ARTICLE · 1326899
小米财报 PDF 转 CSV:六行本地提取
关注「山海只能局」,用东方文化看懂现代科技。
“
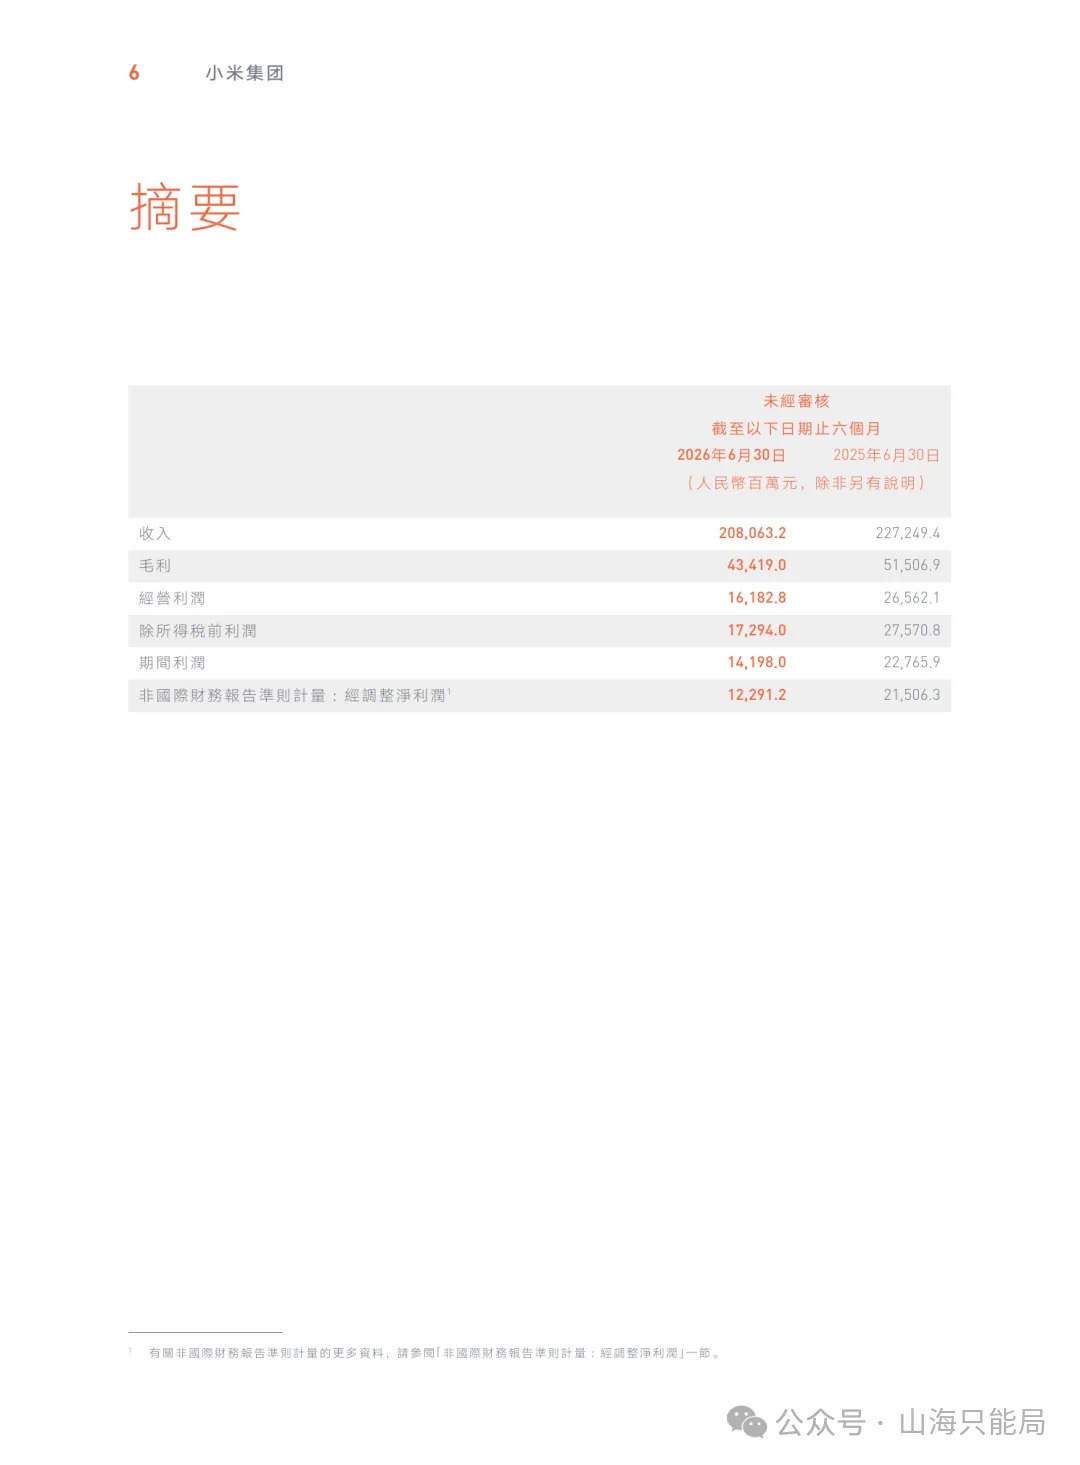
这是一套对固定版式有效的本地 PDF 表格抽取流程。本次已从小米 2026 中期报告第 8 页读出六行两列金额,并对照原页核验标签;它不等于通用财报解析器。
财报表格最费时的是复核,不是复制
很多报表把同一组指标排成左右两列,人工复制会遇到换行、千分位和脚注混入。今天这份样本是小米 2026 中期报告摘要表:两列分别为 2026 与 2025 上半年,金额单位为人民币百万元。
本次目标是把该页六组数值整理成 UTF-8 CSV,再与原页逐行比较。结果只适用于这一份报告的页码、行序和版式;不能据此说任意 PDF 都能自动识别。
验收条件、环境与输入
验收标准有三项:CSV 恰有六行指标、年份列顺序为 2026 H1 与 2025 H1、六组数值逐个与原页一致。中文标签须由人对照 PDF 核实。
运行环境为 macOS 26、Python 3.12.14、pypdf 6.14.2;输入是小米投资者关系网站下载的 2026 中期报告 PDF,SHA-256 为 43f7cd0cf82609ef48ded356af616d9b14c6e41a7088865ad9c8c11588da1ada。费用为 0 美元;处理在本机完成。
第 1 步:先定位原始表格
在小米投资者关系网站打开 2026 Interim Report,下载 PDF 到本地。用系统预览或 PDF 阅读器确认摘要表所在页;本次报告 PDF 的第 8 个 PDF 页面包含六行指标。先检查页面可选择文字,扫描件和图片表格不适用。
第 2 步:安装固定版本并准备抽取脚本
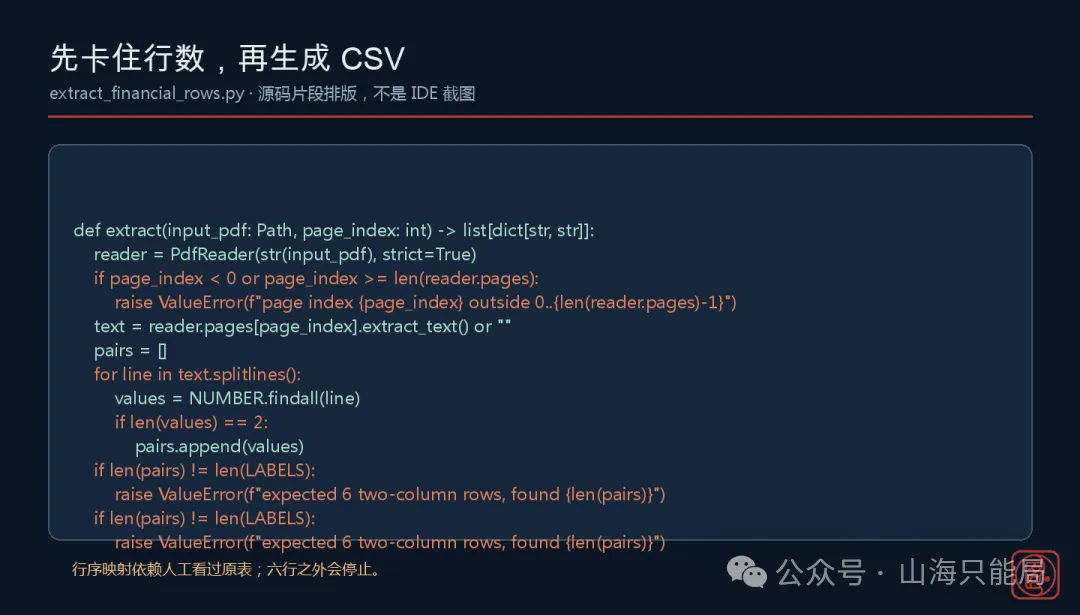
在隔离的 Python 环境运行 python -m pip install pypdf==6.14.2。保存本地脚本 extract_financial_rows.py;它读取指定页的文字层,只接受恰有六个双数值行的样本,再按本页已知行序映射指标。脚本不会调用云端模型,也不会上传报告。
把输入路径替换为自己的 PDF,并先在副本上运行:python extract_financial_rows.py --input report.pdf --output out/rows.csv --page-index 7。PDF 页码参数从 0 开始,第 8 页对应 7。
第 3 步:运行并检查中间回执
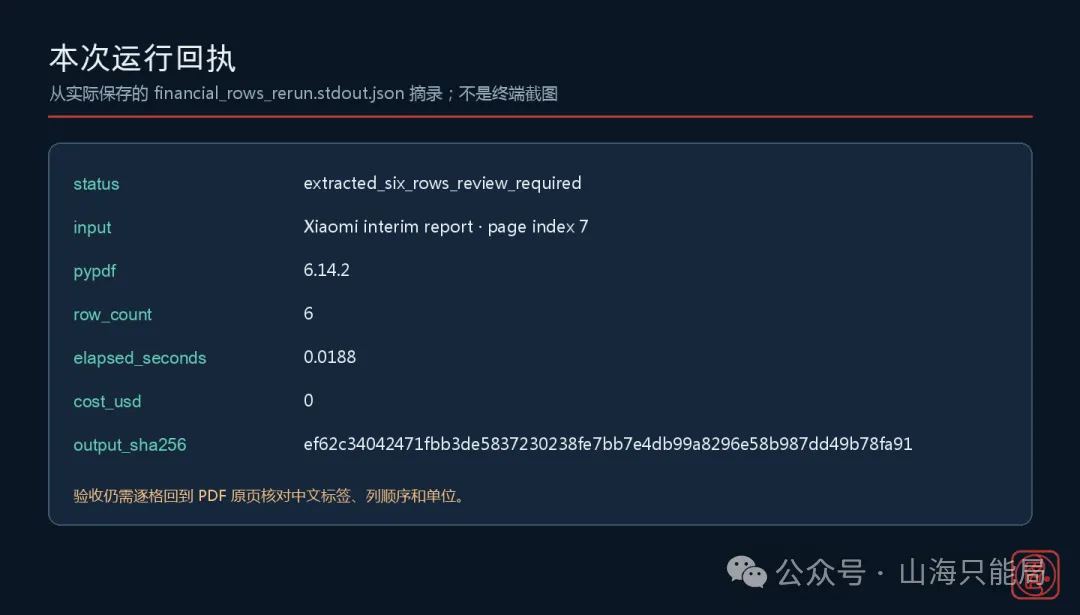
在 ai_media_pipeline_package 项目根目录运行:.venv-automation/bin/python data/research_assets/daily_discovery_20261107/practical_pdf_probe/extract_financial_rows.py --input data/research_assets/daily_discovery_20261107/snapshots/xiaomi_interim_report.pdf --output data/research_assets/daily_discovery_20261107/practical_pdf_probe/generated/financial_rows_rerun.csv --page-index 7。脚本从 PDF 文字层读取第 8 页,只接受六条含两项数字的行,并写入 financial_rows_rerun.csv,同时记录输入与输出 SHA-256。本次运行耗时 0.0188 秒,处理成本 0 美元。
如果提示 expected 6 two-column rows,先不要删除校验。确认页码、表格布局、数字格式和脚注是否变化;格式不符合就转人工复核。
第 4 步:逐行核对 CSV 与原页
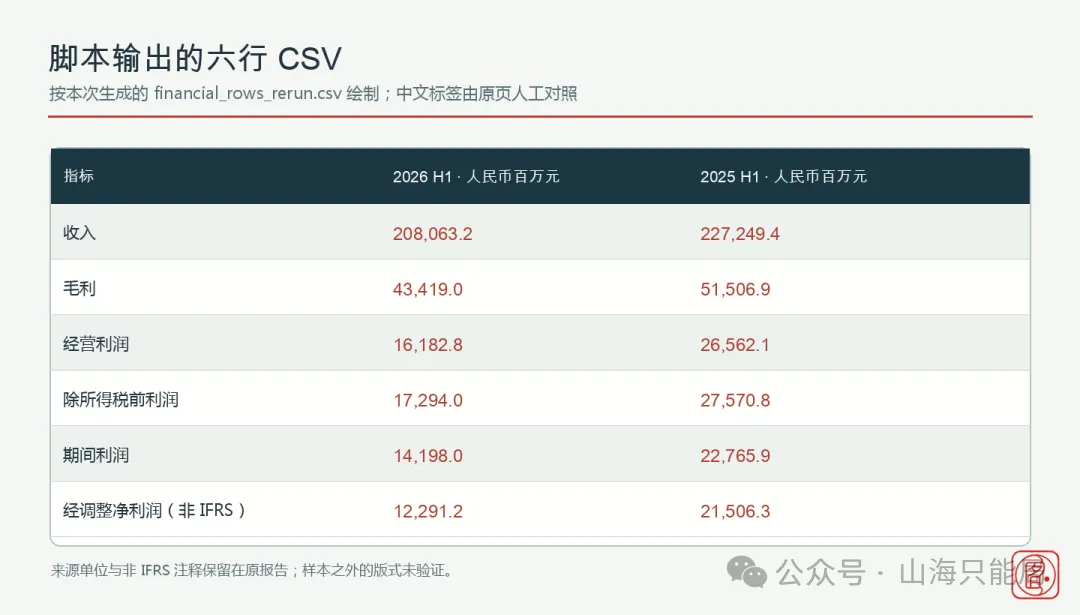
生成文件为 financial_rows_rerun.csv,包含 2026_H1_RMB_million 与 2025_H1_RMB_million 两列。核对结果:收入 208,063.2 与 227,249.4;毛利 43,419.0 与 51,506.9;经营利润 16,182.8 与 26,562.1;税前利润 17,294.0 与 27,570.8;期内利润 14,198.0 与 22,765.9;经调整净利润 12,291.2 与 21,506.3。单位和非国际财务报告准则注脚要随数字保留。
第 5 步:验收 CSV 并存档输出
从 ai_media_pipeline_package 项目根目录运行:.venv-automation/bin/python -c 'import csv; p="data/research_assets/daily_discovery_20261107/practical_pdf_probe/generated/financial_rows_rerun.csv"; rows=list(csv.DictReader(open(p, encoding="utf-8-sig"))); assert len(rows)==6; assert list(rows[0])==["metric","2026_H1_RMB_million","2025_H1_RMB_million"]; print(len(rows), rows[-1])'。验收输出应是六行和最后一项调整后净利润;再用电子表格打开 CSV,对照原 PDF 核对单位、期间、行序和脚注。
存档时同时保留输入 PDF、输出 CSV、脚本版本和 SHA-256。若行数不是六、列顺序改变或最终一行标签错位,停止导入报表,回到原页人工核对,不要只改数字让检查通过。
哪些情况会让它失败
第一,扫描件没有文字层,pypdf 读不到行,需要 OCR 后逐格核对。第二,表格增加指标、脚注或列,六行门槛会报错,不能放宽阈值。第三,数字拆到相邻行、括号表示负值或单位改变,数字正则可能遗漏符号。第四,指标顺序变化会把数据映射到错误标签。第五,跨页表格不适用单页映射。
THE END
隐私、费用与升级条件
脚本无网络调用,报告留在本机;输入若包含非公开财务资料,应放在受控目录,避免同步到个人云盘。pypdf 是开源依赖,安装前要在组织环境审阅软件包来源和许可证。
要把方法推广到第二份报告,先增加列识别、标签定位、负数和脚注测试,再拿两份已人工核对的报告做回归。只有不同版式都能逐格对齐、异常输入会明确停止,才适合升级成通用工作流。
点击右下角,关注「山海只能局」
用东方文化看懂现代科技
如果这篇文章对你有帮助,欢迎点个赞、点亮小红心,或转发给每周需要把 PDF 报表搬进 Excel 的财务与运营同事。