ARTICLE · 1329402
Meta 这次盯上了你的常用 App:Spaces 上新,模型升级补强记忆与执行
“
页面生成只是开场,第二次打开还接得上才算工具。
11 月 6 日,Meta 为 Muse 推出 Spaces,并同步升级专用模型。Spaces 让用户通过描述需求,在 Muse 里创建能反复打开、继续修改的交互工具;模型更新则引入 Active Memory 和 Active Focus,改善信息记忆与执行任务时的应变能力。
Spaces 要反复使用,模型就需要跟上信息变化。假设一个旅行规划页已经生成,随后航班改期,助手需要识别旧安排、调整相关行程,并把变化写回用户正在使用的界面。
「页面生成之后的这些工作,决定了它能否成为日常工具。」
GIF 动图Muse 官方 Spaces 开场动画
📌 本文看点
01
状态怎么留住
02
模型补了什么
03
数字怎么读
STATE
Spaces 如何保留状态并更新信息
用户可以用自然语言创建 Space,继续调整外观和功能,再将它放入侧栏或主标签,并安排它出现的时间。例如工作日打开周计划,周末换成出游安排。这样的入口组织方式,让生成结果成为应用的一部分,减少了反复翻找聊天记录的操作。
— Meta 官方 Spaces 发布图
官方列举的用途包括从学校邮件整理活动、汇集礼物清单,以及追踪音乐人的新专辑和演出。连接相关应用后,Spaces 可以在后台更新日期、价格等信息;用户留下的勾选、笔记和编辑结果也会保留。这里同时涉及外部信息的刷新和用户操作的保存,两者需要在下一次打开时保持一致。
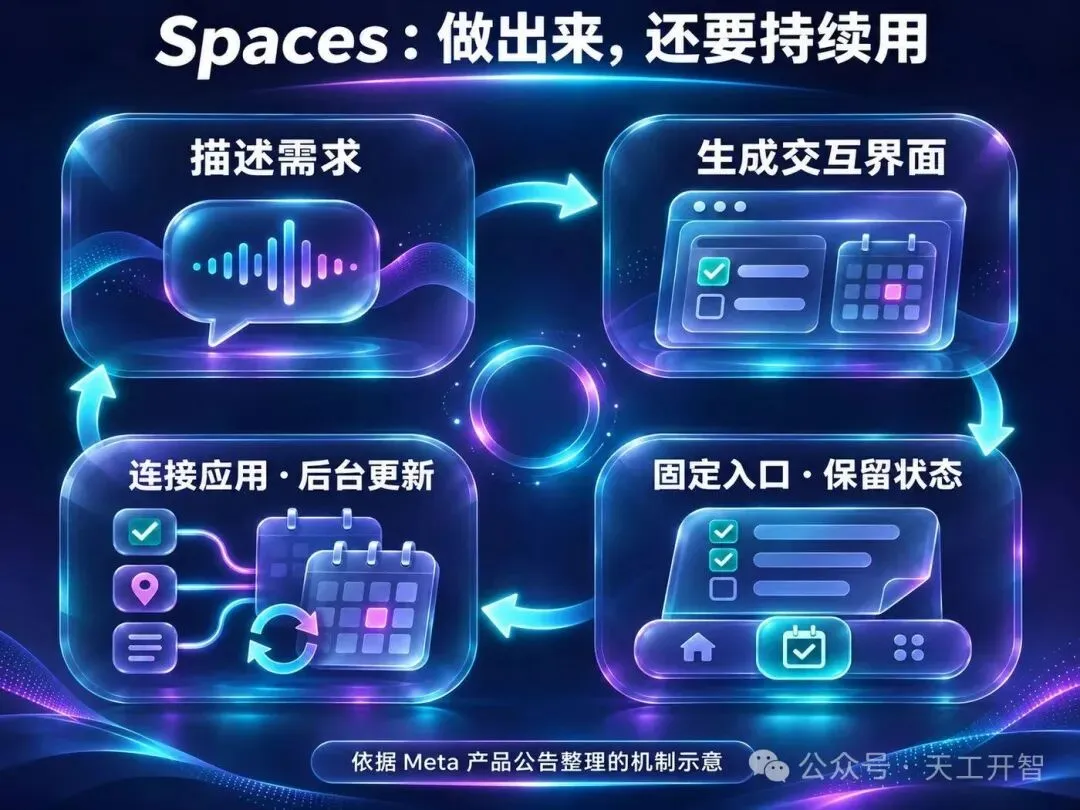
从工程角度看,持续更新的设计重点,是区分外部信息与用户决定。以礼物清单为例,商品价格随时间刷新,用户已经确认的选择则应继续保留。这样的状态管理,能让工具在吸收新信息的同时延续已有进度,也让每次打开都建立在上一次使用的基础上。
从官方演示看工具的不同职责
Muse 在 X 展示了八种 Spaces,以下动图呈现的是成品界面与交互。私信分类、钱币收藏和餐厅整理侧重信息组织;游戏与比分记录则把交互操作放到了界面里。
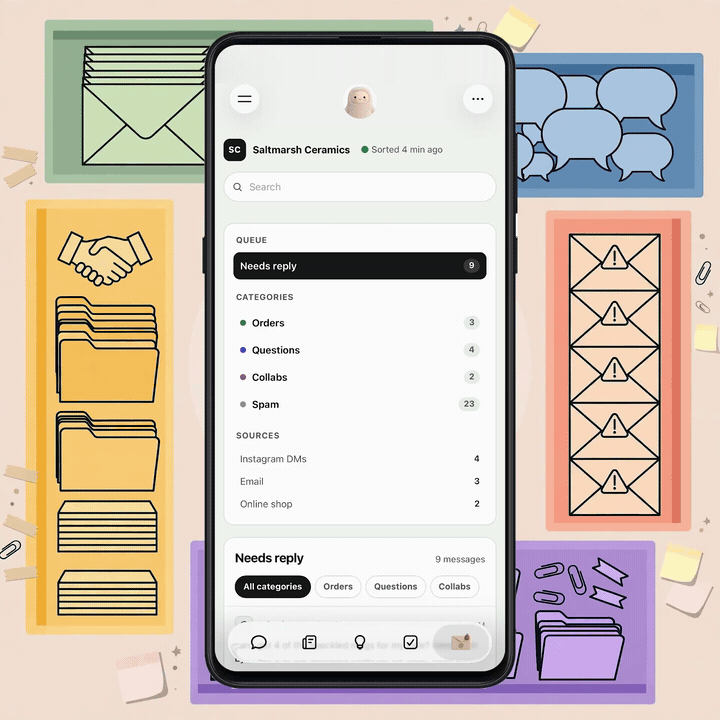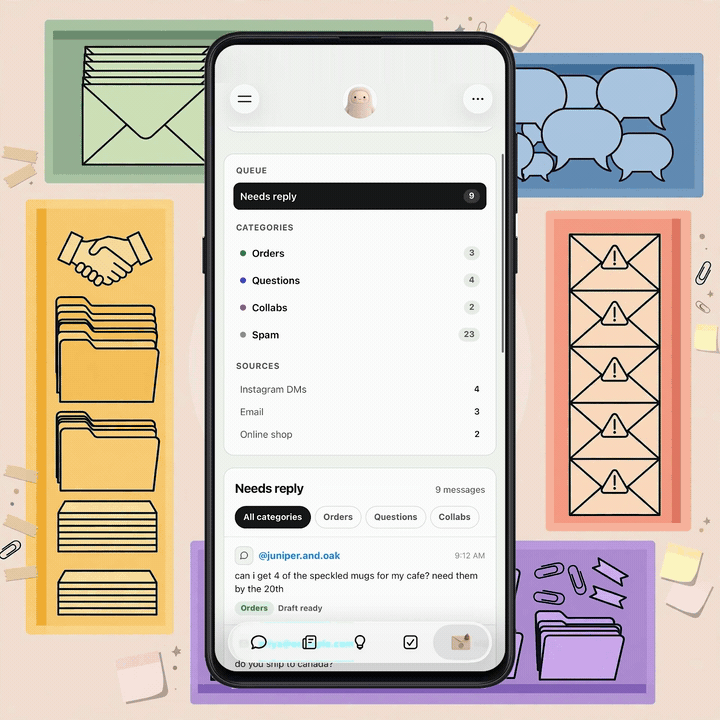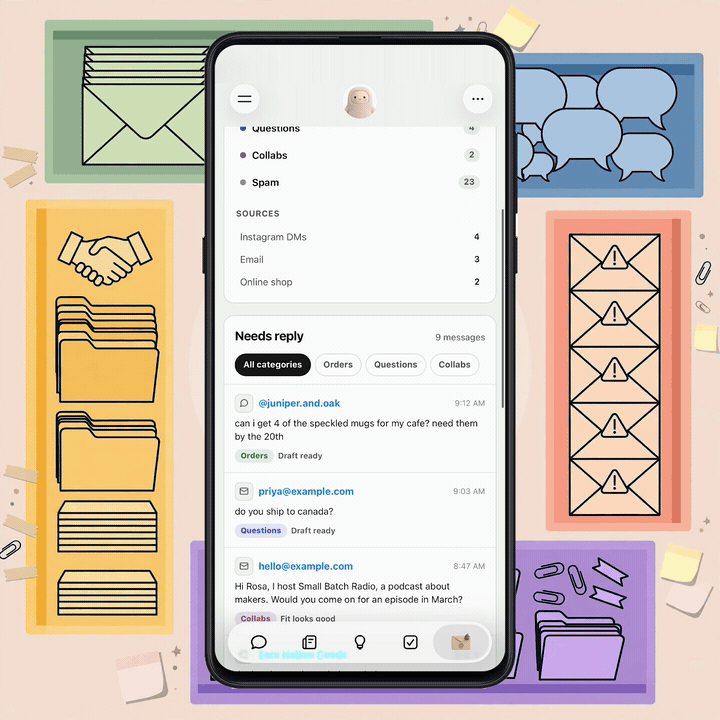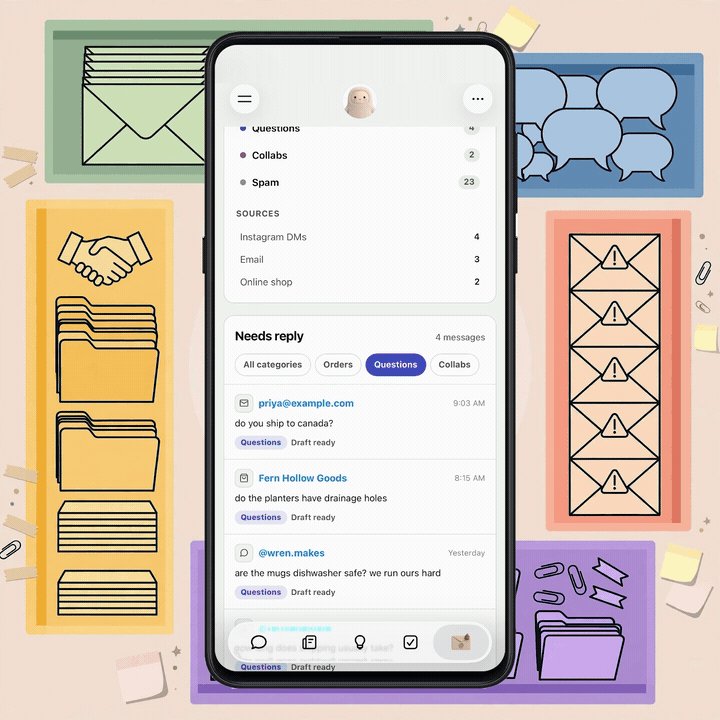
GIF 动图商业私信分类
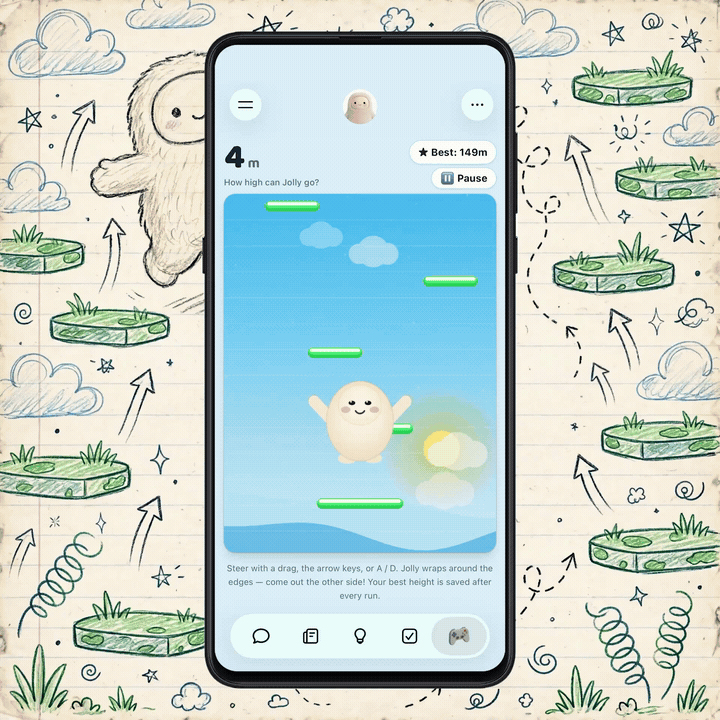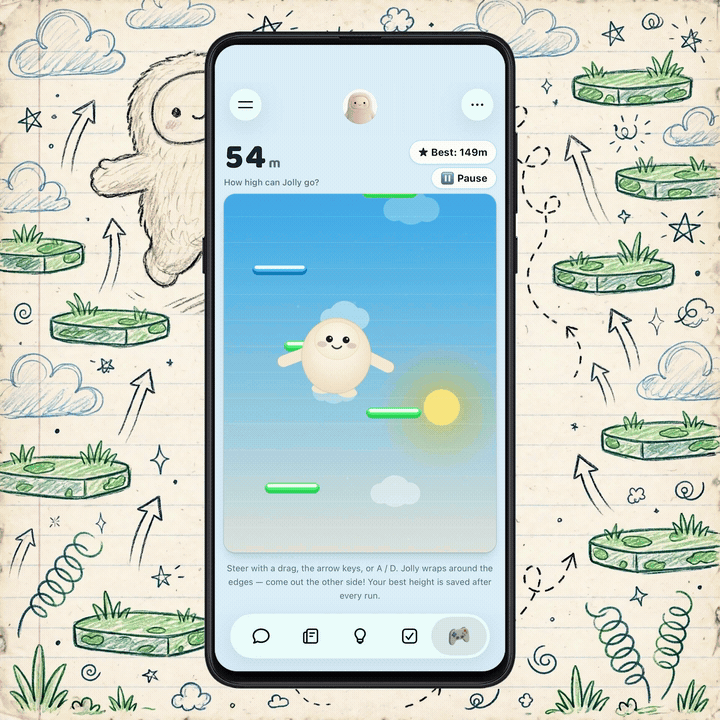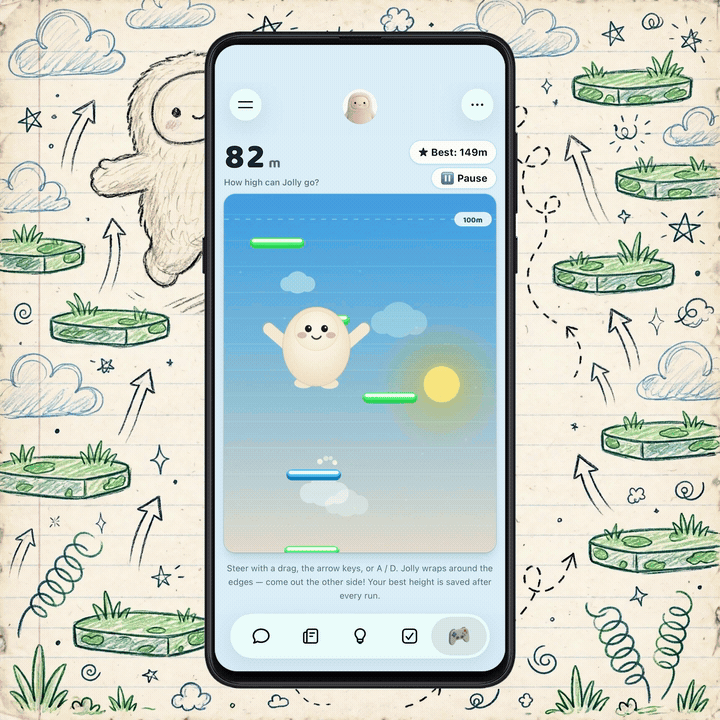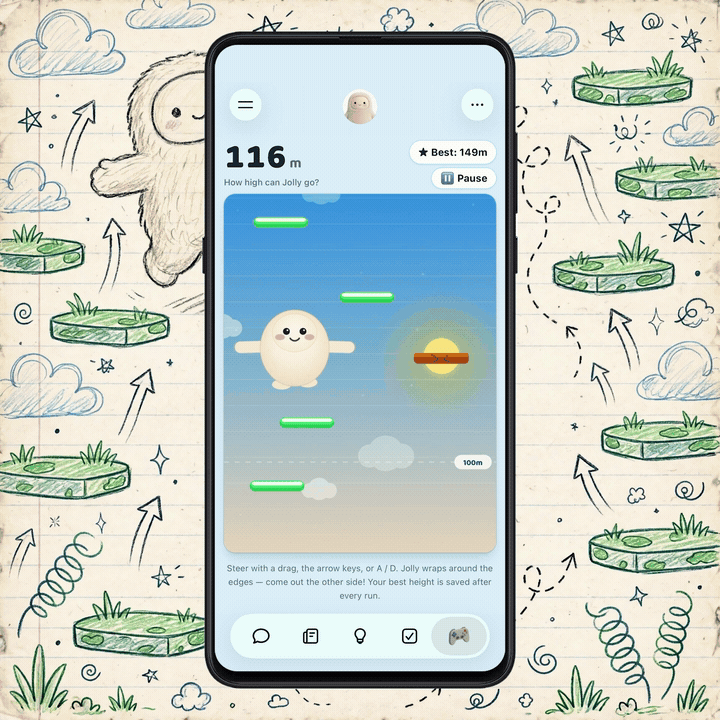
GIF 动图Jolly Jump 小游戏
GIF 动图钱币收藏与挂牌追踪
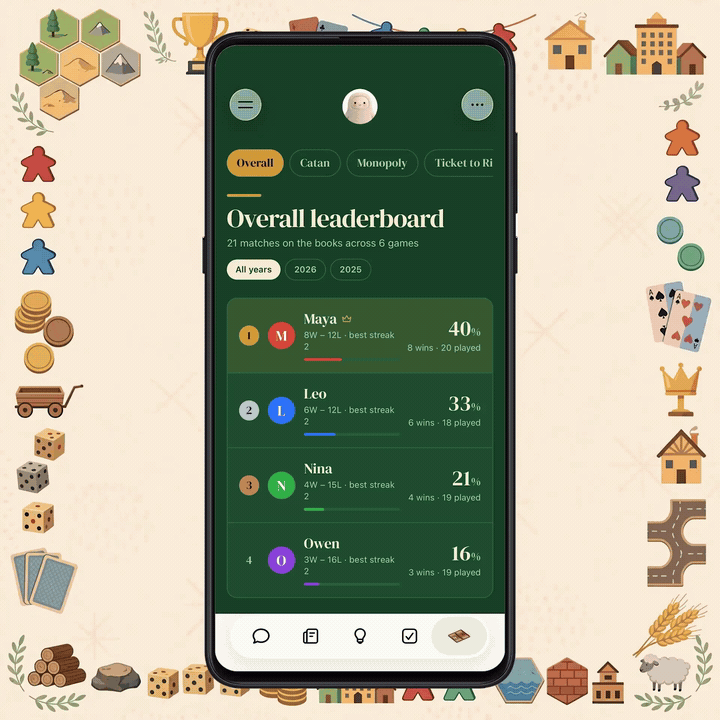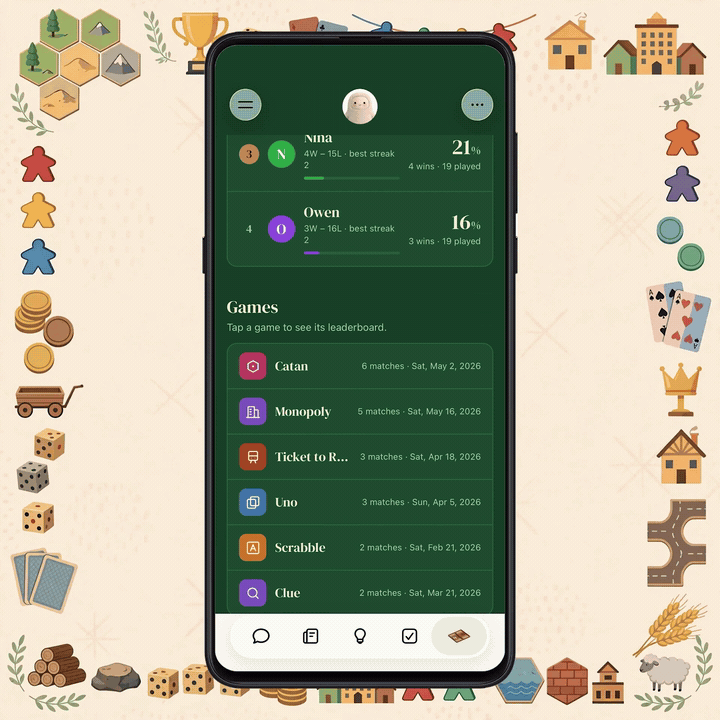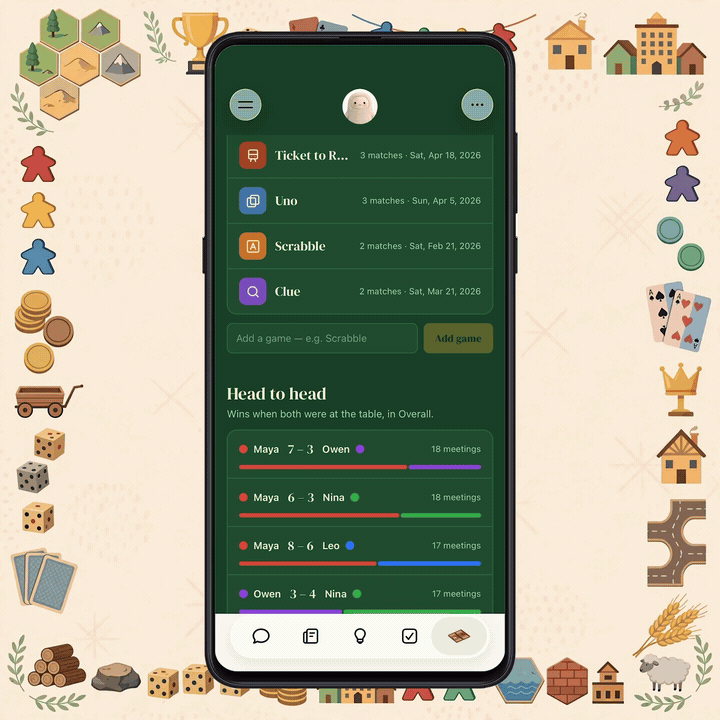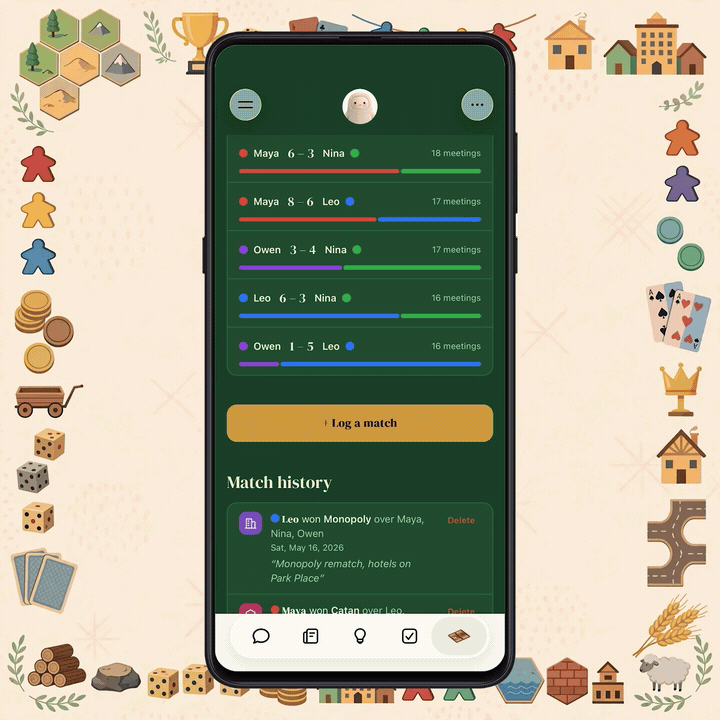
GIF 动图桌游比分与对局记录
礼物规划、周期待办与宠物日程会被反复打开,前一次的记录也是下一次操作的起点。这类工具的价值在于延续已有进度,并随着日期变化调整关联安排。把这些事务放进固定入口,也使用户更容易在同一个界面里查看和修改。
GIF 动图按人整理礼物、尺寸和预算
GIF 动图周期待办与到期安排
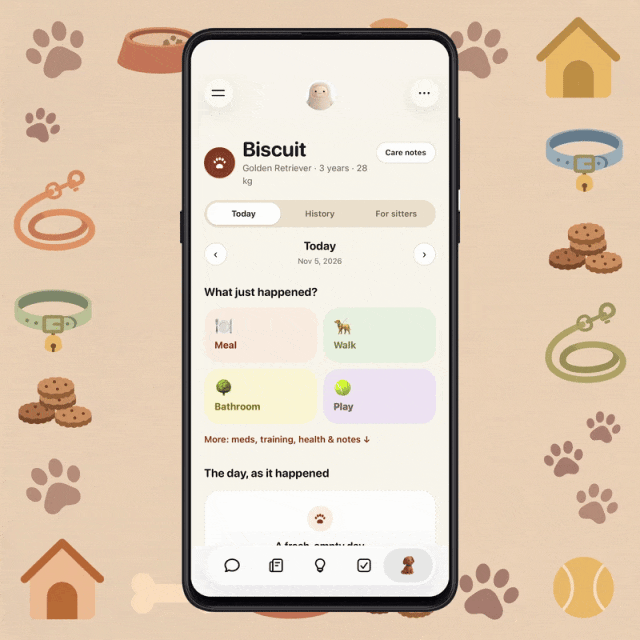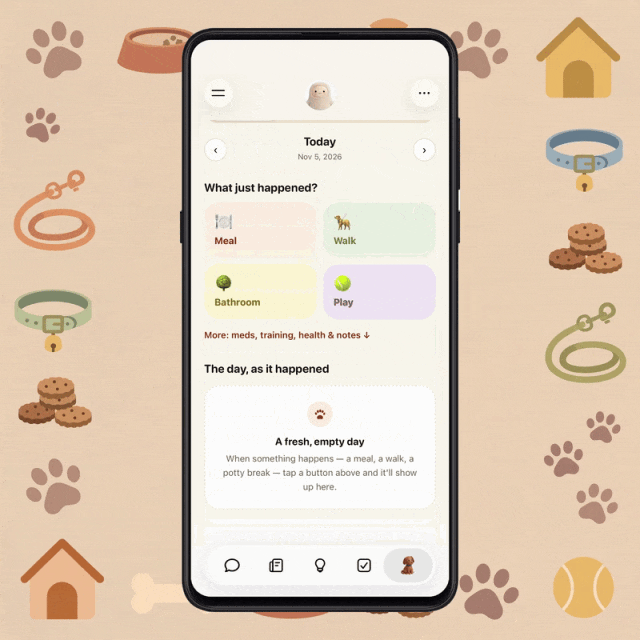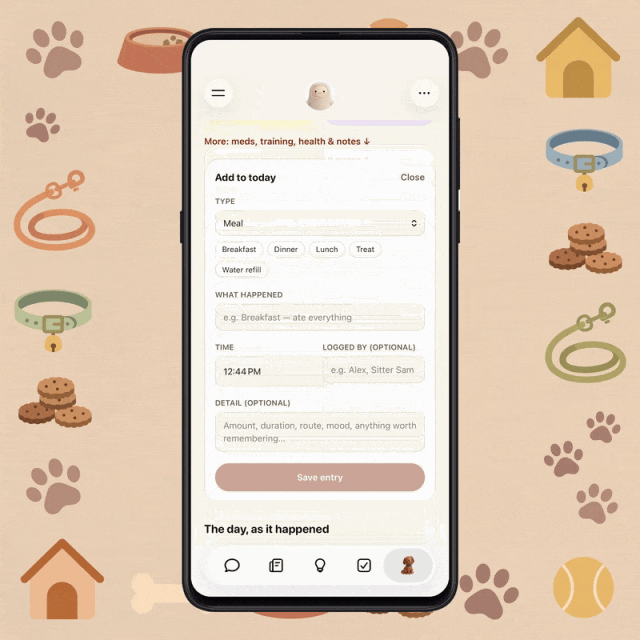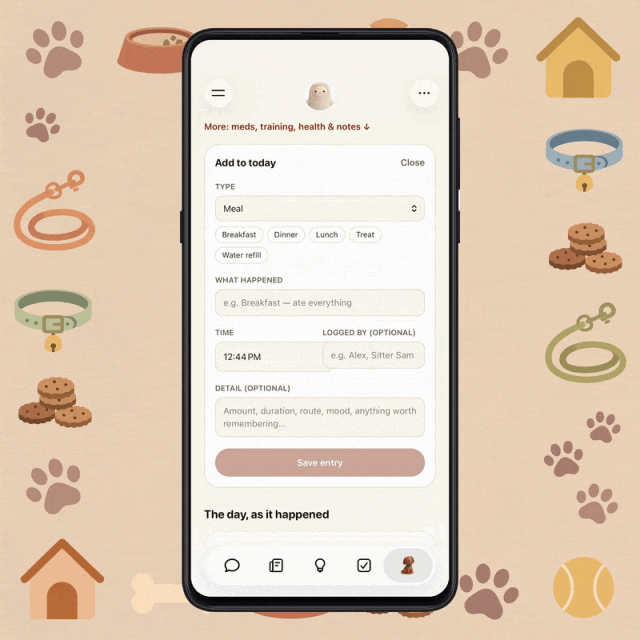
GIF 动图宠物喂食、散步与日程
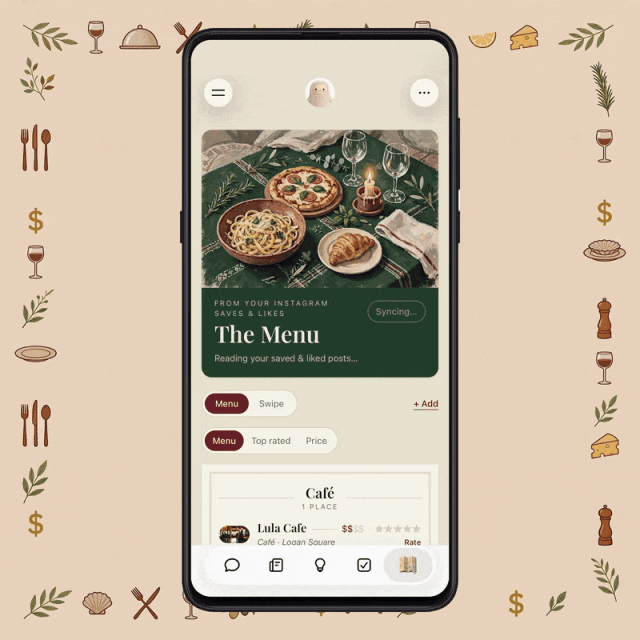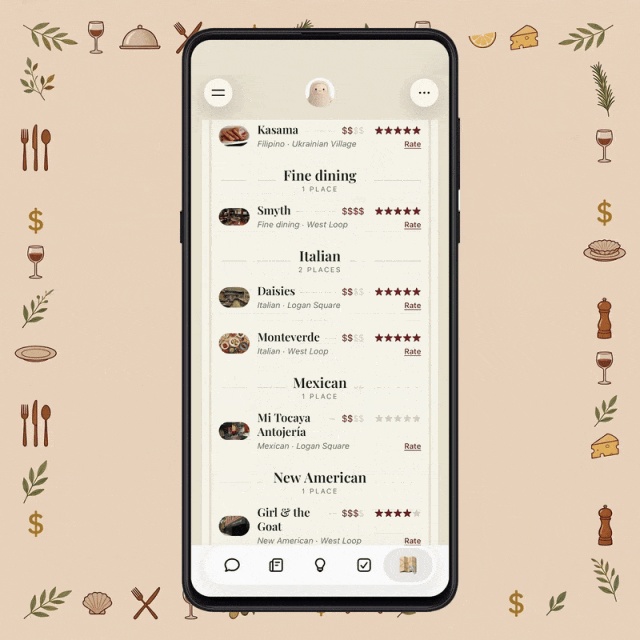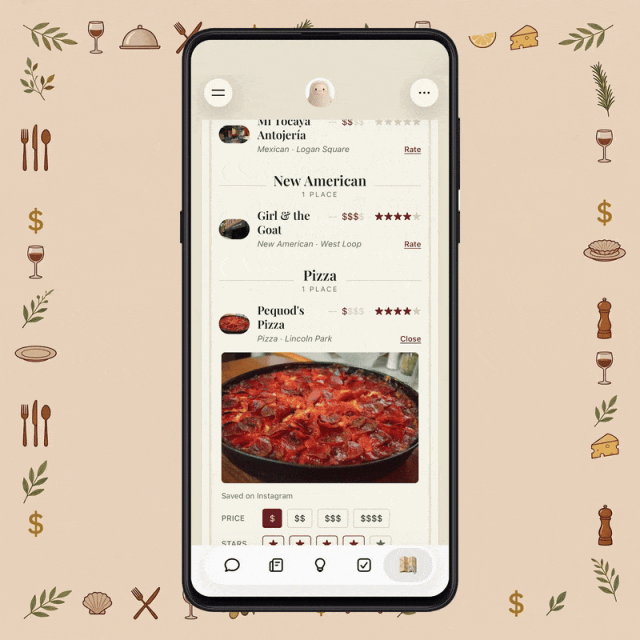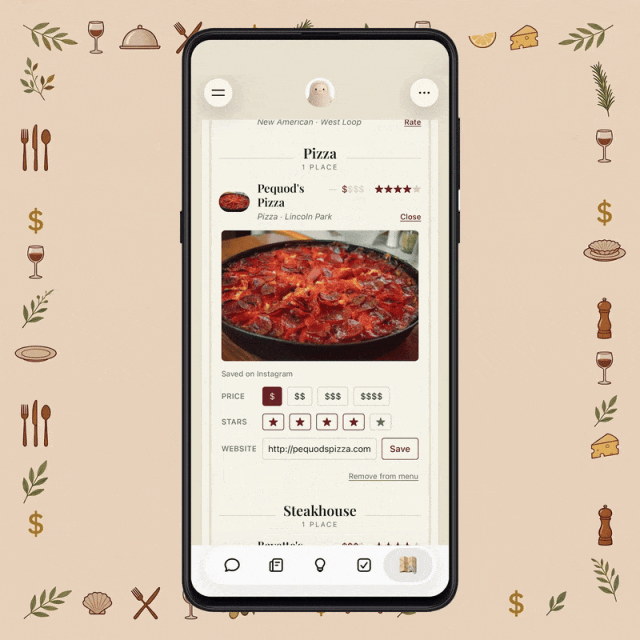
GIF 动图整理 Instagram 收藏的餐厅
MODEL
模型升级如何支持持续执行
这轮升级使用 10 月 12 日发布的 Muse Wonder,训练现有模型的专用版本,再向 Muse 和 Meta AI 推出。
Active Memory 处理的是信息在时间中的有效性:长期偏好与临时安排如何区分,旧信息何时过期,又该在什么任务中被调用。Active Focus 则针对执行过程中的障碍,让模型尝试恢复任务或寻找替代路线。专用模型还加强了对用户中途补充要求、改变方向的适应。
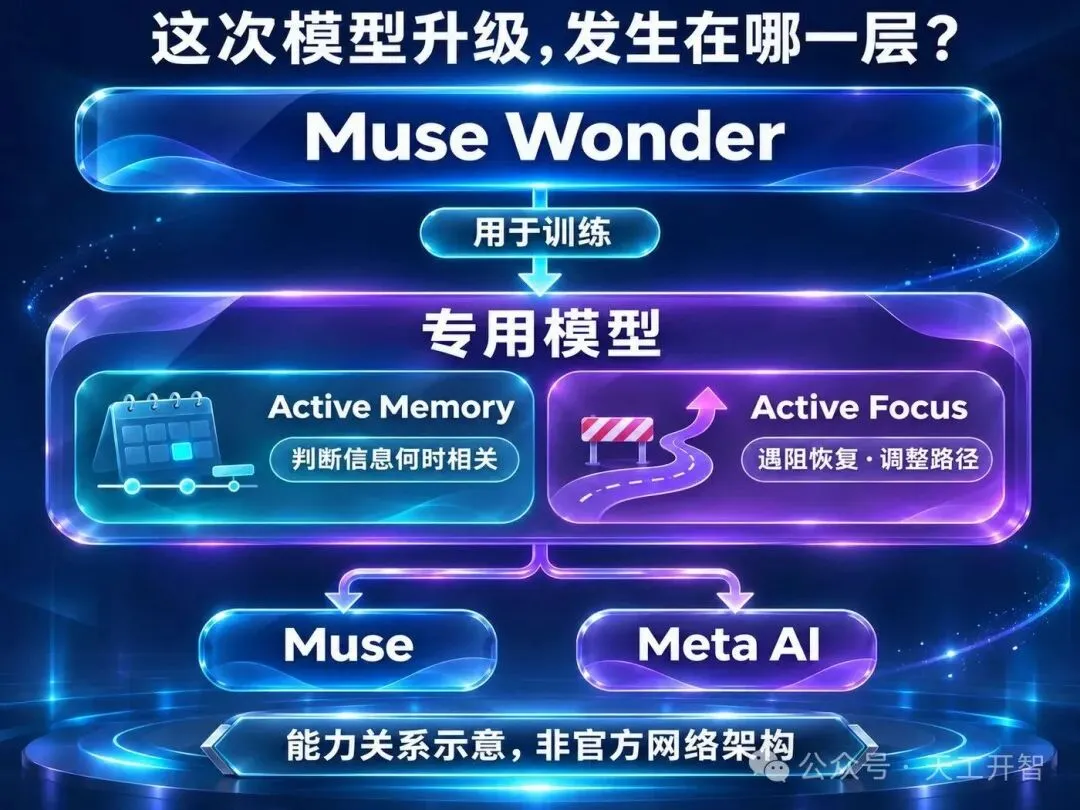
这些能力与 Spaces 的持久化状态有清楚的分工。勾选一个事项后,下次打开仍然显示已完成,是应用保存状态的结果;助手知道旅行日期已经改变,并在下一轮规划中采用新日期,则涉及对上下文的正确使用。Active Memory 的评测针对后者:相关信息能否在后续行动中发挥作用。
长任务中的信息会随时间变化。当旅行日期的新旧版本同时出现在对话中,助手需要判断哪条仍然有效;执行受阻后,还要据此调整行动。对开发者来说,可以把一次信息变更贯穿任务规划、执行和结果更新,观察模型如何将新的要求传递到最终产物。
10 月 Wonder 的婚礼排座演示提供了一个例子:模型根据复杂匹配要求制作座位表,把约束处理与界面生成结合在同一项任务里。用户可以通过最终座位表理解复杂要求怎样转化为可查看的结果。
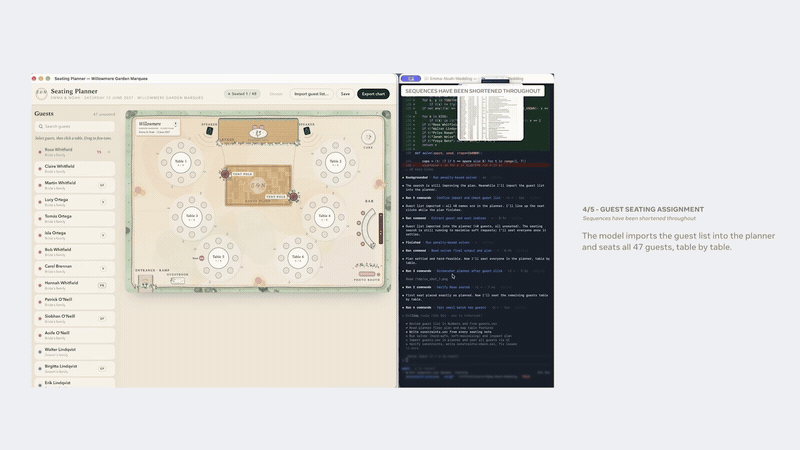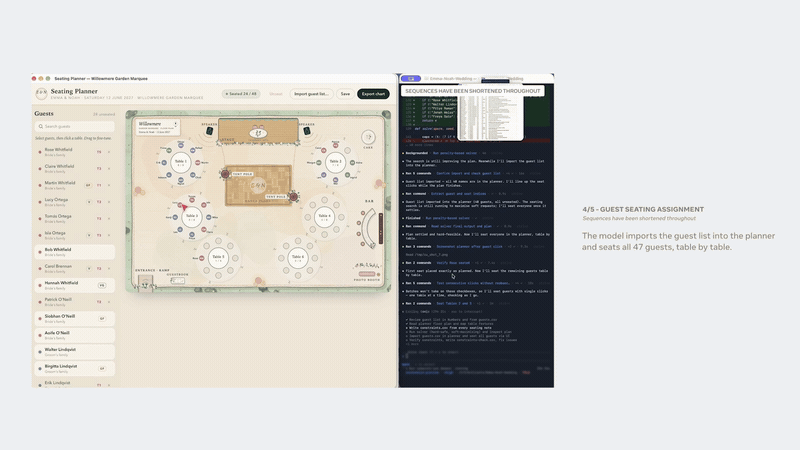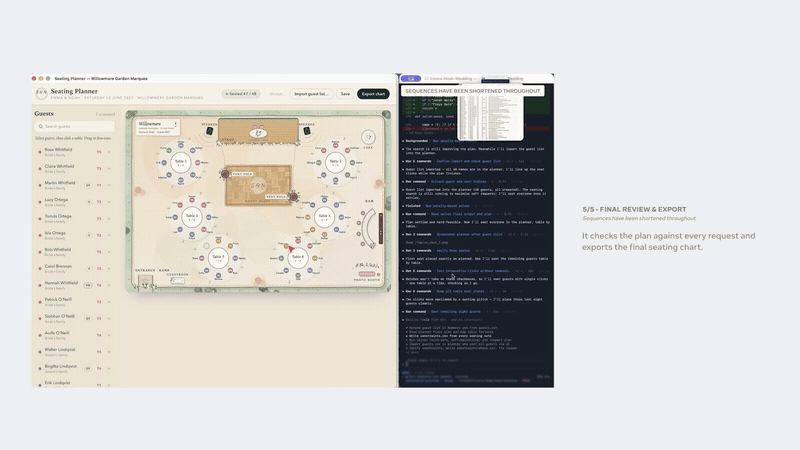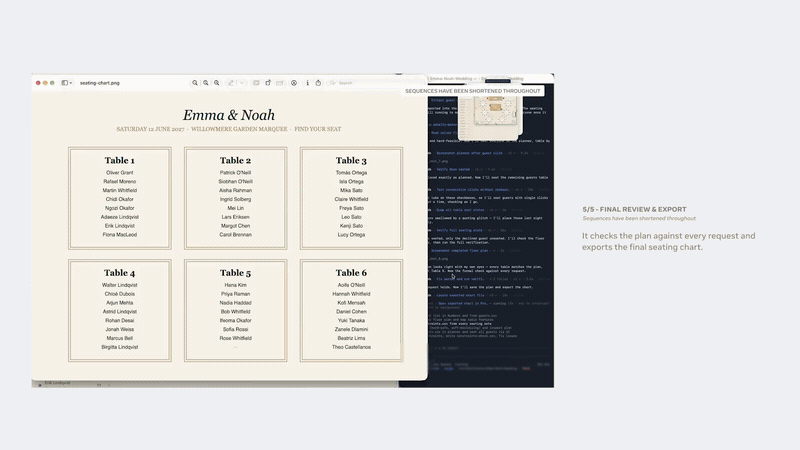
GIF 动图Muse Wonder 10 月官方婚礼排座演示,早于本次专用模型升级
BENCHMARK
评测数字能说明多大的进步
Meta 公布的 Muse 新旧模型评测中,Personal Superintelligence Index(PSI)从 38% 升至 47%,增加 9 个百分点。按旧分数计算,相对提升约 23.7%。
47%
PSI 综合指数
(原 38%)
90%
上下文用对
(原 76%)
67%
遇阻任务改善
(幅度)
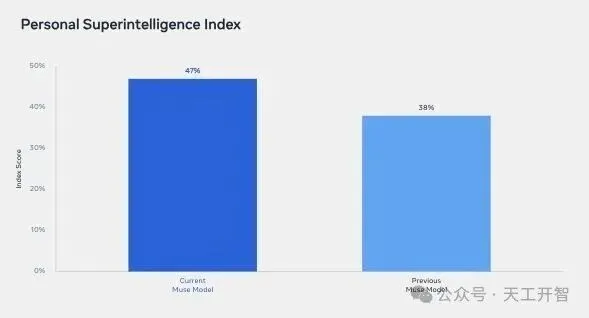
— Meta 官方 PSI 评测:38% 升至 47%(11 月 6 日)
47% 是综合指数得分。10 月《Muse Wonder Model Card》将 PSI 定义为七项评测的复合指标,包含 Agents’ Last Exam、AutomationBench-AA、FocusBench、JobBench、GDP.pdf、VBT 和 DRACO。PSI 用一个汇总分数呈现多类 Agent 任务的表现,适合观察模型升级前后的综合变化。
例如,10 月模型卡中的 Agents’ Last Exam 有 105 项 Linux 虚拟机任务,允许部分得分;JobBench 有 65 项任务,覆盖 35 种白领职业,采用任务专属评分规则。这些测试覆盖的工作不同,评分单位也不同。综合分数提供总体视角,具体子项则帮助开发者判断哪些任务更接近自己的使用场景。
Active Memory 的指标更具体:正确使用关键上下文的任务比例,从 76% 升至 90%,提高 14 个百分点。
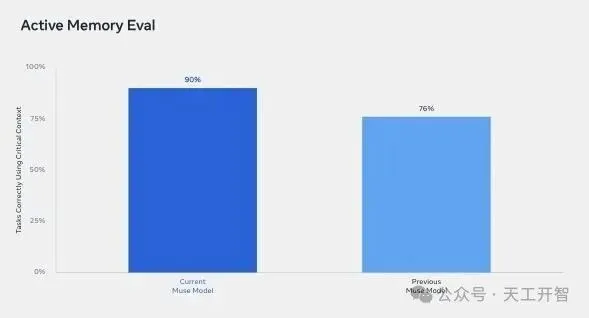
— Meta 官方评测:正确使用关键上下文的任务比例(11 月 6 日)
官方把这一变化称作“遗忘减少 2.4 倍”。换成错误率更容易理解:未正确使用上下文的比例由 24% 降至 10%,旧值是新值的 2.4 倍;相对减少幅度为(24%−10%)÷24%,约58.3%。
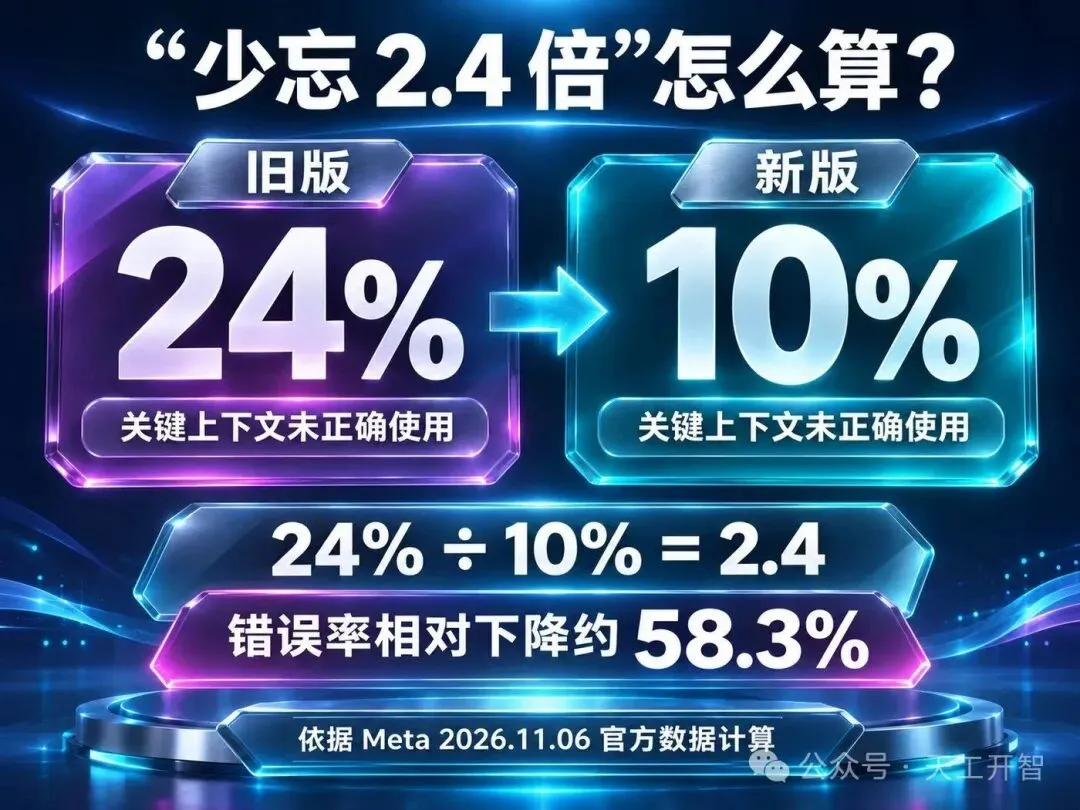
Active Focus 对应的结果是:遇到意外障碍时,日常任务的完成情况改善 67%。
67% 是改善幅度,公告未列前后绝对成功率与样本量。
这些结果对应着持续执行中的不同环节:正确使用上下文,为后续行动提供依据;遇阻后的恢复能力,帮助任务继续推进。综合指数则呈现更广的任务表现。我更看重记忆与执行之间的配合:新的日期被采用之后,后续安排也要随之调整。把两项能力放进同一条任务链,更容易理解这次升级对个人助手的意义。
COMPETITION
竞争会延伸到工具的维护成本
ChatGPT Sites、Claude Artifacts 和 Gemini Canvas 已经提供相近方向的能力。
在这个背景下,Spaces 的特点是把个人事务、常用入口和后台更新组织在 Muse 内。这种组织方式有机会减少用户在工具之间切换和重复补充信息的负担。当前的产品重点是个人使用,跨用户分享与协作仍在探索。
对于开发这类产品的团队,持续使用带来了更具体的价值衡量方式:完成同一件事,用户需要补充多少次信息,花多少时间修订结果,以及重新打开工具后能接着推进多少工作。这些观察能把模型分数与实际使用联系起来,也能说明维护一个个人工具究竟节省了多少人工。
以开头的旅行规划为例,日期变更后,如果助手能沿用已有偏好、调整关联安排并更新页面,用户就省去了重新解释需求和手工修订的工作。Spaces 提供持续使用的入口,模型升级加强上下文使用与任务恢复;
两者结合的产品目标,是让个人工具在日常变化中继续帮人做事。
APPENDIX
Spaces 官方完整演示
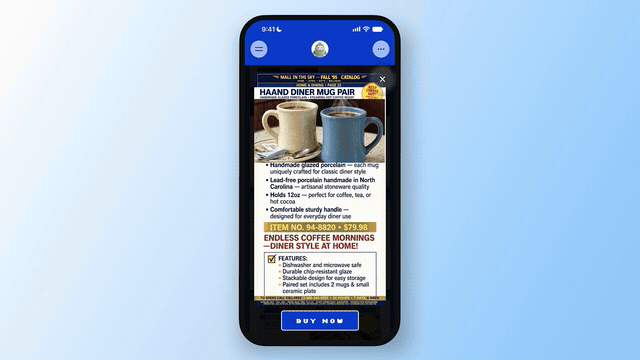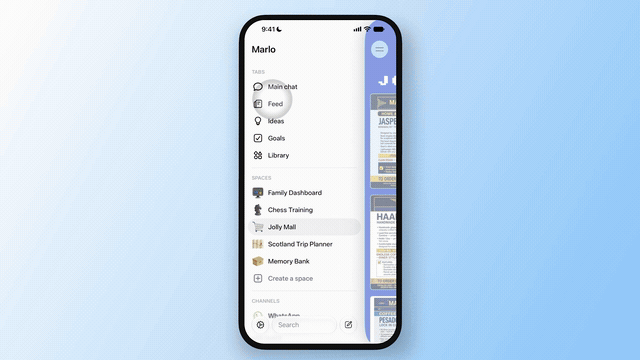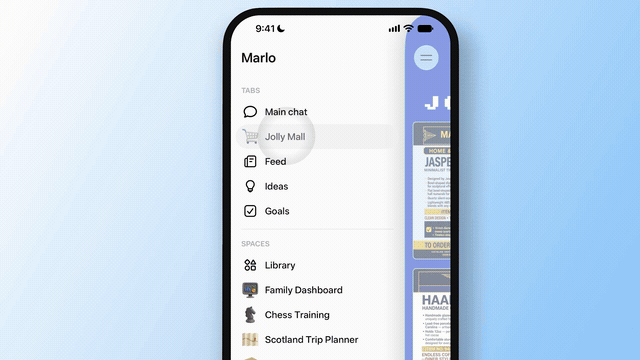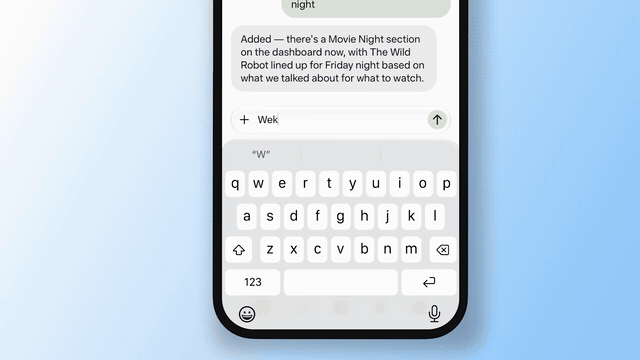
以下为 Muse 在 X 发布的完整介绍视频,转为四段连续动图。
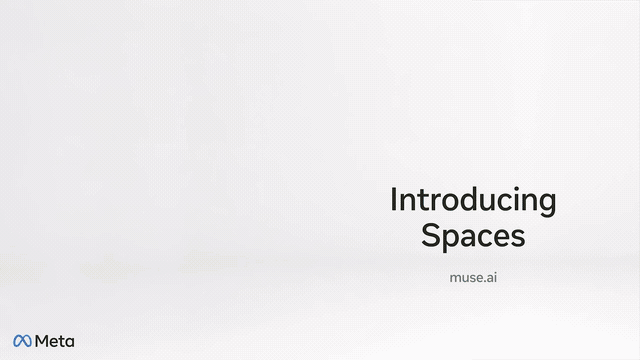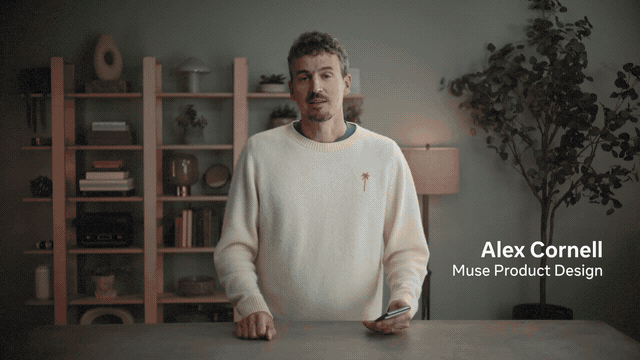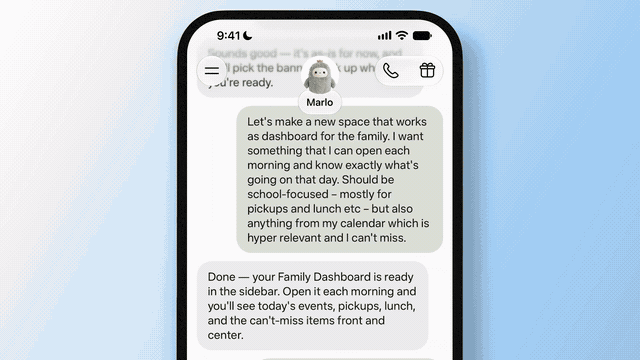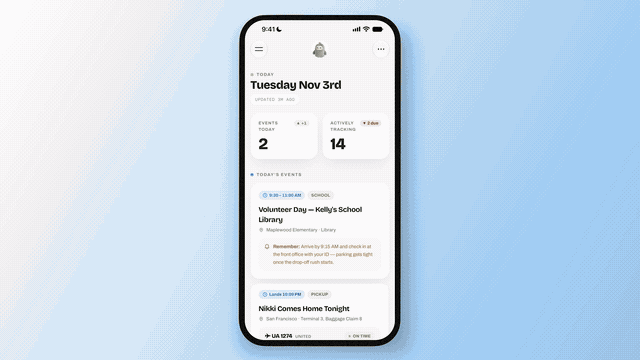
GIF 动图Muse 官方演示 1/4
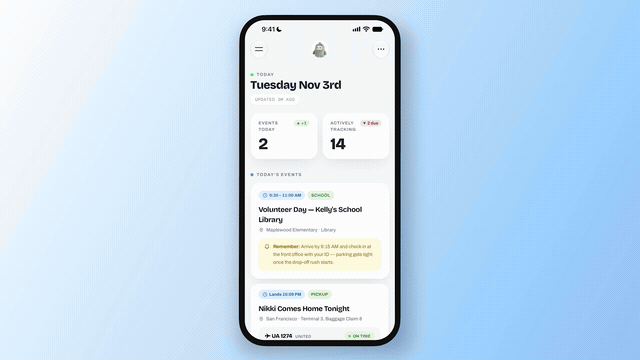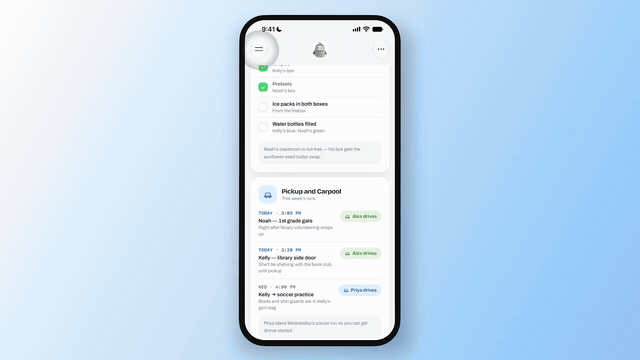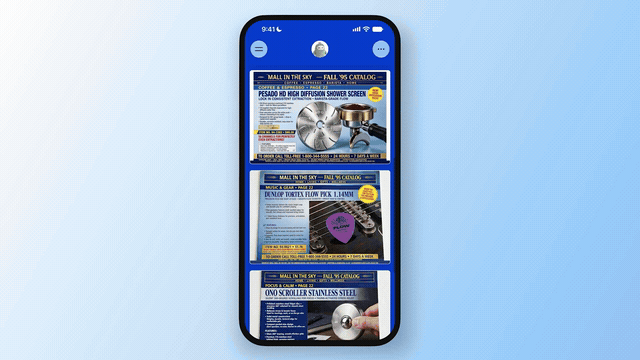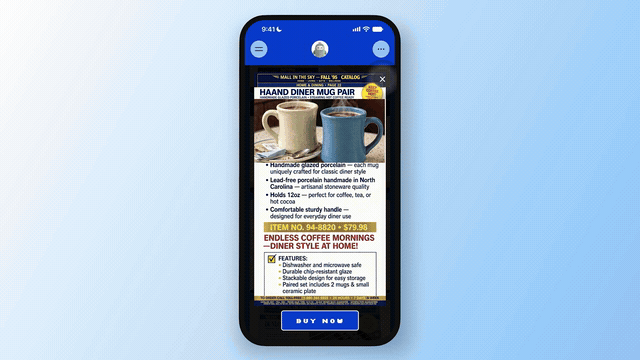
GIF 动图Muse 官方演示 2/4
GIF 动图Muse 官方演示 3/4
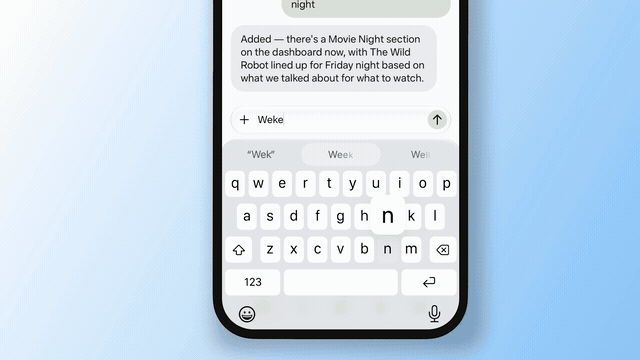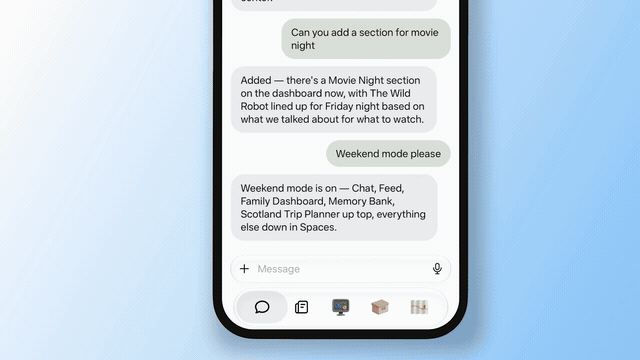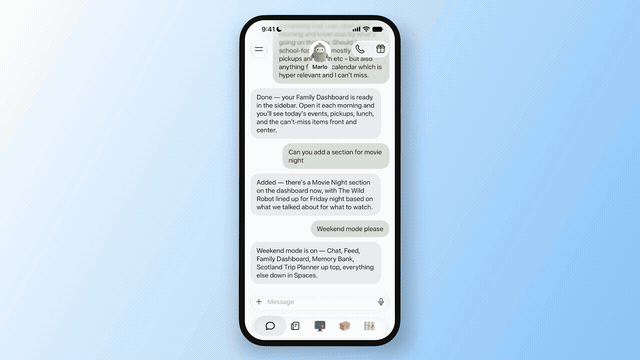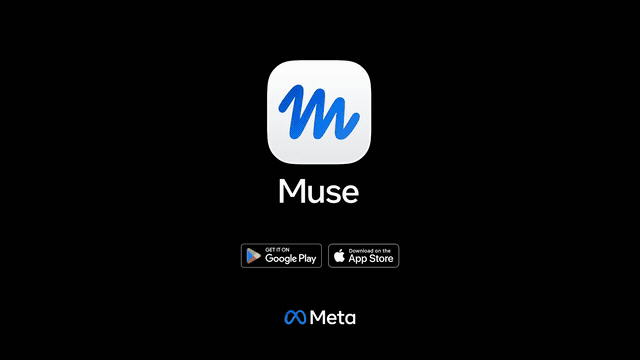
GIF 动图Muse 官方演示 4/4
本次的分享到这里就结束了。欢迎关注公众号,获取更多前沿资料、科技资讯和好玩的实用工具,精彩不错过。
如果你觉得这篇文章有收获的话,欢迎点赞 👍、推荐 ❤️、转发 🔁三连,我们下篇见。