ARTICLE · 1351485
【LevelDB 源码阅读】08 Arena 与 MemTable 的生死
LevelDB 源码笔记 · 第 08 篇
Arena 与 MemTable 的生死
只批发不零售的内存管家,与一代内存的完整生命周期
util/arena.cc · util/arena.h · db/memtable.h · db/memtable.cc · db/db_impl.cc阅读约 25 分钟
上一篇结尾留下了三个问题:
• MemTable 中只涨不跌的字节,什么时候、由谁、按照什么规则回收?
• MemTable 写满换代后,旧的一代在哪里等待,又在什么时候真正消亡?
• 那个以 4096 字节为基本块、每块记账 4104 字节的分配器,为什么敢把内存管理做得如此简单?
这一篇就来回答这三个问题。
答案主要藏在以下几个文件里
•util/arena.cc(66 行)与 util/arena.h(71 行)
•db/memtable.h(87 行)与 db/memtable.cc(137 行)
•db/db_impl.cc 中与 mem_、imm_ 有关的几个关键位置
前两篇分别拆解了跳表和 entry 编码。这一次,我们继续向下追,看看它们的「房东」和「户籍制度」:
• Arena 管理的字节住在哪里,又以什么方式归还;
• 引用计数如何决定一代 MemTable 能活到什么时候。
MemTable 写满换新之后,旧数据何时真正释放?
在最后一个引用被归还的那一刻。
Unref() 将引用计数减到零后执行 delete this,继而触发 MemTable 的析构。成员按照声明顺序的逆序销毁:table_ 先析构,但它不会逐个释放节点;随后 arena_ 析构,对 blocks_ 中登记的内存块逐一执行 delete[]。
整代内存一次清场,没有任何单个 entry 或节点的「葬礼」。
本文导航
01 Arena:只批发,不零售
02 实际走一遍:四条路径与一次对账
03 跳表为什么养得起如此简单的分配器
04 4MB 的账单:write_buffer_size 量的是什么
05 Value 越小,固定开销越显眼
06 出生与户口:MemTable 的引用计数
07 换岗:mem_ 如何变成 imm_
08 消亡:CompactMemTable 的最后一站
09 上机:两代并存与 RSS 的阶梯
10 对比参照:三个内存管家
11 工程启示
01 Arena:只批发,不零售
先把主角请出来。
Arena 的全部状态都定义在 util/arena.h:42-52:
util/arena.h
它只有四件家当:
•alloc_ptr_:当前块中的分配游标;
•alloc_bytes_remaining_:当前块还剩多少空间;
•blocks_:保存所有已申请块的首地址;
•memory_usage_:按照 Arena 自己的口径记录内存用量。
对外接口也很少:Allocate、AllocateAligned 和 MemoryUsage。
普通分配的代码只有十几行(util/arena.h:55-67):
util/arena.h
只要当前块装得下,Arena 就把游标向前推进,然后返回原来的位置。
整个过程只有一次指针加法和一次减法:
• 没有空闲链表;
• 没有 size class;
• 没有单对象元数据;
• 也没有对应的 Free。
这就是典型的 bump allocator:只管向后分配,不管单个对象如何回收。
为什么这里要写成 inline
这里的 inline 有两层作用。
第一层是 C++ 语言层面的。
Arena::Allocate 的实现写在头文件中,而 arena.h 会被多个编译单元包含。如果一个普通的非模板函数直接定义在头文件里,链接时可能出现重复定义;标记为 inline 后,C++ 允许它在多个编译单元中出现内容相同的定义,最终仍然表示同一个函数。
第二层才是通常所说的性能意义。
Allocate 位于 MemTable 写入的热路径上,而且最常见的情况只是判断当前块是否装得下,再推进两项状态。把这段快速路径放在头文件里,编译器可以在调用点直接展开它,省掉一次函数调用,并进一步优化周围代码。
不过,inline 只是允许和建议,并不保证编译器一定内联;是否真正展开,仍由编译器根据优化级别、函数大小和调用上下文决定。LevelDB 在这里还做了一层很典型的冷热分离:高频而短小的成功路径留在 Allocate 中,低频且分支较多的路径交给 .cc 里的 AllocateFallback。这样既让热路径保持紧凑,又避免把慢路径复制到每个调用点。
装不下时怎么办
如果当前块装不下,就进入 AllocateFallback(util/arena.cc:20-36):
util/arena.cc
这里有两条路径,分界线是 kBlockSize / 4。
kBlockSize 为 4096(定义在 util/arena.cc:9),因此阈值是 1024 字节:
• 请求大于 1024 字节时,单独申请一块刚好容纳它的内存;
• 请求不超过 1024 字节时,放弃当前块剩余空间,重新申请一个 4096 字节的标准块。
第一条规则的目的,是避免一个大对象把标准块的尾部全部浪费掉。
例如,当前标准块还剩 3896 字节,这时来了一个 5000 字节请求。如果直接换成一块更大的内存并更新当前游标,原来的 3896 字节就再也用不上了。LevelDB 的做法是让 5000 字节请求单独成块,当前标准块仍然保留给后续的小对象。
第二条规则则接受了少量尾部浪费。小请求装不下时,不再费力寻找或拼接空间,而是直接开启新块。被放弃的尾部不会再次利用,它是 Arena 最主要的内部碎片来源之一。
每块为什么记 4104
真正向底层分配器申请内存的只有 AllocateNewBlock(util/arena.cc:58-64):
util/arena.cc
每申请一块,MemoryUsage() 增加 block_bytes + sizeof(char*)。对于标准块,就是:块本身 4096,加上 blocks_ 数组里存它用的 8 字节指针,共计 4104 字节。这就是 07 篇反复出现的「每块记 4104」的出处。
不过,这里需要区分两个概念:
•memory_usage_ 按每块一个指针估算管理开销;
•std::vector<char*> 的真实内存占用还受 capacity、扩容策略和分配器元数据影响。
因此,blocks × 8 是 Arena 的记账口径,并不意味着 blocks_ 在物理上始终恰好只占这些字节。后面的「对账」,对的是源码定义的 MemoryUsage(),不是进程的精确堆占用。
Arena 如何析构
析构函数同样简单(util/arena.cc:14-18):
util/arena.cc
遍历 blocks_,逐块 delete[],结束。
整个 arena.cc 只有几十行代码。它不合并碎片、不回收单个对象,块的数量在 Arena 活着时也只增不减。
这不是功能缺失,而是职责边界:Arena 的客户从一开始就不需要这些能力。
对齐分配
Arena 还提供了 AllocateAligned(util/arena.cc:38-56)方法,跳表节点就是通过它分配的。
util/arena.cc
节点中包含指针数组,因此地址需要满足指针对齐要求。LevelDB 至少按照 8 字节对齐:
如果当前游标不在对齐边界上,就先垫一小段 slop:
如果当前块连「对象大小加垫片」都装不下,就进入 AllocateFallback。代码注释说:
AllocateFallback always returned aligned memory
因为 new char[] 返回的块基址天然满足 max_align_t 对齐,新块开头不用垫。
LevelDB 在这里依赖新分配块的基址满足所需对齐,并通过最后的断言验证结果:
对齐垫片不会存入任何空闲链表,也不会被再次使用。和被放弃的块尾一样,它们会一直留到整个 Arena 析构。
02 实际走一遍:四条路径与一次对账
从源码可以归纳出四条典型分配路径:
1. 当前块装得下;
2. 小请求装不下,放弃块尾并申请新的标准块;
3. 大请求装不下,单独成块;
4. 对齐分配时插入垫片。
arena_probe walk 用六次分配命中这四条路径:
逐步来看:
1. 第一次申请 100 字节。Arena 尚未拥有任何块,因此走 fallback,申请第一个 4096 字节标准块,usage 变为 4104。
2. 第二次申请 3900 字节。当前还剩 3996 字节,可以直接放入,usage 不变。
3. 第三次申请 200 字节。当前只剩 96 字节,而且请求不超过 1024 字节,因此放弃这 96 字节,申请新的标准块。
4. 第四次申请 5000 字节。请求超过 1024 字节,因此单独成块,记账增加 5000 + 8 = 5008。
5. 第五次申请 900 字节。它继续使用第二个标准块中留下的 3896 字节。
6. 最后申请一个需要对齐的 24 字节节点。当前偏移为 1100,不是 8 的倍数,于是插入 4 字节垫片。
最关键的是最后一行对账。
工具中的 ArenaSim 逐行复刻 arena.cc 的分配规则,只计算块数、剩余空间、尾部浪费、对齐垫片和 MemoryUsage(),并不真正申请内存。每轮实验结束后,再将模拟值与真实 Arena 的 MemoryUsage() 比较。
上一篇重放的是跳表层高,这一篇重放的是内存分配路径。方法相同:源码规则能否解释实验结果,最终要靠逐项对账。
03 跳表为什么养得起如此简单的分配器
现在可以回答第三个问题:Arena 为什么敢如此简单?
因为它服务的对象,恰好具备三个关键特征。
尺寸小而且参差
MemTable::Add 每插入一条数据,通常会向 Arena 申请两段内存:
• 一段 entry 编码;
• 一个跳表节点。
entry 的长度取决于 key、value 和编码开销,通常是几十到几百字节;跳表节点则取决于随机层高。
如果每个对象都单独交给通用分配器,就会带来额外的分配器元数据、对齐以及 size class 取整开销。具体数值取决于平台和分配器,因此不能简单地把某个实现的 chunk header 大小当成所有环境下的固定成本。
Arena 不给单个对象附加元数据。它只在块级别记账,从而把管理成本摊到整块内存上。每块 8 字节,摊到 4096 上是 0.2%。
同生共死
一代 MemTable 中的 entry 和跳表节点,在生命周期内都不会被单独删除。
它们一直活到整代 MemTable 被回收的那一刻。
通用分配器需要处理的许多复杂问题,在这里根本不存在:
• 单对象 free;
• 空闲链表;
• 相邻块合并;
• 长期碎片整理;
• 对象间不同生命周期导致的洞。
既然没有单个对象提前死亡,Arena 就干脆不提供单对象释放能力。
单写者
LevelDB 的 Writer 队列保证同一时刻只有一个 leader 写入 MemTable。因此,Arena 的游标推进不需要为多个并发写线程加锁。
DBImpl::Write 在写 WAL 和 MemTable 时会暂时释放 mutex_,源码注释明确指出,当前 Writer 会阻止其他线程并发写日志和 mem_(db/db_impl.cc:1224-1241):
db/db_impl.cc
所以,保护 mem_ 写入过程的并不是这把互斥锁本身,而是 Writer 队列建立的单 leader 协议。
这也解释了下面几项状态的不对称(db/db_impl.h:177-179):
db/db_impl.h
•imm_ 只在持锁区域内直接访问,因此标注为 GUARDED_BY(mutex_);
•mem_ 会在 Writer leader 持有写入权但临时释放 mutex_ 时被访问;
•has_imm_ 则提供一个无锁的提示信号,让后台线程知道可能有 immutable MemTable 等待处理。
memory_usage_ 是 Arena 中唯一的原子成员。一个合理的解释是:分配状态只有唯一写者访问,但内存用量可能被其他线程并发读取。源码中的 TODO(util/arena.h:50-51)也说明,作者意识到了这种不对称,并没有把它包装成一条明确证明过的同步协议。
This member is accessed via atomics, but the others are accessed without any locking. Is this OK?
因此,更稳妥的结论是:
在 LevelDB 当前调用约束下,分配游标和块数组由单写者使用;memory_usage_ 则允许并发读取。Arena 本身并不是一个通用的线程安全分配器,它依赖上层协议提供并发约束。
把三个条件合在一起,就是:
对象变长、整代同生共死、写入天然串行。
正因为客户具备这些性质,Arena 才能把自己压缩成一个游标、一个剩余计数和一个块指针数组。
它的「简单」,不是编码风格,而是需求约束推导出来的结果。
04 4MB 的账单:write_buffer_size 量的是什么
write_buffer_size 容易给人一种直觉:设置为 4MB,就能放入 4MB 用户数据。
实际上不是。
MakeRoomForWrite 的判满条件是(db/db_impl.cc:1347-1348):
db/db_impl.cc
而 MemTable::ApproximateMemoryUsage() 只有一行(db/memtable.cc:26):
db/memtable.cc
因此,write_buffer_size 限制的不是用户 key 和 value 的总长度,而是 Arena 的记账值。
这本账包含:
• entry 编码后的字节;
• 跳表节点;
• 对齐垫片;
• 被放弃的块尾;
• 当前块尚未使用的空间;
• 每块 sizeof(char*) 的管理开销估算。
另外,判满检查发生在一次 Write 开始时,也就是 batch 插入之前。因此当前 MemTable 可以超过阈值,超出的幅度与最后一个 batch 的大小以及分配跨块情况有关。
include/leveldb/options.h:74-82 对 write_buffer_size 的说明是:
Amount of data to build up in memory (backed by an unsorted log on disk)
注释还特意提醒:
Up to two write buffers may be held in memory at the same time
两代并存这件事,后面的实验会直接看到。
把一代 MemTable 灌满
arena_probe fill 按 MemTable::Add 的节奏分配:
1. 根据 entry 编码规则(编码规则在 memtable.cc:76-99 中:varint 前缀 + internal key + 8 字节 tag + varint + value)计算记录长度;
2. 调用 Allocate;
3. 重放跳表层高(用 07 篇的办法以种子 0xdeadbeef 重放);
4. 根据层高计算节点大小;
5. 调用 AllocateAligned;
6. 在 MemoryUsage() 首次超过 4MB 时停止。
输入模拟短链服务的混合写入:
• 85% 主体记录(c:K%09ld → 28 字节 URL);
• 10% 点击计数;
• 5% 用户索引。
实验结果如下:
58625 条记录的用户数据,也就是 user key 与 value 之和,共 2166209 字节;Arena 记账为 4198392 字节。
端到端放大率为:
4198392 / 2166209 ≈ 1.94
换句话说,在这组负载下,名义上的 4MB 写缓冲只容纳了大约 2.1MB 用户数据。
我们可以将明细列出来。六个科目加起来恰好等于总账:
按照实验的记账模型,可以拆成以下几项:
其中有三项值得注意。
•Entry 编码开销
entry 平均长度约为 46.95 字节,payload 平均约为 36.95 字节,两者相差恰好 10 字节。
在本实验的长度范围内,这 10 字节主要来自:
• internal key 中的 8 字节 tag;
• key 长度 varint;
• value 长度 varint。
这是记录格式层的固定成本。
•跳表节点开销
节点平均约为 18.67 字节。
节点基础大小为 16 字节,每多一层增加一个 8 字节指针。上一篇已经得到期望层高约为 4/3,因此平均节点大小为:
16 + 8 × (4/3 − 1) ≈ 18.67
随机层高带来的平均成本,在这里精确地反映到了总账中。
•对齐垫片
slop 达到 318046 字节,是最显眼的一项 Arena 内部开销。
原因在于 entry 和节点交替分配。entry 是变长字节串,结束位置经常不在 8 字节边界上;紧随其后的节点需要对齐,于是反复产生 1 到 7 字节垫片。
这些垫片单次很小,累计起来却相当可观。
为什么实验中恰好是 1023 块
fill 实验结束时有 1023 个标准块。
每个标准块按 4104 字节记账:
1022 × 4104 = 4194288 1023 × 4104 = 4198392
而 4MB 是:
4 × 1024 × 1024 = 4194304
于是:
• 1022 块时,记账值仍比 4MB 少 16 字节;
• 继续插入记录后申请第 1023 块,记账值首次超过 4MB;
• 实验停止。
换一种负载、改变 batch 大小,或者出现单独分配的大对象,最终块数都可能不同。
稳定的不是「1023 块」,而是判满规则和 Arena 的记账方式。
两种放大率不能混为一谈
arena_test.cc 的 ArenaTest.Simple(随机尺寸分配十万次)断言(预热期过后,:47-48)arena 的总账不超过请求字节总和的 1.10 倍。
本实验中:
因此 Arena 层的放大约为:
4198392 / 3847163 ≈ 1.0913
在官方测试承诺的界内。
但这部分反映的是:
• 对齐垫片;
• 块尾浪费;
• 当前块剩余空间;
• Arena 的块级管理开销。
而端到端放大率 1.94 还包括:
• internal key 的 tag;
• varint;
• 跳表节点本身。
前者是 Arena 的账,后者还叠加了记录格式和数据结构的成本,不能全部归咎于 Arena。
05 Value 越小,固定开销越显眼
固定成本不会随着 value 同比例缩小,因此 value 越短,放大率通常越高。
arena_probe sweep 分别使用不同 value 大小填满一代 MemTable:
每一组实验都在相同的 Arena 记账阈值附近停止,因此总账相同;变化的是其中真正装入了多少用户数据。
• value 为 256 字节时,4MB Arena 大约能装下 3.6MB 用户数据;
• value 为 8 字节时,只能装下约 1.64MB,放大率达到 2.55。
这对计数类写入很有现实意义。
像 c:{code}:click 这样的记录,value 可能只有几个字节。此时 key、tag、长度前缀、跳表节点和对齐垫片占据了更大比例,MemTable 的实际可用容量会远小于名义上的 write_buffer_size。
所以,write_buffer_size=4MB 并不意味着所有业务都能积累约 4MB 用户数据后再 flush。真正能装多少,取决于记录形态。
06 出生与户口:MemTable 的引用计数
内存什么时候归还,最终由 MemTable 的引用计数决定。
refs_ 初始为零,创建者必须主动调用 Ref()(db/memtable.h:22-24 的注释里写得很清楚):
引用计数方法的实现很简单(db/memtable.h:29-39):
db/memtable.h
谁会持有 MemTable 的引用?
大体可以分为三类。
•所有者引用
始终恰好一个。
Open 方法的末尾(db/db_impl.cc:1503-1504):
db/db_impl.cc
这可以看作每一代 MemTable 的「出生登记」。
数据库关闭时,~DBImpl 先等待后台任务结束(db/db_impl.cc:152-159),再归还 mem_ 和 imm_ 的所有者引用(调用 Unref,db/db_impl.cc:166-167)。仍由数据库持有的最后几代 MemTable,会在这里进入销毁流程。
•Get 的瞬时引用
DBImpl::Get 在锁内取得:
•mem_;
•imm_;
• 当前 Version。
然后分别增加引用(db/db_impl.cc:1127-1132),再释放锁执行真正的查询(:1139-1150)。读取完成后重新加锁,归还引用(:1156-1158)。
这样做是因为,线程在放锁读取期间,后台 flush 可能已经完成。
如果没有临时引用,读线程手中的 MemTable 指针可能在使用途中被销毁。临时引用保证的是:
查询尚未结束时,底层 MemTable 对象不会消失。
•Iterator 的长生命周期引用
NewInternalIterator 会给创建时可见的 mem_、imm_ 和 Version 增加引用(db/db_impl.cc:1086、:1089、:1094),并把它们放入 IterState(:1055-1073)。
这些引用不会在函数返回时归还,而是注册到迭代器的清理回调中。只有迭代器析构时,它们才会被统一释放。
因此,一个长期存活的迭代器可能让旧 MemTable 在 flush 完成后继续存活。
需要注意的是,此时 DBImpl::imm_ 字段本身仍然可以被置为 nullptr。被延长的是旧 MemTable 对象的生命周期,不是 imm_ 这个成员变量持续非空。
这一区别很重要:
•imm_ == nullptr 表示 DBImpl 已经不再把它视为待 flush 的 immutable MemTable;
• 旧对象仍可能因为 Iterator 或瞬时读取引用而存活。
memtable.h:45-51 给 NewIterator 写的注释是同一个意思的合同条款:
"The caller must ensure that the underlying MemTable remains live while the returned iterator is live"
至于迭代器内部怎么层层持有、怎么统一清理,后面的文章再详细展开。
Flush 为什么不额外增加引用
WriteLevel0Table 中调用(db/db_impl.cc:512):
db/db_impl.cc
时没有额外给 mem 增加一次引用。
这是因为在后台 flush 期间,imm_ 名下的所有者引用已经足以保证对象存活。在 CompactMemTable 完成并显式执行 imm_->Unref() 之前,这一代 MemTable 不会消失。
这也是「所有者引用」和「临时借用」的区别:
• 所有者引用保证对象作为系统状态的一部分继续存在;
• 临时引用保证对象在一次放锁操作或外部 Iterator 生命周期中不会被提前销毁。
为什么 refs_ 不是原子量
refs_ 只是普通的 int。
原因不是引用计数天然线程安全,而是 LevelDB 把相关操作收束到了受控位置:
•MakeRoomForWrite;
•Get;
•NewInternalIterator;
•CleanupIteratorState;
•CompactMemTable;
•DBImpl 析构;
• 恢复阶段的单线程路径。
这些位置要么持有 mutex_,要么位于数据库尚未暴露给并发访问的初始化阶段(DBImpl::Recover 入口就有 mutex_.AssertHeld(),db/db_impl.cc:292-293;RecoverLogFile 里的临时 MemTable 同样 new 了就 Ref、flush 完 Unref,db/db_impl.cc:440-460)。
因此,引用计数的线程安全来自外部纪律:
所有可能并发发生的引用增减,都在同一把锁下完成。
refs_ 自己不提供同步能力。
07 换岗:mem_ 如何变成 imm_
MemTable 写满后,MakeRoomForWrite 会执行换代(db/db_impl.cc:1360-1382):
db/db_impl.cc
重点看这几行:
旧数据并没有被复制,也没有搬到其他地方:imm_ = mem_。
只是一次指针赋值。
同一个 MemTable、同一个跳表、同一个 Arena,从此由 imm_ 指向:
• 之前是可写的 mutable MemTable;
• 之后是冻结的 immutable MemTable。
内容一个字节都没有移动。
这里也没有对旧 MemTable 执行额外的 Ref() 或 Unref()。原来属于 mem_ 的所有者引用,随着指针角色的变化转移给了 imm_。
这属于所有权转移,不是新增一次借用。
随后,LevelDB 创建新的 WAL 和新的 MemTable,并为新 MemTable 建立所有者引用。后台 flush 任务也在这一步被调度。
has_imm_ 是什么
imm_ 由互斥锁保护,但后台 Compaction 线程(DoCompactionWork)有时会在不持锁的情况下查看 has_imm_(db/db_impl.cc:921-933),用它判断是否可能有 immutable MemTable 等待优先处理。
db_impl.h:179 的注释解释得很清楚:
So bg thread can detect non-null imm_。
写入侧使用:
读取侧使用 relaxed load(db/db_impl.cc:923)。
这里更准确的理解是:has_imm_ 主要承担「提示灯」作用,而不是让无锁线程直接通过它安全访问 imm_。
后台线程看到提示后,仍然需要:
1. 获取互斥锁;
2. 在锁内重新检查 imm_(:925-926);
3. 再执行相关操作。
真正保护 imm_ 和建立临界区同步关系的仍然是互斥锁。原子变量只是帮助后台线程在合适的时机检查它。
关于内存序的内容,可以参考番外 E01 中的内容。
08 消亡:CompactMemTable 的最后一站
后台线程接过 imm_ 后,会把它写成 SSTable,并将新文件安装进版本历史:
db/db_impl.cc
流程可以概括为:
1.WriteLevel0Table 将 imm_ 写成 SSTable;
2.LogAndApply 将新文件登记进版本历史;
3. 两步都成功后,归还 imm_ 的所有者引用;
4. 清空 imm_;
5. 放下 has_imm_ 信号灯;
6. 清理过期文件。
其中最关键的是:
如果此时没有其他线程持有瞬时读取引用,也没有 Iterator 保留它,那么引用计数归零,销毁过程立即开始。所以,旧 MemTable 真正释放的时间点不是「数据写完 SSTable」的那一刻,而是:
flush 和版本安装成功之后,最后一个引用被归还的那一刻。
多数情况下,两者非常接近,因为 Get 的瞬时引用通常很短(只有几微秒)。
但如果某个 Iterator 长期存活,旧 MemTable 对象也会继续存活,即使它早已不再由 DBImpl::imm_ 指向。
从 Unref() 到 delete[]:一代 MemTable 如何真正消亡
把整条调用链展开来看,从 Unref() 到最终的 delete[] 之间没有任何魔法:
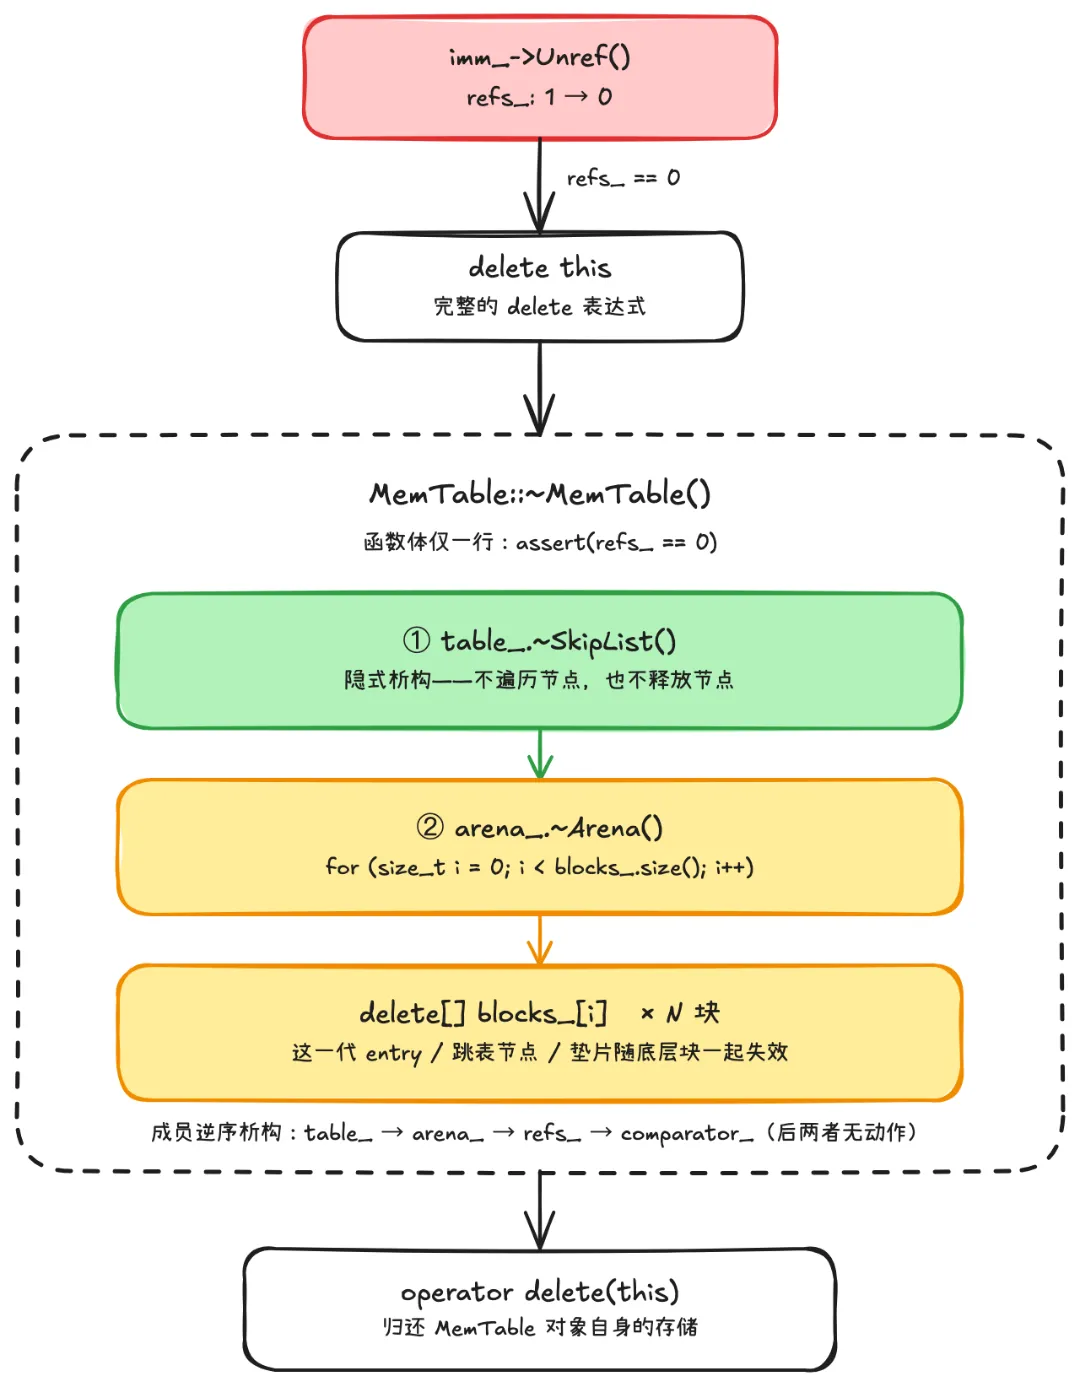 从 Unref() 到 delete[] 的完整调用链
Unref() 本身只做两件事:
1. 将引用计数减一;
2. 在计数归零时执行 delete this。
真正启动对象销毁流程的,是后者。
delete this 是一个完整的 delete 表达式,不是对析构函数的一次普通调用。对于这里这个由 new MemTable 创建的对象,它大体分成两个阶段:
1. 调用 MemTable::~MemTable(),完成对象析构;
2. 调用匹配的 deallocation function,释放 MemTable 对象自身占用的存储。
MemTable::~MemTable() 的函数体很短,只有一句(db/memtable.cc:24):
db/memtable.cc
但函数体短,不等于析构过程到这里就结束了。
析构函数体执行完之后,编译器还会按照成员声明顺序的逆序,自动调用各个非静态数据成员的析构函数。
MemTable 中与这里有关的成员声明顺序是:
db/memtable.h
所以析构顺序相反:table_ → arena_ → refs_ → comparator_。
为什么 SkipList 不遍历节点
table_ 是 SkipList。它没有自定义析构函数,因此执行的是编译器生成的隐式析构。
这个过程只会销毁 SkipList 自身的成员,例如:
• 比较器;
• Arena 指针;
• 头节点指针;
• 最大层高;
• 随机数生成器。
它不会沿着跳表遍历节点,更不会逐个释放节点。
原因在于,SkipList 并不单独拥有这些节点的存储。节点只是从 Arena 中切出来的一段段裸内存,它们没有各自对应的 delete。
紧接着销毁的是 arena_。这一步才真正触发整代 MemTable 的内存释放:
util/arena.cc
~Arena 遍历 blocks_,对每个由 new char[block_bytes] 申请的内存块执行 delete[]。
这一代 MemTable 中的:
• entry;
• 跳表节点;
• 对齐垫片;
• 已经放弃的块尾;
• 当前块尚未使用的剩余空间;
都随着这些底层内存块一起失效。
值成员为什么重要
这里有一个容易被忽略,但非常关键的 C++ 对象关系:
arena_ 是 MemTable 的值成员,不是裸指针。
因此,只要 MemTable 正常析构,编译器就一定会继续调用:
如果成员写成:
那么销毁 MemTable 时,编译器只会销毁这个指针本身,不会自动销毁它所指向的 Arena。
Arena 和它管理的所有内存块都会泄漏。
值成员与指针成员的差别,在这里不是语法细节,而是整代内存能否沿着对象所有权链自动释放。
Private 析构为什么不妨碍 delete this
MemTable::~MemTable() 被声明为 private,但这不会妨碍 delete this。
原因是,delete this 写在 MemTable::Unref() 内部,而类的成员函数有权限访问自己的 private 析构函数。
private 析构函数在这里反而表达了一种生命周期约束:外部代码不应该随意对 MemTable* 执行 delete,而应该通过 Ref() 和 Unref() 管理它。
最终的销毁入口被收束到了类自己的引用计数协议中。
两组分配和释放必须配对
这里还有两组必须严格对应的关系。
MemTable 对象自身通过:
创建,因此最终由:
销毁。
Arena 中的块则通过:
创建,因此必须由:
销毁。
数组形式的 new[] 必须与 delete[] 配对,而不能写成普通 delete。
整个释放过程实际存在两层:
• 第一层:delete[] blocks_[i],释放 Arena 管理的全部数据块
• 第二层:operator delete(this),释放 MemTable 对象自身的存储
两层释放与两组分配的配对关系如下图所示:
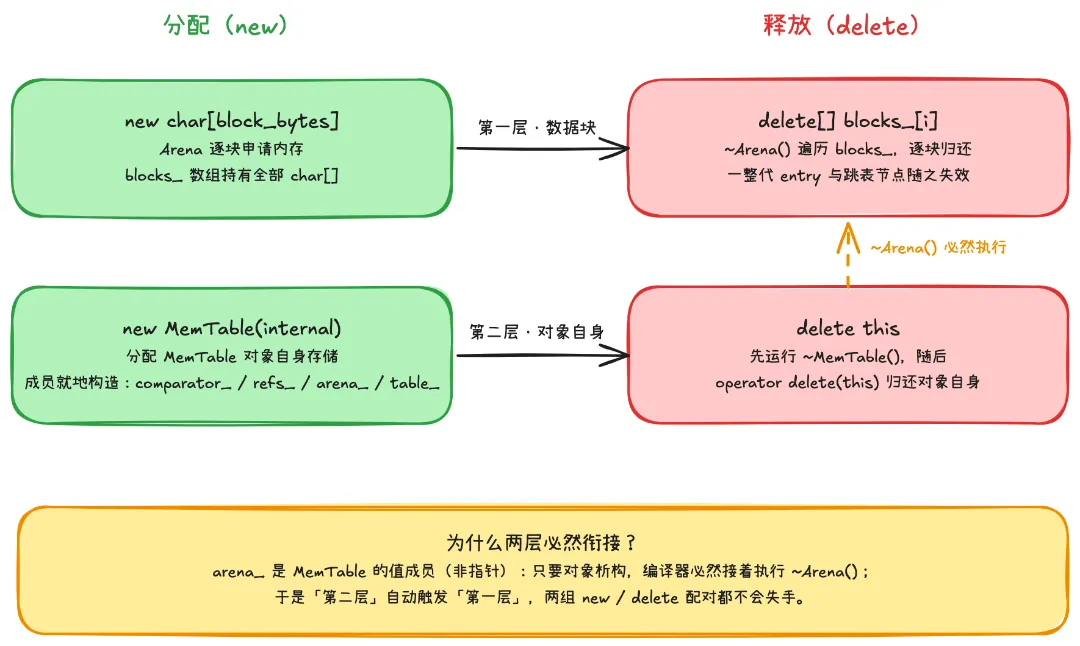
两层释放与两组分配的配对关系
前一层释放的是一整代 entry 和跳表节点;后一层释放的只是 MemTable 这个管理对象本身。
内存先还给谁
~Arena 中的 delete[] 会把内存归还给 C++ 运行时使用的堆分配器。
但这并不意味着操作系统观察到的 RSS 会同步下降。
更准确的路径是:
因此,「Arena 已经释放」与「RSS 已经下降」是两个不同层次的问题。
当 delete[] 返回后,这些块已经不再属于 Arena,也不能继续访问。但底层分配器可能把对应页保留在自己的空闲结构中,等待后续分配复用。
于是可以同时出现:
• LevelDB 视角:旧 MemTable 已销毁,Arena 块已 free
• 操作系统视角:相关页仍然驻留,RSS 没有下降
两者并不矛盾。
释放发生在谁手里,又发生在什么锁下
这条析构链还有一个容易被忽略的并发含义:
它发生在后台线程手里,而且发生在持锁的收尾阶段。
CompactMemTable 进入时要求持有 mutex_(db/db_impl.cc:292-293):
不过,它调用的 WriteLevel0Table 会在最重的 BuildTable 阶段临时释放互斥锁,让前台线程仍有机会继续执行不依赖该 immutable MemTable 的工作。
关于这一段放锁写盘的窗口,下一篇分析 flush 时再详细展开。
这里需要关注的是 flush 成功后的收尾:
执行这段代码时,后台线程已经重新持有 mutex_。
因此,如果 imm_->Unref() 恰好把引用计数减到零,那么随后发生的整条析构链:
都会在持有 DBImpl::mutex_ 的情况下执行。
对于 fill 实验中的那一代 MemTable,这意味着后台线程会在锁内对 1023 个内存块执行 delete[]。在此期间,需要获取同一把锁的前台操作都只能等待。
这揭示了一个具体的延迟来源:
Arena 让整代回收变得极其简单,但「简单」不等于「零成本」。大量内存块的释放被集中到了最后一次 Unref(),并且在正常 flush 路径中发生在持锁阶段。
当然,仅凭「1023 次 delete[]」不能断言它一定会产生明显的长尾延迟。
每次释放的实际成本还取决于:
• 底层分配器;
• 线程缓存;
• 内存块大小;
• 当前堆状态;
• 操作系统内存压力。
但从调用路径上可以确定:这部分成本位于临界区内,分析写入暂停和尾延迟时值得记上一笔。
另外,delete[] 首先把内存交还给进程使用的堆分配器。分配器是否立即将对应物理页归还操作系统,是另一个层次的问题。
因此,这里可以确定的是 Arena 已经解除对这些块的所有权,却不能据此推断 RSS 会同步下降。
恢复路径遵循同一套生死制度
引用计数和 Arena 整代回收不只用于正常写入与后台 flush。数据库恢复过程同样遵循这套规则。
RecoverLogFile 重放 WAL 时,会临时创建一个 MemTable,并立即建立引用:
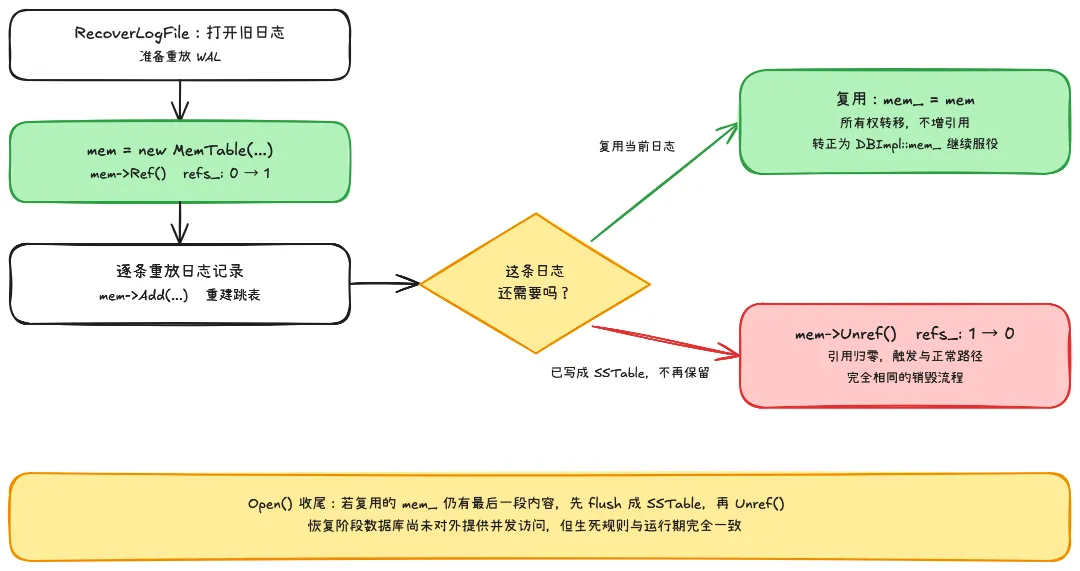
恢复路径中的 MemTable 生命周期
如果这个临时 MemTable 已经写成 SSTable,并且不再需要保留,那么 Unref() 会将引用计数减到零,触发与正常路径完全相同的销毁流程。
如果恢复过程决定复用当前日志,情况则不同。此时会执行类似 mem_ = mem; 的语句,将临时 MemTable 转交给 DBImpl::mem_。
这里不是新增加一次引用,而是所有权转移:原本由恢复过程持有的那个引用,后来改由 mem_ 代表。
对象没有被复制,引用计数也不需要先减后加。
如果 Open 收尾时仍有最后一段 MemTable 内容需要写成 SSTable,则在 flush 完成后再调用 Unref(),让它按照同样的规则退出生命周期。
与正常运行阶段不同,恢复和 Open 收尾主要发生在数据库还没有对外提供并发访问的阶段。
这时生命周期管理仍然采用:
•Ref();
• 所有权转移;
•Unref();
但不需要与前台读写线程争抢同一套并发访问权。
这也说明,Ref()/Unref() 不只是后台 flush 的局部技巧,而是贯穿 MemTable 各条创建和退出路径的统一生死制度:
• 正常打开数据库时使用;
• MemTable 换代时使用;
• 后台 flush 时使用;
•Get 和 Iterator 临时保活时使用;
• WAL 恢复时使用;
• 数据库关闭时仍由它完成最后清场。
三个问题,到这里形成闭环
至此,开篇的三个问题才算真正回答完整。
这些字节什么时候、由谁回收?
在 flush 和版本安装成功后,后台线程归还 imm_ 的所有者引用。如果这恰好是最后一个引用,Unref() 就在持锁阶段执行 delete this,继而调用 ~MemTable 和 ~Arena。
Arena 再遍历 blocks_,逐块执行 delete[],将整代内存统一交还给进程的堆分配器。
旧的一代在哪里等待,又在什么时候真正消亡?
它没有搬家,也没有复制。
imm_ = mem_ 只是一次指针角色转换:同一个 MemTable、同一个跳表、同一个 Arena,从可写状态变成冻结状态,在原地等待后台 flush。
flush 成功并不等于对象必然当场死亡。只有当所有者引用和 Get、Iterator 等其他引用都已经归还后,引用计数才会归零。
DBImpl::imm_ 可以已经置空,但旧 MemTable 对象仍可能因为其他引用继续存活。
Arena 为什么敢把内存管理做得如此简单?
因为它的客户恰好满足三条约束:
• 对象大小变化,但都可以顺序分配;
• 一代对象同生共死,不需要单个回收;
• 写入由 Writer leader 串行执行,不需要支持并发分配。
通用分配器最复杂的那些职责,在这个场景中根本不存在。
Arena 不是忽略了这些能力,而是利用 MemTable 的生命周期结构,从设计上把这些需求消掉了。
09 上机:两代并存与 RSS 的阶梯
mem_ramp 持续批量写入短链,并周期性采样两个指标:
•leveldb.approximate-memory-usage;
• 进程 RSS。
leveldb.approximate-memory-usage 的实现(db/db_impl.cc:1431-1443)会统计 block cache 载荷,加上 mem_ 和 imm_ 两个 MemTable 的 Arena 用量。
实验设计采用每 500 条一个 batch、sync=false、key c:K%09ld、value 是 29 字节的完整 URL。每 5000 条对上述两个指标进行采样。
本实验只写不读,没有主动形成数据块读取负载,因此采样值的主要部分来自两代 MemTable。
节选输出如下:
第一行就能看出按块记账的效果:
41040 = 10 × 4104
500 条短链约 37.7KB,mem_usage 却记了 41040 字节——第 10 块还没装满,但账已经按照十个完整块记上了。
mem_usage 呈现出明显的锯齿形:
1. 当前 mem_ 逐步增长;
2. 超过 4MB 后换代(约五万五千到六万条一代,斜率 75.5 字节每条——和上一节 fill 实验的 71.6 字节对得上,差异在 value 是 29 字节完整 URL 而非 28 字节截断);
3.imm_ 和新 mem_ 在一段时间内并存;
4. flush 完成,旧代的所有者引用被归还;
5. 如果没有其他引用,旧对象销毁,属性值快速回落;
6. 新一轮增长开始。
把几个换代周期连起来看,形状如下:
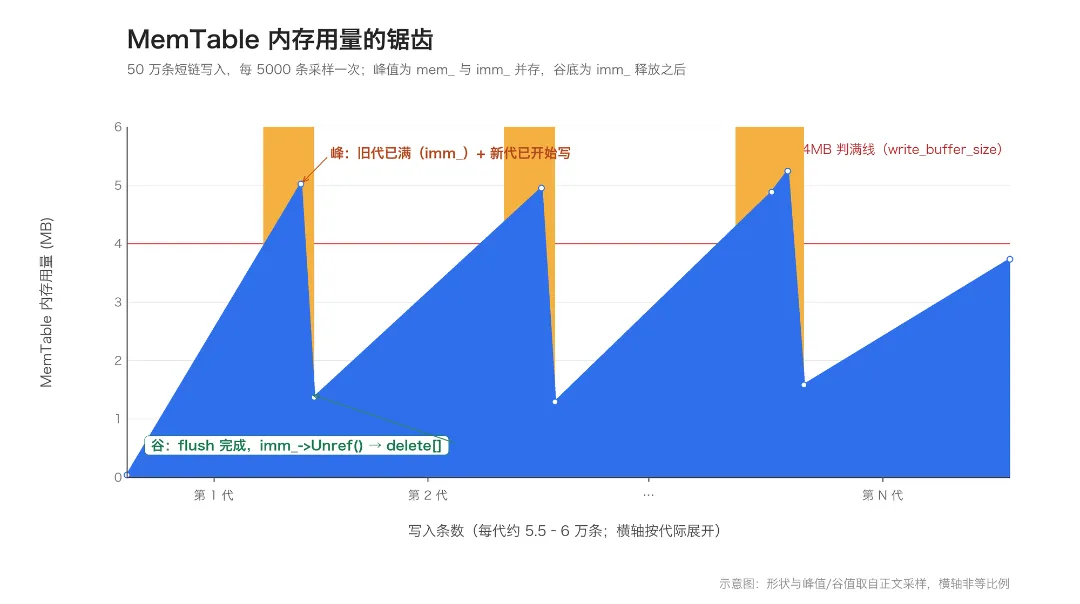
mem_usage 的锯齿形曲线:增长、换代、回落、再增长
峰值为什么超过 4MB
锯齿的峰为什么是 5.02、5.24,而不是恰好 4MB 或最坏 8MB?有两个原因共同作用。
首先,判满检查发生在 batch 插入之前,而且条件是:
只要检查时尚未超过,整个 batch 仍会继续写入。因此,单代 MemTable 本身就可能超过 4MB。
其次,采样可能落在两代并存窗口中。
例如:
465000 条时,可以解释为:接近满载的 imm_(约 4.88MB)和已经开始接收写入的新 mem_(约 0.37MB)。
到 470000 条时,旧代已经完成 flush,并且旧对象不再计入属性,只剩新代。
如果后台存储很慢,imm_ 长时间没有处理完,写入端会在发现 immutable MemTable 仍存在时等待。这个停写机制阻止第三代继续堆积,也使主要内存项通常受「两代写缓冲」约束。
options.h 注释里
Up to two write buffers may be held in memory at the same time
说的就是这个窗口。
所以,容量规划中常用的主项估算是:
它是容量估算,不是逐字节的严格上界。
为什么 Arena 释放后 RSS 不立刻下降
实验中,mem_usage 会在 flush 后断崖式回落,但 RSS 往往不会同步下降。
这并不意味着 Arena 没有执行 delete[]。
delete[] 首先把内存交还给进程的堆分配器。为了提高后续分配速度,分配器可能继续保留这些页,而不是立即把它们归还给操作系统。
实际路径更接近:
因此会出现:
• LevelDB 的存活 Arena 字节已经下降;
• 堆分配器中存在大量可复用空闲页;
• 进程 RSS 仍然维持在高位。
三个视角分别回答什么
可以不修改 LevelDB 源码,直接从三个视角交叉验证:
•ps 和 vmmap 回答:页有没有留下,主要落在哪类内存区域;
•heap 回答:当前还有多少堆对象真正活着;
•leaks 回答:是否有分配已经失去所有引用,形成真正泄漏。
三者观察的不是同一个概念:
• RSS:进程当前驻留了多少物理页
• heap live allocations:分配器认为还有多少分配处于使用状态
• leaks:活跃分配中是否有对象已经无法从已知根访问
如果 RSS 与存活分配同时上升,可以怀疑对象或元数据在累积。
如果 RSS 上升,但存活分配没有上升,甚至略有下降,那么新增 RSS 就不能由仍然活着的 LevelDB 对象解释。更可能的情况是:对象已经 free,但底层分配器仍然保留对应页。
拉长实验时间
另跑一次更长时间的写入实验,在运行时观察:
实验中抽取的两个时刻大致如下:
• 时刻 A(约 200 万条):
• RSS ≈ 17.9MB
• heap 存活 ≈ 4.9MB
• 时刻 B(约 500–600 万条):
• RSS ≈ 22.5MB
• MALLOC_SMALL resident ≈ 21.1MB
• heap 存活 ≈ 4.4MB
从 A 到 B,RSS 增加了约 5MB,但 heap 统计的存活分配没有增加,反而从约 4.9MB 降到了 4.4MB。这个对比非常关键。
如果 RSS 的增长主要来自 L0 元数据或 VersionSet 版本链,那么这些内容应仍以活跃堆分配的形式存在,heap 的存活字节也应该增长。
实际观测并非如此,因此,多出来的 RSS 不能主要由仍然活着的 LevelDB 对象解释。
存活的 4.4MB 里有什么
查看 heap 输出可以发现,4.4MB 中绝大部分是 non-object 裸字节。
这与 Arena 的行为一致。Arena 的底层块来自 new char[block_bytes]。它们是原始字符数组,通常会在堆分析工具中表现为裸字节分配。存活堆中的大头,因此基本可以由当前的 mem_ 和可能并存的 imm_ 解释。
相比之下,带明确类型的 LevelDB 对象很少。例如实验中观察到:
• PosixMmapReadableFile:80 个,单个约 64B,总计约 5KB
• PosixWritableFile:2 个,总计约 139KB
• DBImpl:1 个,总计约 688B
• MemTableIterator:少量,单个几十字节
这些对象确实占用内存,但没有随着 MemTable 代际推进增长到 MB 量级。
因此,「L0 元数据持续累积导致 RSS 上升」的解释可以进一步收窄:
• L0 文件对象存在;
• VersionSet 等元数据也存在;
• 但它们在 heap 中只是几十 KB 到较小规模;
• 无法解释数 MB 的 RSS 增长。
为什么差额落在 MALLOC_SMALL
vmmap 显示:
新增 RSS 的主要部分落在 malloc 管理的小对象区域,而不是文件映射或某个持续增长的独立大块。同时 heap live allocations 只有约 4.4MB,差额说明这些页仍驻留在 malloc 管理的区域中,但其中相当一部分字节已经不属于活跃分配。
更符合观测的解释是:
1. Arena 反复通过 new char[4096] 申请标准块;
2. MemTable 销毁时,delete[] 将块交还给 libmalloc;
3. libmalloc 将块放入自己的空闲结构;
4. 为服务后续分配,相关页继续驻留;
5. 新一代 MemTable 可以复用其中一部分空间;
6. 分配器没有立即把所有空闲页归还操作系统;
7. RSS 因此不跟随 MemTable 的锯齿同步下降,并可能随着页池扩张缓慢上升。
所以,原先的推测可以从「可能是 L0 元数据和 VersionSet 版本链在积累」收窄为「L0 元数据和 VersionSet 状态确实存在,但在这组 heap 观测中只占较小规模;RSS 碎步的主要来源,更符合 libmalloc 空闲页池缓慢膨胀的特征」。
为什么 leaks 多半报不出来
leaks 在这里大概率不会报告问题。
这些页并不是失去指针的内存。
从 LevelDB 的角度看,Arena 已经执行 delete[];从分配器的角度看,这些内存也已经进入空闲状态。它们仍然挂在分配器的管理结构中,可以被后续分配重新利用。
这种状态是已经 free,但尚未归还操作系统。而真正的泄漏却是仍处于 allocated 状态,但程序已经无法通过有效指针访问。两者不是同一个问题。没有泄漏,只能说明没有明显的不可达活跃分配;它不能说明分配器已经把空闲页返还给操作系统。
如何再确认一步
可以在一次 flush 完成后的空档,主动要求分配器释放可回收的空闲页。
macOS 可以尝试:
glibc 环境可以尝试:
如果调用后 RSS 明显回落,就能进一步说明:
• 相关块此前已经被 LevelDB delete[];
• 它们没有被存活元数据引用;
• 相关页仍在堆分配器的空闲池中;
• 施加回收压力后,分配器才把一部分页返还系统。
这种测试会改变进程的内存管理行为,适合用于诊断,不宜未经评估直接放进正常写入路径。
主动归还内存可能降低 RSS,也可能让后续分配重新触发系统级内存申请。分配器保留空闲页,本来就是在 RSS 与后续分配速度之间做权衡。
如何追踪分配来源
如果想继续回答「这些页最初由谁申请」,可以打开分配栈记录。
macOS 下可使用 MallocStackLogging=1,然后执行:
根据地址回查分配栈。
也可以使用 Instruments:
• Allocations 查看分配与释放时间线;
• VM Tracker 查看虚拟内存区域和 resident 变化;
• 将 MemTable 换代点与内存曲线对应起来。
Linux 上可使用:
如果使用 jemalloc,还可以通过 malloc_stats_print 比较:
• allocated
• active
• resident
• retained
由此区分:
• LevelDB 当前仍拥有多少 Arena 字节;
• 分配器保留了多少空闲页;
• 操作系统实际让多少页驻留。
可以下到什么程度的结论
根据目前的 vmmap 与 heap 观测,可以较有把握地说:
1. MemTable flush 后,Arena 的块确实通过 delete[] 进入释放流程;
2. RSS 没同步下降,不代表这些块仍被 LevelDB 对象持有;
3. 从 A 到 B,RSS 增长约 5MB,但存活堆字节没有增加;
4. LevelDB 带类型的存活对象只占很小一部分;
5. 新增驻留内存主要落在 MALLOC_SMALL;
6. RSS 碎步主要符合 libmalloc 保留空闲页的行为,而不是 L0 元数据或 VersionSet 对象持续增殖。
还不能仅凭这些实验断言的,是 libmalloc 内部哪条具体策略导致页池只涨不缩。
常见解释是:分配器保留空闲页,以减少后续系统级分配操作的成本。这个解释与观测一致,但若要精确到具体实现机制,还需要继续追踪分配栈、zone 状态,或者阅读对应系统版本的分配器源码。
10 对比参照:三个内存管家
把 LevelDB Arena、Redis 的对象分配和 InnoDB Buffer Pool 放在一起看,会发现它们实际上在解决三种完全不同的问题。
•LevelDB Arena:整代回收
LevelDB MemTable 中的对象:
• 大小不固定;
• 生命周期高度一致;
• 不需要单个删除;
• 整代对象拥有明确的共同终点。
因此,Arena 选择:
• 变长顺序分配;
• 不支持单对象释放;
• 整代统一回收。
•Redis:对象独立生死
Redis 中的 SDS 字符串、dict 条目、zskiplist 节点,全是逐个 malloc 出来的普通对象,生命周期各异。
对象可能随时:
• 插入;
• 更新;
• 删除;
• 扩容;
• 单独释放。
这种场景需要通用分配器提供 size class、空闲块复用和单对象回收能力。
Redis 官方构建默认绑 jemalloc(源码内还带 zmalloc 封装层和 fragmentation 相关统计)。
代价是碎片率成为长期需要观察和治理的问题。它的对策不是消除问题,而是观测问题:INFO memory 里的 mem_fragmentation_ratio(RSS 与 used_memory 之比)超过 1.5 左右就该警惕,4.0 之后甚至加了 activedefrag 主动整理。
LevelDB 的 Arena 不需要解决同一种长期碎片问题,因为碎片不会跨代永久累积。只要一代 MemTable 真正销毁,属于这一代的内部空洞就会一起消失。
•InnoDB Buffer Pool:固定页帧
InnoDB Buffer Pool 管理的核心单位是页。
整个池子切成 16KB 的页帧,页需要在磁盘与内存之间换入换出,也需要让任意页进入任意可用页帧。因此,固定大小是整个换页机制成立的基础。
页内的变长记录如何排列,则交给页内部结构处理。代价是页内空间的管理(变长行在页内怎么摆、溢出页怎么办)得另写一套 Slotted Page 的逻辑。
这三种设计可以用三个问题区分:
1. 对象尺寸是否固定?
2. 不同对象的生命周期是否一致?
3. 是否需要单独回收?
答案不同,合理的内存管理结构也完全不同。
Arena 的「简单」,不是风格偏好,而是约束塑造出来的形状。
11 工程启示
用好 LevelDB
1不要把 write_buffer_size 当成用户数据容量。它约束的是 Arena 记账值,不是 key 与 value 的总长度。记录越短,entry 固定编码、跳表节点和对齐垫片所占比例越高,实际可以容纳的用户数据越少。
2按两代写缓冲估算主要内存。常驻内存的主要部分可以粗略估算为「block cache + 2 × write_buffer_size + 其他运行时开销」。其他运行时开销包括:
• WAL 与文件对象;
• Version、Table 等元数据;
• 堆分配器保留的空闲页;
• 线程栈与运行库开销。
这个公式用于抓住主项,不能代替真实压测。
3小 value 负载要特别留意固定开销。计数类记录的 value 很短,放大率可能显著高于主体数据。如果业务中存在大量短 key、短 value 热写,可以考虑:
• 调大 write_buffer_size;
• 在应用层聚合更新;
• 减少重复性较强的 key 前缀;
• 使用真实负载压测 MemTable 的换代频率。
4使用正确的观测指标。leveldb.approximate-memory-usage 适合观察:
•mem_ 增长;
•mem_ 与 imm_ 并存;
• flush 后旧代退出统计;
• block cache 与 MemTable 的主要内存变化。
但它不等于:
• 用户数据量;
• 精确堆占用;
• 进程 RSS;
• 操作系统实际可回收的物理页。
这些指标处在不同层次,不能混为一谈。
设计借鉴
1Arena 适合「一批对象同生共死」的场景。典型例子包括:
• 语法解析生成的 AST;
• 编译器中间表示;
• 单次请求中的临时对象;
• 游戏引擎的一帧分配;
• 批处理任务中的阶段性中间结果。
实现可以很短,收益却很直接:
• 单对象无额外元数据;
• 分配路径短;
• 局部性好;
• 整批回收简单。
但前提不可妥协:这批对象确实不需要单独删除。
一旦生命周期开始分化,Arena 节省下来的复杂度就会转化为无法提前回收的空间浪费。
2引用计数本身不是并发安全的全部答案。LevelDB 的 refs_ 只是普通整数。它能够正确工作,依赖两条外部纪律:
• MemTable 冻结后不再修改;
• 引用增减经过统一的锁,或发生在单线程初始化阶段。
真正重要的不是“用了引用计数”,而是系统明确回答了:
• 谁可以持有引用;
• 在什么锁下取得;
• 在什么锁下归还;
• 哪一个引用代表所有权;
• 哪些引用只是临时借用;
• 所有权在什么位置发生转移。
3分代可以主动消除回收复杂度。很多并发系统最难处理的并不是“如何加锁”,而是一个对象此刻究竟还被谁使用,什么时候才可以安全删除?LevelDB 的做法,是把这个问题限制在代际边界上:
• 一代内部只增加,不删除;
• 换代时通过指针完成角色交接;
• flush 后归还所有者引用;
• 最后一个使用者放手时,整代销毁。
它不是把复杂的单对象回收问题解决得更巧,而是通过结构约束,让大量单对象回收问题根本不出现。
一代,一生,一次清算。
现在可以重新回答开篇的三个问题。
这些字节什么时候、由谁、按照什么规则回收?在 flush 和版本安装成功之后,后台线程归还 imm_ 的所有者引用。如果没有其他读取或迭代器继续持有引用,计数归零,后台线程在持锁阶段执行 delete this。随后,~MemTable 按逆序销毁成员,~Arena 遍历 blocks_,对全部内存块逐一执行 delete[]。
旧的一代在哪里等待?它没有搬家。imm_ = mem_ 只是一次指针角色转换。同一个 MemTable、同一个跳表、同一个 Arena,从可写状态变为冻结状态,在原地等待后台线程将它写成 SSTable。
Arena 为什么敢如此简单?因为它的客户满足三个条件:对象大小不固定;一代对象同生共死;写入由单一 leader 串行完成。通用分配器最复杂的那些职责,在这个场景中并不存在。
不过,故事到这里还只讲了一半。
CompactMemTable 中最重的那一步:
我们仍然只是一笔带过。
那 58625 条 entry 是如何变成一个 .ldb 文件的?SSTable 内部有哪些数据块和索引?为什么新文件通常进入 Level 0?Level 0 又为什么与其他层不同?flush 期间那段放锁写盘的窗口,以及最后持锁清场的收尾,分别会阻塞谁,又会持续多久?
下一篇:Flush:从 Immutable MemTable 到 Level 0。
如果这篇对你有帮助,欢迎点赞、在看或转发给正在读 LevelDB 的朋友。
附录:本篇示例与实验代码
arena_probe.cc:arena 的解剖与记账工具。核心是 07 篇「重放对账」方法论的延续——ArenaSim 逐行复刻 arena.cc 的分配决策(4096B 块、>1024B 单独成块、8B 对齐、每块记 block_bytes + sizeof(char*)),只记账不真分配,每轮与真实 MemoryUsage() 比对,MATCH 为准。层高同样以种子 0xdeadbeef 的 Random 重放。walk 六步命中全部分支,fill 按短链混合负载(85% 主体 / 10% 计数 / 5% 索引)灌满一代并拆账,sweep 对不同 value 尺寸各灌一代看放大率。
编译(leveldb/ 目录):
mem_ramp.cc:MemTable 换代期的内存观察。批量写入短链,周期性采样 leveldb.approximate-memory-usage(两代 MemTable 之和 + block cache 电荷)与进程 RSS(ps 读取),看「4MB 写满 → mem/imm 并存 → flush 回落」的完整锯齿。写入不读,cache 电荷恒为 0,采样值即两代净用量。工具开跑前会删掉 dbpath 重新建库。
编译(leveldb/ 目录):
完整代码与编译、运行命令见 GitHub 仓库,或点击「阅读原文」获取。
关注公众号
你的公众号名称
持续更新 LevelDB 源码笔记、存储引擎与后端工程实践。如果这篇对你有帮助,欢迎关注、点赞或在看。