ARTICLE · 1376640
数智人事系统(二十一):知识库文档的入库与清理
数智人事系统(二十一):知识库文档的入库与清理
在企业日常办公中,员工手册、考勤制度、请假规定和业务操作说明等文档,通常分散在不同的文件或系统中。员工想了解某项制度,或查询某个业务流程时,往往需要人工查找,效率不高。
如果希望 AI 助手能够依据企业内部的制度和文档回答问题,就需要先建立统一的知识库,将这些资料集中管理,并为后续的知识检索和问答提供数据基础。
本期目标
本期主要完成知识库文档的入库与清理,包括创建文档记录、异步完成解析与切片、生成并保存向量、维护处理状态,以及在删除文档时清理相关数据。
切片算法、向量生成的具体细节,以及检索和问答功能的完整实现,将放在后续第 22~24 期介绍。
需求分析
知识库模块主要负责管理企业内部文档,并为后续的知识检索和问答提供数据基础。结合这一目标,需要实现以下几项基本功能。
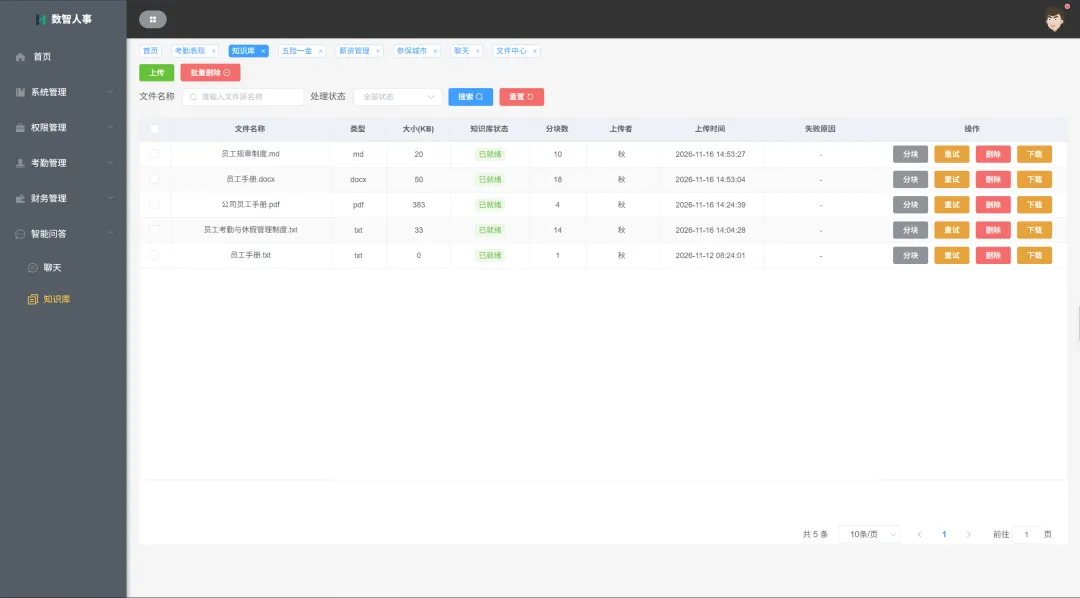
文档列表与状态展示:用户进入知识库页面后,可以查看已上传的文档,包括文档名称、文件类型、文件大小、上传时间和处理状态等信息。文档解析需要一定时间,因此页面还需要展示当前处理状态,让用户了解文档是否已经处理完成,或是否处理失败。
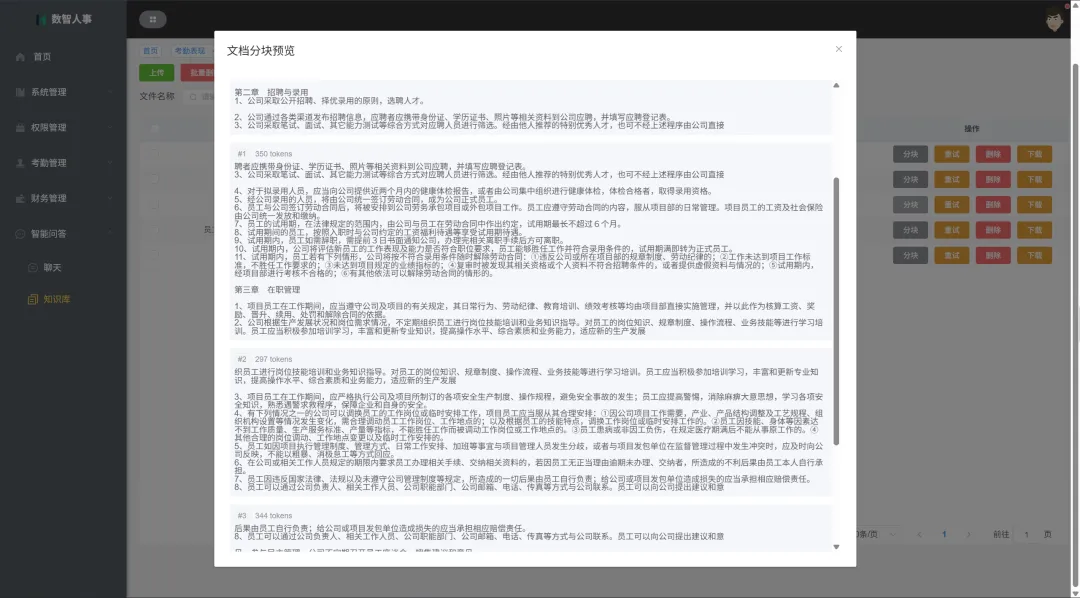
查看文档切片:文档处理完成后,用户可以查看系统生成的文本切片,了解原始文档被拆分成了哪些内容。每个切片需要展示对应的文本,方便检查解析和切片结果是否符合预期。
文档重新处理:用户可以对处理失败或已经处理完成的文档重新发起处理。处理失败的文档可以通过重试恢复处理;对于已经处理完成的文档,也可以根据需要重新解析,生成新的切片和向量数据。
删除文档:用户可以删除不再需要的知识库文档。删除后,不仅需要移除文档列表中的记录,还要清理对应的切片、向量数据和原始文件,避免留下无效数据。
方案设计
技术选型
知识库模块涉及文档存储、文本处理、向量化和检索等环节,主要技术选型如下:
文档元数据需要关联员工信息,并参与现有业务事务,因此继续使用 MySQL 主库。向量检索使用 PostgreSQL 的 pgvector 扩展,同时利用 PostgreSQL 的文本查询能力实现关键词检索,无需额外引入独立的向量数据库。相应地,项目需要额外维护一套 PostgreSQL 实例,并处理 MySQL 与 PostgreSQL 之间的数据清理问题。
配置说明
模型地址、凭据和模型名称统一放在 llm.* 配置项中:
# application.yml:114llm: base-url: ${LLM_BASE_URL:https://dashscope.aliyuncs.com/compatible-mode} api-key: ${LLM_API_KEY:} chat-model: ${LLM_CHAT_MODEL:qwen3.7-flash} embedding-model: ${LLM_EMBEDDING_MODEL:qwen3.7-text-embedding-flash} rerank-model: ${LLM_RERANK_MODEL:qwen3.7-text-rerank}切片参数单独放在 kb.chunk.* 配置项中:
# application.yml:130kb: enabled: true chunk: max-size: 1000 overlap: 100模型名称和密钥通常会随部署环境变化,也不适合直接提交到代码仓库,因此通过 spring.config.import 从 .env 文件中读取:
# application.yml:10spring: config: import: optional:file:.env[.properties],optional:file:hrm-server/.env[.properties]这里配置了两个查找路径,分别对应从项目根目录和 hrm-server/ 目录启动应用的情况。optional: 前缀表示即使对应的 .env 文件不存在,应用也可以继续启动。配置示例放在随代码入库的 hrm-server/.env.example 中,用占位值列出需要在部署环境中提供的变量:
# .env.example:10LLM_API_KEY=<API密钥>LLM_BASE_URL=https://dashscope.aliyuncs.com/compatible-modeLLM_CHAT_MODEL=qwen3.7-flashLLM_EMBEDDING_MODEL=qwen3.7-text-embedding-flashLLM_RERANK_MODEL=qwen3.7-text-rerankJWT_SECRET=REPLACE_WITH_BASE64_JWT_SECRET其中,五个 LLM_* 变量对应 llm.* 配置项,JWT_SECRET 则由认证模块单独使用。这样,切换模型或修改密钥时,只需要调整 .env 文件,不必修改源码或提交敏感配置。
切片参数由 IngestionPipeline 读取。max-size: 1000 用于限制单个切片的最大字符数,overlap: 100 表示相邻切片之间保留 100 个字符的重叠,以减少切片边界处的上下文丢失。切分逻辑本身是纯函数,参数由调用方传入;具体切分过程将在后续介绍摄入流水线时展开。
实现方案
知识库模块主要分为文档管理、文档摄入和检索数据管理三个部分。各部分职责相对独立,并通过文档 ID 关联数据。
文档管理
负责文档信息入库、状态维护、查询、重试和删除。文档上传完成后,系统先创建文档记录,并将其状态初始化为待处理。后续处理过程中的状态变化和处理结果,都通过该记录统一维护。
文档摄入
负责将原始文档转换为可检索的数据,这一过程可以概括为 ETL(提取、转换、加载)。主要步骤包括文件读取、解压、内容解析、文本清洗、切片、向量化和结果存储。上传回调会根据文件类型决定是否使用 zstd 压缩后再存入 MinIO;摄入时则先根据文件魔数判断是否需要解压,再进行解析和文本清洗,最终得到纯文本。
文档处理涉及文件解析和模型调用,执行时间相对较长。如果在上传请求中同步完成,容易延长请求响应时间。因此,这部分采用异步方式执行,避免阻塞用户的上传请求。
此外,为避免同一份文档被重复处理,系统采用基于文档状态的 CAS(Compare-And-Swap,比较并交换)机制认领处理任务。首次处理和重试共用同一个认领入口,只有成功认领文档的请求才能派发后续处理任务。
处理成功后,文档状态更新为 READY;发生异常时则更新为 FAILED,并记录失败原因,方便用户查看和重新处理。
检索数据管理
负责保存文档切片、来源信息和向量数据,为后续的关键词检索与向量检索提供数据基础。切片中会保留文档名称,检索命中后可以直接获取来源信息,无需再跨库查询文档记录。
整体处理流程如下:
分片上传完成 → 创建文档记录(UPLOADED) → CAS 认领(PROCESSING) → 事务提交后派发线程池任务 → 文件解析与文本清洗 → 文本切片 → 批量向量化 → 保存切片与向量 → 更新文档状态(READY / FAILED)文档删除与异常清理
文档删除涉及 MySQL、PostgreSQL 和 MinIO 三处存储,无法通过一个本地事务保证数据一致性。因此,删除时分别清理各处数据;如果清理失败,则记录日志,并由定时任务进行补偿。
定时清理主要处理以下两类数据:
• MinIO 中没有文档记录引用的文件。每天 04:30 扫描 kb/前缀下的对象,清理超过 24 小时且仍没有文档记录引用的残留文件。设置宽限期,是为了避免误删刚上传、但尚未创建文档记录的文件。• PostgreSQL 中找不到对应 MySQL 文档记录的切片。每天 04:45 扫描并清理已经失去文档记录的切片。
通过这两项定时任务,可以处理文档删除过程中可能残留的数据。
数据库设计
本模块涉及两张核心数据表,分别存储在 MySQL 和 PostgreSQL 中。
kb_document:文档元数据表
该表存储在 MySQL 中,主要记录文件信息、处理状态、处理结果和上传者信息(db/mysql/hrm.sql):
-- mysql/hrm.sql:1440CREATE TABLE `kb_document` ( `id` bigint NOT NULL AUTO_INCREMENT COMMENT '主键', `name` varchar(200) NOT NULL COMMENT 'MinIO 对象键(物理文件引用键)', `type` varchar(10) DEFAULT NULL COMMENT '文件类型', `old_name` varchar(200) DEFAULT NULL COMMENT '文件原名称', `file_hash` varchar(64) DEFAULT NULL COMMENT '文件SHA256哈希', `size` bigint DEFAULT NULL COMMENT '文件原始大小KB', `stored_size` bigint DEFAULT NULL COMMENT '磁盘实际占用(字节)', `compressed` tinyint(1) NOT NULL DEFAULT 0 COMMENT '是否zstd压缩: 0=否 1=是', `staff_id` int DEFAULT NULL COMMENT '上传者id', `status` varchar(20) NOT NULL DEFAULT 'UPLOADED' COMMENT 'UPLOADED/PROCESSING/READY/FAILED', `failure_reason` varchar(512) DEFAULT NULL COMMENT '处理失败原因', `preview_text` text COMMENT '文档预览文本', `chunk_count` int DEFAULT 0 COMMENT '切片数量', `upload_time` datetime DEFAULT NULL COMMENT '上传完成时间', `process_time` datetime DEFAULT NULL COMMENT '处理完成时间', `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `update_time` datetime DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '修改时间', PRIMARY KEY (`id`), UNIQUE KEY `uk_document_name` (`name`), KEY `idx_document_status` (`status`), KEY `idx_document_staff_hash` (`staff_id`, `file_hash`)) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='知识库文档';其中,name 保存 MinIO 对象键,也就是文件在对象存储中的唯一定位信息;old_name 保存用户上传时的原始文件名,用于页面展示。compressed 字段用于标记存储对象是否经过 zstd 压缩。DocumentUploadCompletionHandler.onComplete 会在提交文档记录前,根据文件类型尝试压缩;摄入线程读取文件时,则通过魔数判断是否需要解压。对后续解析逻辑而言,这一过程是透明的。
索引方面,唯一索引用于保证对象键不重复;状态索引用于按处理状态查询文档;上传者与文件哈希组成联合索引,用于满足相关查询需求。
kb_chunk:切片向量表
该表存储在 PostgreSQL 中(db/postgresql/hrm_kb.sql),主要字段如下:
• document_name:文档名称,取自kb_document.old_name,即用户上传时使用的文件名。• chunk_text、chunk_index:分别表示切片内容和切片序号。• token_count、chunk_summary:分别表示切片统计信息和摘要。其中,token_count是切分工具根据字符数估算的词元数量,并非精确的分词结果。• char_start、char_end:切片在原文中的起止位置。• embedding:1024 维向量。
-- postgresql/hrm_kb.sql:7CREATE EXTENSION IF NOT EXISTS vector;CREATE TABLE IF NOT EXISTS kb_chunk ( id BIGSERIAL PRIMARY KEY, document_id BIGINT NOT NULL, document_name VARCHAR(255) NOT NULL DEFAULT '', chunk_index INT NOT NULL, chunk_text TEXT NOT NULL, token_count INT DEFAULT 0, chunk_summary TEXT, char_start INT DEFAULT 0, char_end INT DEFAULT 0, embedding vector(1024), create_time TIMESTAMP NOT NULL DEFAULT NOW(), UNIQUE (document_id, chunk_index));CREATE INDEX IF NOT EXISTS idx_chunk_document ON kb_chunk(document_id);CREATE INDEX IF NOT EXISTS idx_chunk_embedding ON kb_chunk USING hnsw (embedding vector_cosine_ops) WHERE embedding IS NOT NULL;切片文本、文档名称和向量保存在同一张表中。检索命中后,可以直接获取来源信息,无需跨库查询。这样设计也有一个代价:表中包含体积较大的向量列,因此查询切片列表时不能使用 SELECT *,而应像 DocumentChunkMapper.selectByDocumentIdOrderByChunkIndex 一样,显式列出需要的字段。向量列只在检索流程中读取。
索引方面,(document_id, chunk_index) 唯一约束用于避免同一文档出现重复序号的切片;文档 ID 索引用于支持按文档查询和删除;HNSW(Hierarchical Navigable Small World,分层可导航小世界图)索引则用于加速向量近邻检索。
核心功能实现
文档提交与任务派发
DocumentService 是文档模块对外提供服务的统一入口。上传完成回调是文档提交流程的起点:DocumentController 将 DocumentUploadCompletionHandler 交给 FileUploadService.completeUpload,后者在同一个事务中合并分片,再回调 handler.onComplete。回调负责读取合并后的文件、按需压缩,并构造 Document 对象,最后调用 submit 方法。
submit 首先插入一条状态为 UPLOADED 的文档记录,然后在同一事务中调用 claimForProcessing,将文档认领为 PROCESSING,以避免重复处理。真正的解析和摄入任务则要等事务提交后才会派发:
// DocumentService.java:98@Transactional(rollbackFor = Exception.class)public void submit(Document document) { document.setStatus(DocumentStatusEnum.UPLOADED.name()) .setUploadTime(LocalDateTime.now()); documentMapper.insert(document); // 新行必是 UPLOADED,认领不会落空;保留是为了让两条命令路径都经由同一状态入口 Long documentId = document.getId(); documentMapper.claimForProcessing(documentId); // 必须等提交:worker 读不到未提交的行,抢跑会卡死在 PROCESSING TransactionSynchronizationManager.registerSynchronization(new TransactionSynchronization() { @Override public void afterCommit() { ingestExecutor.execute(() -> pipeline.run(documentId)); } });}事务外直接调用 submit 时,该方法会开启自己的事务;如果它由上传回调在外层事务中调用,则会加入外层事务。无论哪种情况,工作线程都只能在事务提交后读取到文档记录。
这里的 UPLOADED 和 PROCESSING 会在同一次事务提交前依次写入,因此外部通常看不到 UPLOADED 状态。保留这一状态,主要是为了让首次提交和重试共用同一套认领入口,避免新建文档时直接设置为 PROCESSING,形成一条特殊处理路径。
任务通过 afterCommit 派发,而不是在事务尚未提交时直接提交到线程池。这是因为处理线程使用另一个数据库连接,事务未提交时无法读取刚插入的文档记录。重试也不需要重新上传文件:原始文件仍保存在 MinIO 中,只需重新认领文档并派发任务即可。重试时的认领操作是一条自动提交的 UPDATE。
submit 和 retry 这两个修改状态并触发任务派发的命令方法,不应在同一个类中通过 this 相互调用。因为这种自调用会绕过 Spring 事务代理,导致事务同步回调无法按预期注册或生效。
文档处理与状态流转
文档状态定义在 DocumentStatusEnum 中:
UPLOADED | |
PROCESSING | |
READY | |
FAILED |
正常情况下,状态流转为 UPLOADED → PROCESSING → READY;处理过程中抛出异常时,管道会调用 markFailed,将状态更新为 FAILED。处于 READY 或 FAILED 状态的文档,也可以重新进入 PROCESSING。
目前的实现还有一个边界:认领 SQL 不接受 PROCESSING 状态。因此,如果工作进程在处理过程中崩溃,文档可能一直停留在 PROCESSING,无法通过现有重试入口重新认领,需要人工介入处理。
状态变更统一通过带前置条件的 UPDATE 完成,相关 SQL 集中在 DocumentMapper 中:
// DocumentMapper.java:42@Update("UPDATE kb_document SET status = 'PROCESSING', failure_reason = NULL, " + "chunk_count = NULL, preview_text = NULL, update_time = NOW() " + "WHERE id = #{id} AND status IN ('UPLOADED', 'READY', 'FAILED')")int claimForProcessing(Long id);@Update("UPDATE kb_document SET status = 'READY', preview_text = #{previewText}, " + "chunk_count = #{chunkCount}, failure_reason = NULL, process_time = NOW(), update_time = NOW() " + "WHERE id = #{id} AND status = 'PROCESSING'")int completeProcessing(@Param("id") Long id, @Param("previewText") String previewText, @Param("chunkCount") Integer chunkCount);@Update("UPDATE kb_document SET status = 'FAILED', failure_reason = #{reason}, update_time = NOW() " + "WHERE id = #{id} AND status = 'PROCESSING'")int markFailed(@Param("id") Long id, @Param("reason") String reason);这三条 SQL 分别负责认领任务、标记处理成功和标记处理失败。后两步通过 WHERE 中的状态条件与 UPDATE 的原子性控制并发:如果多人同时尝试处理同一份文档,只有第一条符合条件的 UPDATE 会影响 1 行,其余请求影响 0 行,并据此退出。
认领文档时,还会清空上一轮处理留下的失败原因、chunk_count 和 preview_text,避免旧结果影响本轮处理。
completeProcessing 要求文档当前状态为 PROCESSING。如果文档在处理期间被删除,这条 UPDATE 就会影响 0 行,管道据此删除本次 ETL 刚写入的切片,避免留下无主数据。markFailed 同样限定当前状态为 PROCESSING,因此不会覆盖其他操作已经完成的状态变更。
文档删除与资源清理
删除文档时,需要同时清理三处数据:MySQL 中的文档记录、PostgreSQL 中的切片,以及 MinIO 中的原始文件。由于后续清理还需要文档 ID 和对象键,因此删除前要先查询文档信息,再删除文档记录。具体清理逻辑集中在 purge 方法中:
// DocumentService.java:169private void purge(List<Document> documents) { List<Long> documentIds = documents.stream().map(Document::getId).toList(); List<String> storageKeys = documents.stream() .map(Document::getName).filter(Objects::nonNull).toList(); // PG 切片必须先删:残留切片会继续参与检索,失败要留痕(DocumentCleanupJob 次日兜底) try { chunkMapper.deleteByDocumentIds(documentIds); } catch (Exception e) { log.error("删除检索产物失败,切片将残留在 kb_chunk 中,需人工清理: documentIds={}", documentIds, e); } // MinIO 远端调用失败有 DocumentCleanupJob 兜底,放在最后且只记日志 try { Set<String> failed = storageService.deleteAll(storageKeys); if (!failed.isEmpty()) { log.warn("删除物理文件失败(对象将由孤儿清理兜底): {}", failed); } } catch (Exception e) { log.warn("删除物理文件失败(对象将由孤儿清理兜底): {}", storageKeys, e); }}清理顺序是先删除 PostgreSQL 中的切片,再删除 MinIO 中的原始文件。切片会直接参与检索,因此需要优先清理,避免已经删除的文档仍被检索召回。
两处清理失败都只记录日志,不影响文档删除操作的返回结果。其中,PostgreSQL 清理失败时记录 error 日志,MinIO 批量删除返回失败对象键或抛出异常时记录 warn 日志。需要注意的是,代码中的日志提示“需人工清理”并不完全准确:文档记录删除后,残留切片会由次日 04:45 执行的定时清理任务自动兜底删除;MinIO 中未被文档记录引用的对象,也会由对应的孤儿文件清理任务处理。
删除方法没有添加事务注解。原因在于,PostgreSQL 和 MinIO 的清理操作无法随 MySQL 本地事务一起回滚。如果将这些操作放在一个 MySQL 事务中,一旦事务回滚,就可能出现文档记录仍然存在,但对应切片或原始文件已经被删除的情况。
异常恢复与残留清理
正常删除流程之外可能留下的残余数据,由 DocumentCleanupJob 中的两个定时任务负责兜底:
• 每天 04:30 扫描 MinIO 的 kb/前缀,删除对象键不在kb_document表中、且最后修改时间超过 24 小时的对象。设置 24 小时宽限期,是为了避免误删“文件已经上传,但文档记录尚未提交”的文件。• 每天 04:45 扫描 PostgreSQL,根据切片中的 document_id删除已经找不到对应 MySQL 文档记录的切片。
第二个任务对查询顺序有要求:必须先读取切片中的文档 ID,再查询当前仍然存在的文档 ID。如果顺序相反,在两次查询之间恰好有新文档提交并生成切片,那么新文档的 ID 就不在此前读取的存活文档 ID 集合中,可能被误判为残留数据并删除。
前端交互与功能入口
前端页面位于 hrm-admin/src/views/kb/document/index.vue,提供文档上传、列表查询、状态展示、切片预览、重试和删除等功能。
上传功能复用 ChunkedImportBtn 组件,并通过 scope="DOCUMENT" 区分上传类型。分片合并完成后,前端调用 /document/upload-task 接口。当前支持 .pdf、.docx、.md 和 .txt 格式,按钮会显示“上传 2/5”一类的上传进度。
文档列表支持按 old_name 模糊查询和按状态筛选,状态通过 el-tag 展示,中文状态名称在页面内维护。对于处于 UPLOADED 或 PROCESSING 状态的文档,页面每 3 秒轮询一次列表,用户无需手动刷新即可查看处理进度。
点击“分块”可以只读查看文档切片,包括 chunk_index、token_count 和切片原文;点击“重试”需要二次确认,确认后调用 /document/{id}/retry 接口;点击“删除”则通过气泡确认后调用 DELETE /document/{id} 接口。
至此,文档从上传、创建记录、异步处理和状态维护,到删除及残留数据清理的主要流程已经打通。文档转换为切片和向量后,如何进行检索召回、如何将检索结果组织到提示词中,以及如何流式返回问答结果,属于后续知识库问答环节的内容,本期暂不展开。
效果验证
知识库文档管理主界面:
文档分块预览界面:
小结
本期完成了知识库文档的入库与清理流程。上传文档后,系统会创建文档记录,并异步完成解析、切片和向量保存;用户可以在列表中查看处理状态,也可以预览切片。删除文档时,系统会清理 MySQL 中的文档记录、PostgreSQL 中的切片和 MinIO 中的原始文件;如果跨存储清理失败,则由定时任务处理残留数据。
实现上,切片文本与向量保存在同一张表中,减少了检索和清理时的跨表操作,但列表查询必须显式指定字段,避免读取体积较大的向量列。任务认领采用 CAS 状态更新,没有额外引入任务表,使文档状态成为处理过程的统一依据;相应的限制是,工作进程如果在处理中途崩溃,文档可能停留在 PROCESSING,现阶段需要人工介入恢复。
至此,知识库文档管理的基础流程已经完成。下一期将继续介绍文档切片与向量化的具体实现。
在线访问:https://hrm.qiujie.net.cn
GitHub:https://github.com/quuuuj/hrm