 夜雨聆风
Doco 传播系列 · 第 4 篇 · 技术稿
前面几篇讲了 Doco 能做什么、怎么用。这一篇讲它是怎么设计的,内容较长,也比较偏技术,读起来需要一点耐心。
2026 年,让 Agent 读写文档已经不新鲜。真正的问题是:把一个现成的文档系统直接开放给 Agent,往往很快就会出问题。原因不在 Agent,而在这些系统从一开始就不是为 Agent 设计的:
段落没有地址。Agent 想改一句话,只能整篇读回来、整篇写回去; 写入没有版本。两边同时改,一边静默覆盖另一边,两边还都显示成功; 阅读没有预算。长文档整篇塞进上下文,token 烧完了,信息照样被截断; 错误没有语义。该报冲突时返回 500,该让重试时返回 403,Agent 只能靠猜。
Doco 从第一天起就把「对 Agent 友好」列为一等设计目标。下面十个设计决定,每个都对应一个真实的问题。先看速查表:
block_<ULID>,位置无关 | |
一、每个段落都有稳定的地址
 传统文件范式里,内容的地址是「路径 + 行号」,内容一动地址就失效。Agent 因此只能做文件级操作:整篇读、整篇改、整篇写回——改动范围大、出错难定位,也没法精确引用某一段。
Doco 的做法:给每个顶层块一个稳定 ID block_<ULID>。关键在于 ID 的存放方式——它是节点属性,不是位置索引,存在 Yjs CRDT 里,跟着节点本身走。拖动、重排、折叠、跨章节移动,ID 都不变;复制块时会签发新 ID,不会出现两块同号。
ID 补全有三层兜底:
浏览器端:一个 ProseMirror 插件监听所有编辑事务,自动给缺 ID 的块补上。补 ID 不进 undo 历史,用户按撤销时不会看到多余的操作; 服务端:每次读写都校验格式与唯一性,非法 ID 返回 422 invalid_block_id,重复 ID 返回422 duplicate_block_id——宁可拒绝,也不悄悄改写调用方提交的数据;旧文档:首次加载时做一次幂等迁移事务补齐,不做离线全量重写。
有了地址,后面的一切才成立:改「一句话」就是 PATCH 一个块;引用可以精确到 doco://doc/{id}#block={block_id};浏览器打开带 ?block= 的链接会直接滚动聚焦到那个块——人和 Agent 指向的是同一个位置。
二、版本指纹:让并发冲突显式暴露
 并发写入最危险的不是报错,而是两边都显示成功,其中一边被静默覆盖。
Doco 采用乐观并发控制:每次读取正文都返回版本指纹(ETag),写入必须用 If-Match 把它带回来——
没带指纹?返回 428 precondition_required,直接拒绝,不做 last-write-wins;指纹对不上?返回 409 document_version_conflict,响应里附上最新版本号,引导重读合并。
整篇替换、批量操作、版本回滚,一律强制带指纹。冲突在这里不是事故,而是需要显式处理的事件:系统宁可停下来报错,也不假装无事发生。
这个设计里有一个容易踩的坑:指纹到底哈希什么?直觉答案是哈希 Yjs 状态二进制,但 encodeStateAsUpdate 的字节会随 update 合并历史变化——两份内容完全相同的文档,一份一直在线、一份离线重建过,字节并不相同。直接哈希二进制,Agent 会在内容毫无变化时收到误报的 409。Doco 的版本指纹哈希的是「正文 + 表格数据」的规范化 JSON(键排序):内容相同,指纹必相同,与合并路径无关。
两个配套决定:
同一文档的所有写入走进程内串行队列,从机制上排除竞态; 每次写入前先存版本快照(默认保留最近 20 份)。Agent 写错了,有版本列表和回滚 API 兜底。
三、人和 Agent 写同一份文档
 很多系统的 API 写入走影子存储:浏览器里看到的和 Agent 写入的不是同一份数据,两套存储迟早对不上。
Doco 的开放 API 不开第二个数据源。写入时如果文档正被浏览器打开,事务直接作用在 Hocuspocus 内存中那个 Y.Doc 上,Yjs 会把更新广播给所有连接的客户端——Agent 写下的内容,你能在浏览器里实时看到它出现。文档没人打开时写入 SQLite,下次打开自动读回;写入在响应前就完成持久化,服务端重启也不丢。每笔写入带 origin 标签(doco:open-api:batch、doco:open-api:block-update……),谁改的、走哪条通道,审计日志里查得到。审计还带 is_agent 列,能识别 claude-code、cursor、codex、doco-cli 这些 Agent 客户端——「知识库流量里 Agent 占多少」可以直接查出来。
反向链路同样打通了:你在浏览器里改正文,落库触发 SQLite 触发器,事件进入 SSE /events 流,订阅的 Agent 实时收到;配合块级 changes 接口,Agent 拿着基线游标查增量(增、删、改、移),不必每次重读整篇。这里有个细节:判断「哪些块算移动」时用最长递增子序列比对相对顺序——否则在文档头部插入一段,后面所有块都会被误报为 moved,增量同步立刻失效。
也需要说明:Agent 写入时向浏览器广播「正在修改第 N 段」的瞬时光标,目前还是待做的增强项。人和 Agent 的改动互相可见,但暂时还看不见对方的光标。
四、Markdown 是交换格式,不是存储格式
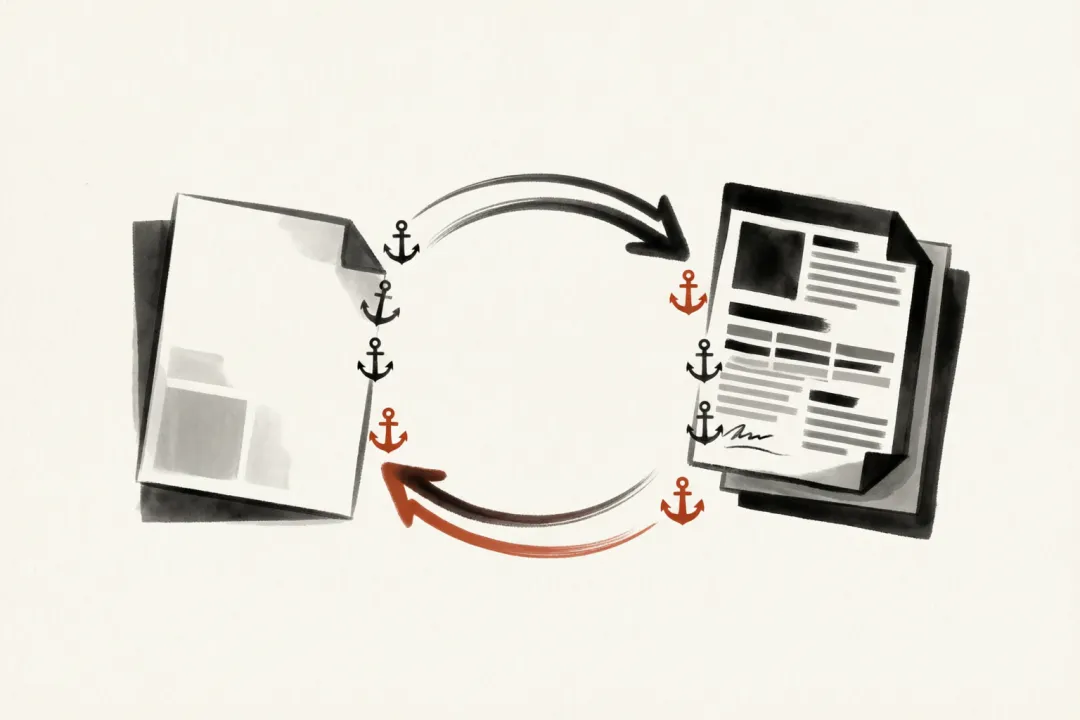 Markdown 是 Agent 最熟悉的格式,但它没有地址,也表达不了表格对齐、Callout、电子表格这些富信息。两个省事的方案都不成立:「让 Agent 直接写 JSON」太不友好,「只开放 Markdown」又会丢信息、丢地址。
Doco 的决定:Tiptap JSON 是无损的标准格式,Markdown 是便捷的交换格式,中间用锚点往返衔接:
导出时带 ?annotate=anchors,每个块前面插入一行独占的锚点注释<!--@block=block_xxx-->;Agent(或你的编辑器)在 Markdown 里自由修改; 整篇写回时,解析器按代码围栏感知的方式切块,锚点归属其后第一个块——没动过的块凭锚点保住原 ID,新增内容签发新 ID。

这样,「整篇人性化编辑」和「块级稳定寻址」不再冲突。CLI 的 doco edit --heading 也靠它:把某一节截出来编辑、整篇写回,其他章节的块 ID 纹丝不动;中途撞了 409,上一轮编辑会被存成冲突副本,不会丢失。
五、搜索结果是契约,不只是提示
 grep 只能回答「这些字出现在哪些文件里」。Agent 搜完真正需要的是一整套信息:哪篇文档、在哪个标题下、前后文是什么、结果新不新鲜、有没有搜全。
Doco 的搜索建在服务端(SQLite FTS5),命中落在块上,每条命中都带完整证据:
块 ID · 块类型 · 位置目录路径 / 标题路径上下文:上一块摘录 / 命中 / 下一块摘录命中次数 · 分数 + 分数解释正文版本 · 索引版本 · 新鲜度投影完整性:complete / 水位 / stale 文档清单三个决定值得展开:
- 分数可解释
。 score_explanation拆出标题权重(8 倍)与正文频次各自贡献了多少。Agent 能判断命中是「标题命中」还是「正文恰好提到」,而不是只看一个黑盒数字; - 完整性可证明
。穷举模式的游标里嵌着投影水位:翻页期间只要有任何文档的索引水位变化,游标立刻以 409 search_cursor_stale作废,要求重新查询。「没搜到」和「没搜完」是两种不同的返回值; - 中文检索用直接的办法
。FTS5 默认分词器不支持中文,Doco 入库时给每个汉字两侧插入空格,查询时转成逐字 phrase AND。不炫技,但语义正确,也不依赖任何外部分词服务。
六、阅读有视图,也有预算
 Agent 消耗上下文最常见的方式,就是「先把整篇读进来再说」。
Doco 把「读」拆成几种方式:
- 先看结构
:outline 接口返回标题树,带 block_id、heading_path、章节块区间——先读目录,再决定深入哪里; - 按视图读
:markdown 求快读,tiptap-json 求无损操作,plain-text 求纯文本,同一份内容按任务给不同投影; - 按预算读
:read 接口支持 max_tokens和around参数,围绕任意嵌套块读上下文。预算不够时,返回值明确标注budget_exceeded,附omitted_ranges和版本绑定的续读游标——期间正文变了,游标以 409 作废,绝不会让你把两个版本的片段拼在一起当事实。
七、批量是原子的,重试是幂等的
 一次任务改四处,前三条成功、第四条失败——半成品比失败更难收拾;网络抖一下重试,文档可能被创建两份。
批量:POST /batch 接受 1–100 个操作,insert / replace / delete 在同一个 Yjs 事务里执行,全有或全无,且强制带版本指纹——否则批量就退化成 last-write-wins。
幂等键:文档、批量、附件等创建型接口支持 Idempotency-Key。Agent 发起创建请求时带一个全局唯一的键,语义是「这个请求无论发送几次,都是同一笔操作」;服务端为每个处理过的键存一张回执存根——哪个令牌、哪个接口、请求体是什么、首次成功的响应是什么——保留 24 小时,重试时凭存根识别:
同键同体重放 → 服务端认出这笔操作已经做过,不再重复创建,原样返回首次结果,重试没有副作用; 同键异体 → 409 idempotency_key_conflict。重试逻辑悄悄改了请求内容?显式暴露,不代为执行;只缓存成功响应,失败不粘滞,改好了随时可以重来。
八、三条通道,一套契约
 REST API、MCP server、CLI 不是三套接口,而是同一套契约的三个投影:
/api/openapi.json,62 个 path,契约测试与路由互相锁定 | ||
--json 全局生效,错误也输出机器可解析 JSON |
几个细节:
MCP server 的 instructions 里直接写明黄金循环(读版本 → 带版本写 → 409 重读重试),写工具内部也替你做了;工具输出设 200k 字符软上限,超限时不返回原文,而是返回「缩小范围」的指引——像保护自己的上下文一样保护 Agent 的; 错误响应是统一的结构化信封: error.type / code / message / details加request_id。409 附最新版本号,429 附 Retry-After,403 列出缺哪些 scope——每个错误都包含下一步该怎么做,而不是让人挠头的字符串;CLI 登录走设备授权:和 GitHub CLI 一样在浏览器确认,网页上还能顺手把权限从读写降级为只读;签发的令牌默认 90 天有效,刻意不做永久 PAT;轮询换令牌时校验 IP 哈希绑定,device_code 就算从代理日志里泄漏,也换不走令牌; 连用法都以 Skill 形式分发: doco skill install把 Agent 操作手册装进 Claude Code / Codex——黄金循环、限频数字、已知坑位,全在里面。这可能是最「Agent 优先」的一处设计:文档的第一读者,就是 Agent。
九、只给 Agent 该给的权限
 令牌权限一刀切,等于让 Agent 拿着超出需要的权限操作整个知识库。Doco 把权限拆细,每个令牌只能做明确授权的事:
- 细粒度 scope
:9 个权限点覆盖文档 / 知识库 / 附件 / 概念的读写与摘要生成, read_only与read_write是两个预设组。scope 不足返回 403,details 里直接列出需要补哪些权限——错误信息告诉你怎么补救; - 令牌安全
:明文只在签发时出现一次,服务端只存 SHA-256 哈希,恒定时间比较;网页上一键撤销,已撤销令牌的 SSE 长连接会被心跳检测踢下线; - 限频四层桶
:SQLite 持久化的令牌桶,重启不清零,每个响应都带 X-RateLimit-*余量头,超限返回 429 和Retry-After。
Agent 不用猜自己还剩多少额度——余量写在响应头里,也可以随时 GET /me/quota 自查。推荐的接入路径同样经过设计:先签发 read_only,让 Agent 用搜索和阅读证明自己的答案质量,再换读写权限。信任应该是逐步建立的。
十、贯穿一切的元原则:绝不让 Agent 猜
 回头看这十个决定,贯穿其中的只有一句话:绝不让 Agent 猜。
搜不全 → complete=false,并列出哪些文档的投影是 stale 的;增量窗口被压缩 → sync_required=true,要求全量重读;转换有损 → warnings[]带 code;读取截断 → budget_exceeded附省略范围;派生内容过期 → 显式标记 stale,绝不悄悄端上来。
这也决定了 Doco 的分层:正文与协同状态是唯一数据源;搜索索引、四层摘要、引用关系、概念图,全部是可重建的派生投影。投影更新失败不阻断正文读写,只标记 stale、启动时回填;每个派生结果都带来源块和来源版本,能回到原文、能重建、能审计。模型生成的摘要、抽取的概念也一样——先进候选池,人确认了才转正,从不悄悄混进权威正文。
设计原则速览
最后把 Doco 的 3条设计原则放在这里,给同样在为 Agent 造系统的同行参考:
内容存储优先于派生索引; 执行回执明确状态和完整性,绝不让 Agent 猜; 人类编辑和 Agent 操作共享同一个状态;
结语
Agent 读写文档,不是加一个 API 层就算「支持 Agent」。地址、版本、预算、契约、权限、可见性——它们虽然不在 API 文档模板里,却决定了一个 Agent 能不能安全、精确、可信地在你的知识库里工作。