ARTICLE · 1038583
AI大模型、Agent、Skill、工具和知识库:到底谁是谁的谁(以报告表审核为例讲清楚流程)
从事咨询行业的你一定要学AI,AI应用层面涉及到哪些基本概念呢?先用一个大白话的场景说清楚大模型、Agent、Skill、工具和知识库之间的关系。
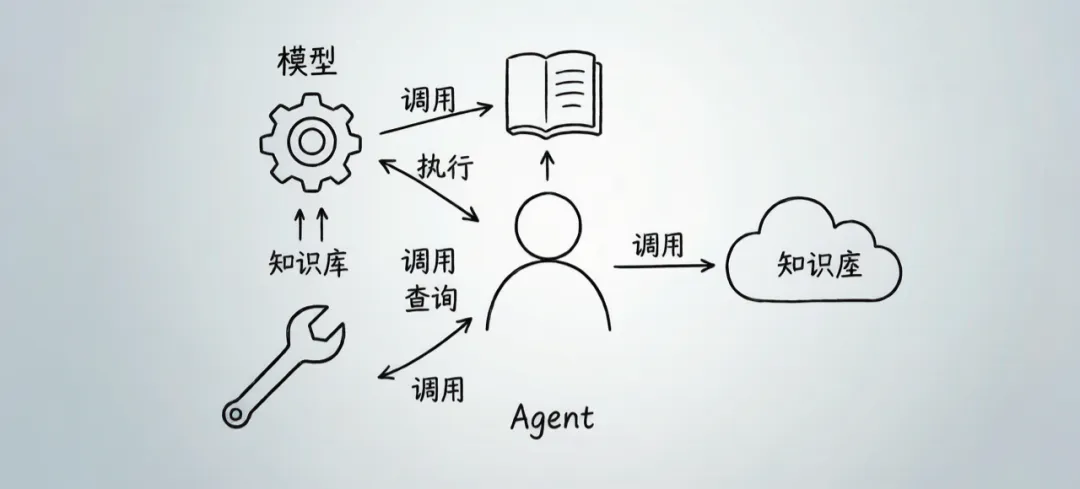
公司招了一个聪明的学霸实习生:看得懂文字、会写材料、脑子转得快——这就相当于大模型。
给他配了电脑、电话、记事本,还允许他自己分几步把活干完——这就成了Agent(智能体)。
你担心他不懂工作流程,于是写了一份作业流程单:"每个过程都要写出依据的"——这是Skill(技能包)。
最后,你把所有涉及的国家和地方相关法律法规、标准、技术规范、以前的成果、专家审查意见整理成一个随时能翻的大型资料柜——这是知识库。
而他能用的那些"家伙事儿"——比如电脑里的office、PDF 阅读器、计算器、制图软件——就是Tool(工具)。前面三样都不会自己动,工具是它们唯一能"动手"的接口。
下面一个个说。
一、大模型:那个"聪明但不了解你家情况"的学霸实习生
大模型(也叫 AI 大模型、LLM)= 一个读过海量资料、会读会写会推理的通用大脑。
强项:理解你的话、组织逻辑、写成人话、总结、翻译。
两个短板都很致命:
它不知道你单位的规矩——你们所的口径、习惯、内部模板,它一概不知; 它答得越流畅,越容易说得像有依据。你问它一条排放标准限值,它可能张口就给个数字,还配一句很专业的解释——但那个数字可能是他瞎编的,但说起来还振振有词,要是最后核实真答错了马上会说对不起。
这不是它"坏",是工作机制决定的:它按概率往下写,不是按原文往下抄。
国内外常见的有哪些?
国外的:
GPT 系列(OpenAI,ChatGPT 用的就是它) Claude 系列(Anthropic,读长文档、写长材料口碑好) Gemini 系列(谷歌) Llama 系列(Meta,开源,可下载到自己电脑上跑)
国内的:
DeepSeek(深度求索)——推理能力突出,技术问答用得多 通义千问 Qwen(阿里)——开源版本多,本地部署常用 豆包(字节跳动) Kimi(月之暗面)——以读长文件见长 文心一言(百度)、 智谱清言 GLM、 讯飞星火 MiniMAX 腾讯混元
想用哪个大模型的,需要去官网充值得到API给Agent,Agent才能武装好自己的大脑。当然目前有一些Agent已经连上了自己的大模型,不需要手动设置。
二、Agent:给大模型配上"手和脚"
Agent(智能体)= 大模型 + 记忆 + 会使用工具 + 能分步骤完成一个目标。
差别在哪?跟大模型是"一问一答";跟 Agent 是"交个任务"。
你说一句"把这份报告表核一遍,出一张问题清单",它会自己安排:打开报告表 → 认出引用了哪些标准 → 挨个去资料柜翻原文 → 逐项比对 → 列出问题清单。中途资料不全它会回头找,算错了会重算。这就是 Agent 和聊天框最大的区别:它是干活的,不只是聊天的。
常见的 Agent,按"在哪用、谁在用"分成五类:
第⑤类单独说清楚——这一族共同点是"跑在自己电脑上、能读本机文件、数据不出门":
这里必须补一句实务提醒:这类东西的能力和风险是同一个来源——它能读写你电脑上的文件。所以用法上要配三条:装在一台单独的机器或单独目录里、只给必要的权限、重要资料先备份。方便和稳妥要一起考虑,不能只图快。
表下再补两句:
手机里那几只"小X"——小爱同学、小艺、小布、蓝心小V——本质是语音助手,能订票、设提醒、开关家电,但还谈不上"自己分步骤把一件复杂活干完",所以没放进上表。
三、Skill:菜谱,不是锅碗瓢盆——中间还隔着一层"工具"
用户↓ 给任务Agent(总导演:拆步骤、调谁、看结果、迭代)↓ 调用Skill(组合技:一组工具 + 工序 + 禁令)↓ 调用Tool 工具层(原子动作:读PDF、查数据库、跑脚本、发消息)↓ 读写大模型(推理引擎)+ 知识库(资料柜)
从下往上看:大模型是脑子、知识库是记忆,工具是手脚,Skill 是把手脚串起来的招式,Agent 是决定"什么时候用、怎么组合"的总导演。
这里最容易被忽略、也最容易和 Skill 搞混的,就是中间的工具(Tool)。专门说清楚:
工具是单个能力:读 PDF、算数、查数据库、调一个标准 API、发一封邮件、跑一段脚本——每个只干一件小事,是最小不可再分的"原子动作"; 技能是一整套工序:先干什么、后干什么、按哪条判、输出成什么格式、哪些事绝对不能做。
打个比方:工具是锅碗瓢盆和灶台,技能是菜谱。同样的灶台,有菜谱的人做出来能上桌,没菜谱的只能自己吃。
再举个例子,"查 GB 16297 的无组织限值"这件小事:
工具层:向量检索工具(去知识库翻出 GB 16297 的相关段落)、表格解析工具(把段落里的限值表抽成结构化数据); Skill 层(技能包):先判定污染物是什么 → 再调检索工具查标准号 → 用表格工具提取限值 → 核对适用级别 → 输出"污染物 + 限值 + 依据条款"的标准格式。
Skill = 工具 + 调用顺序 + 判据 + 输出格式 + 禁令。工具是"被封装好"的——你用 Skill 的时候已经在调工具了,只是不用关心具体是哪个。但真要自己搭系统,工具层必须单独拎出来,因为它是唯一能跟外部世界"动手"的那一层:不读文件就进不了知识库,不跑脚本就算不出总量,不调 API 就发不出提醒。
环保咨询里常见的工具有哪些?先有个印象:
这些工具不绑定任何模型、不绑定任何 Agent 框架——OpenClaw 能用、Dify 能用、扣子也能用,你自己也能写。这是它要单独成层的原因:它是公共基础设施,谁调用都能执行。
环保咨询里的技能包长什么样?以"报告表审核"为例,它其实就是一张检查点清单(注意,清单里的每一步,背后都靠工具层去执行),比如你可以简单设置审核报告的skill:
项目类别与环评类别对不对得上; 各要素评价等级判得对不对(大气、地表水、地下水、声环境、土壤、生态); 执行标准选得对不对——标准号、年份、表号、适用条件; 正文与表格里的数据前后一不一致; 章节齐不齐、附件全不全; 结论与前面各章是否对得上。
外加两条禁令:
每条问题都必须写出依据的标准号和条款号,写不出依据的问题一律不报; 不许凭记忆填任何数值,必须回原文。
四、知识库:单位的资料柜,而且要"能翻到原文"
知识库 = 把单位的资料整理好,让 AI 能查、能引用、能追溯到原文。
这里必须分清两个词:
记忆:这一次对话里的上下文,是个人的、临时的; 知识库:共享、有版本、能查到出处,是资产。
知识库的四种部署方式
第一种:云端现成版(最省事,上手最快)
直接使用平台自带的知识库功能,把文件传上去就能问:
腾讯 ima:可以上传文件建自己的知识库,能联网,和微信、公众号生态衔接顺手。 WPS 知识库:和云文档、Office 生态绑在一起,适合文档量大、天天在 Word/Excel 里干活的团队,谁改了什么都有记录。 此外还有飞书、钉钉、企业微信自带的知识库,以及 Kimi、豆包的文件问答。
优点:今天就能用,目前多数不额外花钱,不用人维护。缺点:文件在别人服务器上,内部资料和涉密内容不要用;文件一多就不好管;各平台之间搬家不轻松,要是平台垮台不做了,资料可能灰飞烟灭。后期随时可能收费。
第二种:本地文件夹式(最踏实,也最省钱)
把标准做成一份份 Markdown 文件(纯文本),结合obsidian放在自己硬盘或共享盘上,AI 直接读文件来回答。
优点:不需要任何服务器,文件永远在自己手里,人和 AI 都能直接看懂,要改就是改文字。缺点:得有人整理。乱堆一堆 PDF 他看不懂。
我目前倾向于用的是这种:一个标准一张卡片,卡片里把封面信息、目录、正文、表格、附录全部录入。文档都是轻量,每次提问时AI检索省时间、更省调用大模型的token费用。
第三种:本地检索库(数据不出门,功能更全)
在自己电脑或单位服务器上装一套:开源模型(如 Qwen、DeepSeek 的开源版本)+ 检索工具(如AnythingLLM、Cherry Studio、RAGFlow、Dify),把标准文件切块存进向量数据库(常见的有ChromaDB)。
用法:你问一句,它先从库里把最相关的几段原文找出来,再让模型照着这几段回答。
优点:数据不出门,能装几千份文件;缺点:要一台配置非常高的电脑,而且能完成部署配置高一点的本地大模型的,要不然脑子不好使回答出的答案就是幼儿园的水平。
当然现在也可以通过一些智能体的工具能把本地的RAG检索向量来实现,把这两者实现有效串联。
五、走一遍完整流程示范:审核一份报告表
任务:审核一份报告表,出一张问题清单。
假设这是个有喷漆工序的机械加工项目,报告表已经送到你手上。你把任务交给 Agent,只说一句:"按我们的报告表审核技能包,把这份报告表核一遍,输出问题清单。"
第一步,用工具把文件读进来。Agent 调 PDF 解析工具、OCR工具等,打开报告表,把正文、表格、引用的标准号和污染物数据都抽出来——这一步就是"工具层"在干活,大模型和知识库都碰不到原始文件,必须先靠工具读出来。
第二步,按技能包逐项过。项目类别、评价等级、执行标准、数据一致性、章节完整性、结论是否对得上——一项一项来,不凭印象。这是 Skill 层在指挥:它规定了顺序、判据和输出格式。
第三步,遇到标准就去知识库翻原文。比如报告表里写"本项目不开展地下水环境影响评价",它不会直接认下来,而是让检索工具去知识库翻出 “报告表的编制指南”等,再判断"不开展"这句话站不站得住。这一轮是 Agent → Skill → 工具 → 知识库,四层都全串起来了。
第四步,输出一张问题清单(下面几条是示例,项目名称、数值均为虚构):
可能大家在问,这些工作过程好像都没用到大模型,大模型到底有什么用?
其实,上面的每一步工作,都是大模型在深度烧脑思考:
读文件那一步:工具只负责"把字读出来"(PDF 解析、OCR、提表),大模型负责"把意思读出来"——哪几页是正文、哪一张是附表、OCR 认歪的串要顺回来、提取出来的几列里哪一列是限值哪一列是标准号。工具管字符,大模型管语义。 逐项过那一步:技能包只是"清单",执行清单的人是大模型——它要把这份报告表里的具体内容对应到检查点上("有喷漆工序的机械加工"归到"项目类别"),要判断正文的 99% 和表里的 95% 是不是同一件事,才谈得上"前后不一致"。 翻原文那一步:检索工具只管"像不像",大模型管"对不对"——先把报告表里的话转成检索条件,再把翻回来的几段逐条比对本项目,判断哪一条真正适用(哪个行业、哪一栏)。 出清单那一步:几乎全是大模型——组织语言、填表、配依据、定等级。
一句话:大模型是全程在的那个"脑",工具是手,技能包是规矩,知识库是资料柜。它不显眼,是因为它在做"判断",而判断是看不见的。
AI 工作流五层架构与审核流程架构总览
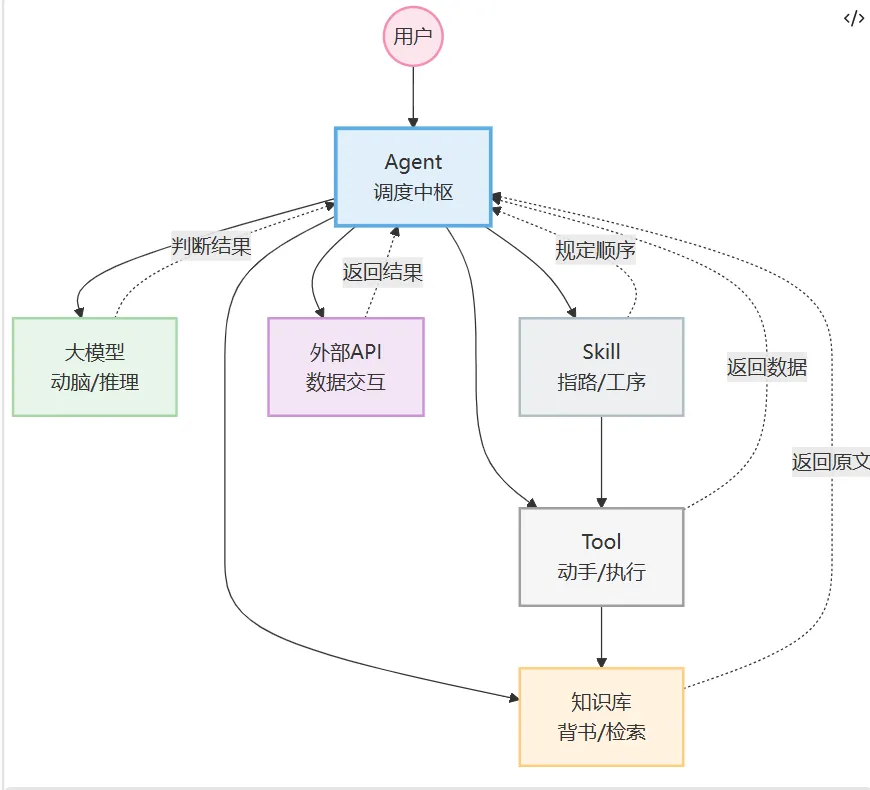
Agent = 总导演(盯全程)| Skill = 菜谱(规定先查什么后查什么)| Tool = 手脚(抠字/算数/调接口)| 大模型 = 全程在用脑(看懂+判断+写下来)| 知识库 = 资料柜(标准原文/历史案例)
第五步,也是最关键的一步:人复核。AI 报出来的问题里一定有它自己看错的——把报告书的条款套到报告表头上、把两个行业的类别混了、拿旧版本标准当现行有效。哪些留、哪些删、哪条必须要求补充监测,只有人能定。
六、AI 能替哪些活,不能替哪些
能替的:翻标准、抄条文、核数据、排版、写初稿、做对照表、查历史资料。
不能替的:现场判断、参数取值、跟主管部门沟通口径、承担责任、签字。
三条底线,建议写进制度:
每一句结论都要能追到出处(哪份标准、哪一页、哪张表); 没经过人核对的结论,不能进正式成果; 签字权和与人一起担的责任,永远在人。
七、五个合起来,是不是就成了"环保管家的超级 AI 助手"?
是,但要限定范围:它能做成"能干活的合规助手",做不成"能签字的环保管家"。
前面一直在讲四样(大模型、Agent、Skill、知识库),但别忘了还有藏在 Skill 下面的工具层——工具是手脚,不干活就什么都白搭:读不了 PDF,知识库喂不进去;跑不了脚本,总量算不出来;调不了 API,提醒发不出去。完整的系统是五层,不是四样。
能做成的那部分。把五层配齐,环保管家的日常里凡属"信息处理+文书产出+合规对照"的活,基本都能接住:政策法规检索与适用判定、评价类别与等级初判、执行标准与限值核对、台账整理与到期提醒、执行报告和自行监测方案初稿、隐患排查检查表、培训材料与答复函件。这一块大约占日常工作量的大头,也是最能省人的地方。
接不住的那部分,有三条硬边界:
第一,资质和资格不是 AI 给的。环评单位资质早已随法律修改取消,但注册环评工程师的职业资格还在,编制主持人、责任人的签署要落到具体的人头上;检测要有 CMA、危废经营要有许可证、涉及工程设计和施工另有建设主管部门的要求;环保管家本身不是行政许可事项,靠的是服务能力和履约记录。AI 不产生资质,也不具备承担责任的资格。相反,它能把"能力证据"沉淀下来——你们做过什么项目、被评审采纳过什么意见、每张卡片谁核对签的字,这就是可以拿给客户看的履约能力。
第二,责任与签字在人。报告、执行报告、台账的责任签署不能由 AI 代签;专家评审、现场核查必须人到场。这一条不是技术能不能做到的问题,是责任归属的问题。
第三,现场和交涉,AI 到不了。隐患排查的最后一眼、工艺到底改没改、与监管部门沟通口径时的分寸感,这些都靠人。AI 能给你备好材料、列好清单、想好说法,但它不能替你站在现场,也不能替你担那句话。
把它按"参与程度"排一张表,会更清楚(示例):
所以我的判断是:五者合起来,最合适的定位是"共用的合规助手**"——它把老师傅脑子里的经验变成谁都能调用的能力,把新人从"翻标准"里解放出来去学判断,把重复劳动压下去。它不是替掉环保管家,而是让一个环保管家的产出更稳、更一致、可追溯。
还有一句专业提醒:AI 出的错一旦直接进了报告,行政处罚落在单位和人头上。所以这套东西必须留"核对痕迹"——依据原文、核对人、核对日期、二审记录。将来真被问起来,能拿出这条证据链,才是它真正的价值所在。
最后:配 AI 工作流,最关键的一步是选对 Agent
大模型是脑子,工具是手脚,技能包是菜谱,知识库是资料柜——但这四样都不会自己动。
真正把四样串起来、让整套东西转起来的,是Agent:它去资料柜取原文,照着菜谱往下做,用工具把活干完,再把结果交回来。所以配 AI 工作流,最该花心思的不是"哪个模型更强",而是"谁来当这只干活的手"。
选 Agent,就三条硬标准:
能不能读你的文件、调得动你的工具。 读不了本机文件、接不上你的 PDF/检索/计算工具、进不了你们的知识库,再强的模型也只能在聊天框里说空话; 认不认你的技能包。 不能按"必须先查原文、不许凭记忆填数"的规矩办事,它出的东西你不敢直接用; 输出带不带出处、能不能被审计。 每条结论都能追到标准号和条款号,将来才拿得出证据链。
三条都过,它才算 Agent;一条不过,那只是升级版的搜索框。
但最上面那一层永远不变:Agent 再能干,签字的还是人。
AI 做第一遍,人做最后一遍。签字、判断和责任,始终在人。这个AI搭建思路,其他行业也可参照通用。