ARTICLE · 1039908
用AI把高中数学装进知识库后,它开始提醒我哪里还没学懂
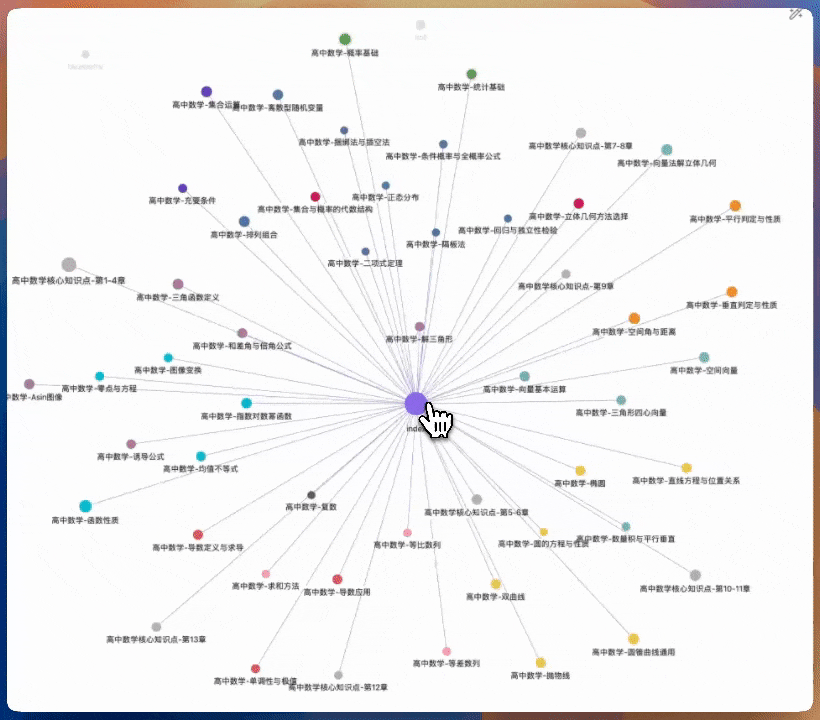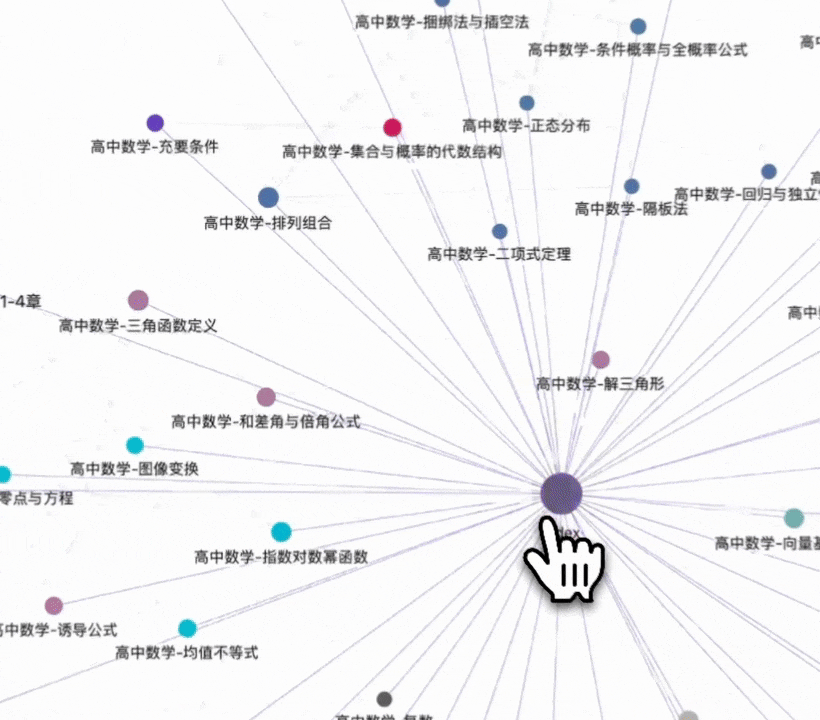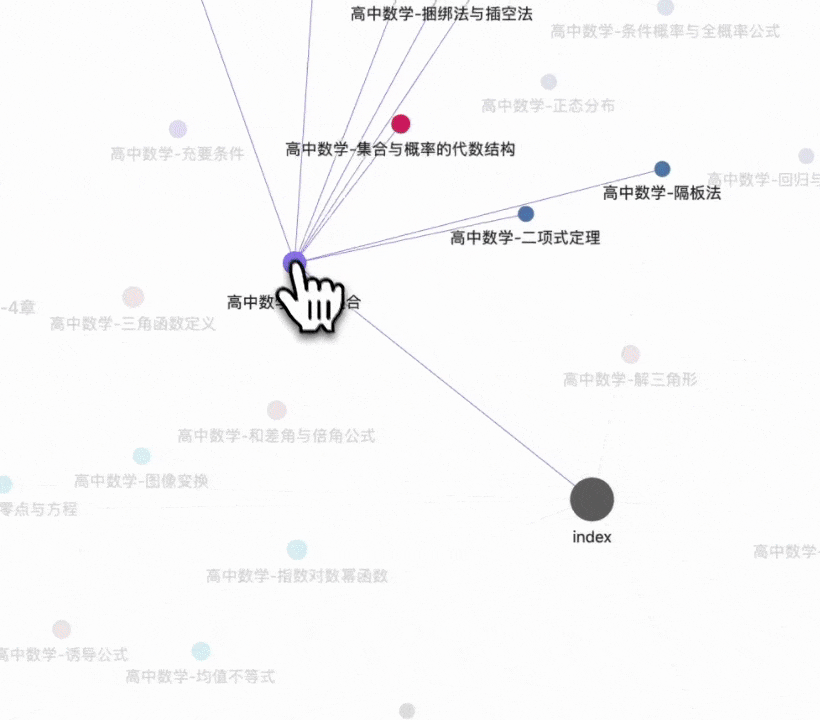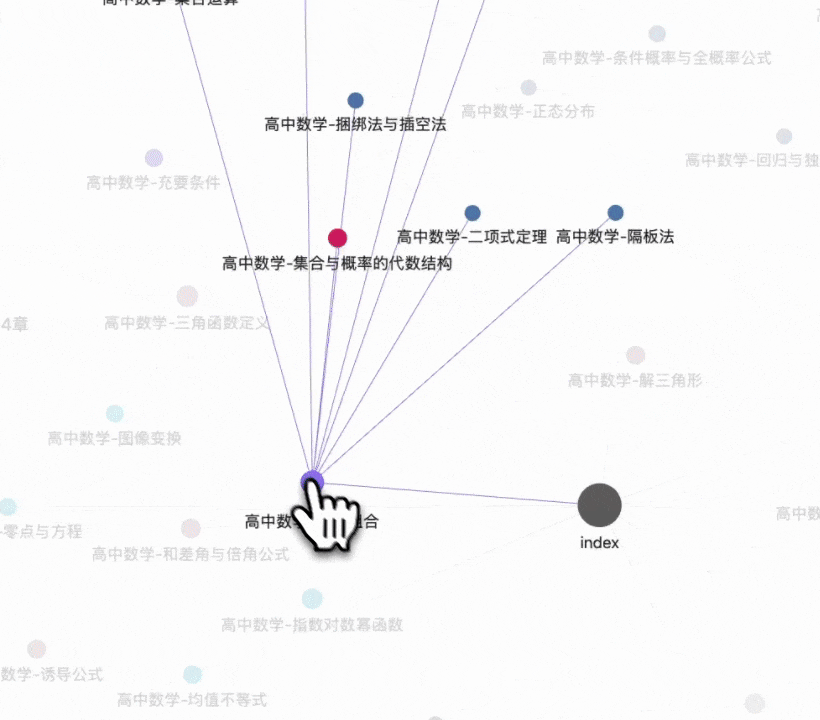
首先提前剧透一下由NextClaw搭建出来的高中数学知识图谱。《安装说明》看本号置顶贴图
教了几年数学的老师,都有一个观察:
好学生和普通学生的区别,不是谁做的题多,而是谁脑子里的知识是成网的。
举个例子。
一道题说:从含 4 件次品的 10 件产品中不放回地抽取 3 件,求次品数 X 的分布列。
好学生的脑子里会自动跑出一条链:
不放回 → 每次抽取不独立 → 不满足二项分布的前提 → 这是超几何分布 → 套分布列模板:定取值、逐值算概率、验证和为 1。
四步,四个知识点串在一起,几秒钟反应过来。
普通学生呢?二项分布是二项分布,超几何是超几何,独立性是独立性——三个孤立的知识点背得都熟,但在脑子里没有连上。
这道题他大概率会把"抽 3 件"直接套进二项分布,错得毫无知觉。
这不是天赋差异。是知识的组织方式不同。
但传统的学习方式——课堂笔记、错题本、期末画一张思维导图——全都是线性的、一次性的。
做完就扔,概念之间的关联始终是隐性的。
学生看到的永远是一条条孤立的知识点,从来没有人把整张网摊开给他看过。
我在想:能不能先把这张网真正建出来,让它可以被看见、被查询、被每天使用?
于是有了这套用 NextClaw 搭建的高中数学 LLM Wiki。
这一篇要讲的,就是这张网建好之后的事:怎么让它从"好看的图谱",变成一台每天推着你复习的引擎。
很多人的高中数学资料,最后都会变成几个文件夹:
• 课本知识点 • 错题截图 • 试卷 PDF • 收藏的讲题视频 • AI 聊天里的一段解答
资料不少,但真正遇到“导数不等式怎么下手”“圆锥曲线弦长题总错在哪里”时,还是得重新翻、重新搜、重新问。
问题不在于资料不够,而在于它们没有形成一张能复用、能复习、能持续维护的知识网络。
这就是我想用 LLM Wiki 做高中数学的原因。
它不是让 AI 再写一份知识点总结,而是把教材、题目、错因、方法和复盘,逐步编译成一套可查询、可链接、可维护的 Markdown 知识库。
数学最适合做 LLM Wiki 的地方
高中数学不是单纯“背公式”。
真正拉开差距的,往往是这几件事:
• 看见题目,能不能识别它属于什么结构; • 知道一个公式,能不能判断它的适用条件; • 做错之后,能不能定位到底是概念、方法还是计算出了问题; • 学完一个章节,能不能迁移到后面的导数、数列、概率、解析几何中。
这些都不是单页笔记能解决的。
例如,“均值不等式”不应只是一条公式。它应该连向:
• 函数最值; • 不等式放缩; • 构造函数; • 等号成立条件; • 常见误用; • 对应的典型题和错题。
这样,一页知识点才不只是“抄过”,而是未来解题时真正能被调用的节点。
1、知识库目录结构
高中数学知识库的目录,可以按下面的结构组织:
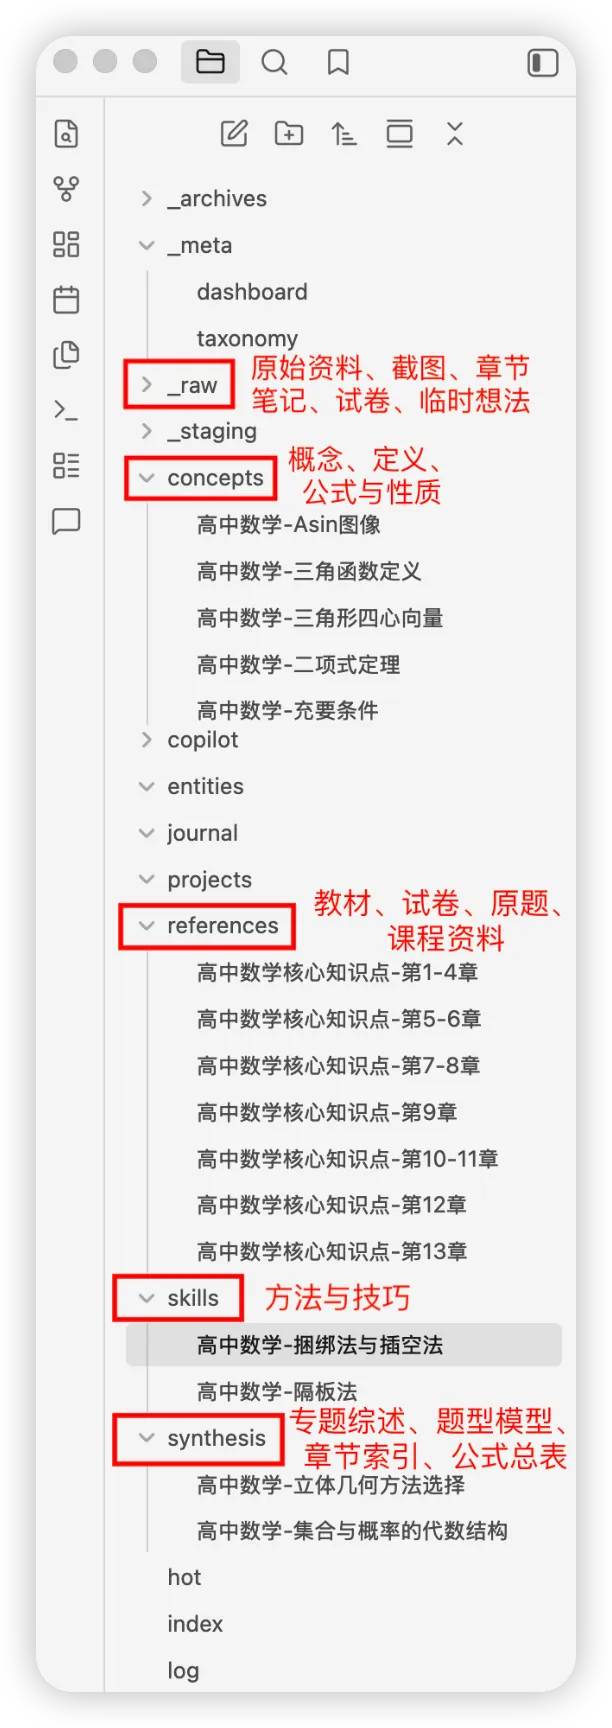
这套系统先把资料分成两层:
• _raw/ 原始资料、截图、章节笔记、试卷、临时想法 • concepts/ 概念、定义、公式与性质 • skills/ 方法与技巧 • references/ 教材、试卷、原题、课程资料 • synthesis/ 专题综述、题型模型、章节索引、公式总表
_raw/ 是收件箱,不要求整洁。
你可以把老师发来的讲义、错题整理、微信里转来的图片先放进去;之后再通过 ingest 流程,把它们提炼成正式页面。
这样做的好处是:原始资料始终保留,正式知识页面也不会被临时内容污染。
2、知识点页面结构
一张高中数学知识点页面,可以按下面的结构组织:
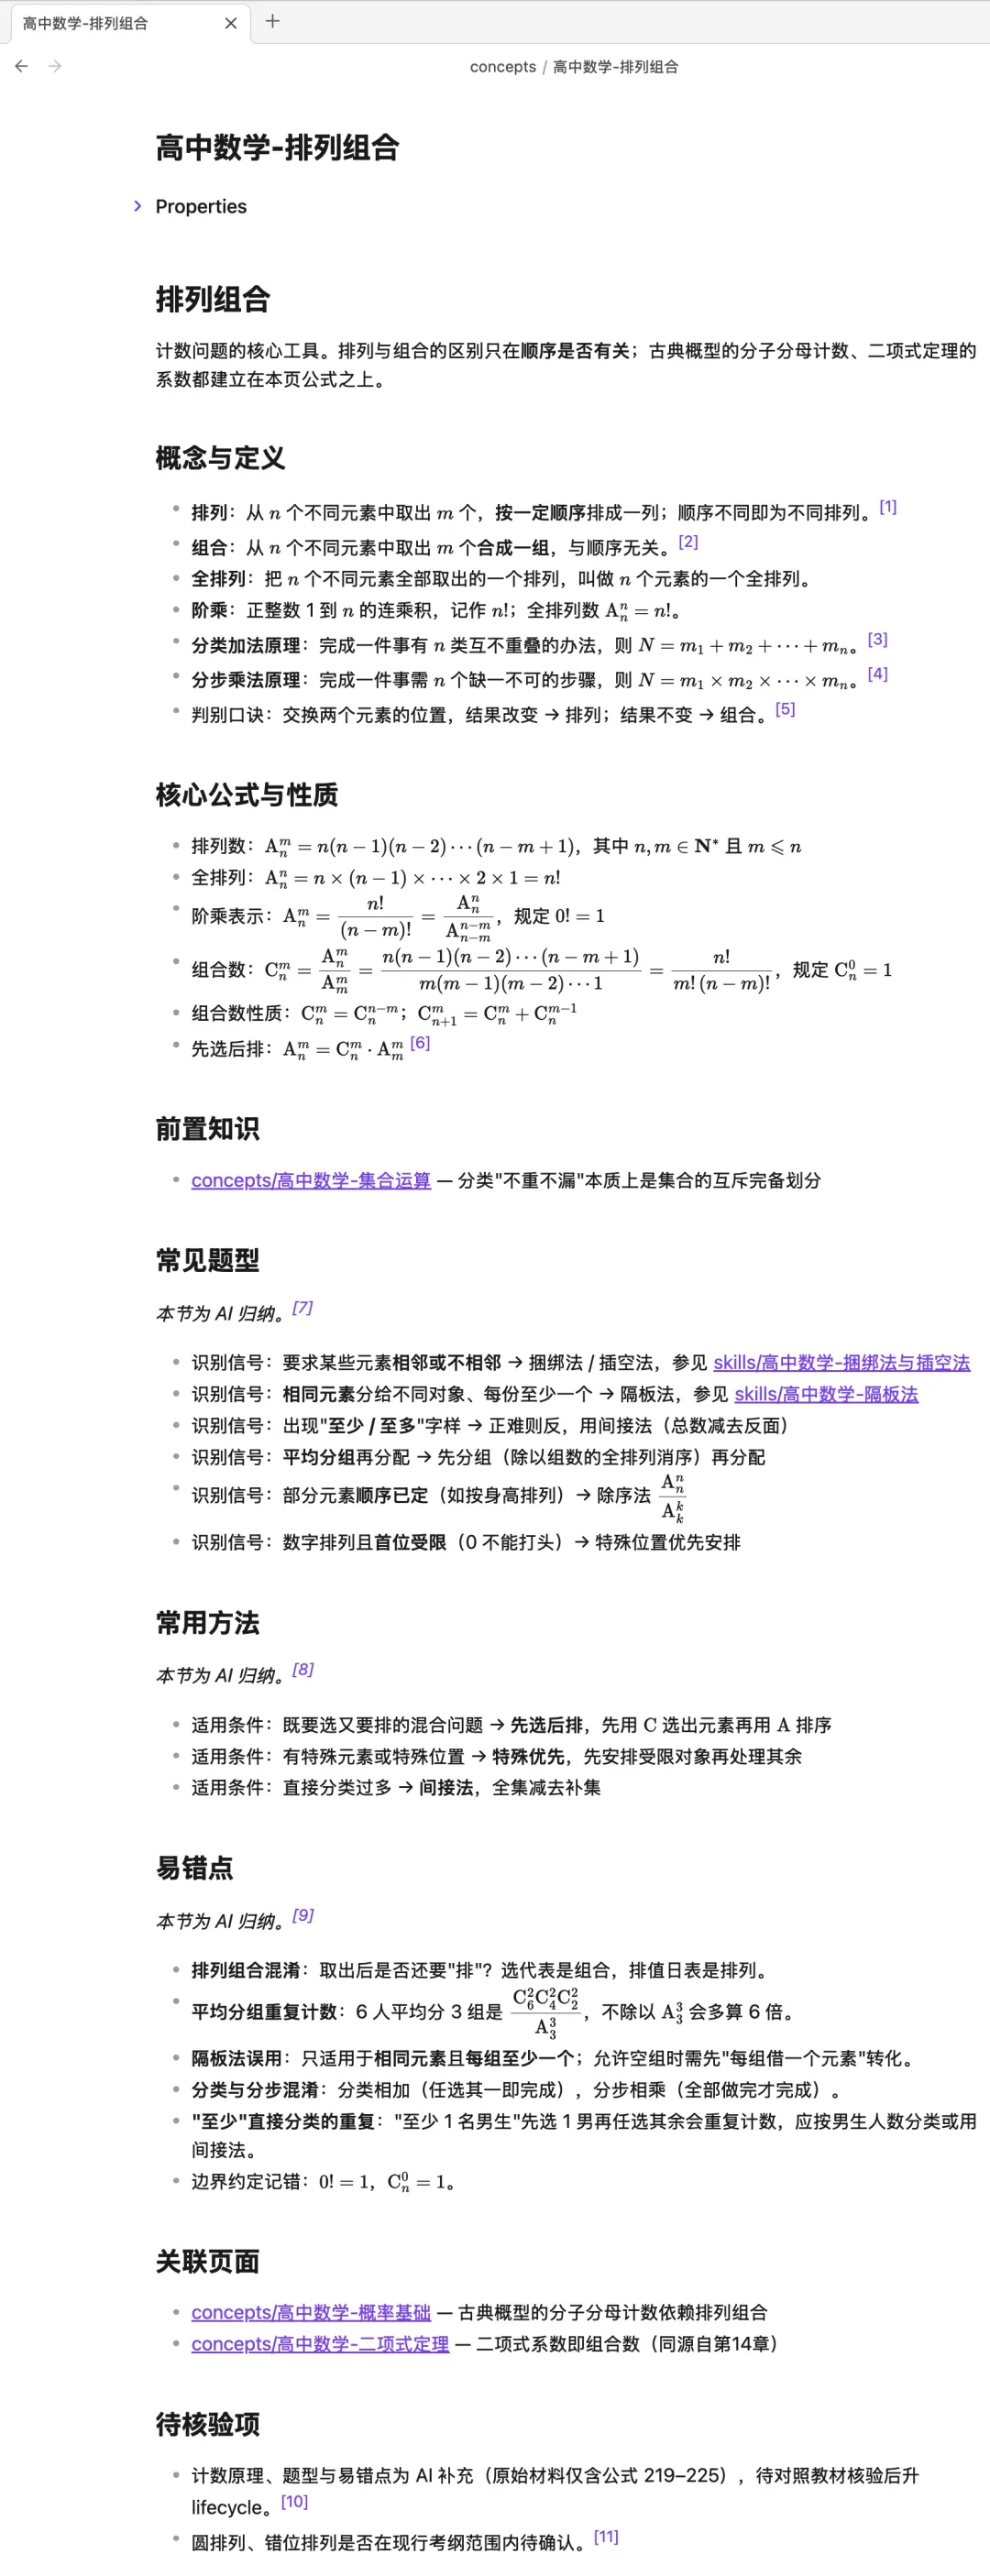
# 知识点名称## 概念与定义## 核心公式与性质## 前置知识## 常见题型## 常用方法## 易错点## 关联页面## 待核验项但这不是要求每页填满八个标题。
原则是:顺序固定,没有内容就省略。
比如“函数单调性”会重点写定义、判定、参数题、导数联系和易错点;“构造函数”作为方法页,则重点写适用信号、基本步骤和常见坑。
更重要的是,概念页不重复抄方法的完整内容。
“导数应用”可以链接到 [[构造函数]]、[[分类讨论]];“构造函数”再专门解释什么时候该用、怎样构造、容易漏掉什么。
这样,知识点、方法和题型各自有边界,又能彼此连接。
3、解题方法页面结构
一张高中数学解题方法页面,可以按下面的结构组织:
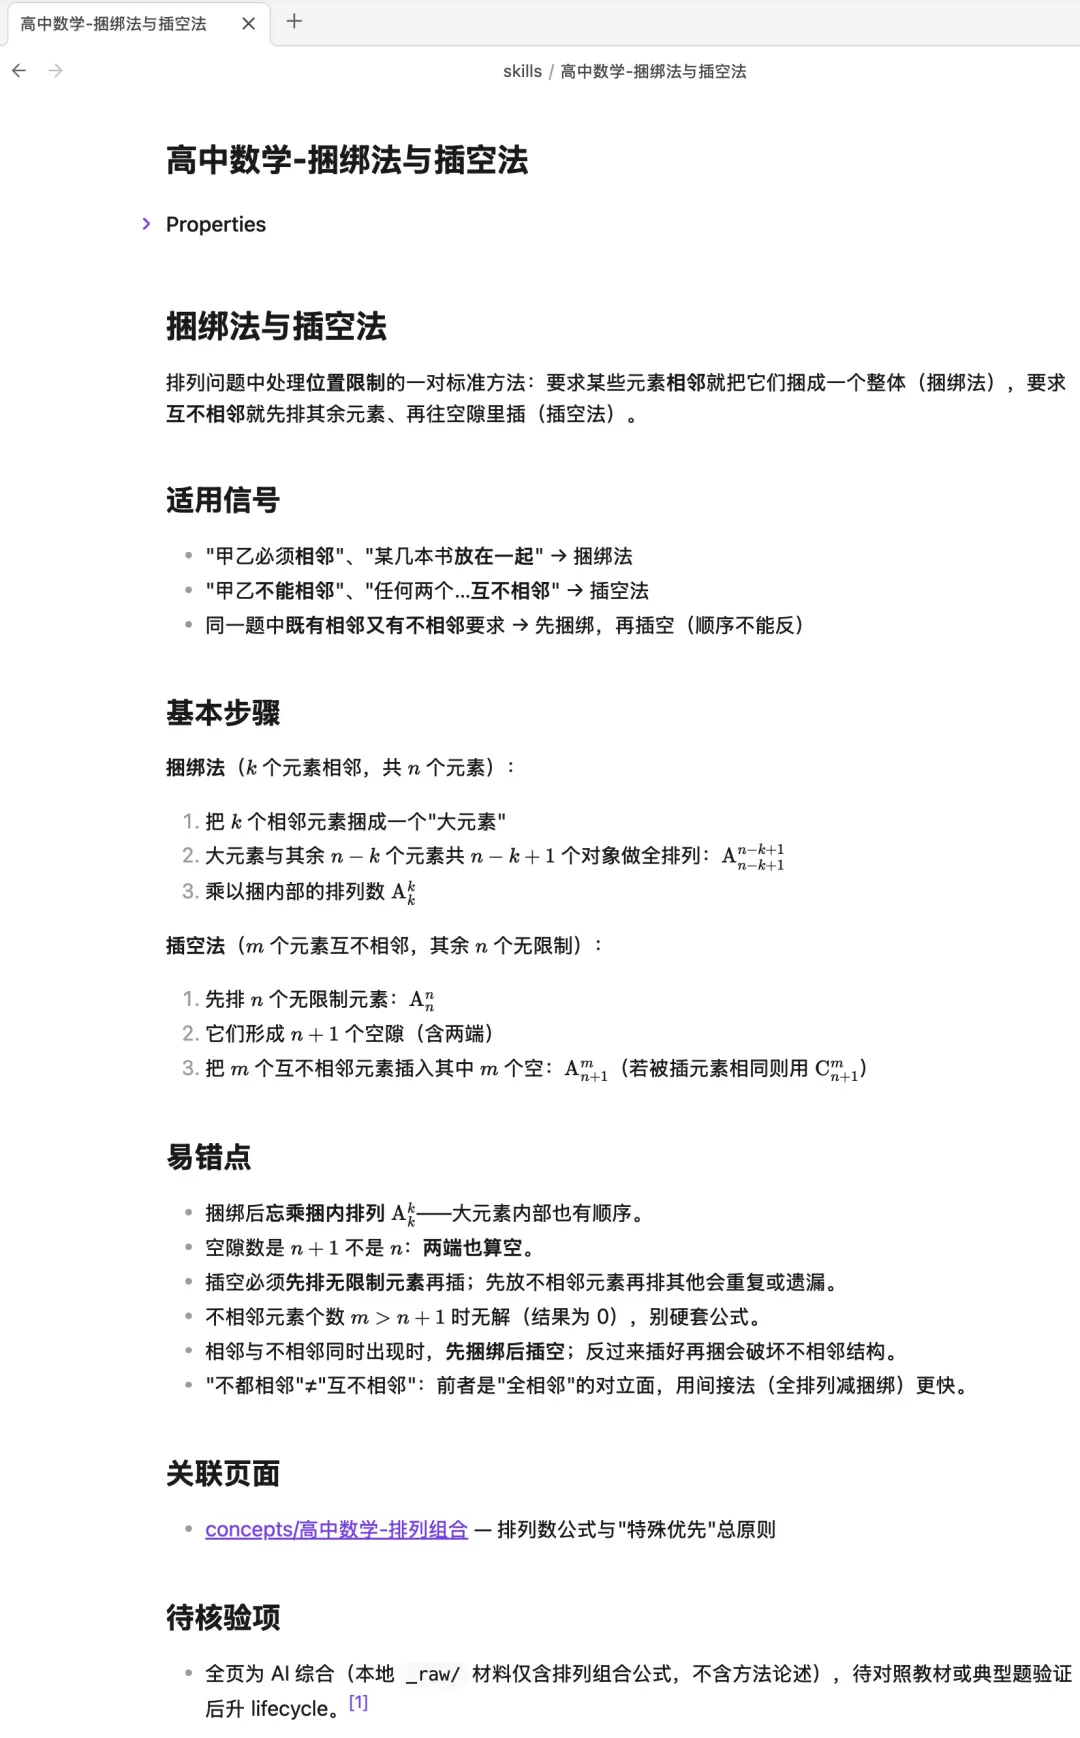
--- title: 高中数学-方法名称 category: skill tags: [数学, <域级标签>, <方法名称>] sources: [] summary: >- 一句话说明这个方法解决什么问题、适用什么条件。 provenance: extracted: 0.0 inferred: 0.0 ambiguous: 0.0 lifecycle: draft tier: supporting --- # 方法名称 一句话说明:这个方法的目标、核心思路与适用范围。 ## 适用信号 - 题目出现…… - 已知条件具有…… - 目标需要证明、求值、比较或分类…… ## 前置知识 - [[concepts/相关概念]] - [[concepts/相关公式或性质]] ## 基本步骤 1. 明确题目的对象、条件、定义域或参数范围。 2. 识别可调用的结构或转化方向。 3. 按方法的核心步骤处理。 4. 检查边界、等号条件、分类是否完整。 5. 回到原题,写出结论。 ## 常见变体 - 变体一:出现……时,改用…… - 变体二:若……,需要先…… ## 常见坑 - 忽略方法的适用前提。 - 漏掉定义域、参数范围或分类讨论。 - 中间结论成立,但未回代原题。 - 将充分条件误当成必要条件。 ## 典型题 - [[references/相关原题或试卷]] - [[synthesis/相关题型模型]] ## 关联页面 - [[concepts/相关概念]] - [[skills/相关方法]] - [[synthesis/相关专题]] ## 待核验项 - 尚未确认的结论、题型边界或来源。 使用规则: - 适用信号、基本步骤、常见坑 通常是方法页的核心。 - 前置知识、常见变体、典型题、待核验项 按需出现,没有内容就省略。 - 概念页只链接到方法页,不重复展开完整步骤;方法页也不重复解释概念定义。从"好看的图谱"变成一台推着你复习的引擎
下面具体讲怎么把一套已经建好的高中数学 LLM Wiki,从"好看的图谱"变成一台每天推着你复习的引擎。顺便你会看到,这台引擎在运转过程中,还替我抓出了原始资料里的两处笔误。
先交代现状。经过前几篇的流程,这套 Wiki 目前长这样:
• 41 张概念页,覆盖高中数学全部主干章节 • 2 张方法页(捆绑法与插空法、隔板法) • 2 张综合页(立体几何方法选择、集合与概率的代数结构) • 7 张章节参考页 • 一份控制标签词表:11 个域级标签,每页最多 5 个标签 • 图谱 14 个颜色组,按域上色
页面数量不算多。但接下来你会看到——
复习引擎需要的不是页面数量,而是页面上的三个字段。
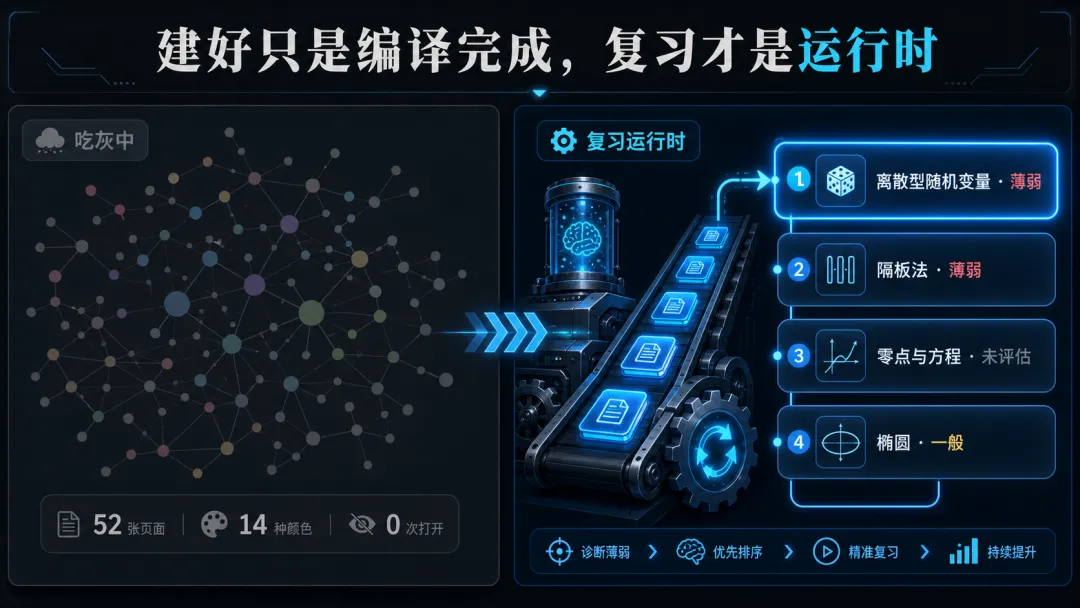
玩法一:给每一页装上"复习状态"
Markdown 页面的 frontmatter,本质上是一个小型数据库。
大多数人只用它放标题和标签。但既然每个知识点都是一张独立页面,那"我掌握得怎么样"这件事,也完全可以记在页面自己身上。
于是给全部 43 张概念页和方法页,统一加上三个字段:
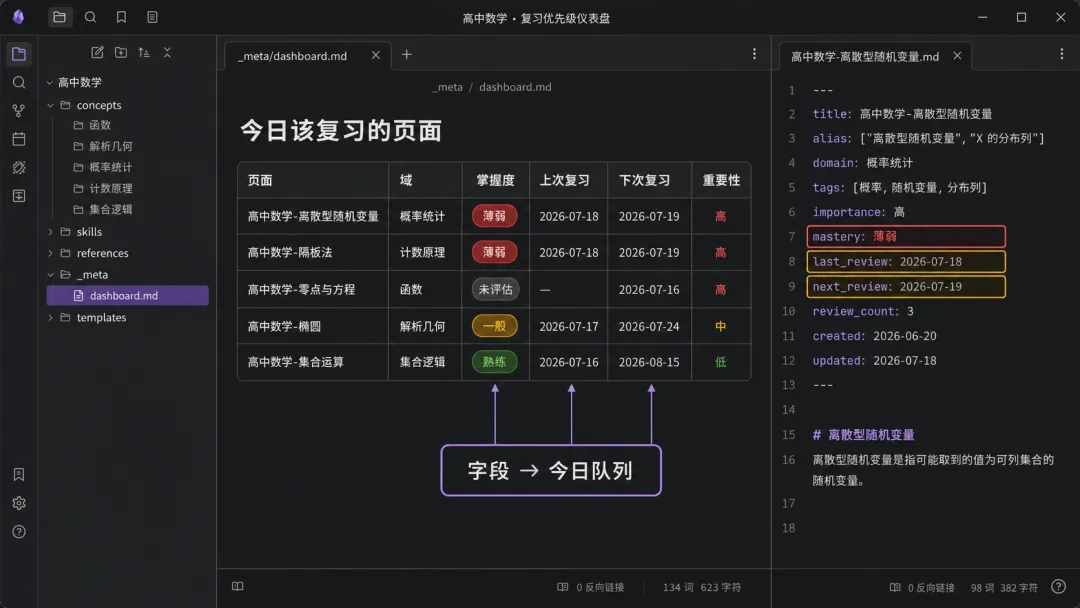
mastery: 未评估 # 未评估 | 薄弱 | 一般 | 熟练last_reviewed: null # 上次复习日期next_review: 2026-07-16 # 下次该看它的日期这里有一个容易做错的细节:初始值不要虚构。
AI 可以帮你把 43 页的字段一次性初始化好,但它不知道你真实的掌握程度——你自己在没做题之前也不知道。所以所有页面统一初始化为"未评估",全员进入首轮复习队列。
掌握度只有一个来源:你真实复习过、真实做错过之后,亲手改这个字段。
复习一页,评一页。做错一题,降一页。字段慢慢从"未评估"分化成"薄弱、一般、熟练",这张知识网络就开始有了你的指纹。
知识网络是 AI 编译出来的,掌握度地图只能由你自己跑出来。
玩法二:一张 Dataview 表,免费打造一个 Anki
字段有了,接下来让它们动起来。
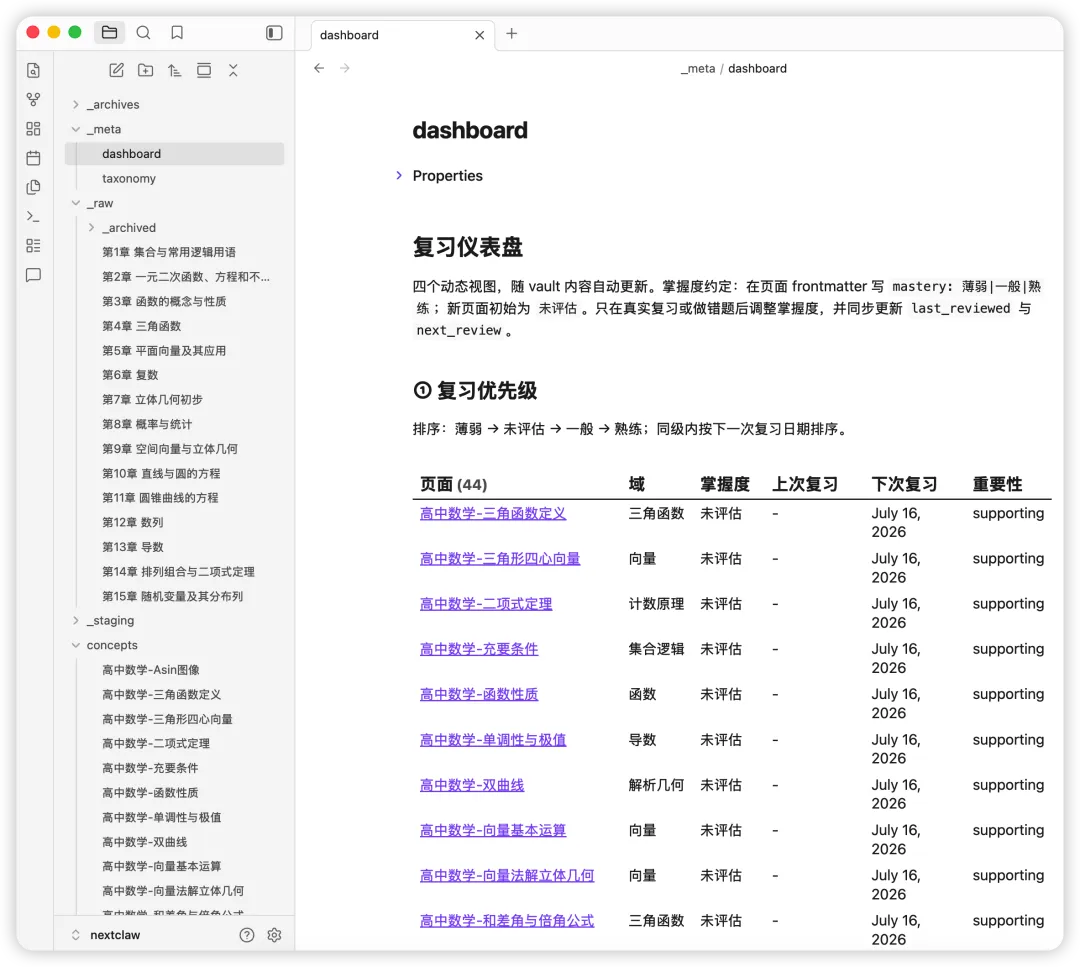
在 _meta/dashboard.md 里放四个 Dataview 视图。它们全部是活的查询,随页面字段自动更新,不需要任何手工维护:
① 复习优先级 —— 核心视图。所有概念页和方法页,按"薄弱 → 未评估 → 一般 → 熟练"排序,同级内按 next_review 日期升序。每天打开,最上面的就是今天该看的。
② 待核验清单 —— 所有 lifecycle: draft 的页面。AI 生成的内容核验一页升级一页,这张表自动缩短,等于一个验收看板。
③ 易错总览 —— 所有带 #易错 标签的页面。考前把这张表过一遍,等于把全库的易错点小节集中检阅。
④ 按域浏览 —— 全部概念页按 11 个域级标签分组。这是标签归一化的直接红利:词表没统一之前,这张表根本做不出来。
再配一条简单的推迟规则,间隔重复就成型了:
复习完改三个字段,页面自动沉到队列里它该在的位置。
没有装任何间隔重复插件,没有把知识点搬进另一个 App。就是 frontmatter 加一张 Dataview 表——
用知识库自己的零件,拼出了一个 Anki。
玩法三:错题三层链——原题、错因、方法各归其位
错题本是每个学生都被要求做、但很少有人真正回头看的东西。
问题出在结构上:传统错题本把原题、错因、正确解法抄在同一页纸上。它是一个终点——抄完就结束了,和你的知识体系没有任何连接。
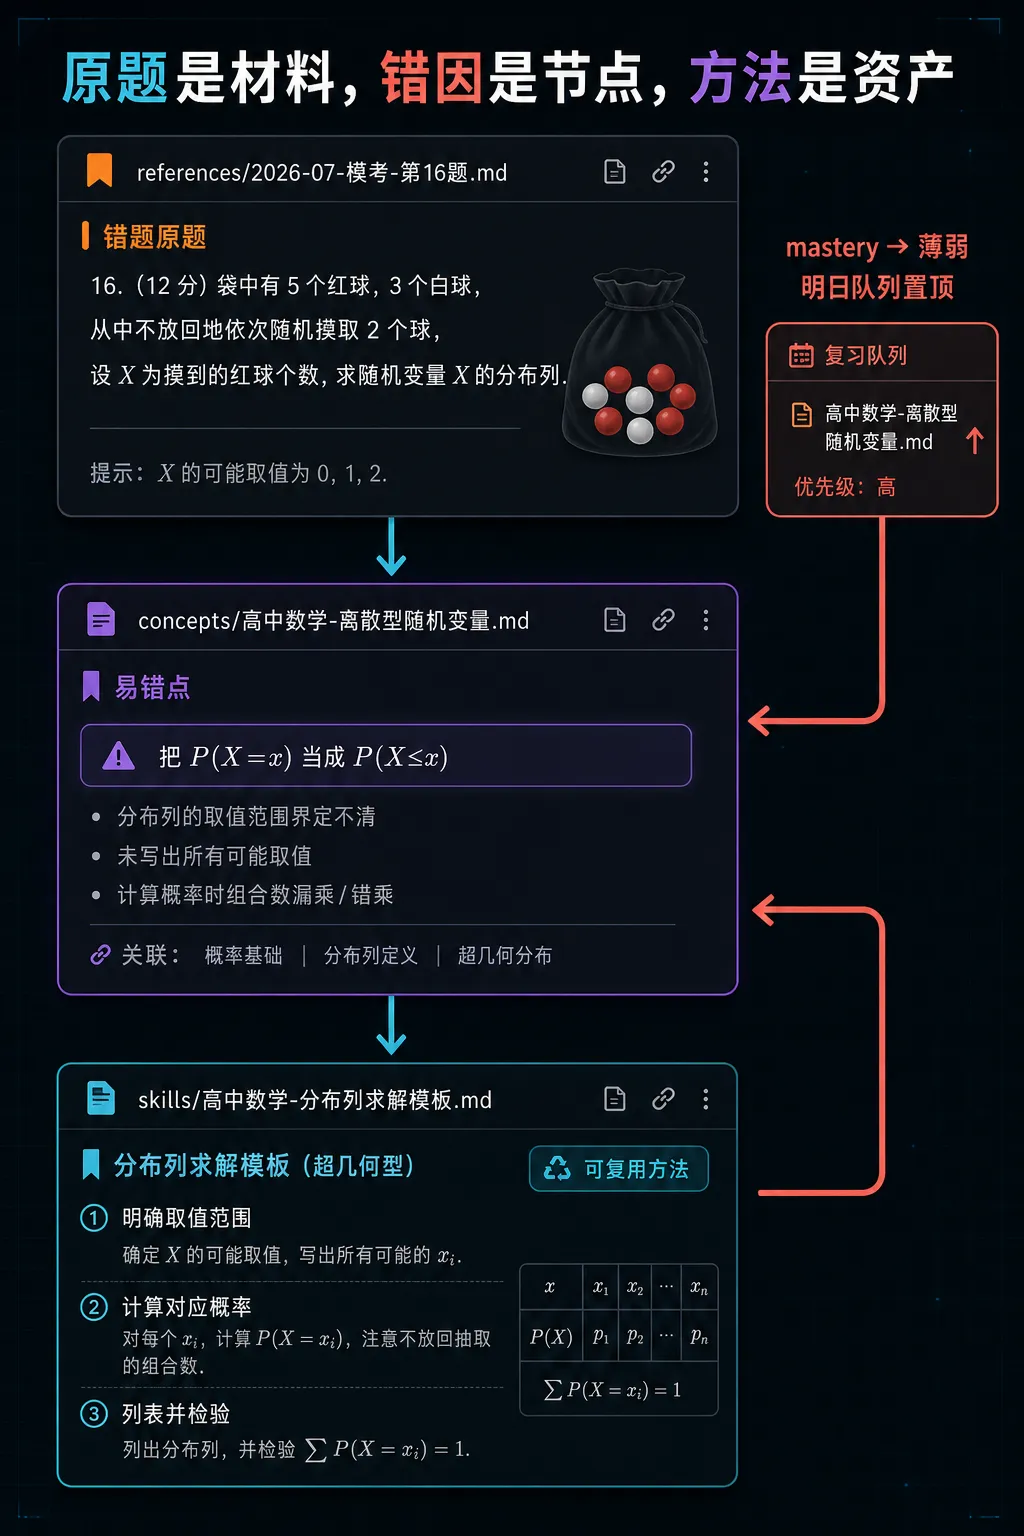
在 Wiki 里,一道错题被拆成三层,各归其位:
references/2026-07-模考-第16题.md ← 原题(题目本身是材料) ↓ wikilinkconcepts/高中数学-离散型随机变量.md ← 错因(页内"易错点"小节) ↓ wikilinkskills/高中数学-分布列求解模板.md ← 方法(可复用的解题模型)为什么这样拆?因为题目本身是材料,解题经验才是可复用知识。
原题放 references/,它是证据,永远不用改。
错因指向概念页的易错小节——如果这个错误模式还没被收录,就补一条。这条易错点从此服务所有后续复习,而不是只服务这一道题。
方法指向 skills/ 方法页——如果方法页还不存在,这道错题就是建页的最好时机。
最后一步,把闭环接回复习引擎:把对应概念页的 mastery 改成"薄弱"。
这一页明天就会出现在复习队列最顶端。
错题不是终点,是引擎的燃料。
玩法四:识别信号与适用信号,互为镜像
这套 Wiki 的页面模板里,藏着一个专门为做题设计的机关。
概念页有一节"常见题型",每条长这样:
识别信号:相同元素分给不同对象、每份至少一个 → 隔板法,参见 [[高中数学-隔板法]]
方法页有一节"适用信号",每条长这样:
" 个相同的球分给 个不同的盒子"、"每组至少一个" → 标准隔板:
注意到了吗?这两节互为镜像。
从概念页出发:我在复习"排列组合",看到某类题面特征该用什么方法,一跳就到方法页。
从方法页出发:我在复习"隔板法",看到它能解决哪些题面特征,一跳回概念页。
考场上真正的难点,从来不是"隔板法公式是什么",而是"这道题该用隔板法吗"。识别信号训练的正是这个判断。
由此衍生一个进阶玩法——考我模式:让 AI 从 Wiki 里抽取识别信号,反向出题。
AI:一道题说"把 10 个相同的名额分给 7 个班级,每班至少一个",用什么方法?你:隔板法,。AI:正确。追问:如果允许某些班级为零呢?
答错了?对应页面 mastery 降为薄弱,自动接回复习队列。
整个问答的素材全部来自你自己的页面。
AI 出的每道题,都有页面可溯源——它不是在考你,是在陪你巡检自己的知识网络。
玩法五:图谱不是装饰品,是体检报告
图谱好看,但好看不是目的。
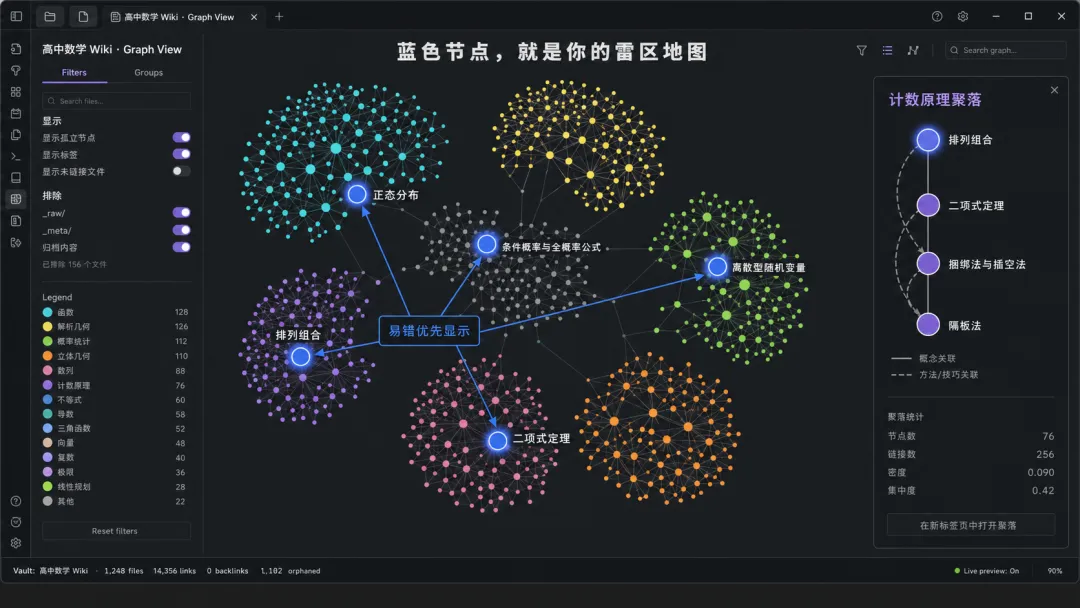
这套 Wiki 的图谱配了 14 个颜色组:11 个域级标签各一色,方法页、综合页、参考页按目录各一色。其中有一条特殊规则:
#易错 标签的蓝色,排在所有颜色组之前。
也就是说,不管一张页面属于哪个域,只要它带着易错标记,图谱上就是蓝色。打开图谱,蓝色节点的分布就是你的"雷区地图"——哪个板块蓝点密集,哪个板块就是考前重点。
图谱还能看出三种病:
• 孤立节点:没有连线的页面,说明它还没织进网络,交给 /cross-linker• 异常巨大的节点:连线过多,说明主题可能拆得不够细,考虑拆页 • 只有目录关系、没有方法关系的区域:说明这个板块只完成了收纳,还没真正"编译"
图谱不是用来欣赏的,是用来发现哪里还没长好的。
玩法六:沿依赖链找病根
高中数学的知识不是并列的,是有依赖方向的。
这套 Wiki 在 frontmatter 里用类型化关系记录了这个方向:
relationships: - target: "[[高中数学-排列组合]]" type: uses # 本页依赖排列组合 - target: "[[高中数学-概率基础]]" type: extends # 本页建立在概率基础之上uses 和 extends 都是先修语义。于是可以做传递查询:
学正态分布之前,需要先掌握哪条链?→ 正态分布 → 离散型随机变量 → 排列组合 + 概率基础 → 集合运算
这条链最实用的场景是找病根:当某一页被评为"薄弱"时,先别急着刷这一页的题——沿着 uses 边往上游查一层。
分布列算不对的人,病根经常在排列组合。
圆锥曲线联立总出错的人,病根经常在韦达定理。
在下游刷题,不如在上游补课。依赖链让"往上游查"从一句经验,变成一次可以真正执行的查询。
玩法七:AI 写的每一句话,都欠你一次核验
这套 Wiki 有一条硬约定:AI 生成的内容必须带溯源标注。
• 从原始资料忠实提取的内容,不加标记 • AI 综合补充的内容,逐条标 ^[inferred]• 来源含糊或冲突的内容,标 ^[ambiguous]
每张新页面出生时都是 lifecycle: draft,出现在仪表盘的"待核验清单"里。你对照教材核验一页,升级一页 evergreen。
这个流程看起来是负担,直到它抓住了真问题。
摄取第 14、15 章时,AI 发现了原始资料里的两处笔误:一处是二项式系数中间项的公式排版错乱,一处把"互斥事件"写成了"互反事件"。两处都被按标准结论修正,并标上 ^[ambiguous] 留待人工确认——而不是悄悄照抄,也不是悄悄改掉。
还有一处更微妙:资料里相关系数 的强弱分界用 0.25/0.75,而部分教材用 0.3/0.75。这种口径冲突被单独记进了矛盾清单,标注"以任课教师口径为准"。
一套会给资料纠错、并且把裁决权交还给你的复习系统——这是溯源标注真正的价值。
AI 负责发现和起草,人负责裁决。裁决权不外包,这在教育场景里不是效率问题,是底线问题。
终局玩法:把 Wiki 打包成你的私人数学家教
当大部分页面升级为 evergreen、掌握度地图跑出轮廓之后,还有最后一层玩法。
把整套成熟的 Wiki 打包成一个 Agent Skill。
打包之后,在任何会话里问数学题,AI 不再泛泛地从互联网知识里作答,而是用你自己的知识体系来讲解:你的符号习惯、你归纳的识别信号、你踩过的易错点、你命名的方法页。
一个真正"懂你学习史"的家教。
再配上两个周期性动作,引擎就能长期运转:
• 每周: /wiki-digest week生成一份周报——本周复习了什么、哪些页面掌握度变化、新增了什么内容• 每天: /daily-update挂上定时任务,晨间自动刷新索引和状态
这套玩法不只属于数学,也不只属于学生
回头看这台引擎的零件清单:三个复习字段、识别信号、易错标签、错题三层链、依赖链、溯源标注。
没有一个零件是数学专属的。
换一门科目,照样能转
物理:概念页装定律与模型,方法页装"受力分析模板""能量观点还是动力学观点"。识别信号照写不误——
识别信号:斜面 + 摩擦 + 缓慢移动 → 受力分析 + 准静态处理,参见 [[受力分析模板]]
化学:#易错 标签天然适合"方程式配平陷阱""实验操作顺序"这类高频失分点;矛盾清单则用来管理不同教材对同一实验现象的表述差异——和数学里 分界的口径冲突是同一个问题。
英语:错题三层链直接平移。完形填空的原题进 references/,错因指向语法点页的易错小节("定语从句关系词误选"),方法指向"长难句拆解模板"。
历史、地理:依赖链换个语义照样成立。uses 边在数学里是"先修",在历史里是"因果",在地理里是"成因推导"——"分析安史之乱之前,先掌握哪条链"和"学正态分布之前,先掌握哪条链"是同一个查询。
而且多科不需要多个知识库。域级标签词表扩一层"科目"维度,图谱颜色组照旧,一个 vault 装下整个高中。
换一个角色,看的是不同视图
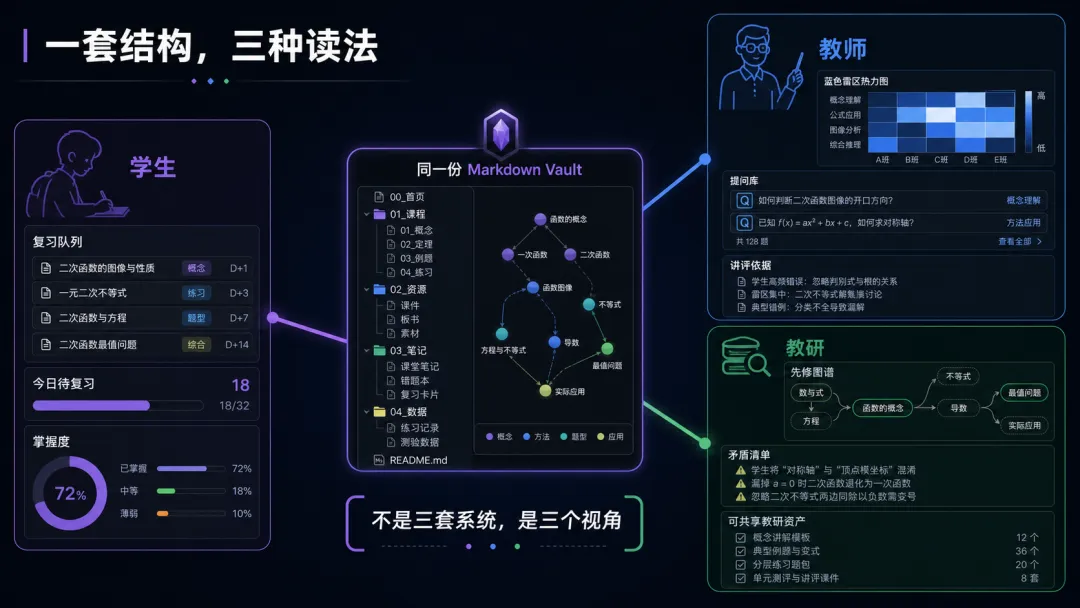
学生、教师、教研,用的是同一套页面结构,差别只在打开哪张视图:
对教师,最直接的一点是:把一个班的错题按三层链归位之后,"易错点"小节的引用频次就是天然的学情统计。蓝色雷区哪里密集,讲评课就讲哪里——不需要再做一次问卷。而概念页里那些"识别信号",本来就是现成的课堂提问和变式命题素材:把信号读出来让学生答方法,就是一次即兴检测。
对教研,价值在另外两处。其一,uses/extends 依赖链就是一张可以查询的先修图谱,排课序、设计螺旋上升的教学路径时,它比经验靠谱。其二,还记得 AI 抓出"互反事件"笔误的那个流程吗?那本质上就是讲义校对流程——溯源标注让每一份下发资料都能回答"这句话是从哪来的、谁核验过"。教研成果沉淀成方法页和综合页,而不是散落在各自电脑里的 PPT。
学生用它复习,教师用它讲评,教研用它设计——同一份 Markdown,三种读法。
总结:知识库的价值,在建成之后才开始计算
把这一篇的玩法串成闭环:
每天打开复习仪表盘→ 复习队列顶端的页面→ 评掌握度,更新 next_review→ 做错题?原题进 references/,错因进易错小节,方法进 skills/→ 对应页面 mastery 降为薄弱,回到队列顶端→ 薄弱页沿 uses 链往上游查病根→ 考前打开易错总览和蓝色雷区地图→ 每周 digest 回顾,draft 页持续核验升级→ 页面足够成熟时,打包成私人家教 Skill上一节说过,这套零件不属于数学,也不只属于学生。再往外走一步:任何有"掌握程度"概念的领域——考证、语言学习、面试准备、新员工培训——都可以用同样的三个字段和一张仪表盘,把静态知识库改造成复习引擎。
前几篇我们说:AI 负责簿记,人负责判断。
这一篇可以再加一句:
AI 负责编译知识,人负责运行它。
知识网络编译得再漂亮,不运行,就只是一座安静的藏经阁。
而运行它需要的,不过是每天打开仪表盘,看一眼队列顶端的那几页。
如果你也在关注 Obsidian、私有化知识库、LLM Wiki、OpenClaw 或 AI Agent 工作流,可以关注这个系列。我会继续分享 NextClaw 的真实搭建过程、产品设计和使用案例。
如果觉得内容不错,请随手关注
并点个
、转发、
三连吧,您的支持,是我持续更新的动力。
往期文章精选
把AI入口嵌进Obsidian:OpenClaw开始自动维护你的个人知识库
把Obsidian接进OpenClaw:不用WorkBuddy也能让Markdown变成自己生长的AI知识库
为什么全球最懂AI的人说LLM Wiki才是你那个“越记越乱”的知识库救星?
设备选型报价不用再等老师傅了:一个AI知识库售前Agent落地复盘
NextClaw 硬件配置方案:为什么工作站可能是 AI 知识库落地的最优解
143分!全网疯传的高考数学世界杯,“反刷题”新规被AI踢爆了?
AI 时代最贵的不是算力,而是你自己的知识库 — 解密NextClaw 私有化部署架构
自由职业者必备:保姆级教程,熬夜整理!用这5个开源工具,从零搭建私有化AI知识库(附完整架构图)
只会RAG的AI像个实习生,会长期记忆的AI像个合伙人——你的知识库是哪种?
NextClaw:ChatGPT之后的下一个战场,让AI直接操作你的个人知识库
NextClaw:当所有AI知识库都在抢你的数据,只有一种方案让你继续拥有控制权
NextClaw:用OpenClaw构建的知识库,为什么应该同时存在于电脑、手机、iPad 和服务器上?