ARTICLE · 1047578
OpenAI缓存诊断更新,能帮学习工具什么
(虚构情境)一位家长看到学习工具宣传“教材已经缓存”,便问:“那它是不是一直记得孩子哪里不会?”这其实是三个不同的问题。
一份材料曾被系统处理过,系统能否找到上次对话,以及孩子是否已经掌握知识,各自需要不同证据。把它们都叫“记住了”,很容易误读产品功能,也容易把工具运行得顺畅当成学习发生了。
2026年9月8日,OpenAI宣布Prompt Cache Diagnostics,也就是提示缓存诊断,在Responses API面向GPT-5.6及后续受支持模型正式开放。[1] 这不是今天的新模型,也不是ChatGPT里向所有家长新增的学习按钮。本文是动态解读和应用设想,没有实际调用该功能或进行教学实测。
新的不是“会缓存”,而是能查为什么没复用
想象教师已经为一个阅读单元准备了背景资料与任务要求,之后每次只换一道问题。模型每次回答都要处理输入;若开头一段内容及相关条件保持一致,符合条件的缓存能复用部分已经完成的计算。[2] 可以把它理解为同一份底稿不用每次从头处理,但这只是帮助理解的类比。
缓存保存的是计算中的中间状态。它没有把这一单元训练成模型永久新增的知识,也不直接证明孩子学到了什么。官方说明,缓存不会改变输出生成方式;即使输入相同,也不保证两次答案完全一致。[2]
此前开发者已经能查看缓存用量,也有监测表现的仪表板。这次更新让开发者把当前请求与某个先前回复进行比较,查看模型、工具或输入等变化是否妨碍了预期复用。[3] 比如一套材料没有换,但工具名称或顺序变了,诊断可能提示相关原因。
所以它更像帮助建设者查运行问题的一项功能。它不能给作文评分标准背书,也不会告诉教师哪条教学建议正确。家长值得知道这件事,是因为越来越多学习工具会用运行指标介绍自己;看懂指标的边界,才能问到与孩子有关的问题。
第一种应用:同一单元,分别练不同问题
下面用自拟材料说明设计方法,不展示模型输出。成人准备一份获准使用的阅读材料,固定目标是区分“观察到的事”与“对原因的猜测”。第一道问题给出“纸片移动了,所以一定有风”,第二道换成“窗边的叶子动了,可能是有人经过”。每次只让学生解释哪部分是观察,哪部分是推测。
可交给有资格使用相关API的开发者验证的提示草案是:“固定任务:依据所附阅读材料,帮助学习者区分观察与推测。先提一个问题,等学习者回答,再指出依据。不得直接替学习者完成整组题。材料版本:A。当前练习:纸片移动了,所以一定有风。”
开发者可以把稳定的目标与获准材料放在前部,把当次练习放在后部,再按官方要求设置可复用的边界。仅把文字顺序这样摆放,并不保证命中;还涉及模型、长度、边界与运行条件。GPT-5.6及后续模型的最小可缓存前缀长度为1024个输入token,token是模型处理文本的单位,并不等于中文字数。[2]
这段短提示用来解释结构,不满足演示完整缓存请求的条件。不要为了凑门槛往学习资料里加无关内容。成人也不必懂接口才能做这次练习:把两句话写在纸上,让孩子划出观察与推测,再解释“所以一定”和“可能”表达的确定程度有何差别。
合格的学习回答应能指出纸片移动是观察,有风是尚需依据的解释;第二句同样不能仅凭叶动就确定有人经过。这个人工验收标准来自材料本身,与工具是否缓存成功无关。孩子若只是照抄答案,还应换一个熟悉例子让他独立判断。
第二种应用:批量反馈时保住同一把尺子
另一个待验证方案,是成人为若干自拟段落生成初步反馈。固定要求写成:“只检查观点是否有材料支持,以及解释是否越过材料范围。指出一处依据和一个追问,不打总分,不推断作者能力,不生成可直接提交的完整改写。”之后每次附不同的匿名练习段。
例如段落写:“小组成员互相核对日期,发现并改正了一处错误,所以合作在所有任务中都比独立完成好。”人工先建立基准:前半句可以支持这次互相核对的价值,后半句超出了单个例子的范围。反馈若只是夸奖逻辑清晰,即便缓存命中率很高,教学验收仍然不合格。
若第二次调用突然慢了,开发者可以用新诊断比较请求变化;若教师修订了评价要求,就应更新要求并接受可能减少的复用。不能为了保住一个漂亮的技术指标,继续沿用已发现有问题的规则。
这个例子也说明,统一背景有利于让任务条件清楚,却不能保证每份反馈都公平正确。教师仍需抽查材料对应关系,家长仍需看孩子是否理解反馈。实际学生作业的处理还涉及授权、数据和适龄安排,本文只用成人自拟材料说明设想。[4]
三个问题,分别问运行、记忆和学习
面对“我们的系统记得教材”的介绍,家长先问:“记得指复用了计算,还是会保存并调用上次的谈话?”缓存诊断中的比较标识只请求比较,不会自动加载早先对话,也不会改变缓存行为。[3] 不能因为后台选中了某次回复,就认定它已拿到孩子之前的全部内容。
接着问:“如果资料改版或学生换了,怎样保证当前材料和当前回答对应?”正确性要靠实际输入、权限隔离和验收去确认,不能靠缓存这个词推断。若对方说不清,就先使用不涉及真实学生信息的小样本材料了解功能。
最后问:“孩子离开工具后能独立完成什么?”这才把讨论带回学习。对于上述练习,观察与推测能否区分、单个事例能支持多大的结论,都能在纸上再做一次。后台速度和复用量可以记录,却不能充当成绩提升的证据。
看见“不可用”,也不能替它猜一个成功结果
设想一个开发者把两次反馈请求送去比较,得到的是诊断暂不可用。这个结果不能解释为没有复用,也不能解释为已经复用;应查看实际用量字段,并按文档换一条近期可比较记录或继续排查。诊断记录不存在或过期,同样不等于先前对话内容必然已被删除。[3]
如果比较提示命中,也只是未发现该次比较预期中的缓存缺口。当前新输入仍然需要处理,实际复用了多少应看用量记录。家长无需学习这些字段的写法,但可以据此要求服务提供者把运行说明与教学效果分栏,不用“系统状态正常”回答“孩子是不是更会写了”。
还有一个容易误读的边界:官方说诊断记录不保存原始提示和模型输出,指的是这项诊断功能的记录方式,不能由此推断整个学习应用从不保存学生内容。[3] 应另外查看应用与API的数据规则。本文不收集真实作业,不用去掉姓名就宣称已消除所有个人信息风险。
入口与边界,在尝试之前说清
功能入口在Responses API,需要具备服务资格、项目权限和可用模型的开发者接入;普通聊天提示不能直接开启诊断。核验时OpenAI的API支持地区列表不含中国大陆。[5] 国内家长和教师可把本文作为功能认知与纸笔练习,不按即用教程理解,也不需要为了本文购买服务。
官方说明诊断本身不额外收费,但额外的基准请求、重试和正常模型调用仍按规则计费;诊断也可能不可用、记录过期,或只报告首个识别出的原因。[3] 更高的缓存复用不自动等于总成本更低,更不等于输出更正确。本文不估算单次费用,也没有测得速度或学习收益。
今天能做的四件事很简单:把产品的“记得”问具体;选一份不含个人信息的材料;自己写出正确性基准;让孩子脱离工具再判断一个新例子。技术进展值得了解,而学习的证据,仍要落在孩子做出的解释里。
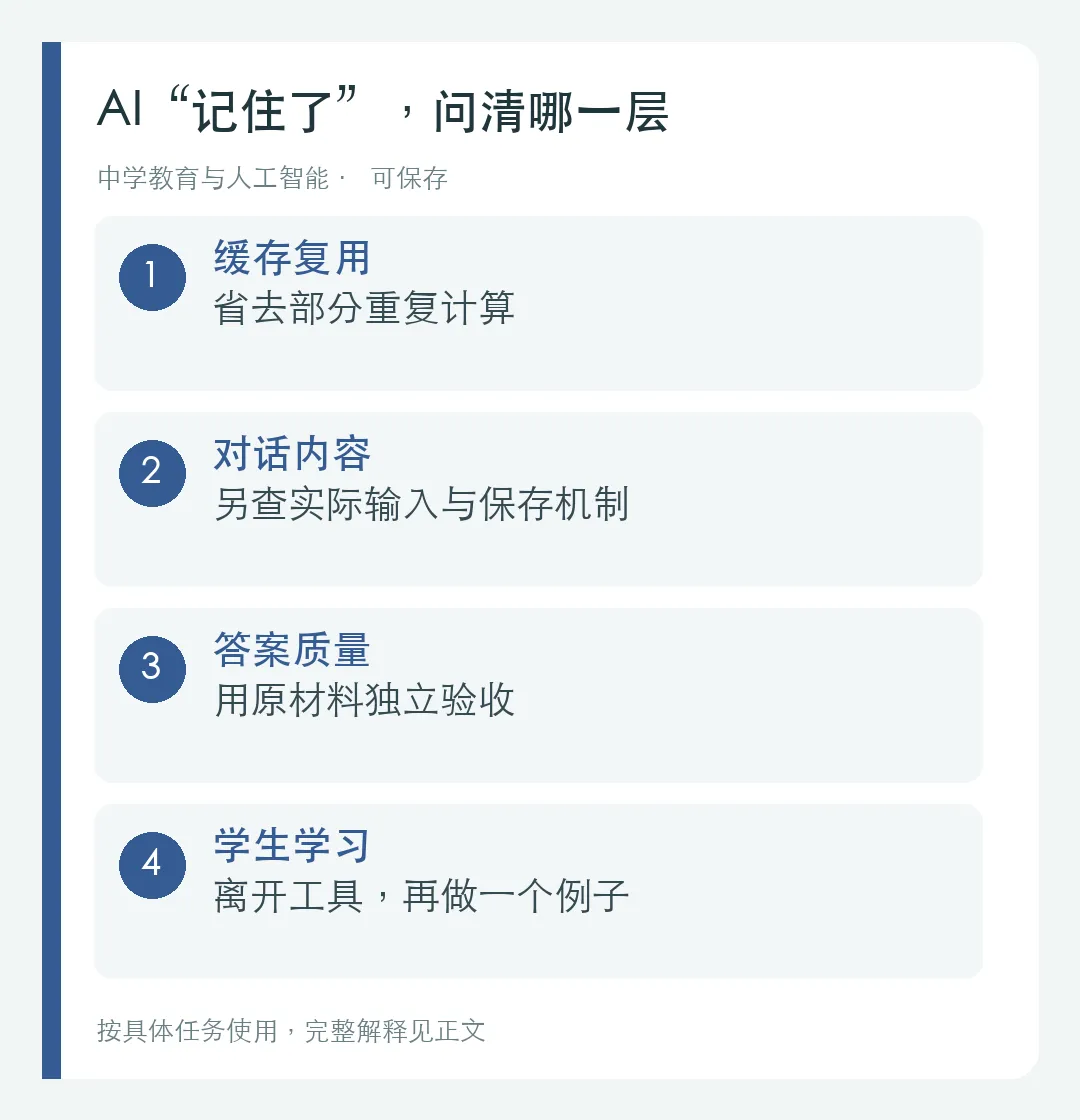
可保存:AI“记住了”,问清哪一层
来源与适用说明
新闻日期2026年9月8日;核验截止2026年9月15日09:45(北京时间)。[1] OpenAI更新日志;[2] 提示缓存指南;[3] 缓存诊断文档;[4] 未满18岁API使用指南;[5] API支持地区。官方功能、作者类比和待验证方案已分别标注,提示词没有实际调用,不把API开放等同于ChatGPT全量可用。
[1] OpenAI API Changelog
[2] Prompt caching
[3] Prompt cache diagnostics
[4] Under-18 guidance
[5] Supported countries and territories
运行指标可以说明工具怎样工作,学习证据仍要看孩子独立做出了什么。
新缓存诊断帮开发者查运行问题,我们选学习工具时还要另外问:用的是什么材料、反馈是否正确、孩子能独立做什么。
跟踪AI新功能,并把运行表现与学习证据分开看。
下一期:同一套AI反馈标准更新后,怎样检查旧结论还适不适用。
AI生成的虚构场景。并非产品截图或教学实测。
介绍学习工具时,你更想追问它记住了什么,还是孩子能独立做什么?