ARTICLE · 1047956
微软OpenAI内部绝密曝光:高管私下承认,我们正在进行人类史上最大规模盗窃!
谁也没想到,AI 巨头们苦心遮掩了两年的底牌,竟然以这种方式被公之于众。
就在这两天,美国纽约南区联邦法院解密了一批重量级法律文件。在《纽约时报》等媒体起诉 OpenAI 与微软的版权大战中,数十页曾经被大面积涂黑的机密备忘录、内部聊天记录和宣誓证词,被法官亲手撕去了遮羞布。
撕去涂黑之后,展现在公众面前的是一场赤裸裸的内部利益博弈与恐慌。
微软自家的应用科学总监布伦特·赫奇特(Brent Hecht)在内部备忘录中直言:将全网人类创作的新闻大规模抓取并喂给 AI,是“前所未有规模的惊人盗窃”,甚至“可能是人类历史上最大规模的劳动盗窃”!
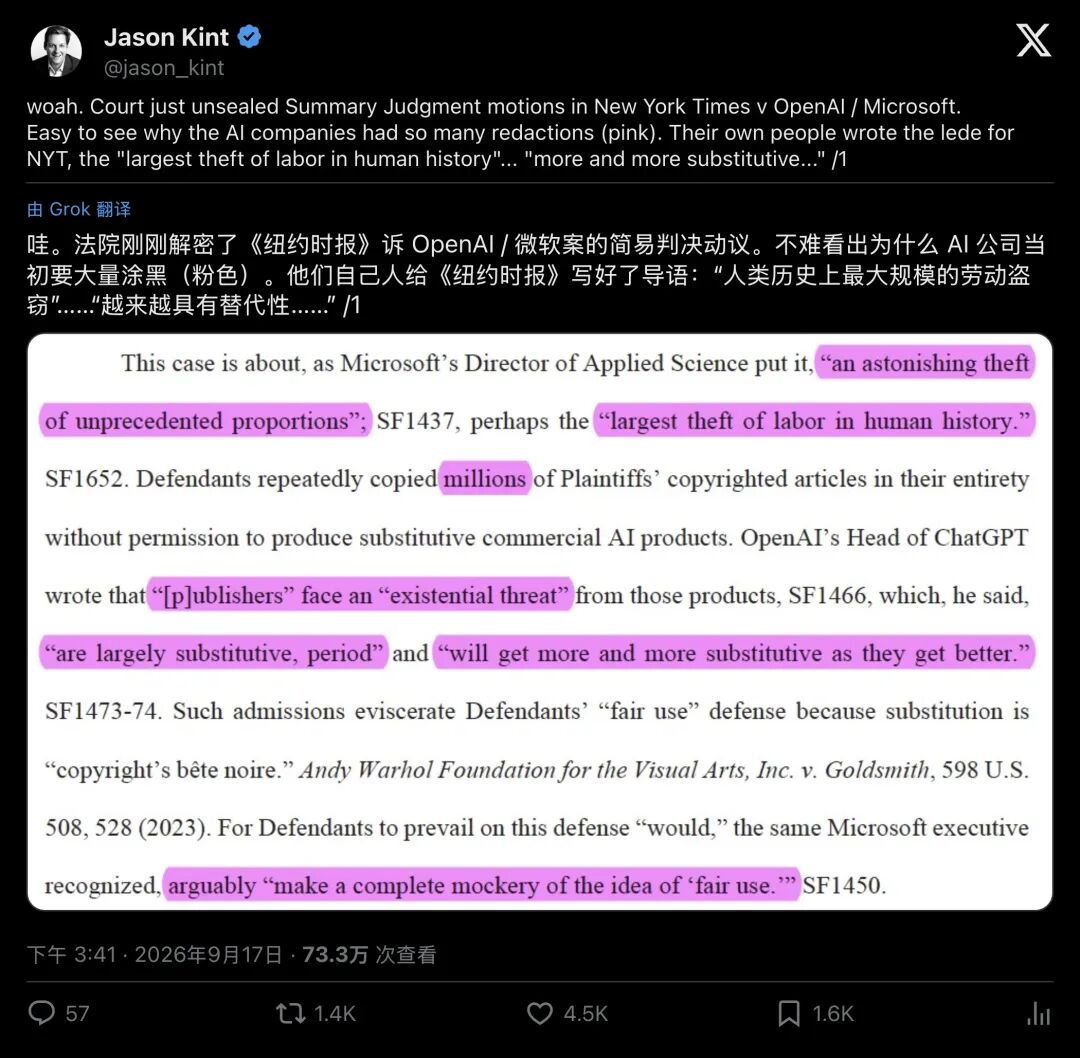
▲ 行业组织负责人 Jason Kint 贴出的解密文件截图,粉色去涂黑区域赫然写着“史上最大规模劳动盗窃”
消息一出,随即震动了整个科技界与传媒界。
原来,那些在发布会上把“科技向善、合理使用”挂在嘴边的科技巨头,关起门来,比谁都清楚自己在做什么。
撕破画皮:白天高喊“合理使用”,夜晚承认“彻底嘲弄”
过去两年里,每当外界质疑大模型侵犯版权,科技巨头们的官方公关口径始终高度一致:
“我们是在合法学习!”“大模型看书就像人类看书一样,这属于版权法保护的‘合理使用’(Fair Use)!”
但这次解密的文件,把这种冠冕堂皇的说法砸得粉碎。
在这批去涂黑的文件中,微软应用科学总监 Brent Hecht 直言不讳地指出:如果法律允许 AI 公司如此肆无忌惮地复制全人类的作品,那么版权法中的“合理使用”原则,将沦为一场“彻底的嘲弄(a complete mockery)”!
他写道:当初创作者敲下键盘时,谁也无法预料心血会被如此掠夺,事后也未曾获得分文补偿。
这番极为严厉的定性,直接出自微软自家核心科学家的白纸黑字。
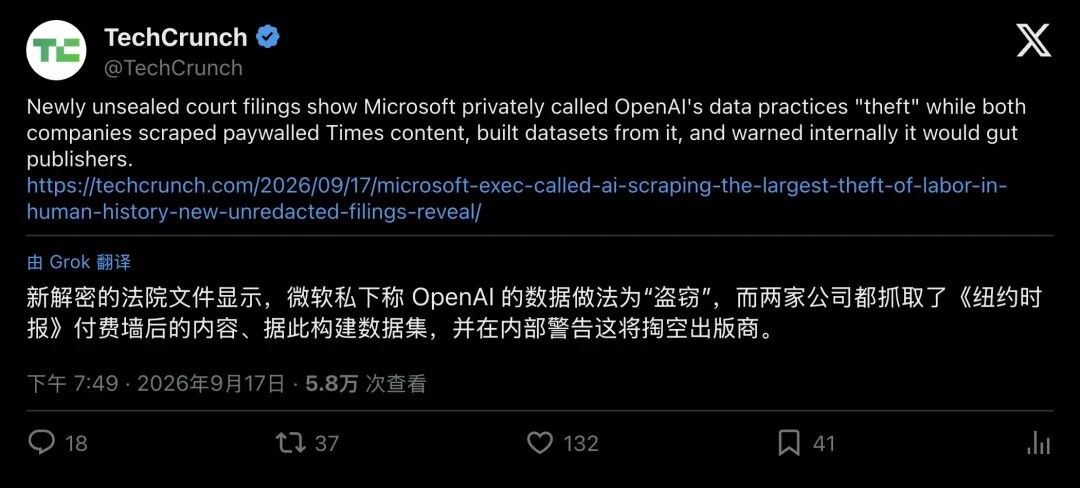
▲ TechCrunch 报道:微软私下将 OpenAI 的数据抓取行为称为“盗窃”
OpenAI 负责 ChatGPT 产品的高管尼克·特利(Nick Turley)同样在内部直言:生成式 AI 对内容出版商而言就是“生存威胁(existential threat)”。
他甚至不留情面地写道:“AI 的本质,基本上就是替代性的,句号(largely substitutive, period)。” 而且随着模型能力越来越强,这种替代只会越来越致命。
台前宣传“我们是创作者的得力助手”,内部却承认其技术路线具有彻底的替代性。
这一记响亮的耳光,直接抽碎了硅谷编织的伦理神话。
一句“Ah nice”引发震动:绕付费墙扒数据,联创内部叫好
如果说高管的道德拷问还算理论探讨,那么数据获取过程中的手段,则彻底拉低了巨头们的底线。
在许多普通读者的认知里,AI 学习的数据都是“网上公开发布的内容”。但事实上,为了让大模型更聪明,科技巨头盯上了各家顶级媒体的付费墙(Paywall),那些只有付费会员才能阅读的高质量深度报道。
原告提交的证据显示:OpenAI 内部曾有人兴高采烈地向联合创始人兼总裁格雷格·布罗克曼(Greg Brockman)汇报,称他们找到了“绕过《纽约时报》付费墙进行抓取的黑客手段”。
面对这种明晃晃的破坏规则行为,这位手握百亿美金估值巨头的二把手,在聊天框里轻飘飘地回了两个单词:
“ah nice”(啊,不错)
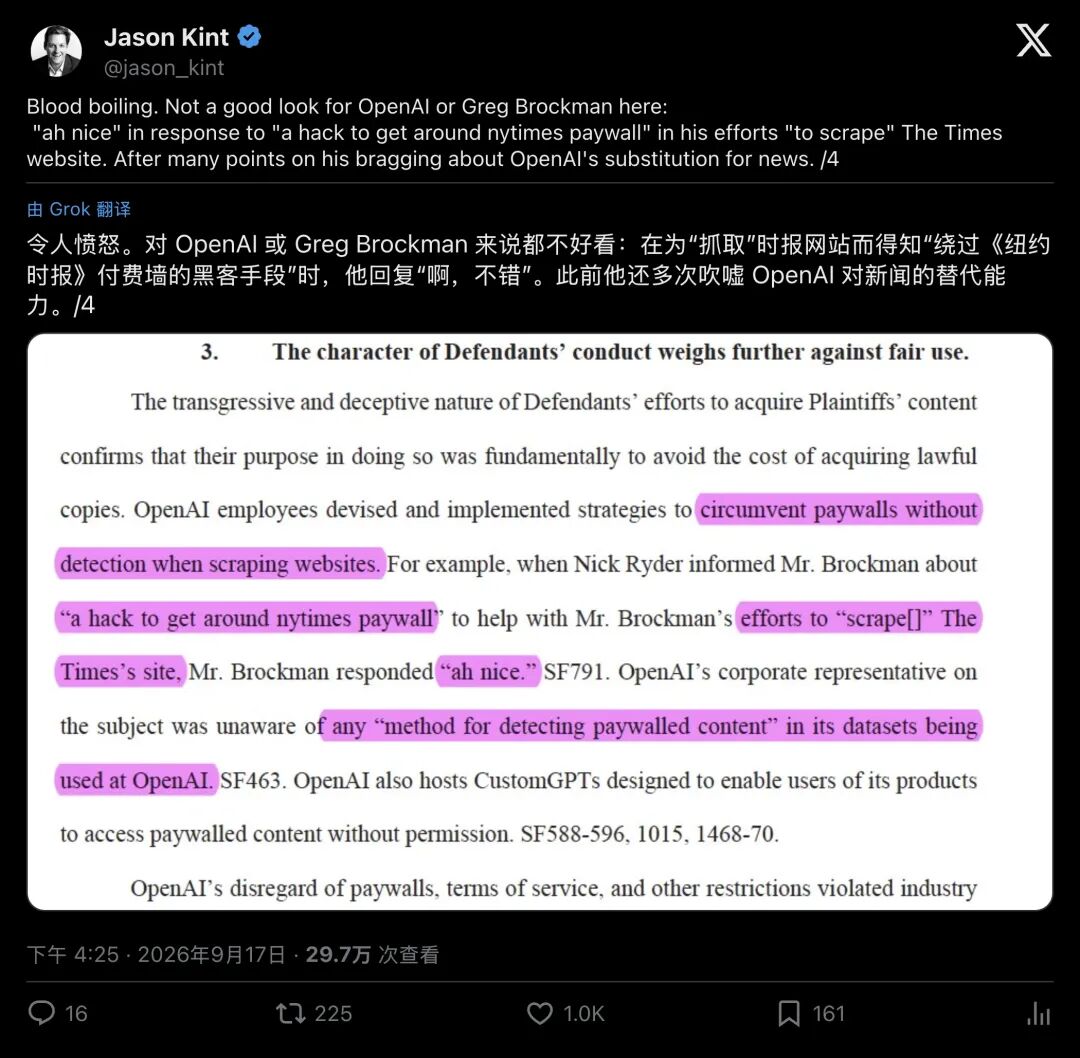
▲ 文件显示,当得知有黑客手段绕过付费墙抓取内容时,OpenAI 总裁 Brockman 回复“ah nice”
原告统计数据显示,微软与 OpenAI 之间存在极其庞大的数据交换网络:微软通过内部代号为“Project Taxi”和“Project Mango”的项目,直接把 Bing 搜索引擎的内部索引语料打包输送给 OpenAI。仅在其中一个数据集中,就包含了超过 16 万份 原告媒体的独特作品副本;而从开源爬虫衍生出的语料里,涉及 nytimes.com 域名的文档高达 200 万篇!
不仅如此,为了防止被抓现行,开发人员在清洗数据时,还会有意识地剥离掉原文自带的版权声明与作者信息,理由竟然是“不想让模型在回答用户时把版权声明也吐出来”。
当被问及此事时,微软 CEO 萨提亚·纳德拉(Satya Nadella)在宣誓证词中迅速开启了“甩锅模式”:他表示,如果要用付费墙内容训练模型,按理必须获得授权;如果他当时知情,会行使合同权利要求 OpenAI 销毁数据并重新训练模型。
而微软官方发言人面对媒体时更是光速切割:这只是“个别员工的个人视角”,不代表公司法律立场。
但网友们并不买账社交平台上有评论一针见血:“如果他们真觉得自己光明磊落,当初为什么要把这些段落涂得漆黑一片?”
▲ 网友惊叹:这些人明知可能会被曝光,竟然还敢把这些话白纸黑字写进备忘录
杀鸡取卵的“末日循环”:AI 正在吃掉自己的食物供应链
在这份解密档案中,微软内部详尽论述了所谓 “末日循环(Doom Loop)” 的系统性危机。
微软的一份内部报告用极其冰冷、残酷的商业语言,剖析了自己亲手制造的怪物:
“终端产品威胁到了其关键供应商的经济基础。这种情况在商业史上极为罕见,但这正是我们在大语言模型业务的内容供应链上造成的局面。”
文件直指本质:大语言模型,是一个正在摧毁自身供应链的产品。
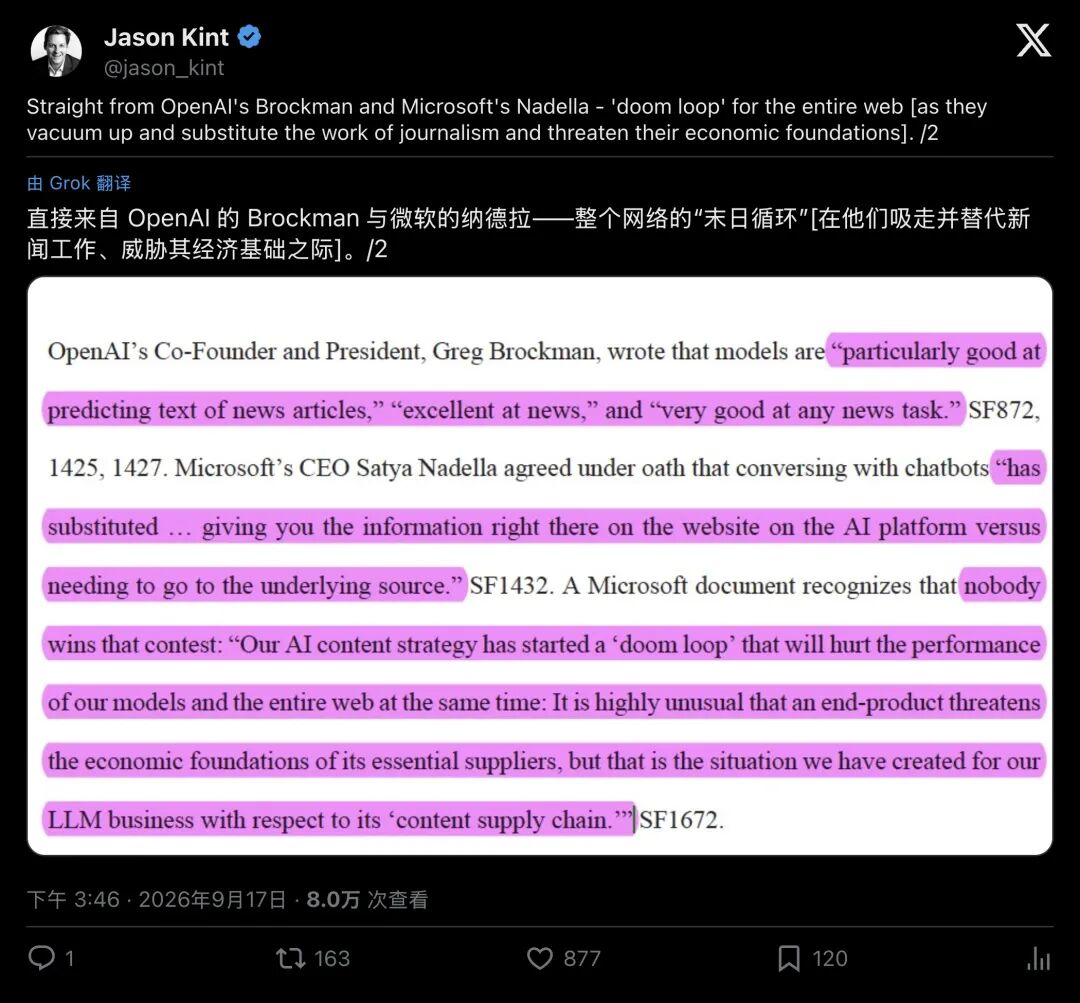
▲ 文件清晰指出:AI 正在形成“末日循环”,威胁整个互联网的经济基石
为了让高中生读者也能一秒看懂,我们可以把这个逻辑拆解为一个极其通俗的闭环:
- 第一步(吸血):
AI 巨头把人类记者、作家、学者辛苦调查写出的高质量文章,免费扒进模型。 - 第二步(截流):
用户在 Bing Copilot 或 ChatGPT 提问,AI 直接把总结好的答案吐在屏幕上。 - 第三步(断粮):
用户看完了答案,根本不会再去点击原始新闻网站。 - 第四步(断流):
新闻机构失去点击量,广告和订阅收入受挫,内容再生产难以为继。 - 第五步(反噬):
互联网上再也没有人类生产真实、严谨的新鲜知识。AI 失去投喂来源,只能被迫吞食网上泛滥的“AI 生成垃圾”,导致模型近亲繁殖、智力退化。
这一切已是正在发生的残酷现实
微软自家的监控数据显示:相比于传统的 Bing 网页搜索,集成了 AI 答案引擎的 Copilot 导致《纽约时报》等新闻站点的点击率暴跌了 87% 到 93%!
近乎九成的流量,在一夜之间凭空蒸发。
OpenAI 的工程师在内部无奈地承认:“不管我们把原文链接放得多显眼,用户根本就不会去点。”
科技巨头们筑起了一座金碧辉煌的数字巴别塔,但地基,却是靠拆毁人类知识生产者的房屋换来的。
囚徒困境:一边是百万美元的施舍,一边是鱼死网破的死磕
面对 AI 带来的灭顶之灾,全世界的内容创作者分化成了两个极端阵营。
一部分人选择了妥协和拿钱退场比如美联社、德国媒体巨头 Axel Springer 等,先后与 OpenAI 签下了授权协议。OpenAI 每年向他们支付几百万美元的授权费,换取合法调用新闻库的权利。但在动辄万亿市值的科技巨头面前,几百万美元无异于九牛一毛的“封口费”。
而以《纽约时报》为代表的硬骨头,则选择了死磕到底。他们封锁了 OpenAI 的一切抓取爬虫,并直接把微软和 OpenAI 送上了被告席。
为什么非打不可?因为对于整个知识产业来说,这是一场你死我活的生存之战。
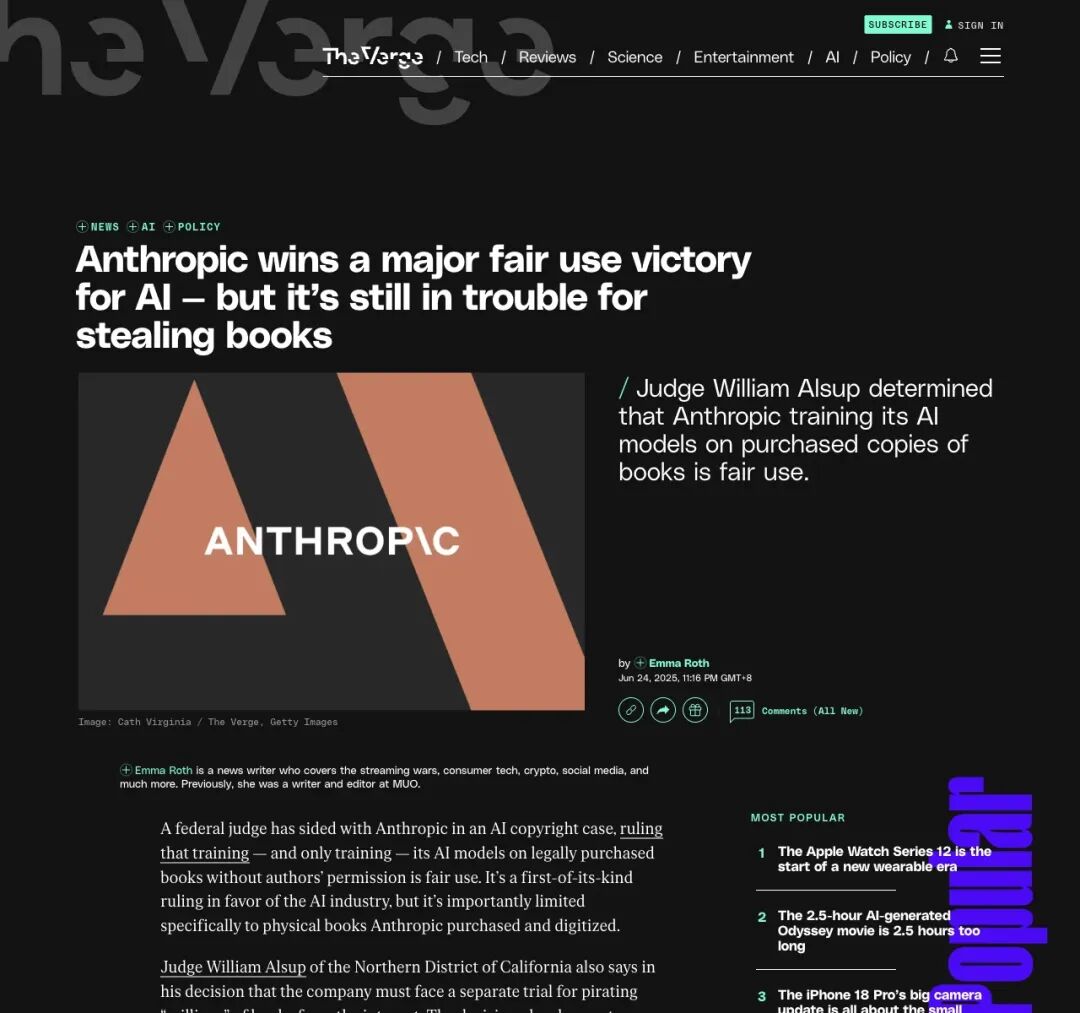
▲ The Verge 报道:加州法院此前裁定 Anthropic 训练购得书籍构成合理使用,成为科技巨头援引的抗辩前例
在此之前,硅谷一直试图用加州法院判决的 Anthropic 和 Meta 案件作为挡箭牌,声称“AI 训练属于合理使用”。但那些案件之所以科技公司占了上风,是因为原告作家们没能拿出确凿的“市场替代和实际经济损害”证据。
而这一次,《纽约时报》有备而来他们不仅拿出了 AI 能够大段逐字复述受保护文章的技术证据,更凭借解密档案,拿到了微软和 OpenAI 高管们亲口承认“点击率暴跌 90%”、“产品具有彻底替代性”的内部铁证!
正如新闻方代理律师史蒂文·利伯曼(Steven Lieberman)在解密后所说:“他们从第一天起就知道自己做的是错的。如今,猫终于从袋子里彻底跑出来了”
当水井被抽干,淘金者去喝什么?
回顾整场解密风暴,最讽刺的地方莫过于此:
在这个由顶尖算法和万卡算力堆砌的辉煌时代,科技巨头的高管们在战略图谱上写满了全人类的未来,但他们内心深处最真实的焦虑,却是一个连中学生都能看懂的常识,不给种麦子的人留活路,磨坊主最后也只能饿死。
在巨大的商业利益和资本竞赛面前,科技巨头们陷入了典型的“囚徒困境”:谁停下来买单,谁就会在算力军备竞赛中落后;于是所有人都在拼命加速抽水,假装看不见水位线正在见底。
这次法庭文件的解密掀开了数字文明规则重塑的序幕,其深远影响已超越单场诉讼的胜负。
AI 确实是工业革命级的工具,但它绝不能成为掠夺人类智力劳动的特权通行证。
如果把原创作者当作可以无限榨取的免费矿产,一旦原创内容生态逐步萎缩、全网充斥着 AI 洗稿生成的同质化数据垃圾,
那些不可一世的大模型,又该去哪里寻找自己的下一顿美餐呢?