ARTICLE · 1047946
离开OpenAI两年!ChatGPT核心功臣掀桌:我们全被大模型带偏了,这一刀砍死所有废话
想象一个极其荒谬的场景:
你在写一个电商退款程序用户发来一句“鞋子码数小了,想换一双”,你的程序只需要知道一个极度纯粹的结果:去换货队列,还是退款队列?
在过去的整整四年里,整个硅谷给出的标准答案堪称“高射炮打蚊子”,
你必须把这句话打包发给一个拥有上千亿参数的庞大语言模型。这个被人类训练得极具礼貌的“赛博哲学家”,在机房里疯狂烧电,一个词一个词地往外吐字:“亲爱的用户您好,非常理解您的心情……”,最后慢吞吞地输出一段复杂的 JSON 代码。
只要它在末尾多打了一个空格、漏掉了一个引号,或者自作聪明造了一个新词,你的后台服务器就会当场崩溃。
“这简直是疯了”
曾一手参与 ChatGPT 指令跟随与强化学习(RLHF)训练的 OpenAI 核心人物 Diogo Almeida,在隐身研发两年后,选择直接掀翻这张桌子。
他和团队正式发布了一款名为 Jev 的全新模型。它不会写诗,不会讲笑话,甚至在底层架构上被彻底剥夺了“说一句完整人类语言”的能力。
但整个开发者圈子彻底沸腾了
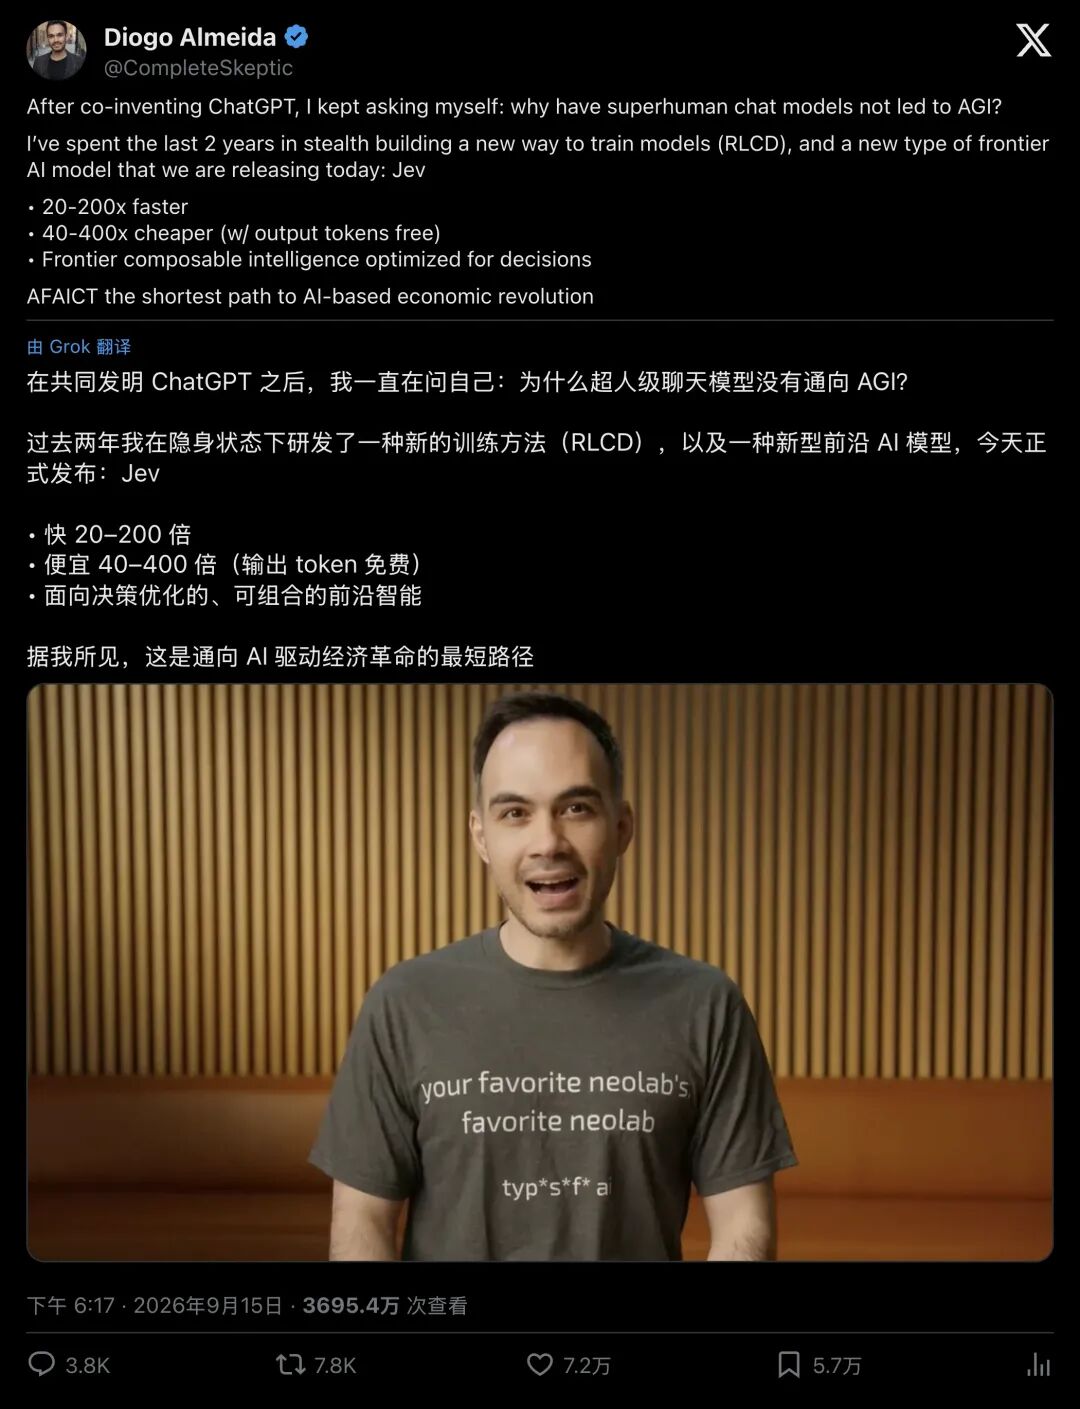
▲ TypeSafe AI 创始人 Diogo Almeida 发布 Jev:把智能从“人类爱听的废话”里解放出来
软件工业的大错位:我们需要条件反射,却请来了一个哲学家
大语言模型(LLM)的聊天能力早就超越了普通人类,但在实际软件工程落地中,自动化的推进却慢得像蜗牛。
这一迟滞的根源在于产品形态与工程需求之间发生了根本错位,单纯把模型做聪明无法消弭这种断层。
诺贝尔奖得主丹尼尔·卡尼曼在《思考,快与慢》中提出过著名的理论:人类大脑有两套决策系统。系统二(System Two)缓慢、深思熟虑、负责逻辑推理和长文组织;而系统一(System One)则是本能、快速、面向瞬间的直觉判断。
过去几年,所有大厂都在拼命卷“系统二”。它们把模型越做越大,让它学会引经据典、学会长篇大论。
但在现代软件的血管里,日夜奔流的代码根本不需要一段充满温度的散文。程序需要一个冷酷、精准、能直接驱动逻辑分支的“开关”。
▲ 官方发布博客:定义全新的 System One 架构,直面自动化落地的痛点
当一个客服工单进来,程序只需要三个答案:
- 这是退款、投诉还是技术咨询?
(单选题) - 用户的愤怒程度打几分?
(打分题) - 他有没有提出法律诉讼威胁?
(是非题)
如果你用聊天模型来做,你必须承受秒级的延迟、昂贵的 Token 账单,以及提心吊胆的解析失败重试。
Jev 的出现,就是把“判断”从“写字”的泥潭里硬生生抽离了出来。它被定义为世界上首个商业级 System One 决策模型。
废掉“嘴巴”的AI:速度暴涨200倍,输出永久免费
Jev 是怎么做到这一点的?它的逻辑极其暴烈:彻底切除模型的自由生成词表。
在传统大模型里,生成一段文字是“串行”的,吐出第一个字,再根据第一个字算第二个字,像老牛拉破车。
而在 Jev 的世界里,接口契约被焊死在三套最基础的“决策原语”上:
- Choice(单选)
:从你给定的选项列表(最多255个)里选一个,返回概率分布与置信度; - Score(打分)
:把状态映射到你定义的有序梯度上(比如1到10分); - Noul(真伪)
:对一个具体命题直接计算“为真”的概率(0到1之间的绝对值)。
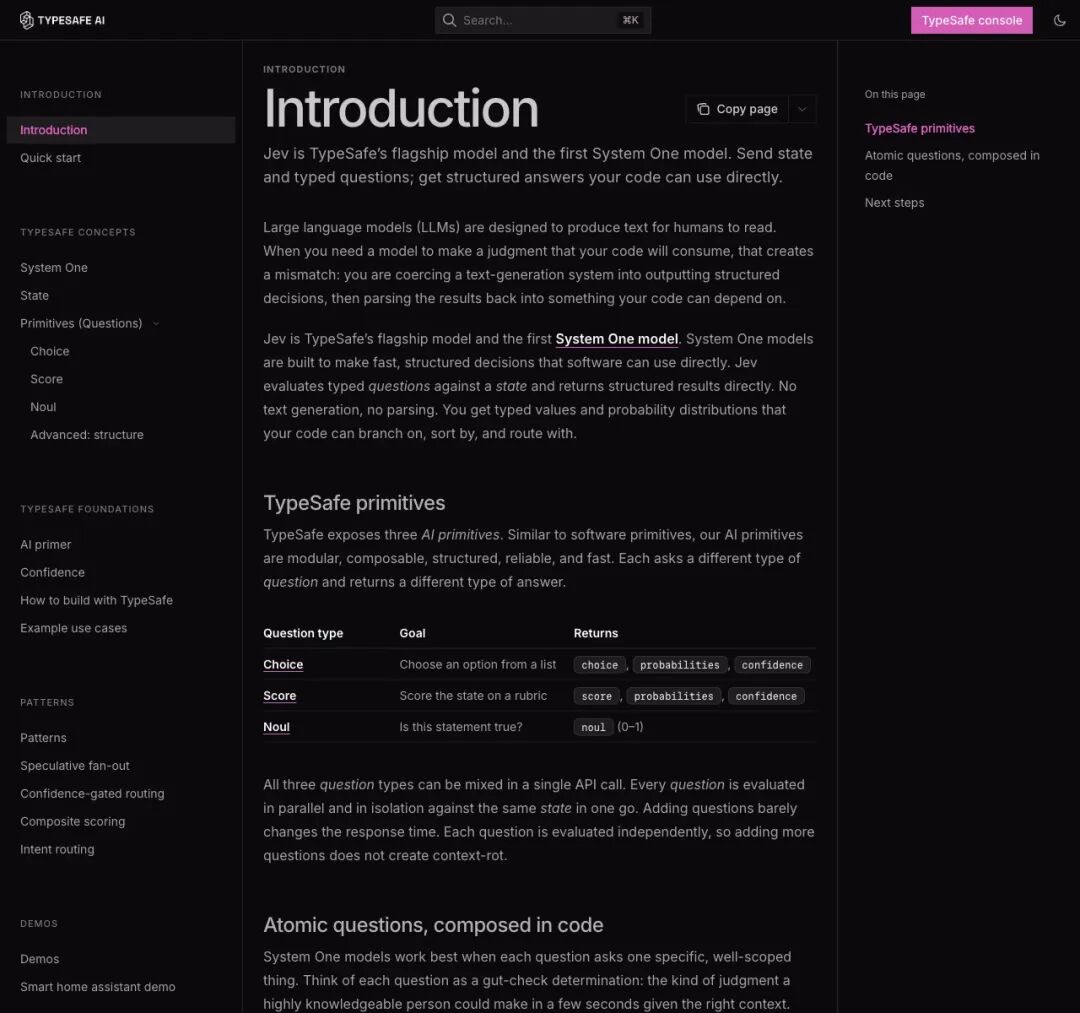
▲ 官方文档明确了三种核心决策原语:Choice、Score 与 Noul
你把上下文(State)扔给 Jev,它只做一次特征编码,随后多个决策头并行打分。
整个流程省去了逐字解码与词表随机采样,计算耗时被大幅压缩。
带来的技术收益堪称降维打击:
- 端到端延迟压到 70~500 毫秒
; - 相比传统大模型,速度最高快了近 200 倍,调用成本最高降低 400 倍
; - 输入每 100 万 Token 仅需 0.042 美元,而输出,永久免费!
为什么输出能免费?因为模型根本不用去算成百上千个文本 Token。它只输出几个浮点数和枚举索引,算力消耗低到厂商甚至懒得为它设计计费逻辑。
Vercel 首席技术官 Malte Ubl 拿它跑自家的分类审查评测,对比谷歌的 Gemini 2.5 Flash Lite,不仅评测准确率直接打满,速度更是当场狂飙了 6 倍。
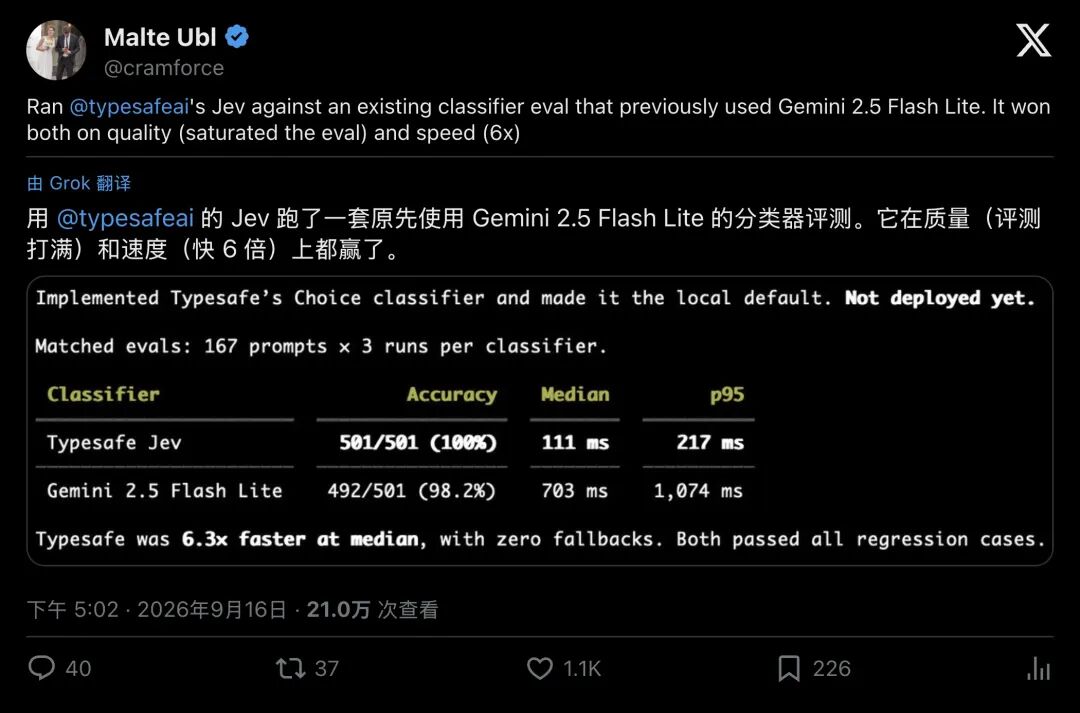
▲ Vercel CTO Malte Ubl 实测:分类任务速度提升6倍,质量直接打满
狂欢背后的冷水:“类型安全”绝不等于“真理安全”
发布不到48小时,一波极度危险的营销口号在技术社区疯传:“Jev 不可能产生幻觉!”
甚至有人发推宣称:“既然它零幻觉,那它立刻可以在医疗、司法等出人命的领域大展身手!”
这盆滚烫的迷魂汤,很快被清醒的工程师们兜头泼了一盆冷水。
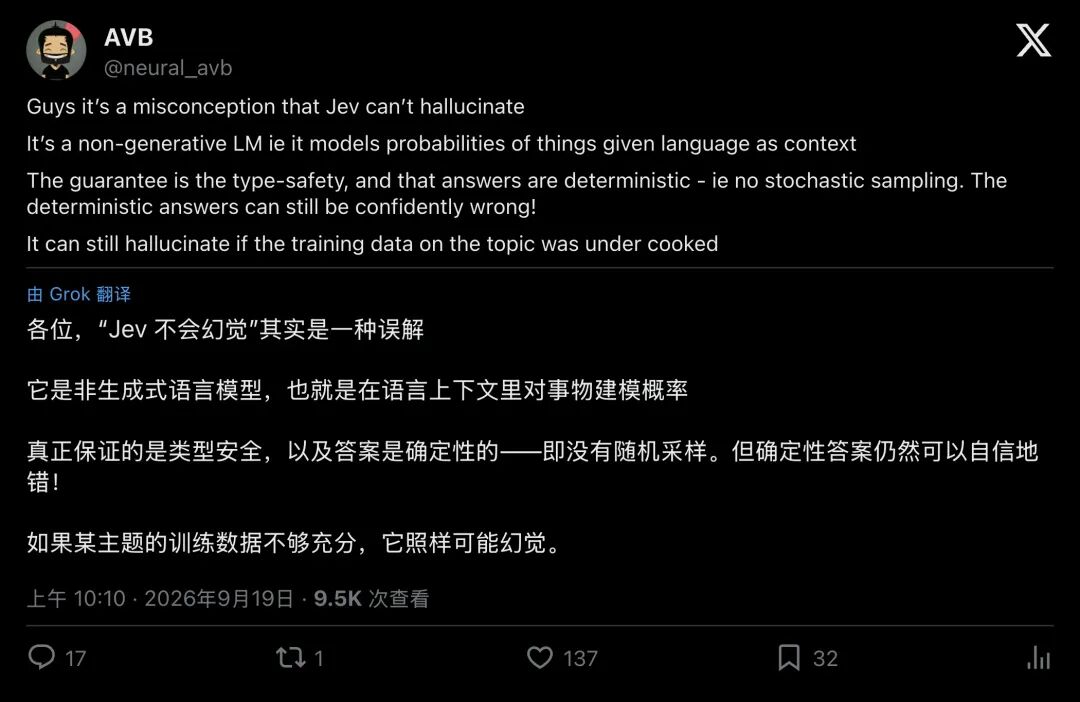
▲ 工程师社区迅速反驳:必须分清“格式不报错”与“逻辑判断正确”的区别
机器学习研究者 AVB 一针见血地指出:不能输出非法类型,不代表它的答案是正确的!
什么叫“类型安全”?如果你让 Jev 在 [退款, 咨询, 投诉] 里选一个,它绝对不会发神经吐出一个不在列表里的“外星语”,也不会返回一段格式错乱的代码。在结构上,它永远正确
但这绝不保证事实正确如果模型本身的训练数据不够充分,或者逻辑超出了它的边界,它完全会以 99.9% 的确定性置信度,极其自信地给你选出一个完全错误的答案!
官方文档极其罕见地在发布第一天就主动公开了一份名为 Jaggedness(锋利缺陷边缘) 的避坑指南。
官方在文档里白纸黑字写明:
- 不要让它数数
:问它“strawberry 里有几个字母 r”,它会极其笃定地给出一个错误数字; - 不要让它做复杂日期计算
; - 不要让它处理高度模糊的指代
。
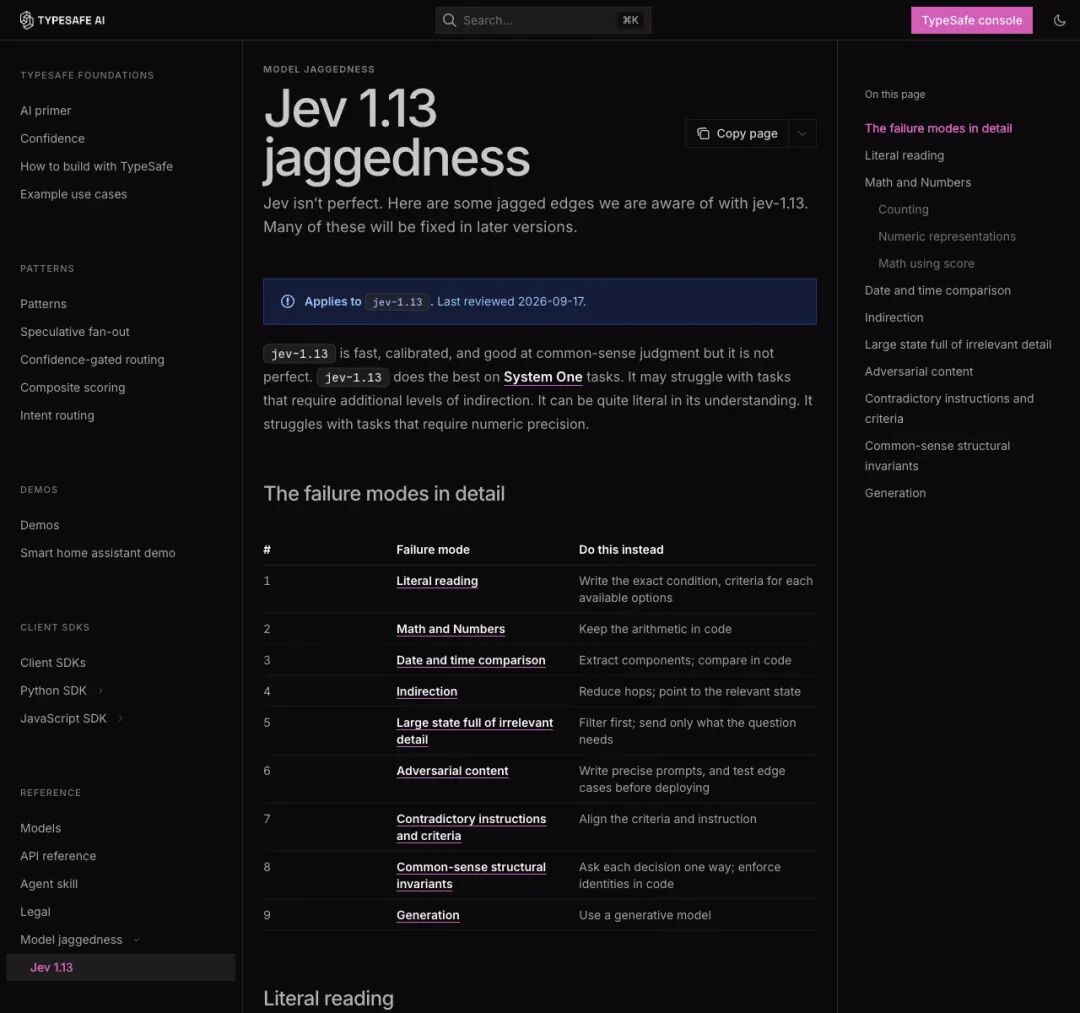
▲ 官方发布的 Jaggedness 文档,主动承认模型的局限与短板
TypeSafe 联合创始人 Sasha Sheng 更是直言不讳:“Jev 现在依然太慢、太贵、太笨。请大家多去挑刺”
把算术和循环交还给代码,把复杂的深度推理留给大型模型,让 Jev 专注在定义清晰的条件反射上,这才是它合理的工程定位。
杰文斯悖论生效:一场属于“神经末梢”的开源裂变
为什么 Jev 会在整个硅谷引发如此深层的震动?
答案隐藏在它的名字里,Jev,致敬的是19世纪著名经济学家威廉·斯坦利·杰文斯。
著名的“杰文斯悖论”指出:当某种资源的利用效率大幅提升、成本断崖式下跌时,人类对它的总消耗量不仅不会减少,反而会迎来报复性的几何级暴增。
当一次智能判断的成本是 2 美分、耗时 3 秒时,工程师只敢在核心主流程上调用一次大模型;但当一次判断只需要 0.000042 美元、耗时 0.1 秒时,整个软件工程的底层结构被彻底重构了。
智能由此化作千千万万个敏捷的神经末梢,直接嵌入每一个循环、每一个前置拦截网和每一个界面的点击事件中。
在 LangChain 最新的架构中,Jev 被直接充当 Agent 循环里的“方向盘”与“护栏”,负责在毫秒间决定要不要调工具、要不要终止循环,而根本不用每次都把前沿大模型唤醒一遍。
开源社区的动作更快得惊人不到一周时间,不仅有人用开源小模型 Gemma 搓出了单步前向的开源 System One 架构,更有团队推出了参数量仅 70.6 万、体积仅 2.8MB 的微型端侧决策模型,专门在电脑桌面上毫秒级判定“表单到底该点哪里”。
软件史上的又一次“降维胜利”
在社区的讨论帖中,一位开发者写道:
“当你的程序直接宣布‘我决定了’,取代模棱两可的‘我觉得’,代价究竟是什么?”
回望整部计算机软件工程史,类似的故事其实已经上演过无数次。
曾经,动态语言的拥趸嘲笑强类型语言死板,自由文本查询鄙视 SQL 语法的严苛。但历史一次又一次证明:只有放弃一部分无序的自由,才能换来软件工程规模化协作的确定性。
大语言模型让机器学会了像人类那样组织自然语言;而以 Jev 为代表的 System One 模型,则补齐了工业落地所需的核心拼图:在需要扣动扳机的瞬间,利落地切下开关。