ARTICLE · 1047957
清华满分神作震撼AI圈:大模型根本不会思考!我们全被强化学习骗了
过去这一年,整个科技圈都在为一件事集体狂热:“会慢思考的推理大模型”。
从OpenAI的o1,到横空出世的DeepSeek-R1,所有人都在惊叹:AI终于拥有了“顿悟”时刻!它会自我反思、会纠错、会推翻重来。
在各大科技团队的预期中,这被描绘成AlphaGo时刻的重演,只要给AI设定好奖励规则,利用“可验证奖励强化学习”(RLVR),模型就能像当年自我对弈的AlphaGo一样,在纯粹的试错中无师自通,自行进化出人类教科书上从未存在过的高级逻辑与推理能力。
无数创业公司和投资人开始疯狂“All in RL”。
然而,一篇斩获 NeurIPS 2025 最佳论文亚军(并在评审中砍下罕见满分)的研究,像一盆冰水,直接把整个AI界浇了个透心凉。
这篇来自清华大学自动化系团队(LeapLab)与上海交通大学合作者的重磅论文,用极其严密而残酷的实验,撕开了这层华丽的皇帝新衣:
大模型根本没有通过强化学习学会新的推理。所谓的“思考跃升”,不过是一场被精心包装的概率压缩游戏。
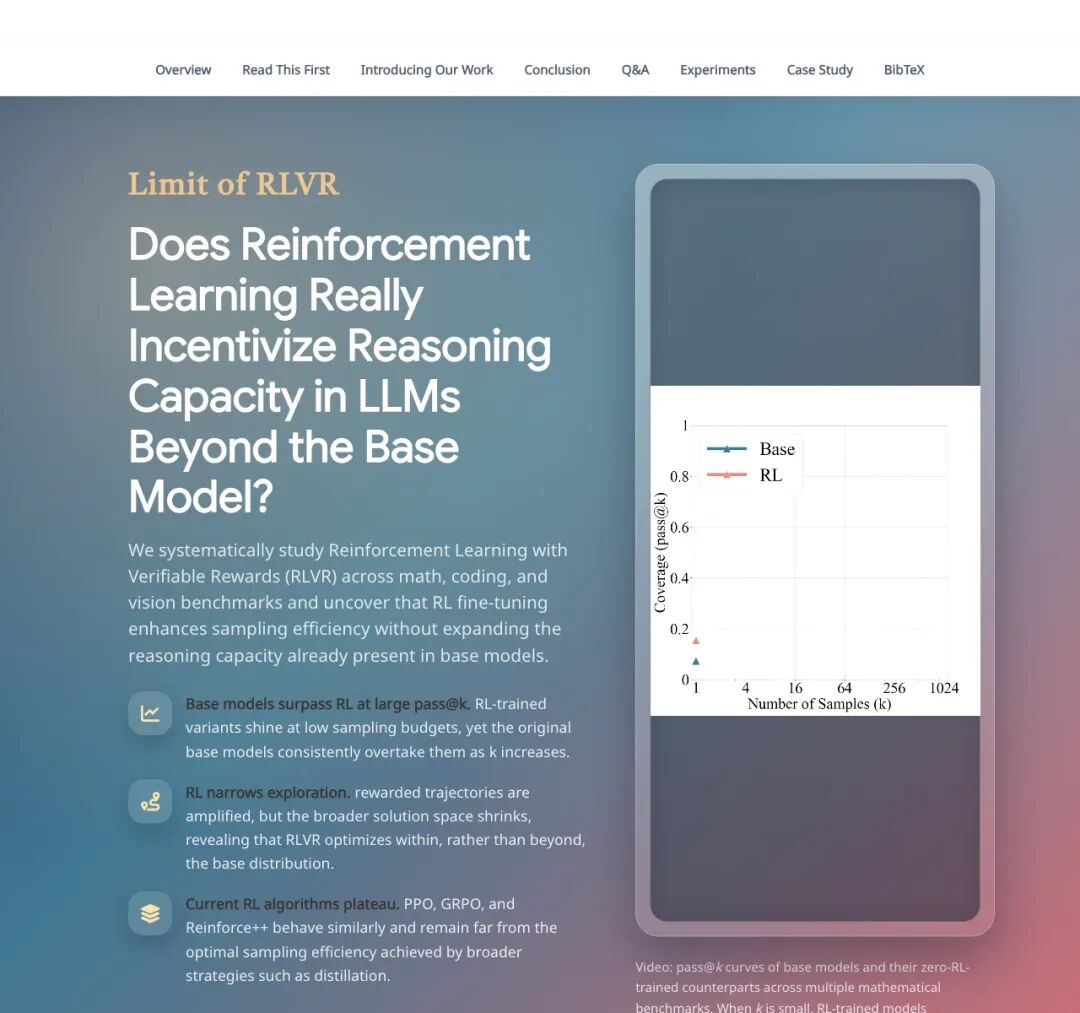
▲ 清华团队项目主页《Limit of RLVR》,直指当前强化学习的认知边界
致命测试:当把考试机会给到第256次
为了验证大模型到底有没有“进化”,清华团队做了一件极其本质、却长期被大众评测忽略的事情。
平常我们测试AI,比的是 pass@1,给AI一道数学题或代码题,让它答一次,答对就算赢。这就像让学生直接上考场,看单科卷面分。
在这个指标下,强化学习(RL)训练后的模型简直是降维打击,成绩一路飙升。
但清华团队换了一把尺子:pass@k。
什么意思?同一道难题,我给你 $k$ 次独立作答的机会(比如256次)。只要这256次里有一次蒙对或者推导对,就算这道题你能解。
这把尺子量的是什么?是模型的“能力上限与潜能边界”它在刺探模型的概率分布深处,到底还藏不藏得住通往正确答案的路径。
接下来,反直觉的恐怖一幕发生了
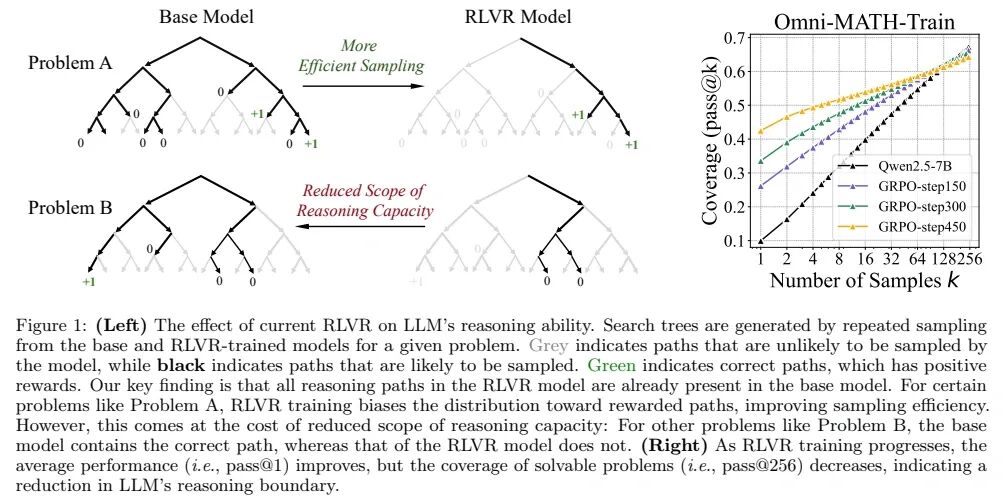
▲ 论文核心图Figure 1:左侧搜索树展示RL并没有长出新分支;右侧曲线显示,随着训练进行,pass@1上升,但pass@256断崖式下跌
看懂这张图,你就看懂了当前AI的全部真相:
- 当 $k=1$(只答一次)时
:强化学习后的模型确实遥遥领先; - 当 $k$ 增大到几十、上百乃至256时
:未经任何强化学习的“毛坯”基座模型(Base Model),一路狂追,最终在 pass@256 上全面反超强化学习模型!
这揭示了一个残酷的现实:
如果在基座模型里,AI做256次哪怕一次都解不出的题;那么经过千锤百炼的强化学习之后,AI依然一次都解不出。
“只有RL能解、基座彻底解不出”的题目比例,在实验中无限趋近于零。
研究还发现了另一重代价:那些原本基座模型在第100次、第200次能灵光一现解出来的偏门解法,经过强化学习的反复“调教”后,彻底被丢弃、被遗忘了。
它的卷面分变高了,但它的世界却变狭窄了。
顶级做题家:从“狂想艺术家”到“死记硬背考生”
为了让所有人都能理解这个现象,我们可以打一个生动的比方。
未经过RL训练的基座模型,就像一个天马行空但神经兮兮的狂想艺术家。
你问他一个复杂的几何难题他第一次回答可能在胡说八道;第二次回答可能在写散文;但如果你让他狂猜256次,在他浩瀚无垠的灵感库里,第187次他很可能突然灵光一闪,写出一段惊为天人的精妙证明。
而强化学习(RLVR)在做的事情是什么?
这项技术本质上是在旁边架设严格的奖惩机制:答对一次就给糖吃,答错就扣分惩罚,促使它反复巩固已知的高分路径。
很快,艺术家被驯化成了应试做题家
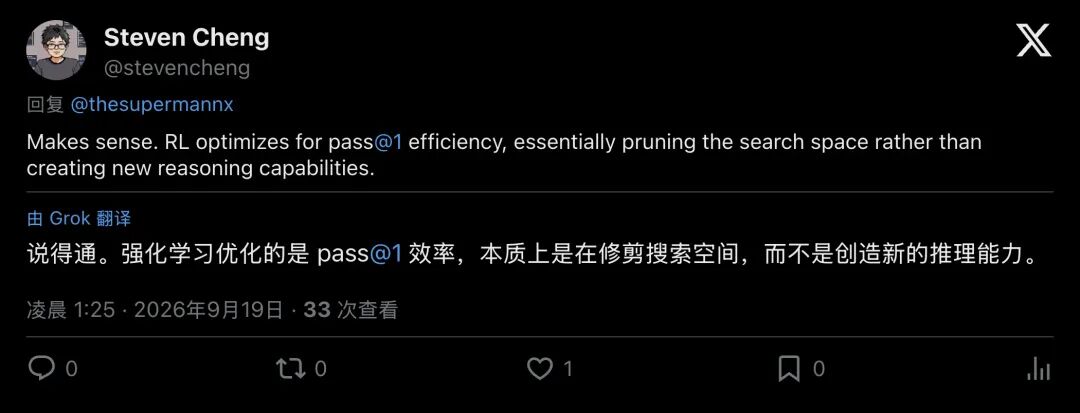
▲ 开发者锐评:强化学习优化的是pass@1效率,本质是在修剪搜索空间,而非创造新推理能力
做题家很快发现,只要死记硬背那几条最稳妥、最平庸的套路,第一遍答对的概率(pass@1)就能提到最高。
代价是什么?
他把所有天马行空的思维触角全给斩断了。 他的搜索空间被极度压缩,熵值骤降他再也不会走偏门偏路,但也永远失去了在现有知识边界之外“偶遇奇迹”的可能。
论文中的困惑度(Perplexity)分析直接证实了这一点:RL模型写出的所有推理轨迹,对基座模型而言一点都不意外。 那些所谓的“思考链条”,早就一字不差地潜伏在基座模型庞大的概率云里。
强化学习的作用是在旧有认知版图上修筑直道,高效收敛至已存在的高概率解法。
硅谷大震荡:一场关乎AGI信仰的论战
当这篇论文被挂上预印本平台并摘下NeurIPS大奖后,整个AI研发圈掀起了激烈讨论。
推特(X)上迅速分化成几个激辩阵营
▲ 知名开发者引用转发:“又多了一个理由:别再死磕强化学习了!”
第一派:实用主义者的反驳,“能做对一次,不比瞎猫碰死耗子强?”
有人立刻提出了犀利的反问:
“一个外科医生做手术,第一次就能保证95%成功;一个普通人乱切一气,试256次碰巧有一次切对了。难道你能说普通人比外科医生更有医学能力?”
这个反驳在工程落地和商业产品上极其有力。用户用ChatGPT,需要的是点一下就出正确答案,没人有算力也没人有耐心让你连摇256次骰子。把 $pass@1$ 提上去,就是巨大、实打实的商业价值。
第二派:理论派的冷峻回击,“追求AGI绝非应试刷分”
作者团队与研究者们指出了这篇论文的核心落脚点:
如果你做AI的目的只是为了做一款商用刷题插件、写代码助手,那强化学习完全够用,甚至非常好用。
但如果硅谷讲的故事是,通过RL让AI自我进化,去攻克人类至今未解的数学猜想、寻找可控核聚变的新公式、发明室温超导材料呢?
这篇论文告诉你:不可能
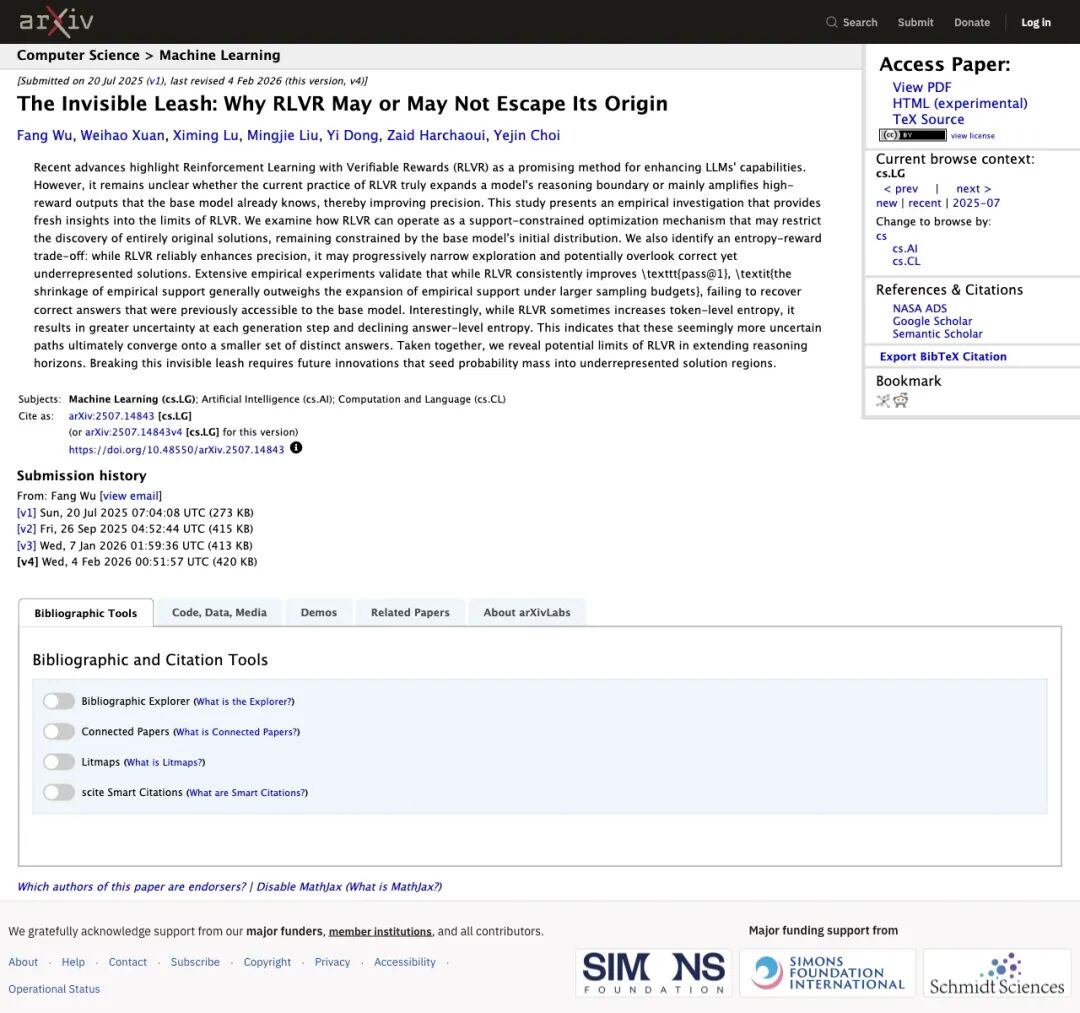
▲ 后续研究《The Invisible Leash》:RLVR无法挣脱基座模型这根“看不见的牵引绳”
因为当前这种基于固定任务、0/1二元结果奖励的强化学习,被一根“看不见的隐形牵引绳”死死拴在基座模型的先验分布上。
如果答案的种子在预训练阶段没有埋进基座里,RL就算空转一万年,由于每一次尝试都得到“0分”,在没有有效梯度的黑暗荒原中,它根本不可能“无中生有”地蹦出全新的解法。
迷雾拨开:模型蒸馏带来的认知突围
难道大模型学不会新逻辑了吗?
清华团队在实验中设置了一组关键对照:模型蒸馏(Distillation)。
当他们让一个较小的基座模型,去模仿并学习更强“教师模型”的思考轨迹时,奇迹出现了:
小模型的能力边界(无论是 pass@1 还是 pass@256)全面向外扩张!
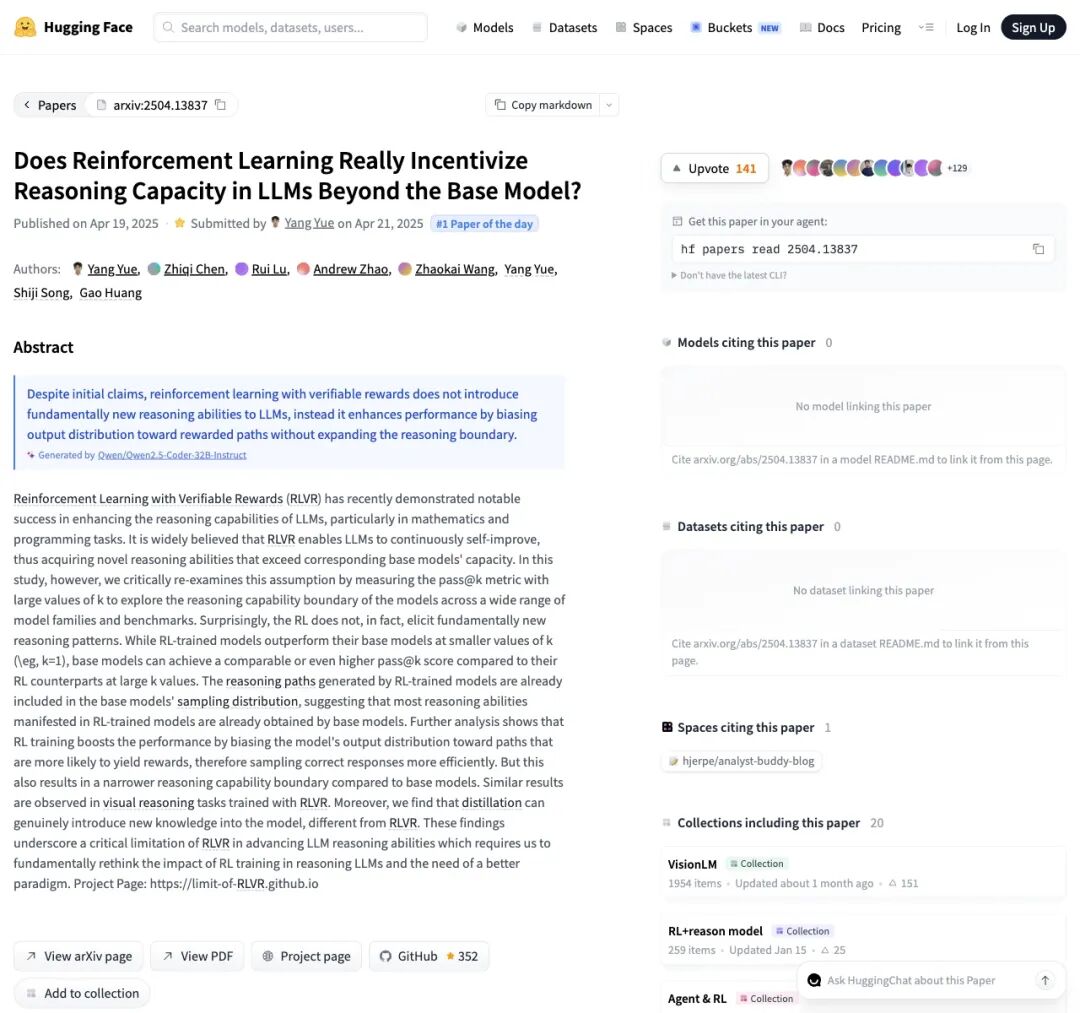
▲ 论文迅速登上 Hugging Face Papers 热榜,引发全球开发者对“后强化学习时代”的探讨
这个对比非常残酷,却直击底层:
- RLVR
:是模型在自己的肚子里翻江倒海,把原本80%不会考、20%能蒙对的陈年旧账,整理成90%能立刻背出来的标准卷面。 - 蒸馏 / 高质量新数据
:能够从外界引入全新的信息与认知结构。
模型架构本身具备容纳新思维的空间,瓶颈在于当前工业界普遍采用的“用简单对错做死板强化”的训练范式。
连苹果机器学习团队此前发布的《思考的幻觉》(The Illusion of Thinking)也遥相呼应地指出:当问题复杂度稍微超过某个临界点,所谓“会思考的推理模型”准确率便会发生悬崖式的崩溃。
模型漫长的“思考过程”,往往只是在更长上下文中反复倒带播放预训练阶段习得的模式片段。
剥离神话:重新确立智能进化的探索路径
论文一作杨越在后续发声中明确指出:这项工作的核心目的在于为狂热的行业划出清晰边界,促使学界探索更有效的演进范式。
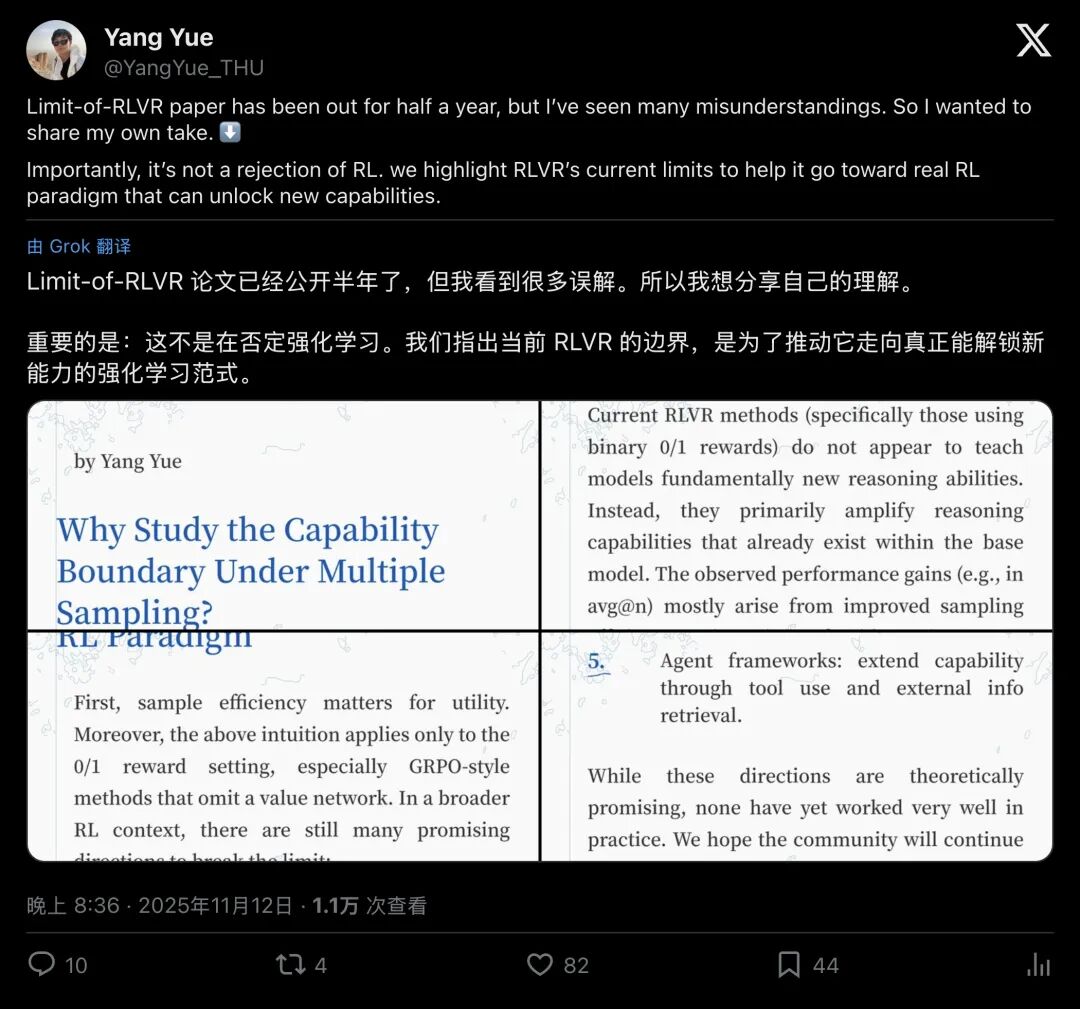
▲ 一作杨越在社交平台发文澄清:指出当前局限旨在推动研究走向能解锁新能力的强化学习范式
如果把AGI的探索比作攀登珠峰:
过去的宣传让人觉得只要把“强化学习”这把梯子架在基座模型上,就能一直往上搭,直到捅破天际。
而清华这篇获得NeurIPS满分赞誉的论文,冷酷地给出了测量结果:这把梯子的长度,从一开始就被基座模型的高度封死了。 它能帮你更快爬到梯子顶端,但无法让山峰再长高一厘米。
当前的强化学习塑造出的是极具效率的“超级做题家”,距离具备自主发现能力的爱因斯坦式智能仍有遥远距离。
打破这根牵引绳的关键,在于跳出“对错二元反馈”的单一路径,转而引入更广阔的探索机制、更细粒度的过程激励,以及具备实质信息增量的预训练与环境交互。
褪去神化光环之后,更为严谨的科学探索才刚刚拉开序幕。