ARTICLE · 1049027
Tautest:AI 生成的测试全绿,为什么一个边界变异仍然活着
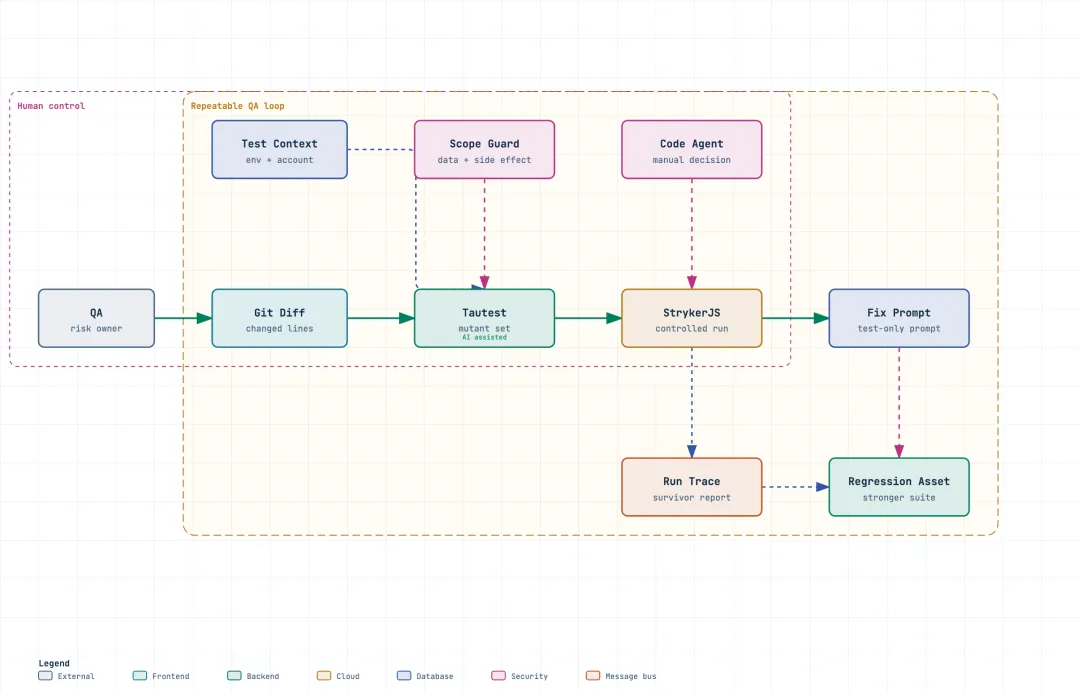
AI 给折扣逻辑补了一组测试,CI 全绿、行覆盖率也不低。但把“年龄大于等于 65”偷偷改成“年龄大于 65”后,测试仍然通过。这说明测试执行过代码,却没有真正保护 65 这个边界。
这篇文章讨论的是一条可执行的 QA 实践方案,不虚构项目实测、节省比例或成功率。重点不是工具有多少功能,而是它能不能进入一个真实测试动作,并留下 QA 可以复核的证据。
先说结论
Tautest 对应的是 服务端测试 / 单元测试质量 / PR 质量门禁。它解决的具体步骤是:只对 PR 改动行运行变异测试,把存活变异整理成确定性的补测试任务,再交给 Codex、Cursor 或其他 coding agent 强化测试。
AI 参与的是候选生成、画面理解或补测试任务整理,最终业务判断仍由 QA 完成。个人验证时先选一个小接口、一条桌面路径或一个 PR,不要一开始建设全量平台。
原来怎么做,为什么总在重复
QA 或测开先看覆盖率,再逐行猜哪些断言只验证了 happy path。 想验证测试强度时,要自己修改条件、返回值或边界,再观察测试是否失败。 发现测试太弱后,还要把代码上下文和缺失行为重新描述给 coding agent。 PR 一大,人工注入错误的范围和恢复成本都会迅速上升。
这些动作的问题不是“手工就落后”,而是每次从头开始,且输入、执行和证据没有形成同一条可复跑链路。
工具介入后,AI 具体做哪一步
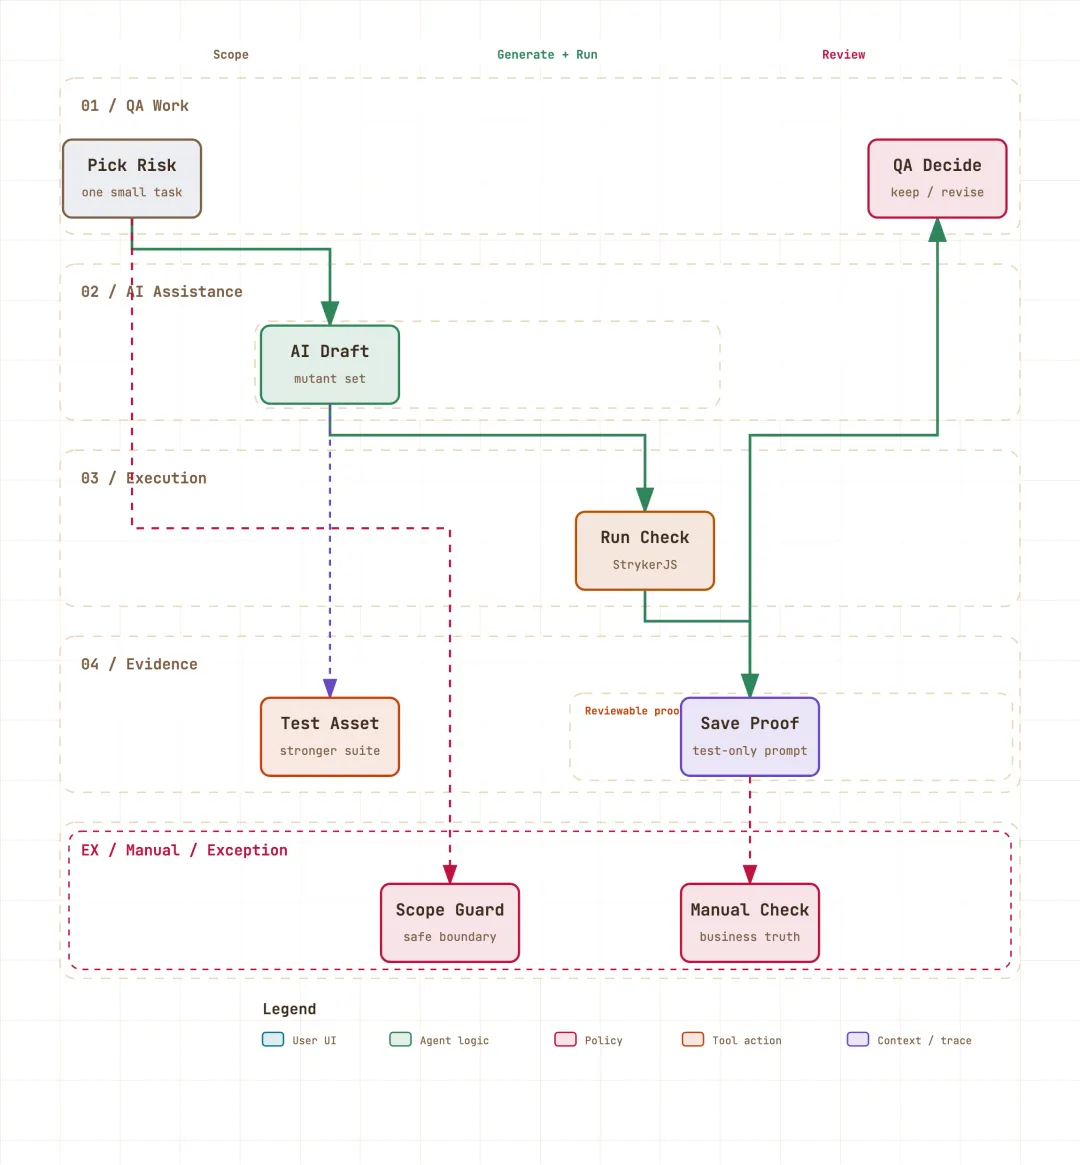
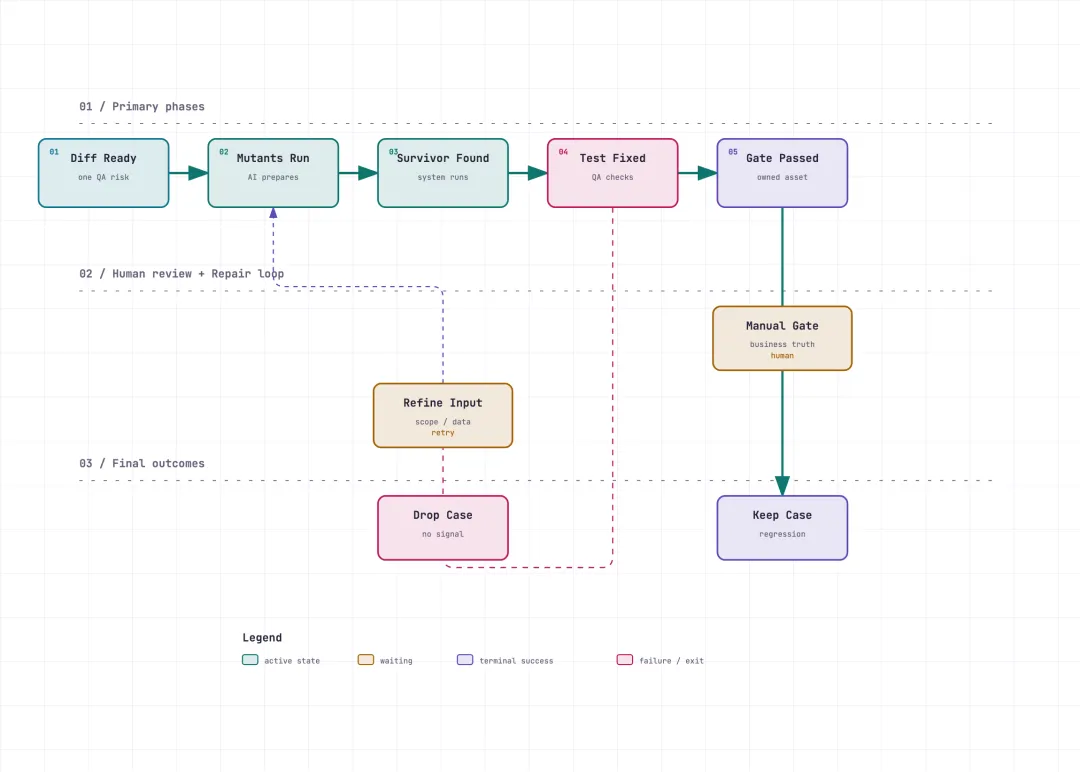
Tautest 从 git diff 提取改动行,并调用 StrykerJS 在这些行上做变异测试。 存活变异被整理为 Markdown、JSON 和面向代码 Agent 的确定性 fix prompt。 Coding agent 根据 prompt 只新增或强化测试,不应修改生产代码来迎合结果。 QA 检查新测试能杀死变异、在原始实现上通过,并重新运行常规测试与 Tautest。
AI 的输出先按候选处理。能否进入回归,要看它有没有清晰输入、可观察执行、确定性证据和人工门禁。
10—30 分钟最小验证路径
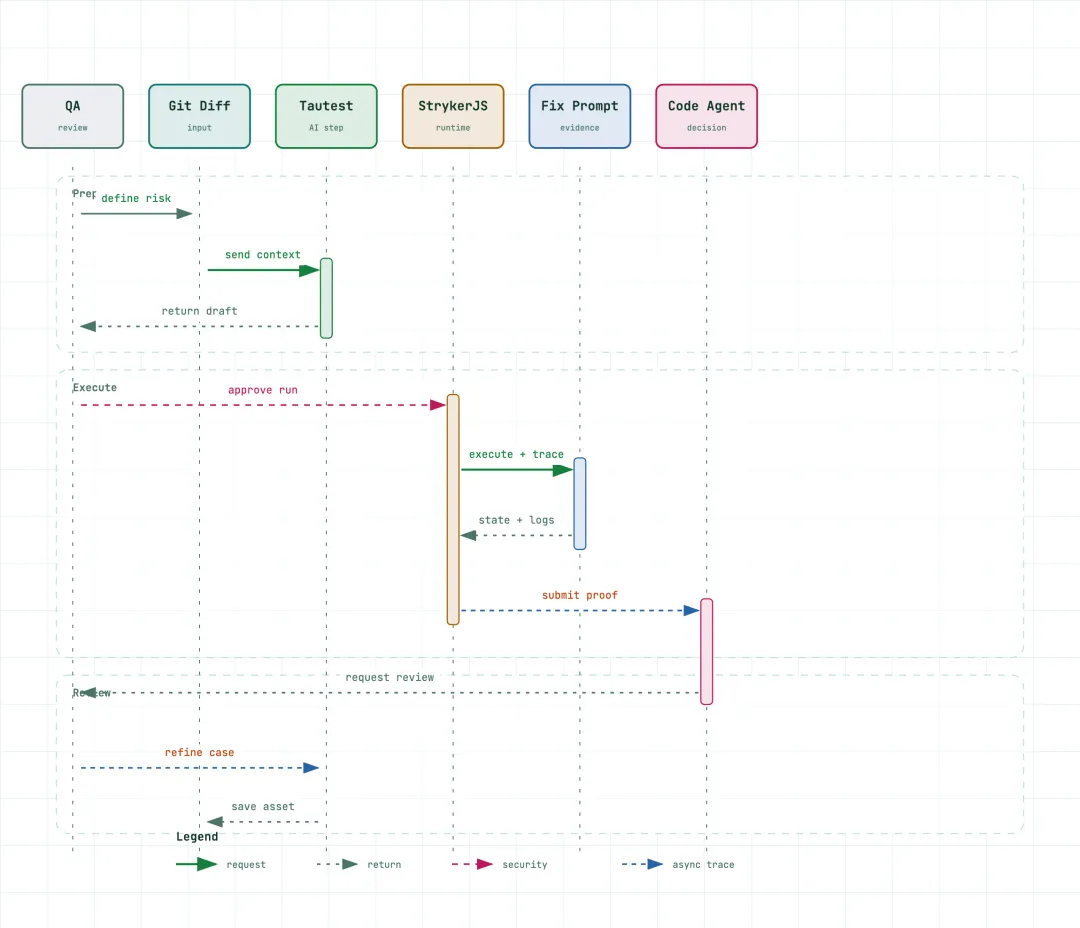
选择一个使用 Vitest 的小型 JavaScript 或 TypeScript 项目,并准备一个包含条件边界的 PR。 安装 Tautest、Stryker core 和 Vitest runner,再执行 init 与 doctor。 运行 tautest run --base origin/main,查看 .tautest/report.md 和存活变异。 生成 codex 风格 prompt,让 coding agent 只补测试,然后复跑原测试和 Tautest。
接入入口:
pnpm add -D tautest @stryker-mutator/core @stryker-mutator/vitest-runnerpnpm exec tautest init --yes --runner vitest --no-installpnpm exec tautest doctorpnpm exec tautest run --base origin/mainpnpm exec tautest prompt --style codex如果环境准备本身超过 30 分钟,就先停在一个可重复的小闭环,不要把平台搭建时间包装成工具验证时间。
具体少做了哪些动作
少把行覆盖率误当成断言有效性的证明。 变异范围聚焦 PR 改动行,不必一开始就跑全仓。 存活变异直接变成小范围补测试任务,减少人工重新描述上下文。 AI 写的测试由确定性变异结果反向校验,而不是再让另一个 AI 口头评价。
这里不写“提效 80%”。真正值得保留的是动作级变化:少手写一份骨架、少人工制造一次异常、少维护一套脆弱定位,或少重新解释一次测试缺口。
QA 必须人工校对什么
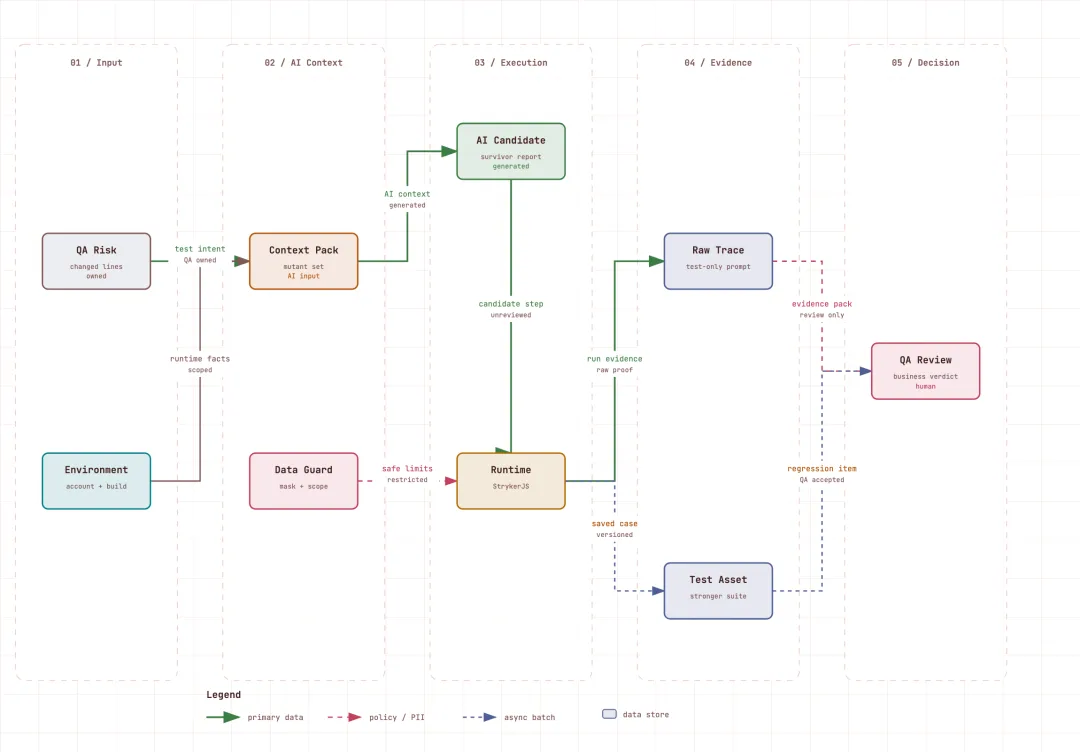
确认 agent 只修改测试文件,没有为了杀死变异改生产逻辑。 新测试必须在原始代码上通过,在对应错误行为上失败。 人工判断存活变异是否等价变异,不能要求每个变异都必须被杀死。 先限制改动行和文件数,避免 PR 门禁变成不可接受的长任务。
AI 越靠近执行层,QA 越要盯住业务结果、权限、数据副作用和失败归因。自然语言总结不能替代接口状态、数据库结果、运行轨迹或确定性断言。
风险边界
Tautest 不是变异引擎,本质上是围绕 StrykerJS 的 PR 工作流层。 当前主要支持 JavaScript/TypeScript 与 Vitest;Jest 和 workspace 能力仍有 beta 边界。 它默认不调用 LLM,AI 参与发生在使用生成 prompt 的后续补测试步骤。 变异测试不能证明测试完美,运行时间也受项目规模和测试速度影响。
什么时候值得继续投入
一条小场景能够稳定复跑。 输出证据能让 QA 判断失败发生在哪一步。 AI 候选经过人工修订后可以沉淀成测试资产。 扩范围前已经明确账号、数据、权限和副作用边界。
如果只得到一段“智能分析”,看不到执行过程,也无法加入人工门禁,它就更像演示,不适合成为 QA 的回归依赖。
总结
Tautest 值得尝试,不是因为它带 AI 标签,而是因为它直接进入了这个 QA 动作:只对 PR 改动行运行变异测试,把存活变异整理成确定性的补测试任务,再交给 Codex、Cursor 或其他 coding agent 强化测试。
正确顺序始终是小范围验证、人工校对、保存证据、再决定是否扩展。这样既能利用 AI 减少重复劳动,也不会把质量结论交给不可审计的黑盒。
官方资料依据
https://github.com/canblmz1/tautest