ARTICLE · 1050686
Python办公:Word 文档批量查找替换
Python办公:Word 文档批量查找替换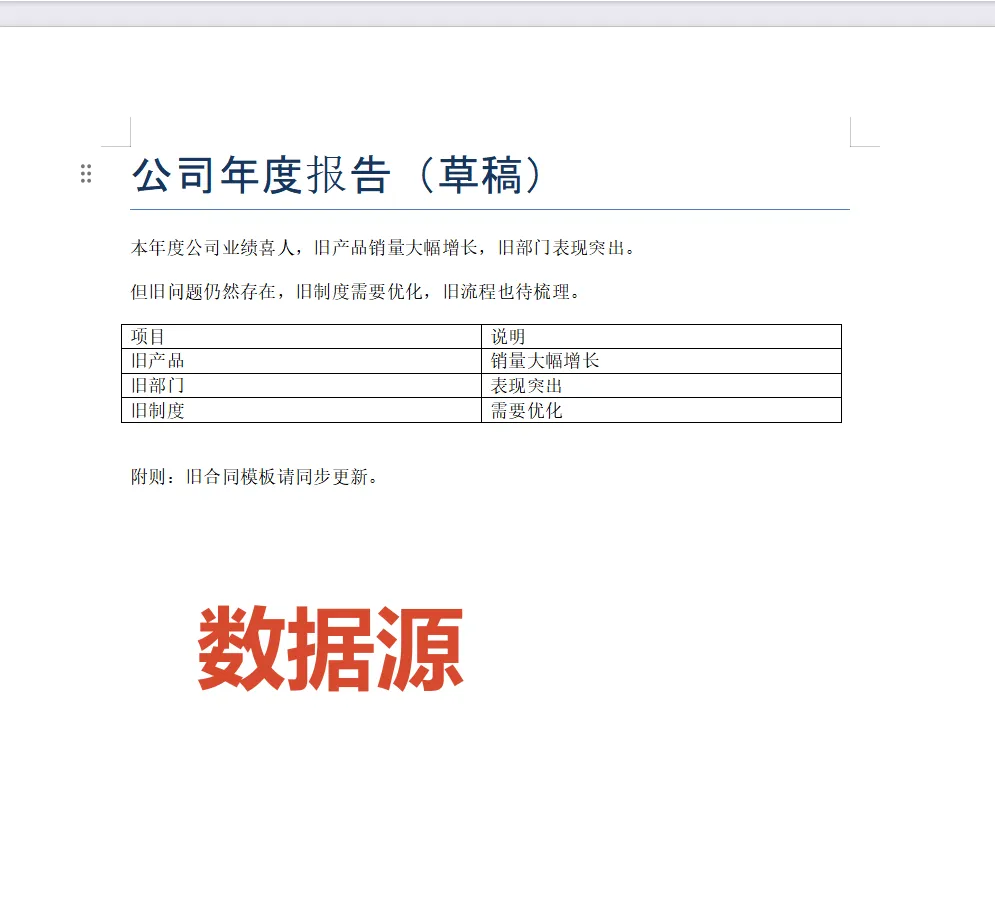
🔁 word_replace · Word 文档批量查找替换
一篇 Word 里多处出现同一个旧词(公司名、年份、产品名……),想一键全部替换成新词。正文段落和表格里的词都不会漏。
适用人群
• 行政 / 文秘:合同模板里公司名变更、年度更迭,批量替换全篇。 • 老师:试卷 / 课件里统一改术语、改年份。 • 运营 / 编辑:稿子里品牌词、活动名统一更新。 • 任何人:手里有一堆 .docx,要做全文级的「查找-替换」。
功能简介
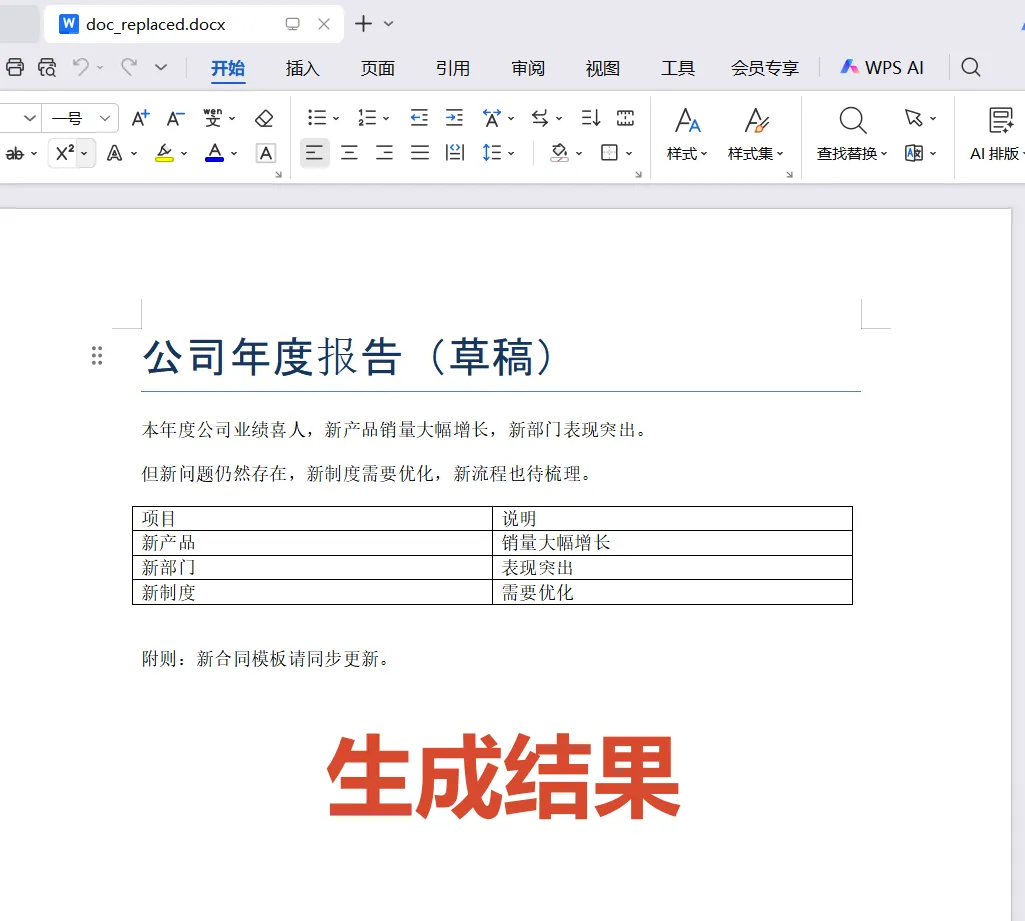
• 读取一篇 Word( testdata/doc.docx)和一份替换规则 JSON({"旧词":"新词"})。• 遍历所有段落和所有表格单元格执行替换,不留死角。 • 兼容「词被拆到多个 run(格式片段)」的情况,替换不漏、格式尽量保留。 • 输出 output/doc_replaced.docx,并回显是否还有残留旧词。• 文件 / 规则缺失时给出友好提示,JSON 格式错误也会被捕获。
环境准备
pip install python-docx本项目用
python-docx 1.2.0验证。替换规则是纯 JSON,无需额外依赖。
使用方法
# 1) 生成测试素材python make_testdata.py# 2) 默认运行python word_replace.py# 3) 自定义python word_replace.py --doc testdata/doc.docx --rules testdata/replace.json --out output/doc_replaced.docx输出示例:
替换规则共 6 条,已写入:.../output/doc_replaced.docx全部旧词已替换完成,无残留。核心代码讲解
1. 替换规则(JSON)
{"旧产品":"新产品","旧部门":"新部门","旧制度":"新制度"}键是要被替换的旧词,值是新词;中英文皆可,也支持把长句替换成另一段文字。
2. 段落内替换思路和批量生成一致:先逐 run 替换保格式,若词被拆到多个 run 则整段拼接后替换。
defreplace_in_paragraph(paragraph, mapping): runs = paragraph.runsifnot runs:returnfor run in runs:for old, new in mapping.items():if old in run.text: run.text = run.text.replace(old, new) full = "".join(r.text for r in runs)ifany(old in full for old in mapping): new_full = fullfor old, new in mapping.items(): new_full = new_full.replace(old, new) runs[0].text = new_fullfor r in runs[1:]: r.text = ""3. 表格也别漏
defreplace_in_table(table, mapping):for row in table.rows:for cell in row.cells:for para in cell.paragraphs: replace_in_paragraph(para, mapping)4. 残留检查替换后把正文 + 表格拼成一段文本,统计还有没有旧词——贴在新词里的旧词、页眉页脚、图片中的文字不在 python-docx 文本模型内,会在此提示,方便你人工复核。
测试素材说明
运行 make_testdata.py 后,testdata/ 下生成:
• doc.docx:含 2 段正文 + 1 个 4 行 2 列表格(表内也放了旧词,用来验证「表格替换」)。• replace.json:6 条旧→新规则。
运行后 output/doc_replaced.docx 中:正文与表格里的「旧产品 / 旧部门 / 旧制度 / 旧问题 / 旧流程 / 旧合同」全部变为对应新词,脚本回显「无残留」。
常见问题
• Q:页眉 / 页脚 / 文本框里的词没被替换?A:python-docx 的 paragraphs/tables不包含页眉页脚与文本框。如需覆盖,可额外遍历doc.sections的页眉页脚,或用docx2pdf走 Word 自身替换。本脚本会在回显中提示残留,便于你定位。• Q:旧词本身也是新词的一部分,会死循环吗?A:不会。脚本一次扫描、一次性替换,不存在「替换结果再次被替换」。 • Q:想把旧词保留大小写形态?A:本脚本为精确匹配(区分大小写)。若需忽略大小写,可在 replace_in_paragraph里改用不区分大小写的替换逻辑(注意新词大小写需自行指定)。• Q:批量替换很多个 docx?A:当前脚本处理单个文件;把 Document()放进遍历testdata/*.docx的循环即可,思路与本系列word_extract_tables类似。
打包成 exe
pip install pyinstaller# 单文件、无控制台pyinstaller -F -w word_replace.py• -F单文件;-w去掉黑色控制台(想看进度就去掉-w)。
资源路径坑本脚本用 base_dir() 取脚本所在目录作为相对路径基准,打包后不怕「当前目录」变化。但 testdata/ 不会被自动打进 exe:
• 方式 A(推荐):把 word_replace.exe和testdata/放一起发布。• 方式 B(内置素材):
并在pyinstaller -F -w --add-data "testdata;testdata" word_replace.pybase_dir()兼容sys._MEIPASS:defbase_dir():ifgetattr(sys, "frozen", False):return sys._MEIPASSreturn os.path.dirname(os.path.abspath(__file__))
加图标
pyinstaller -F -w --icon=app.ico word_replace.py瘦身
pyinstaller -F -w --upx-dir=upx word_replace.py依赖很少(仅 docx),体积主要来自 python-docx 及其依赖,UPX 可再压一截。
常见坑
• 双击 exe 提示找不到 testdata/:按上面方式 A/B 处理资源。• JSON 含中文却报错:确保 replace.json是 UTF-8 编码(Windows 记事本默认存成 UTF-8 即可)。• 杀软误报:单文件 exe 偶有,加白名单或目录式发布。
小结
word_replace 把「全篇查找替换」自动化,关键是同时遍历段落和表格,并兼容词被拆成多 run 的坑。理解了替换逻辑,你可以把它改成「批量处理一整个文件夹」的进阶版。