ARTICLE · 1050684
RustFS 上手文档:一篇文章看懂全功能版图(S3 兼容对象存储)
如果你和我一样,之前没怎么碰过 RustFS,只想搞明白「它是什么、怎么装、怎么用、还能做到什么程度」——这篇就是给你写的。命令都来自官方文档与实践,循序渐进,覆盖全貌但不深挖;读完你应该能画出 RustFS 的功能地图,知道每个能力对应哪个场景。
一句话:RustFS 到底是什么
RustFS 是一个用 Rust 写的高性能分布式对象存储系统,核心卖点就一句:完全兼容 S3 协议。
换句话说,你原来怎么用 AWS S3、怎么用 MinIO,换成 RustFS 基本不用改代码——只是它把内核换成了 Rust,内存更省、写吞吐更高,而且许可证是 Apache 2.0(不像 MinIO 社区版是 AGPLv3,商用要小心开源义务)。
几个关键事实先记一下:
仓库: github.com/rustfs/rustfs协议:Apache 2.0(商用友好) 端口:9000 = S3 API,9001 = Web 控制台 默认账号: rustfsadmin/rustfsadmin(上线前务必改)状态:2026 年 9 月发布 1.0.0 GA,已可用于生产
本文接下来的节奏:先让你跑起来(第 2–6 章),再带你扫一遍生产环境真正用得到的五大能力面——权限、数据保护、分布式高可用、监控运维、协议网关(第 7–11 章),专门讲一章 AI 时代的优势(第 12 章),最后给一张选型对照表(第 13 章)。
3 分钟装起来:Docker / 二进制 / 一键脚本
最省事的方式是 Docker,一条命令起一个单节点实例:
docker run -d \ --name rustfs \ -p 9000:9000 \ -p 9001:9001 \ -v $(pwd)/data:/data \ -e "RUSTFS_ACCESS_KEY=你的accesskey" \ -e "RUSTFS_SECRET_KEY=你的secretkey" \ -e "RUSTFS_VOLUMES=/data" \ -e "RUSTFS_CONSOLE_ENABLE=true" \ -e "RUSTFS_CONSOLE_ADDRESS=0.0.0.0:9001" \ rustfs/rustfs:latest起来后访问:
S3 API: http://你的IP:9000Web 控制台: http://你的IP:9001
生产环境建议用 docker-compose 管理(把 data 挂持久卷、restart: unless-stopped)。不想碰 Docker 也有两条路:
# 官方一键脚本curl -O https://rustfs.com/install_rustfs.sh && bash install_rustfs.sh# 二进制直接跑(先 export 根账号/根密钥)export RUSTFS_ROOT_USER=你的accesskeyexport RUSTFS_ROOT_PASSWORD=你的secretkeyrustfs server /data/rustfs --console-address ":9001"Kubernetes 用户走 Helm Operator(helm repo add rustfs-operator https://operator.rustfs.com),Sealos 也能一键部署——按你的运维习惯选。
第一次启动:环境变量与数据目录
RustFS 几乎全靠环境变量配置,记住这几个就够日常用了:
RUSTFS_ACCESS_KEY | ||
RUSTFS_SECRET_KEY | ||
RUSTFS_VOLUMES | /data | |
RUSTFS_ADDRESS | 0.0.0.0:9000 | |
RUSTFS_CONSOLE_ENABLE | true | |
RUSTFS_CONSOLE_ADDRESS | 0.0.0.0:9001 |
几个关键点:
数据一定要挂持久卷。RustFS 把对象和元数据都直接写盘,不挂卷重启数据全没。 最小配置:2 核 / 4GB 内存就能跑测试;生产往上加。官方建议文件系统用 XFS 或 ext4。
用 mc 客户端管桶:建 / 传 / 列 / 删
RustFS 完全兼容 MinIO 生态,mc 客户端直接复用。装好 mc 后:
# 添加主机(把 IP / key 换成你的)mc config host add rustfs http://你的IP:9000 你的accesskey 你的secretkey# 建桶mc mb rustfs/my-bucket# 上传文件mc cp ./report.pdf rustfs/my-bucket/# 列出桶内文件mc ls rustfs/my-bucket/# 看占用mc du rustfs/my-bucket/# 删对象 / 删桶mc rm rustfs/my-bucket/report.pdfmc rb rustfs/my-bucketAWS CLI 也一样:aws s3 ls --endpoint-url http://localhost:9000 即可。任何 S3 工具(rclone、各类备份软件)都能直接指向 9000 端口,迁移成本为零。
用代码对接:S3 SDK 的通用套路
因为 100% S3 兼容,你手上的任意 S3 SDK 都能用,只改三处:endpoint 指向 RustFS 地址、开启 path-style、region 随便填(RustFS 不校验 region)。
Python(boto3)示例:
import boto3s3 = boto3.client("s3", endpoint_url="http://你的IP:9000", aws_access_key_id="你的accesskey", aws_secret_access_key="你的secretkey", region_name="us-east-1", # 随便填,RustFS 不校验)# 上传s3.upload_file("report.pdf", "my-bucket", "report.pdf")# 列出print(s3.list_objects_v2(Bucket="my-bucket"))Java(AWS SDK)要点:endpointOverride(URI.create("http://IP:9000")) + forcePathStyle(true) + region(Region.US_EAST_1)。
⚠️ 新手最常卡的一点:忘了开 path-style。RustFS 走
http://host:9000/bucket/object这种路径风格,SDK 默认可能是 virtual-hosted,结果报NoSuchBucket。把forcePathStyle打开就对了。
三个新手必踩的坑
默认账号没改:默认 rustfsadmin/rustfsadmin,公网一开就被扫。上线第一件事改RUSTFS_ACCESS_KEY/RUSTFS_SECRET_KEY。path-style 没开:上面说过,SDK 不显式开就报桶不存在。 S3 兼容性有边界:99% 的调用开箱即用,但有两个实测坑—— ListObjectsV2某些prefix+delimiter组合分组略有差异;MinIO 的/minio/health/live健康检查端点 RustFS 没有(改用 RustFS 自己的探活或/minio/health/ready)。站点复制(Site Replication)目前不支持,跨集群同步用rclone sync顶上。
到这里你已经能单机跑通 RustFS 了。下面 5 章是生产环境绕不开的能力面(第 7–11 章)——每章点到为止,知道「它解决什么、怎么开」即可;它们也是 AI 工作负载的底层支撑,第 12 章会专门串起来讲。
权限与访问控制:IAM / Bucket Policy / STS / OIDC
单机用 root 账号够了,但一旦多人或多服务接入,就得上访问控制系统。RustFS 的策略引擎对齐 AWS IAM,所以你会很熟悉:
身份:IAM 用户、用户组、服务账号(service account,给程序用的长期凭证)。 临时凭证:STS 签发有时效的临时密钥,避免把长期 key 散落各处。 单点登录:支持 OIDC(比如对接你的企业 IdP),还带 single sign-out。 桶策略(Bucket Policy):Public / Private / Custom JSON 三档,精细控制「谁能在什么条件下对哪些前缀做什么」。 判定优先级(记住这条就不会配错):显式拒绝 Explicit Deny > 仅拒绝 DenyOnly > 属主绕过 Owner Bypass > 显式允许 Explicit Allow。
开一个只读用户并绑策略的套路:
# 建用户mc admin user add rustfs alice 她的密码# 绑定内置只读策略mc admin policy set rustfs read-only user=alice# 给程序开一个服务账号(拿临时/长期凭证)mc admin user svcacct add rustfs alice经验:权限遵循最小授权。给人用 STS + OIDC,给程序用 service account,别把 root key 写进业务代码。
数据保护:版本控制 / 对象锁 / 加密 / 复制 / 自愈
对象存储不怕硬盘坏,怕的是误删、被改、被勒索、跨机房丢。RustFS 这一组能力就是来兜底的:
版本控制(Versioning):三态—— Unversioned/Enabled/Suspended。注意它不能彻底关,只能挂起(Suspend);单个对象最多 1 万个版本。误删后能回到旧版本。对象锁(Object Lock / WORM):合规保留或治理保留,锁定期内谁都改不了删不了,对付勒索软件和监管很香。 服务端加密: SSE-S3(平台托管密钥)/SSE-KMS(对接 KMS,后端支持 Local / HashiCorp Vault / AWS KMS)/SSE-C(你自带密钥)。桶复制(Replication):支持站点间双写(Active-Active),一个机房挂了另一个还能读写。 自愈(Heal)+ Bitrot:落盘用 SHA-256 校验,后台自动扫描修复静默损坏,丢盘后自动重建。
开版本控制 + 加密一行搞定:
# 桶开启版本控制mc version enable rustfs/my-bucket# 桶级 SSE-S3 加密mc encrypt set sse-s3 rustfs/my-bucket配额也在这里设:
mc quota set rustfs/my-bucket --size 1TiB,防止某个租户把集群写爆。
多节点高可用:分布式 MNMD 模式
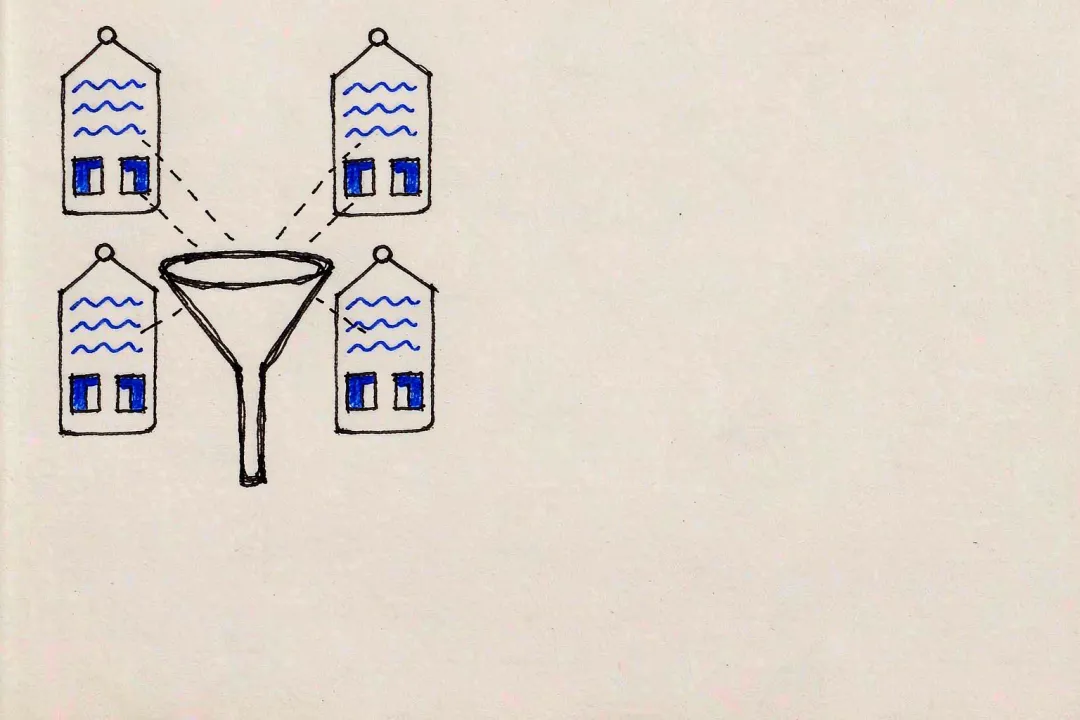
单节点是玩具,生产要上分布式。RustFS 的分布式叫 MNMD(Multiple Nodes Multiple Drives):多台机器、每台多块盘,组成一个纠删码(Erasure Coding)阵列。
几个必须知道的点:
最少 4 台服务器才能组分布式;默认纠删布局是 12+4(12 数据 + 4 校验,共 16 片)。小规模也可用 4+2(容忍任意 2 片丢失)。 数据靠花括号展开一次性声明:节点和盘都列进 RUSTFS_VOLUMES。
# 4 节点 × 4 盘 的分布式卷声明(node1..node4 已在 /etc/hosts 或 DNS 解析)export RUSTFS_VOLUMES="http://node{1...4}:9000/data/rustfs{0...3}"export RUSTFS_ACCESS_KEY=你的accesskeyexport RUSTFS_SECRET_KEY=你的secretkeyrustfs server --console-address ":9001"层级关系:Node(机器)→ Drive(盘)→ Set(纠删集)。数据被打散到 Set 里的各盘。 法定票数:读法定 = 数据盘数;写法定 = 数据盘数(+1 当数据片数等于校验片数)。少数是盘坏、多数是节点挂,都能扛。 前置:每台机器用 systemd 起同样的服务;前面挂一个负载均衡(Nginx / HAProxy / 云 LB)把 9000 流量分摊。主机名要能顺序解析(写 /etc/hosts或用 DNS 轮询)。
这是从「能存」到「不会丢」的关键一跃。真要上,照官方 MNMD 文档把 systemd 单元和 LB 配齐,别裸跑。
监控与运维:Prometheus / Grafana / 审计 / K8s Operator
存进去不算完,看得见、查得着、能自愈才是运维。RustFS 的观测面很完整:
指标:暴露 200+ Prometheus 指标,比如 rustfs_request_duration_seconds(请求时延)、rustfs_bytes_written_total(写总量)、rustfs_cache_hit_ratio(缓存命中率)、rustfs_node_status(节点健康)。直接scrape_configs挂进去就行。看板:官方 Grafana 面板一套,节点、盘、请求、容量一目了然。 链路追踪:支持 OpenTelemetry / OTLP,接进你现有的 APM。 审计日志:可流式推到 Kafka / Pulsar,做合规留存和异常告警。 K8s 原生:Helm Operator( operator.rustfs.com)一条命令管集群生命周期;TLS 用 cert-manager 自动续。
Prometheus 抓取片段(示意):
scrape_configs:-job_name:rustfsstatic_configs:-targets: ["rustfs:9000"] # 填你的负载均衡地址# K8s 一键装 Operatorhelm repo add rustfs-operator https://operator.rustfs.comhelm install rustfs-operator rustfs-operator/rustfs-operator -n rustfs --create-namespace生产三件套:Prometheus 抓指标 + Grafana 看板 + 审计日志落 Kafka。三者齐了,半夜被叫醒的概率直线下降。
协议网关:WebDAV / SFTP / S3 Select / MCP
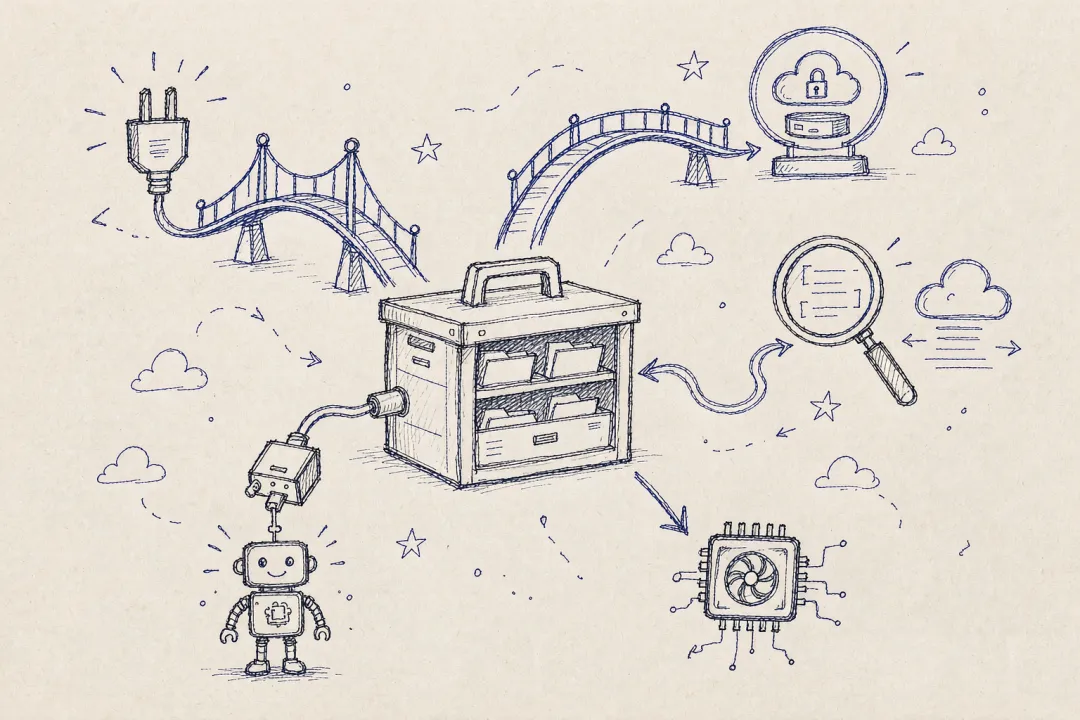
S3 API 是主线,但 RustFS 还顺手提供了几座「桥」,让不是 S3 客户端的系统也能用上它:
WebDAV / FTP / SFTP:直接当网盘挂,设计、财务同学不用装客户端就能拖文件。 OpenStack Swift API:从老 Swift 栈迁过来零改造。 S3 Select:在对象存储侧用 SQL 直接检索对象内容(SIMD 加速),不用把整个大文件拉回本地再筛——查日志、查 CSV 巨省带宽。 MCP Server:给 AI Agent 用的接口,大模型能直接「读/写/列」你的桶,做 RAG 或工具调用。 GPU Direct Storage / RDMA:高性能场景把数据从存储直通到 GPU 显存,绕过 CPU 拷贝,训大模型喂数据更快。
这部分大多在控制台或配置文件里开开关,按需启用即可,不必一次全开。
AI 时代的优势:RustFS 为什么天生适合大模型工作负载
RustFS 不是「刚好能用」在 AI 场景,它的几个设计点正好压中大模型时代的真实痛点——数据吞吐、Agent 接入、合规嵌入、边缘推理。
1. 给 AI Agent 开了原生门:MCP Server 大模型应用(RAG、Agent)最缺的是「安全、结构化地读写你的私有数据」。RustFS 直接提供 MCP Server,Agent 能把「读 / 写 / 列某个桶」当成工具调用,不用自己撸 S3 适配层。
例:客服 Agent 用 MCP 直接读
rustfs/kb/桶里的产品文档做检索增强,答案始终基于你最新的私有资料,而不是训练时的旧知识。
2. 训练数据直喂 GPU:GPU Direct Storage + RDMA 训练常被数据加载拖后腿。RustFS 支持 GPU Direct Storage / RDMA,对象数据从存储直通 GPU 显存、绕过 CPU 拷贝,dataloader 不再成瓶颈。
例:多机多卡训练 ImageNet / 海量 parquet,每个 worker 直接高吞吐拉取分片,显存利用率和训练步速明显提升。
3. 写密集快 20–40%:对检查点与数据入湖友好 RustFS 小文件写(PUT)比 MinIO 领先约 20–40%。训练检查点、数据集灌入、日志归档都是纯写密集。
例:每 10 分钟落一次几 GB~几十 GB 的 checkpoint,写优势直接缩短保存窗口、降低训练中断风险。
4. Apache 2.0:把对象存储塞进闭源 AI 产品不踩雷 MinIO 社区版是 AGPLv3——网络服务分发要开源你的产品。RustFS 是 Apache 2.0,可无开源义务地嵌入闭源 AI SaaS、私有化交付、信创方案。
例:做一款企业闭源 RAG 一体机,底层用 RustFS 存知识库,不用向客户公开你的源码;换 MinIO 社区版则为 AGPL 头疼。
5. 数据集版本化 + 多区域镜像:可复现的训练基建 S3 版本控制(单对象最多 1 万版本)+ 跨站点双写复制,天然适配「数据集版本管理 + 多地训练集群同步」。
例:数据集 v3 训出的模型效果回退,直接回滚到 v2 桶版本重训;北京 / 法兰克福双集群靠复制保持训练数据一致。
6. 小内存跑边缘:ARM / homelab 推理 空闲内存 80–120MB(MinIO 250–350MB),能在受限边缘盒、ARM 开发板、homelab 上跑起合规对象存储,给本地 / 边缘推理当数据底座。
例:工厂车间边缘服务器用 RustFS 收视觉检测模型产物与日志,低配机器也跑得动。
一句话:RustFS 在 AI 时代的价值 = Agent 能直接接(MCP)+ 训练喂得动(GPU Direct / 写密集)+ 产品敢嵌入(Apache 2.0)+ 边缘放得下(小内存)。
RustFS vs MinIO:什么时候换、什么时候留
换 RustFS,如果:
负载偏写(CI/CD、ML 检查点、日志归档、上传) 在意许可证合规(信创 / 私有化交付 / 闭源产品嵌入) 跑在资源受限机器(边缘、ARM、homelab) 想要一个改动最小的 S3 平替
留 MinIO,如果:
负载偏读且全是小对象(CDN 源站、缩略图、静态资源) PB 级极端混合负载 依赖 MinIO 特有集成(十年生态) AGPL 对你无影响
一句话总结:RustFS 不是「全面碾压 MinIO」,而是在「写密集 + 许可证 + 小内存」这三个具体场景上更合适。按你的真实负载选,别被「性能翻倍」的营销话术带偏。
到这里,RustFS 的全貌你应该有了清晰地图:单机能跑(第 2–6 章)→ 有权限(7)→ 丢不了(8)→ 多节点高可用(9)→ 看得见(10)→ 接得进各种系统(11)→ AI 时代吃得开(12)→ 选型不纠结(13)。下一步就是挑一个最小的真实场景动手——比如先把 CI 产物归档迁过来,跑顺了再扩。