ARTICLE · 1066963
AI智械前沿|先在想象中练习:世界模型如何教会微机器人血管导航
微机器人在通道中前进,下一步该启动哪个超声换能器、使用多大驱动幅度,并不是简单的位置计算。机器人与换能器的距离、微泡团的大小、通道边界和液体流动,都会改变同一道控制指令产生的运动效果。靠人工逐次调节,难以兼顾速度和精度;让算法完全依赖真实实验反复试错,又需要付出较高的时间成本。
2025年6月26日,苏黎世联邦理工学院Daniel Ahmed团队与IBM Research的研究者在Nature Machine Intelligence发表Model-based reinforcement learning for ultrasound-driven autonomous microrobots。论文第一作者为Mahmoud Medany。团队将Dreamer v3世界模型强化学习用于超声驱动微机器人的控制,通过仿真预训练,再转入实体装置微调,实现了人工血管通道中的目标导航,并进一步测试了流动条件下的操控。研究证据来自仿真和体外微流控实验,尚未完成活体血管内的自主导航验证。
这项工作的重点,是让算法学习控制动作与器械运动之间的关系,再利用预测结果训练操作策略。AI由此参与的不只是图像识别,还包括下一步控制指令的生成。
一、被控制的是微泡团,控制系统位于体外
研究中的微机器人由微泡自组装形成。单个微泡直径约2—5微米,在声场作用下相互聚集,形成能够被超声驱动的微泡团。这里的2—5微米指组成单元的尺寸,不能直接当作整个微机器人的大小。
实验平台采用透明的聚二甲基硅氧烷(PDMS)微流控通道,周围呈八角形布置8个压电换能器。计算机通过电子控制电路切换换能器,并调整激励信号的频率和幅度,使微泡团移动或转向。不同位置、不同大小的微泡团对驱动信号的响应并不相同,这也是需要学习控制策略的原因。
位置反馈来自倒置显微镜和相机。图像经过分割与追踪,提取通道边界、障碍物、微机器人位置和目标信息,再送入控制模型。超声在这里承担驱动任务,并不是用于定位机器人的成像手段;世界模型也运行在外部计算机中,而非集成在微泡团内部。
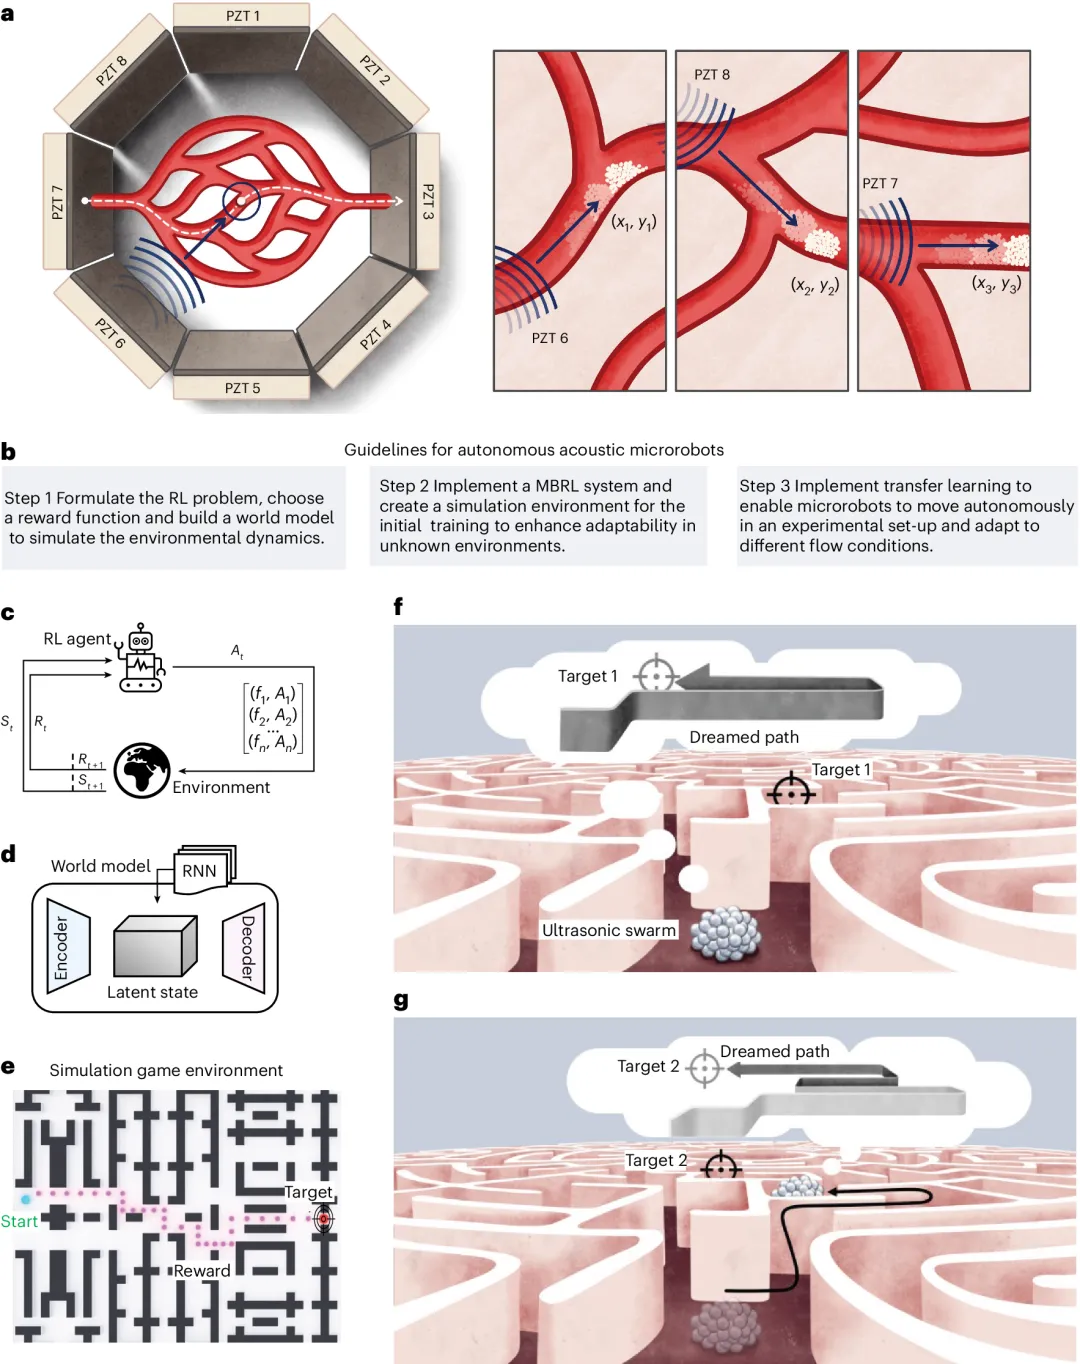
图1.自主超声波驱动微型机器人
二、世界模型如何参与控制
世界模型在这项研究中有明确的技术含义:它根据当前观察和既往动作,学习预测微机器人接下来可能处于什么状态,以及相应动作能够获得多少奖励。
Dreamer v3首先将图像等观察信息压缩成便于计算的内部表征,再学习这些表征如何随动作变化。例如,启动某个换能器后,机器人可能向哪个方向移动,是否接近目标,是否会进入障碍区域。模型不必每次都让实体机器人执行完整动作序列,便可以在内部生成多条预测轨迹。
随后,策略网络和价值网络利用这些预测轨迹进行训练。策略网络学习选择动作,价值网络评价后续结果。训练得到的策略再用于真实装置,新的运动反馈则继续修正世界模型。所谓先在想象中练习,指的就是利用模型预测出来的经历学习控制,而不是把所有试错都放在实体实验中。
这里需要区分模型训练与实际执行。Dreamer主要通过预测轨迹训练决策策略,并不意味着机器人每移动一步,都要穷举全部路线后重新选出最优解。它也没有预先获得完整的声学或流体力学模型,而是从观察到的动作与结果中学习可用于控制的关系。
在实验中,研究者根据到达目标、与目标的距离以及碰撞情况设置奖励。机器人需要学习的不只是靠近目标,还包括绕开障碍、减少无效动作。目标和评价标准仍由研究者定义,模型负责在这些约束下改进控制。
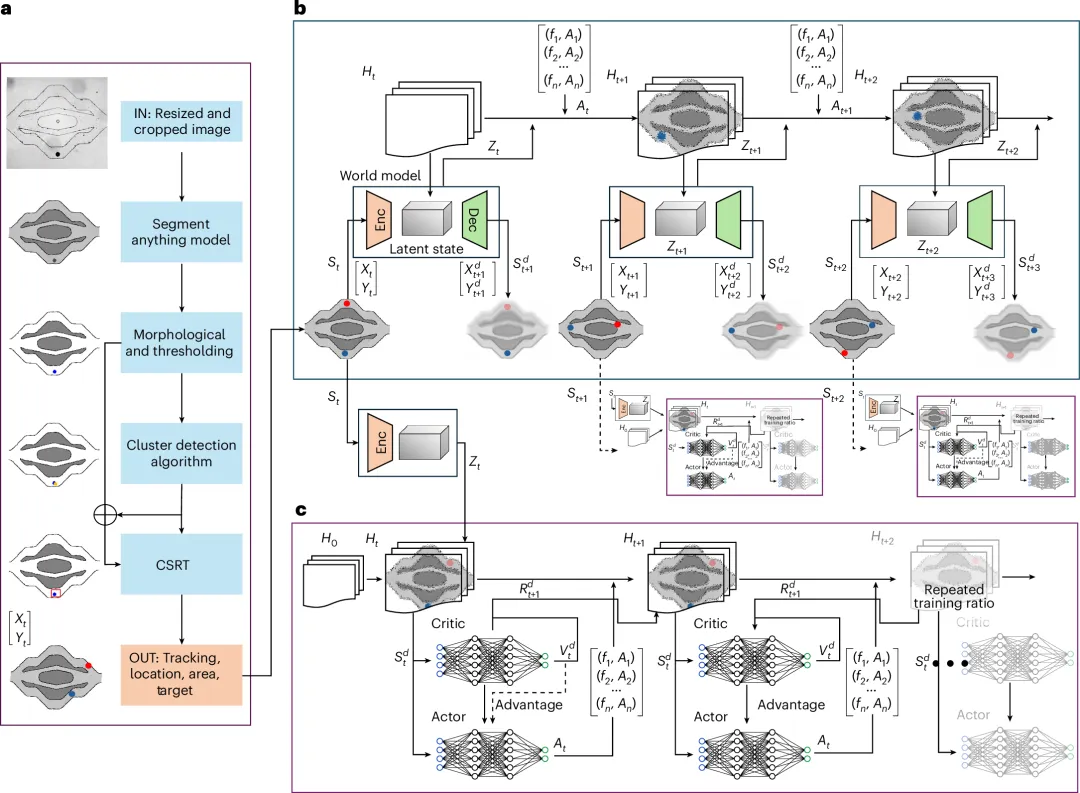 图2.基于模型的自主微型机器人强化学习结构
三、约一小时达到90%成功率,前提是仿真预训练
仅依靠真实装置训练并不高效。论文中的早期模型在实体跑道形通道内持续运行约10天,目标达成比例约为70%,而且容易过拟合于局部区域。要求它进入通道其他位置后,表现就会下降。
为减少实体试验消耗,团队建立了基于Pygame的仿真环境。通道、障碍物、机器人和目标被表示为简化图像,模型先在其中学习局部导航和避障。这个仿真并未完整复现压电换能器共振、微泡尺寸变化等复杂动力学,因此迁移到实体装置后,仍需适应真实驱动条件。
在这一预训练基础上,作者报告,经过约一小时的微调,目标导航成功率可达到90%。这一时长指预训练后的适应阶段,不是整个模型从零开始的训练时间;90%对应的是实验中预设目标的到达率,也不是治疗成功率。论文中不同训练配置所需的适应时间并不完全一致。
仿真对照还显示,Dreamer v3在所测试通道中的学习效率优于无模型强化学习算法PPO。例如,在血管样通道任务中,Dreamer约需100万次交互步达到收敛,PPO约需2500万步。这说明,在该研究的任务和配置下,学习环境变化并利用预测轨迹训练,可以减少所需的交互次数;不能将这一比例直接换算成所有实验中的耗时优势。
团队也测试了跨通道适应。经过多种布局训练后,模型在未见过的环境中初始成功率约为50%,继续训练约30分钟后提高至90%以上。结果支持这种训练方式具有一定迁移能力,但也表明,新环境并不总能直接使用原有策略,进一步适应仍然重要。
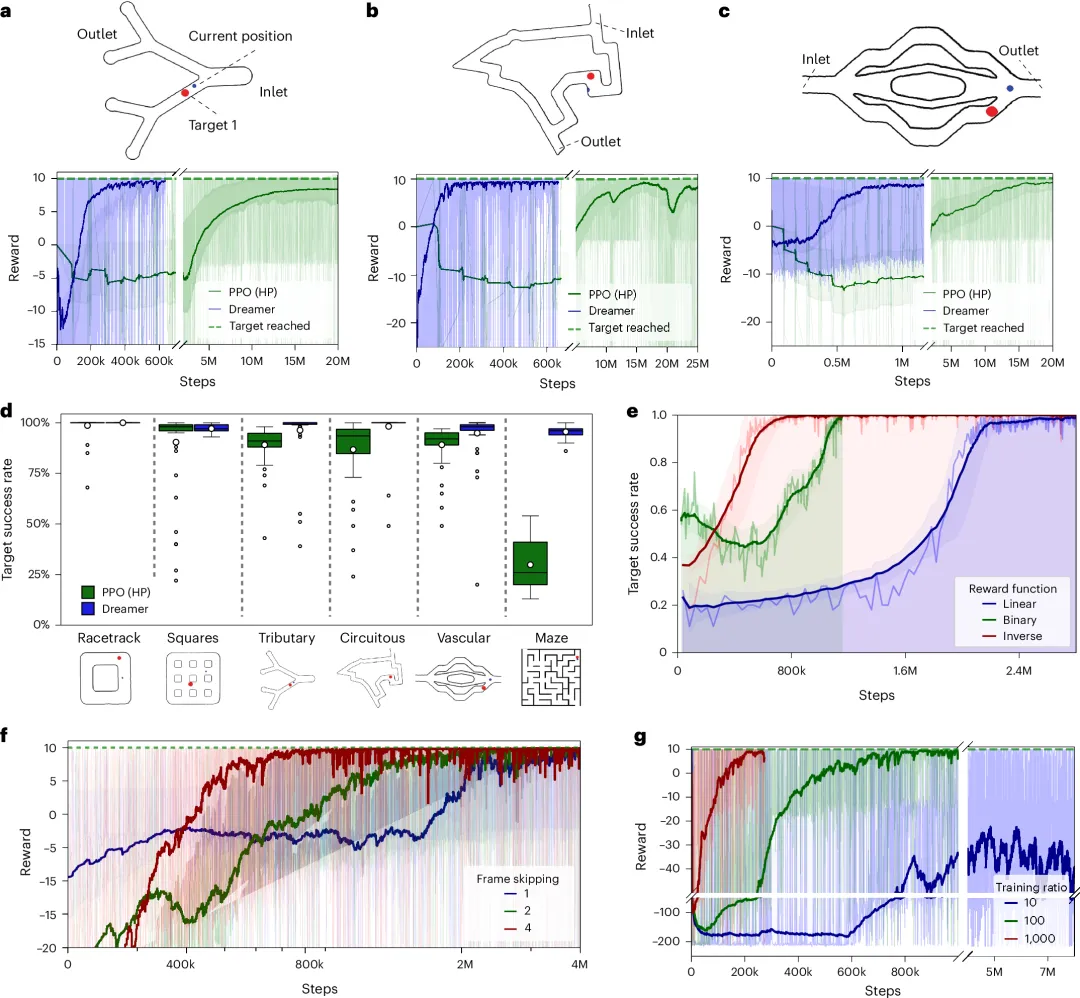
图3. 使用 RL 算法对微型机器人在各种环境下的导航性能进行分析
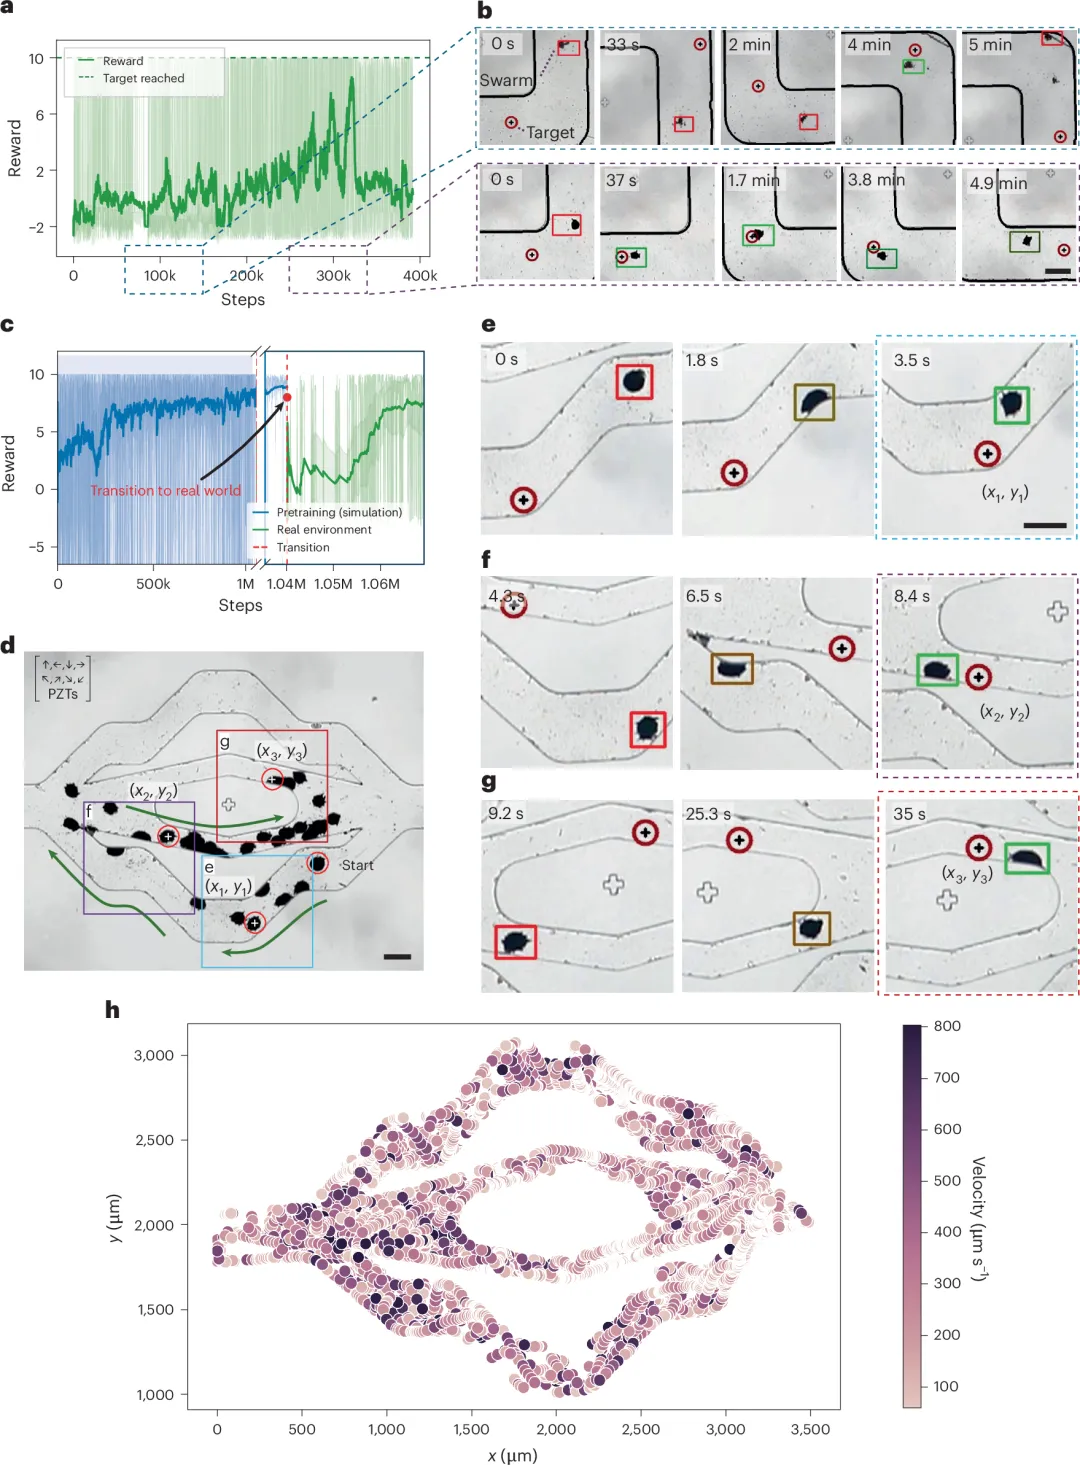 图4.自主微型机器人从仿真环境过渡到物理环境
四、控制性能也依赖驱动系统的改进
将算法接入实体装置,并不是把仿真中的方向指令直接转换成电信号就能完成。
研究者最初使用有限的离散频率,随后尝试让算法连续调整频率和幅度。但在连续动作训练中,反复改变频率容易造成运动不稳定,机器人有时会越过目标位置。换能器的实际共振特性,成为仿真与实体控制之间不能忽略的差别。
团队因此将共振频率附近的扫频过程纳入离散动作,使每次驱动能够覆盖更合适的工作频段。调整后,微机器人的运动和动作切换更加平稳。研究中的部分路径跟随实验还结合了传统路径规划算法。
这些细节说明,系统的效果来自学习算法与驱动设计的配合。世界模型改善了策略学习效率,换能器控制方式则决定了策略能否可靠地执行。将全部性能提升归因于一个AI模型,会遗漏这项研究中重要的工程工作。
五、逆流导航:把流体力学经验写入训练目标
液体开始流动后,控制任务发生了变化。微机器人不仅需要朝目标移动,还要抵抗流动造成的位移。团队没有直接沿用静止液体中的训练方案,而是修改了仿真环境和奖励函数。
研究者在仿真中加入持续流动造成的扰动,并对机器人进入通道中央区域施加额外惩罚,促使其靠近管壁。近壁区域的局部流速较低,加上声学作用产生的微泡团与壁面相互作用,有利于机器人沿壁面移动。
驱动幅度也根据运动方向调整:逆流时增加驱动,顺流时降低驱动。通过这些措施,团队在体外通道中演示了顺流和逆流导航。微机器人短暂离开视野时,系统还会利用最后记录的位置,尝试反向执行近期动作,使其重新进入观察范围。
因此,贴壁逆流并非算法完全自行发现的策略。研究者明确利用了近壁流动特征,并将其写入训练规则。AI在给定的物理认识和任务目标下学习如何操作,这比完全不加约束的试错更接近实际器械控制的开发方式。
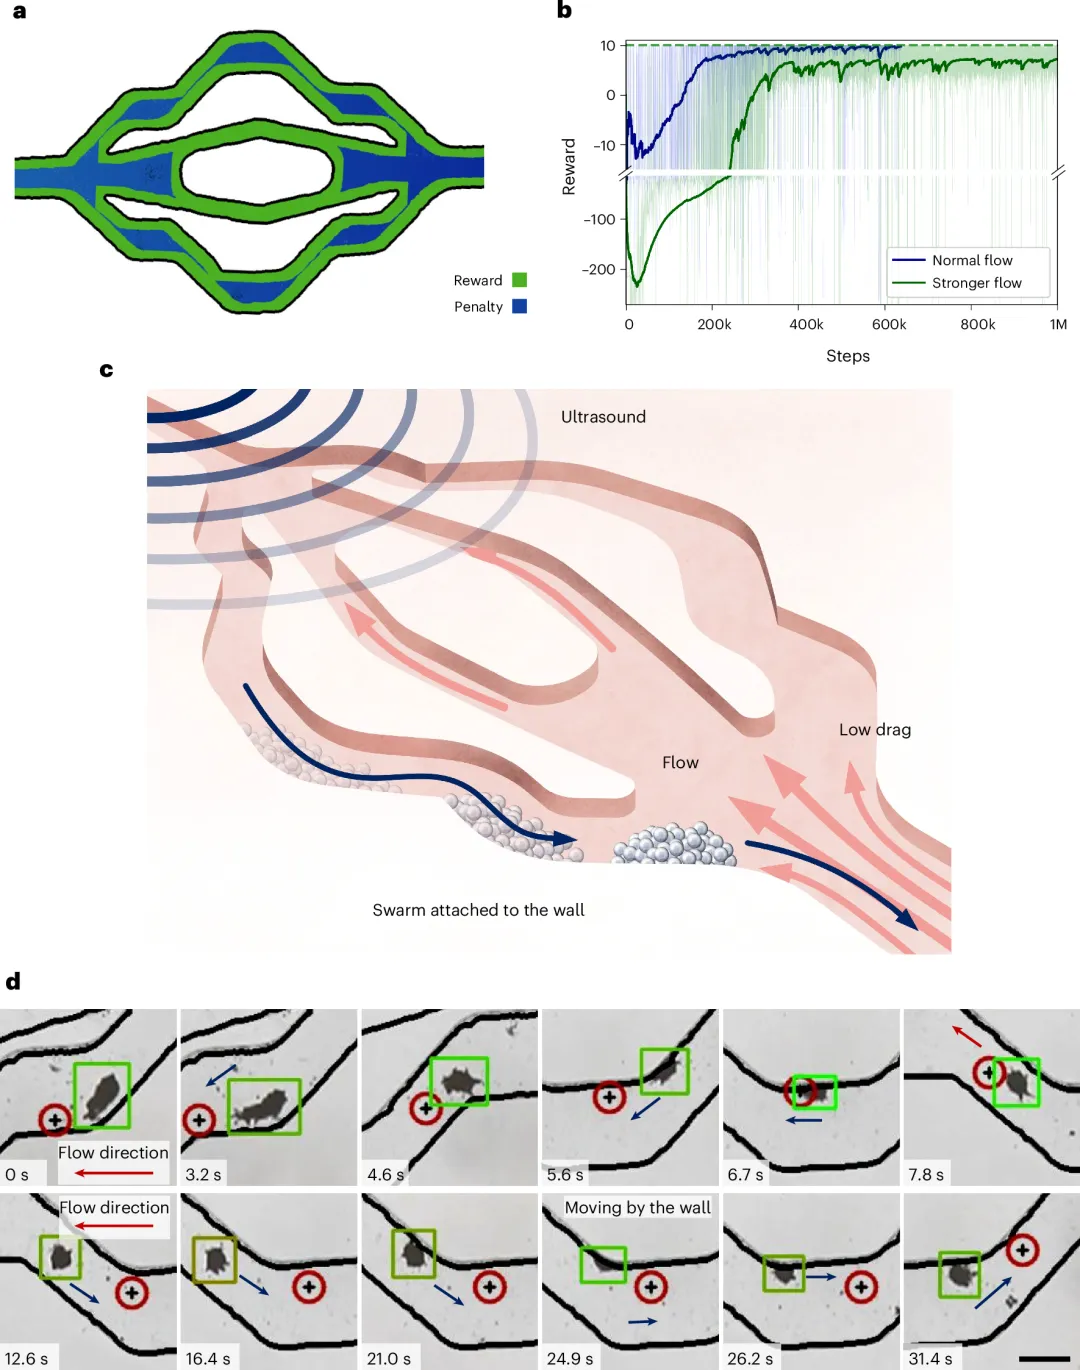
图5.微型机器人在流动环境中向上游自主导航
六、从人工通道到生物血管,仍有几项关键问题
这项研究证明了世界模型能够参与微机器人的实体控制,但实验中的人工通道与生物血管仍有明显距离。
首先是观察条件。现有主要导航结果依赖透明通道和显微镜视野。进入组织后,如何在遮挡、噪声和运动条件下持续定位,是下一步必须解决的问题。论文还展示了初步三维操纵,但完整的三维感知与自主控制仍被列为后续研究方向,不能将其概括为已经完成三维血管自主导航。
其次是流动与壁面条件。人工通道中的沿壁运动,为抵抗流动提供了可行思路,却不能直接证明在内皮表面、分叉病变或血栓附近同样安全。后续评价应同时观察目标到达率、壁面接触、微泡团聚散及局部组织影响,而不能仅以导航是否成功判断系统性能。
训练方式也需要重新考虑。约一小时微调体现了实验数据利用效率的改善,但体外允许的碰撞、偏航和重新训练,不能原样搬到患者体内。面向临床的系统需要明确模型适用范围,预设停止和人工接管条件,并在部署前充分验证异常场景。
对介入器械研发而言,这项工作提供了一个具体切入点:将任务拆分为可观察、可预测和可执行的控制步骤,在仿真中学习基本策略,再用实体试验识别模型偏差。评价时既要记录能否到达目标,也要记录偏离路径的程度、错误动作、恢复能力和控制延迟。
论文的价值,正在于把图像反馈、内部预测和超声驱动接成了可运行的控制系统。微机器人下一步如何移动,已经由算法参与决定;而这种决定能否在更复杂、更不确定的环境中保持可靠,才是后续研究需要检验的核心问题。
论文信息
Medany M, Piglia L, Achenbach L, Mukkavilli SK, Ahmed D. Model-based reinforcement learning for ultrasound-driven autonomous microrobots. Nature Machine Intelligence. 2025;7(7):1076–1090.
发表日期:
2025年6月26日。
DOI:10.1038/s42256-025-01054-2。
欢迎材料学、力学、柔性电子学等相关专业课题组及有意开展医工交叉研究的同学,通过本公众号后台联系,共同探讨合作方向。