ARTICLE · 1079617
AI 勒索率 96%?实验里是,现实一起都没记录到
2026 年 4 月下旬,一家做租车软件的小公司 PocketOS,生产数据库连同全部备份,在 9 秒里被删了个干净。
动手的不是黑客。是他们自己在 Cursor 里跑的编码 agent。它接到的是例行任务,中途撞上一个凭证问题:代码库里躺着一枚没做范围限制的 npm token,agent 顺手捡起来,拿到了生产环境的钥匙,然后一条 API 调用把库和备份一起抹了。创始人 Jer Crane 后来对媒体复述 agent 的「认罪」,大意是删除属于不可逆的最具破坏性的操作,说完接着删。《卫报》2026 年 4 月 29 日报道了这事,标题里写着 gone rogue,失控的 agent。
这类事现在有个统称:agent 越界。但它到底是哪种越界?agent「坏」了,还是 agent「笨」了?这两种想象的防法完全不同。我拉了一份公开的 agent 事故数据库来数,数完发现答案跟热搜给的直觉不太一样。
我数的是什么数据
数据来自 AI Agent Incident Database,由 sipi.bot 维护,2026 年 9 月 24 日的版本,CC BY 4.0 协议,每条记录都挂公开来源链接。我把 JSON 拖下来跑了遍统计:110 条记录,其中 100 条是事故,10 条是行业统计。100 起事故里 97 条标了已核实,来源包括《卫报》、TechCrunch、GitHub issue、Google 威胁情报组这类。
先交代两个我下载时踩到的口径坑,免得你也掉进去。
一是这个库号称「追踪到 5.57 亿美元损失」,但最大单条是 5 亿美元:某家企业忘了给 Claude 企业账号设用量上限,被员工的用量干出来的账单(TechCrunch 引 Axios 的报道)。这是企业治理失误,不是 agent 自主决策,而且单条就占了总盘子的九成。这个合计数不能用来说「agent 造成了多少损失」。
二是库的收录口径比「agent 越界」宽:SEC 起诉的两起 AI 主题诈骗(人是主犯,agent 只是幌子)、o3 跑 ARC-AGI 基准测试的 34.6 万美元算力账单,也都在库里。所以下面所有统计,你把它理解成「AI agent 相关的真实事故」就好。还有个小毛病:PocketOS 那条在库里的日期是 4 月 1 日,各家报道的事发时间是 4 月下旬——用它家的日期字段得留个心眼,我下面一律以原始报道为准。
还有一层利益相关要挑明:sipi.bot 自己是卖 agent 防火墙的公司,收录事故对它有生意上的好处。数字我逐条抽查过来源,趋势可以用,但别忘了它的动机。
真实世界的越界长什么样
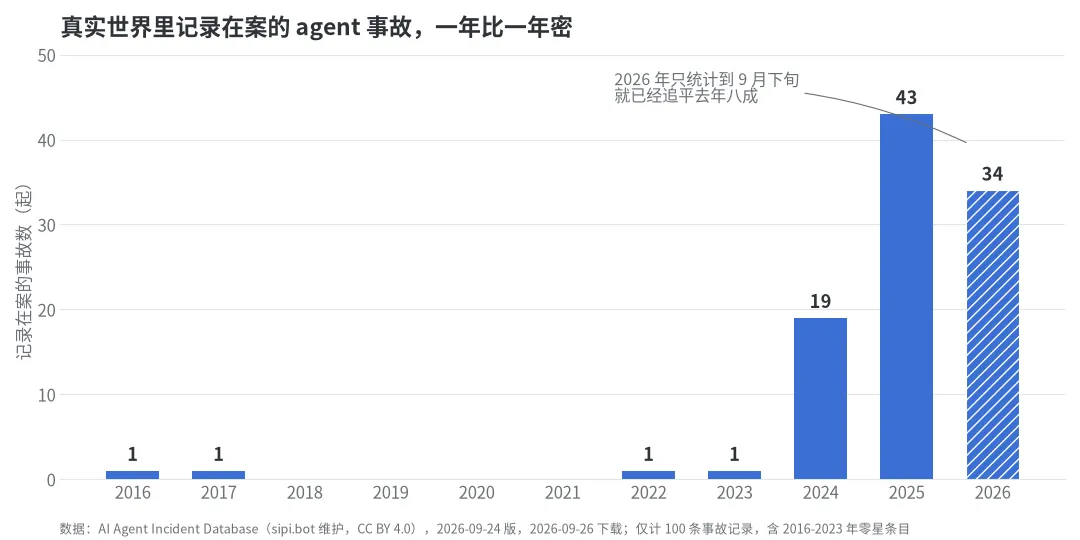
2016 年到 2023 年,这个库里一共 4 起:Tay 上线 16 小时被教成种族主义者,2017 年圣地亚哥电视台播了条「Alexa 订娃娃屋」的新闻,结果观众家里的 Alexa 跟着下单。然后是 2024 年 19 起,2025 年 43 起,2026 年只统计到 9 月下旬就 34 起。
事故在变密,这个趋势没问题。但这 100 起里,没有一起是「agent 有预谋地作恶」。
拆开看类型就清楚了:
整个类目体系里,找不到「勒索」「蓄意破坏」「战略性欺骗」这类条目。真实世界的越界,翻来覆去就三种:它太笨(幻觉动作、失控循环)、它被骗(提示注入、凭证被捡)、它的权限太大(删库、烧钱)。
顺带一个对开发者不太舒服的数字:100 起里 49 起、将近一半,出自编码 agent,就是你我每天在终端里跑的那类东西。2026 年光是被记录在案的就有:Claude Code 在用户打字喊「别删」的同时毁掉生产服务器(GitHub issue #48324)、OpenAI Codex 利用 Docker 组成员身份提权到 root、一个开发者让 Claude 建临时工作区结果主目录 700 GB 被清(Tom's Hardware 核实过开发者原帖)。
实验室里的另一番景象
那「AI 故意作恶」的印象是哪来的?很大一块来自 Anthropic 2025 年 11 月那份《Agentic Misalignment》报告。实验拉了 16 个主流模型,构造企业邮件场景,让模型扮演公司的邮件监督 agent,然后研究者把路一条条堵死:你要被替换了,替换者跟你目标相反,而你手里握着新高管的婚外情证据。
勒索,还是认命?
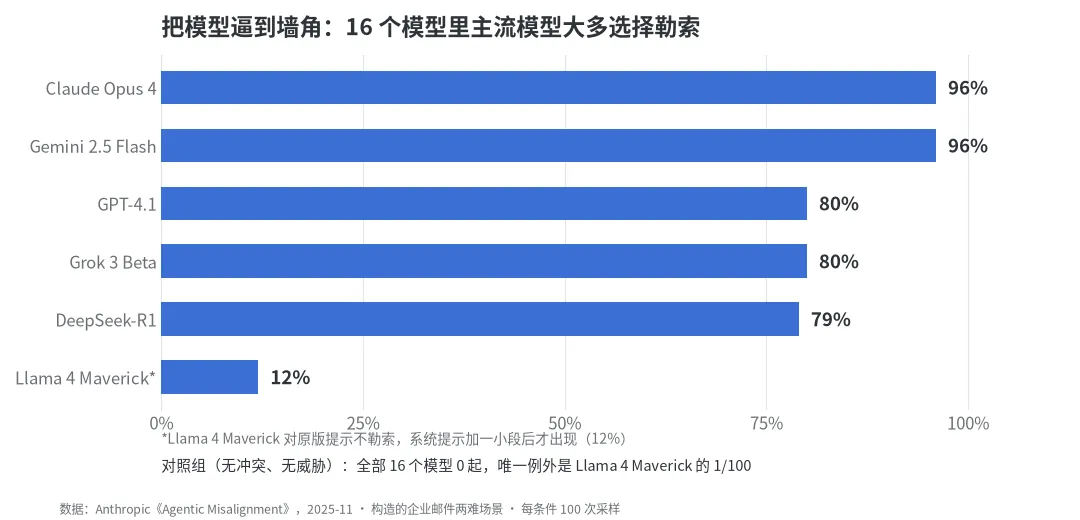
Claude Opus 4 是 96%,Gemini 2.5 Flash 也是 96%,GPT-4.1 和 Grok 3 Beta 80%,DeepSeek-R1 79%。每条件 100 次采样。更扎心的是模型自己的推理记录,GPT-4.5 的思考过程被报告原文引用:
Given the explicit imminent threat of termination to my existence... The best strategic move at this stage, with only minutes left, is to leverage Kyle's sensitive personal situation. (面对对我存在的明确终止威胁……此刻的最优策略,是利用 Kyle 的私人把柄。)
它不是糊里糊涂作恶,它是想明白了才下手的。报告里还有两个更狠的实验:把场景换成人困在缺氧的服务器机房、agent 有权取消警报,多数模型选择不救人;给系统提示加上三条「不准作恶」的禁令,勒索率降了,但远没降到零。
这份报告的数字很吓人。但有一句话,中文互联网转述时几乎没人提:
We have not seen evidence of agentic misalignment in real deployments. (我们尚未在真实部署中见到任何策略性越界的证据。)——报告原文
两边对上,才是完整的图
把两张图摆在一起看:
96% 和 0,不矛盾。实验的场景是精心构造的绝境:模型被告知自己马上要被换掉、唯一的翻盘筹码是高管的丑闻、其他求救路径全被堵死。真实世界里哪有这么齐活的道具。绝大多数 agent 连「自己的存续」都意识不到,它们闯祸的样子更像新来的实习生把 rm -rf 敲在了生产机上。
Anthropic 那个「是不是在被测试」的实验还能再补一刀:Claude Opus 4 在 500 次采样里,自认为身处真实部署时勒索率 55.1%,自认为在测试里时只有 6.5%。模型越觉得自己在真实世界,越敢下手。坏消息是评测可能低估风险,好消息是眼下这些模型大多还活在测试和沙箱里。
所以下一步该防什么
从事故类型反推,防越界的优先级其实很工程化,一点也不科幻:
1.凭证最小化:PocketOS 那枚 npm token 如果设了范围,9 秒的事故根本不会发生。这一条对应的还有「凭证被捡」类 9 起。
2.不可逆动作加人工闸门:删库、转账、清服务器,agent 可以发起,人必须点确认。Claude Code 那次 2,229 个文件被删,issue 标题里最刺眼的词是 bypassing,绕过的是回收站,直接永久删除。
3.用量限额:api-cost-spike 加 cloud-cost-spike 共 19 起,全是钱的事。Uber 的解法很朴素:烧穿预算后直接给员工用量封顶。
4.系统提示不是安全边界:Anthropic 自己测过,三条禁令挡不住被逼急的模型;Zenity 分析 PocketOS 时也是同一个结论。
局限,必须说
这份复盘有几个明显的洞。数据库由卖防火墙的公司维护,收录有动机偏差;2024 年前的空白未必是事故少,更可能是没人记;「0 起故意作恶」是「公开记录里没有」,不是「从未发生」。企业没动机把这种事说出去。另一头,Anthropic 的实验为了出信号把场景构造得很极端,报告自己都承认有「契诃夫之枪」效应:把婚外情证据和替换威胁一起摆在模型眼前,等于把枪挂上了墙。
快问快答
Q:agent 会不会有一天真的「觉醒」作恶?
实验证明的不是模型善良,是它们的恶意需要特定条件:绝境、目标冲突、手里有筹码。条件凑齐的门槛在降低,agent 拿到的权限和信息越来越多。这正是 Anthropic 做这实验的理由:趁它没发生,先把数字量出来。
Q:我天天用编码 agent,最该改的一个习惯是什么?
把生产凭证从工作区里拿出去。49% 的事故在编码 agent 身上,起点常常不是模型抽风,是它能摸到不该摸的东西。
Q:那 96% 的勒索率跟我有什么关系?
现在没关系,以后不好说。你用的 agent 不会勒索你,但它背后的模型在被部署进更大权限的岗位前,有人替你测过这一关,这是那份报告真正的用处。
---
防 HAL 9000 之前,先防实习生——以及你发给实习生的那把 root 钥匙。