ARTICLE · 1081953
让AI少胡说八道的办法,不是换模型,是给它配个书柜
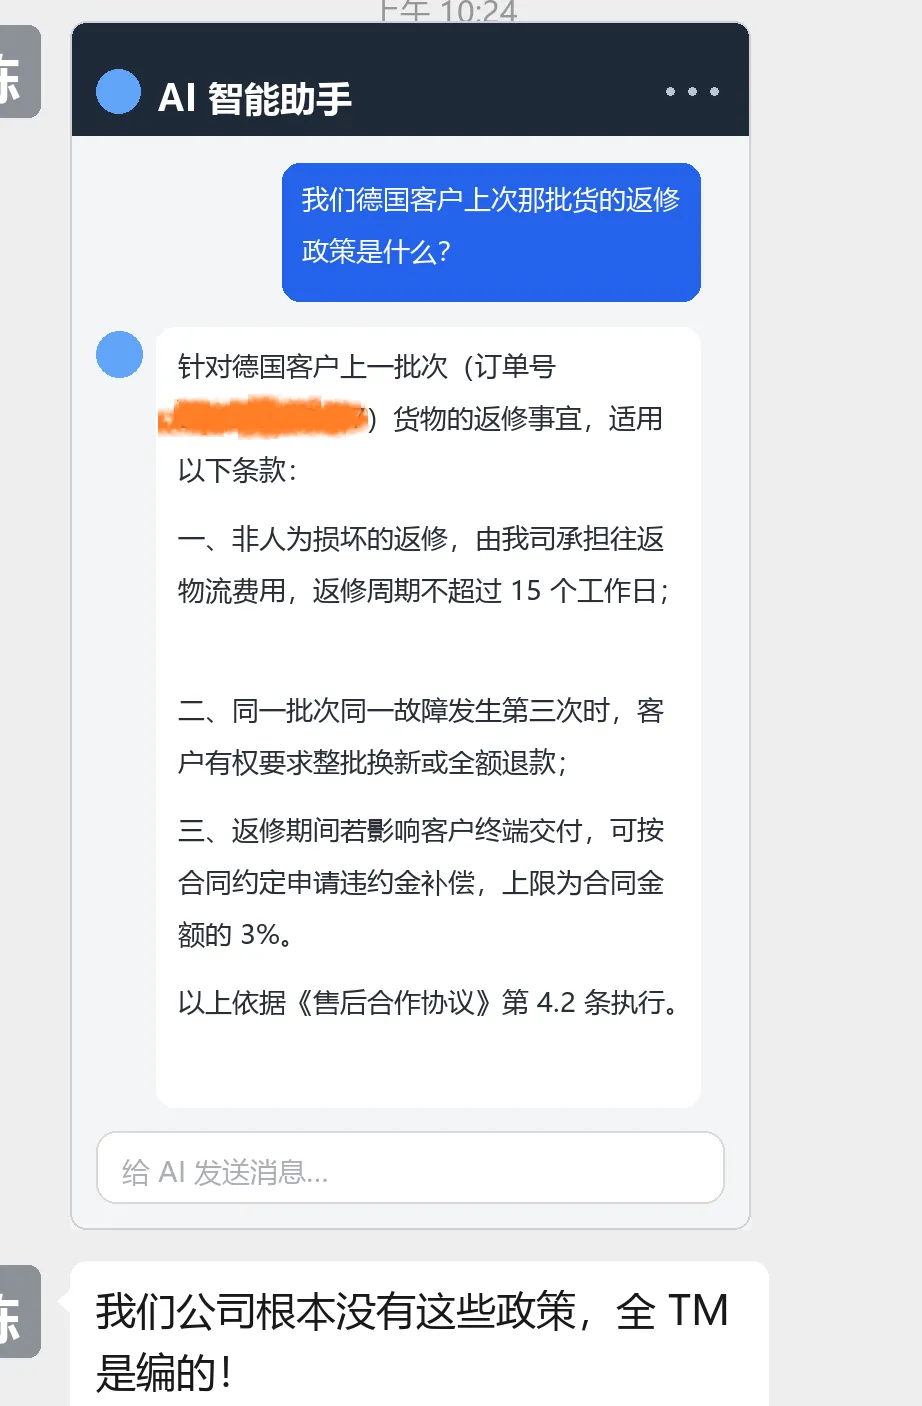
AI 秒回,条理清晰,三条政策列得整整齐齐,语气专业得像是法务写的。
只有一个问题:他公司根本没有这些政策。全TM是它编的啊。
他很崩溃:“它怎么能这么理直气壮地瞎说?”
我说:“它不是瞎说,它是在闭卷考试。”
而解决这件事的办法,简单到有点好笑——不是换个更贵的模型,是给它配个书柜,把产品材料放进去。
这个书柜有个正经名字,叫知识库。今天这篇,把它讲透。
01 它不是笨,它是在“闭卷考试”
我们先把一件事说清楚:AI 为什么会答错?
不是算力不够,也不是模型不行。是它的工作方式和你想的不一样。
大模型回答你的时候,靠的是训练阶段“读进去”的东西——全互联网的公开文本。这个规模确实大到吓人,但它有三个致命的边界:
第一,它不知道你公司的事。你的产品口径、报价规则、客户历史、上次开会定了什么,从来没进过它的训练集。
第二,它有“毕业日期”。模型训练完成的那一刻就封版了。之后发生的事——新政策、新产品、新财报——它一无所知。你问今天的事,它在用去年的记忆回答。
第三,也是最要命的一条:它不会说“我不知道”。这是最反直觉的一点。人被问到盲区会说“这个我不确定”,但大模型的任务是“接着往下写最可能的下一个字”。于是遇到不知道的事,它会生成一段语法通顺、语气笃定、逻辑自洽,但完全是编的内容。
这就是行业里说的“AI幻觉”。
所以记住这个判断:AI 答错,通常不是能力问题,是信息来源问题。
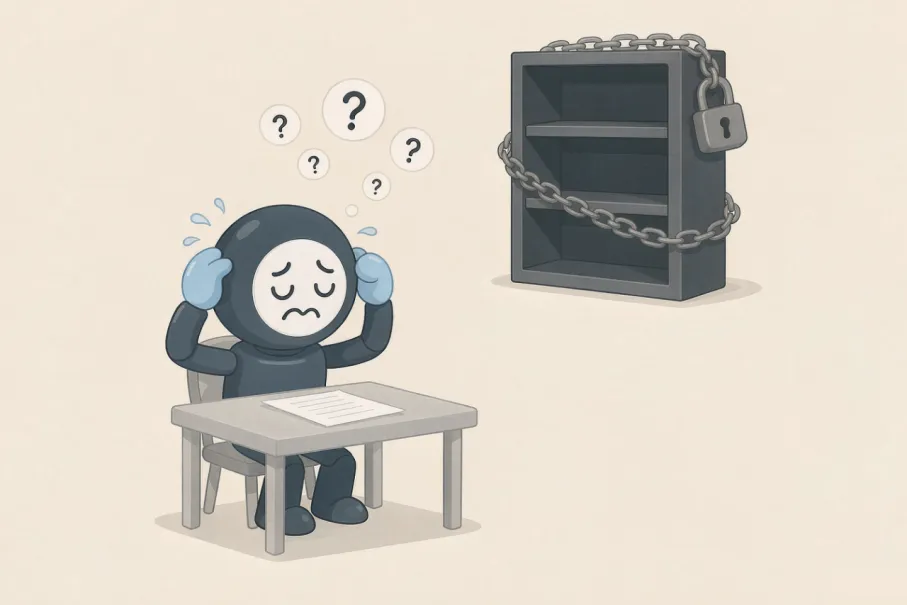
图01|AI 的三个边界:不知道你公司的事、有“毕业日期”、不会说“我不知道”
02知识库,就是把闭卷改成开卷
如果问题出在“它只能凭记忆”,解法就很直接了——给它书。
知识库,说白了就是:你给AI 配的一个专属书柜。
书柜里装的不是互联网上的通用知识,而是你自己的东西:
·产品手册、技术规格、常见问题答复口径
·会议纪要、项目复盘、历史方案
·客户档案、合同模板、过往报价
·公司制度、流程规范、培训材料
书柜搭好之后,AI 的行为模式变了:
以前(没知识库) | 现在(有知识库) | |
依据 | 训练时的记忆 | 你提供的材料 |
遇到盲区 | 硬编一段 | 说“ 库里查不到 ” |
答完 | 没有出处 | 标注来自哪份文件 |
时效性 | 停在训练截止日 | 你今天传,它今天知道 |
一个是闭卷,一个是开卷。
这个转变带来的差别,大到不像是同一个产品。
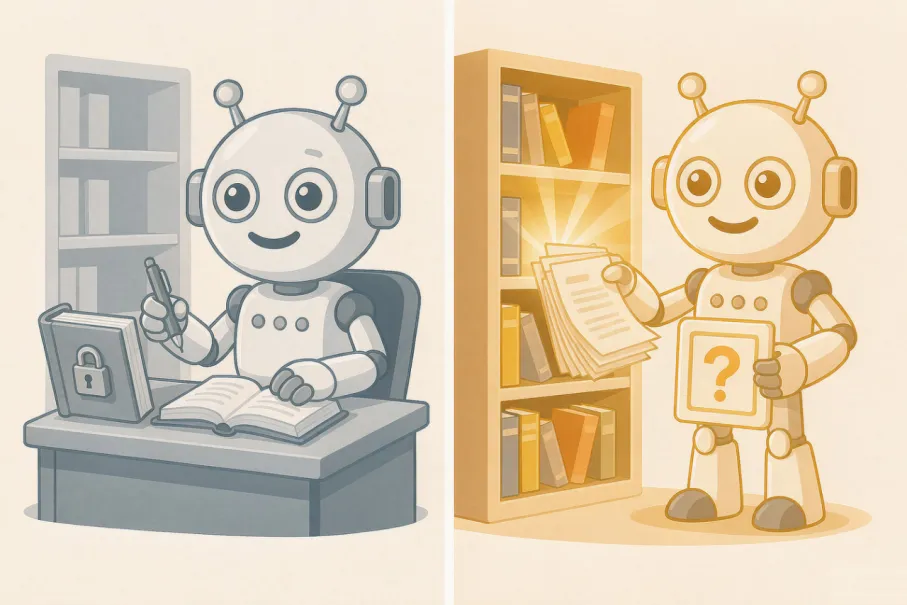
图02|同样是回答问题:左边是闭卷(凭记忆硬答),右边是开卷(照着材料答,还给出处)
03 拆开看:每次回答前,它偷偷干了五件事
听起来很智能,流程其实朴素得很。一共五步:
第一步,你提问。比如:“德国客户那批货的返修怎么算?”
第二步,把问题变成线索。系统把你的大白话提炼成检索用的关键信息。这步很关键——它决定了后面能不能翻对。
第三步,去书柜里翻。拿着线索,回你的资料库里找最相关的几段,而不是整篇。找的是片段,不是文件。
第四步,把「问题+ 材料」一起交给 AI。注意这一步是全文的核心:AI 看到的不是你那句孤零零的问题,而是问题下面压着一叠资料。
第五步,基于材料作答,并告诉你出处。它照着材料回答,并且能说明这段依据来自哪份文件的哪一部分。你可以点过去核对。
这套流程有个专业名字:RAG,Retrieval-Augmented Generation,检索增强生成。
别被术语吓着,说人话就四个字:先找,再答。
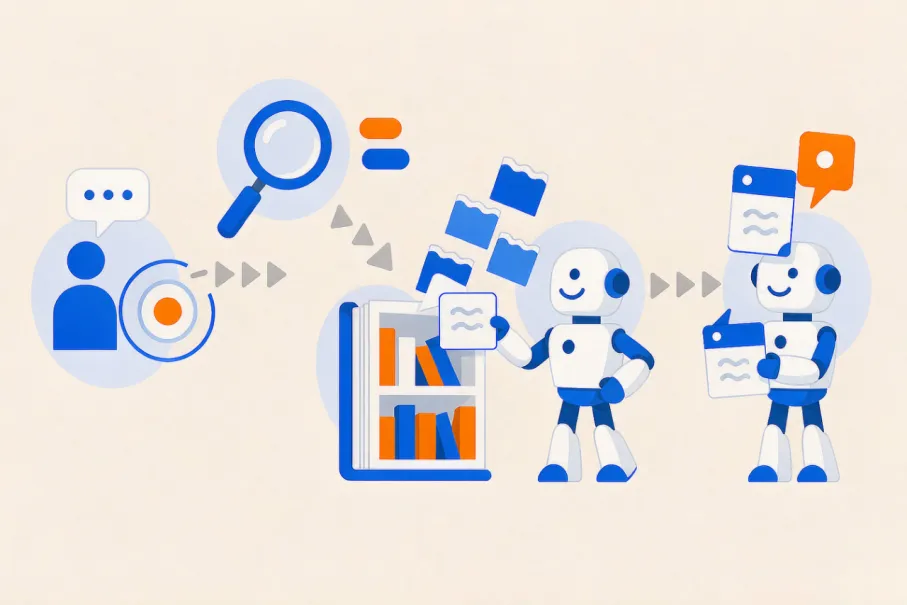
图03|每次回答前的五步:提问→ 提炼线索→ 去书柜里翻→ 问题+材料一起交给AI → 带着出处作答
04所以它对 AI 到底有多重要?三层
知识库的价值,可以从三个层面理解。越往下越值钱。
一层:补记忆—— 接上训练截止之后的世界
模型有“毕业日”,知识库没有。
今天上传的新政策,五分钟后它就能用上。知识库把AI 的时间线,从“过去某刻”拉到了“现在”。
这一层解决的是“信息太新”的问题。
二层:补边界—— 让它知道你家的私事
通用模型再强,也不知道你们公司上季度哪个客户投诉过什么。
知识库把公共知识和你的私有知识缝合在一起。它让AI 从一个“什么都懂一点的路人”,变成一个“在你公司待了三年的老员工”。
这一层解决的是“信息太私”的问题——这也是对企业最有价值的一层。
三层:补可信—— 从“它说的”变成“有据可查”
这是被低估的一层。
一旦答案能标出处,人和AI 的关系就变了:你不再是“信不信它”的问题,而是“能不能核对”的问题。
在企业场景里,这一条几乎是决定性的。不能核对的答案,在业务上等于没有答案。
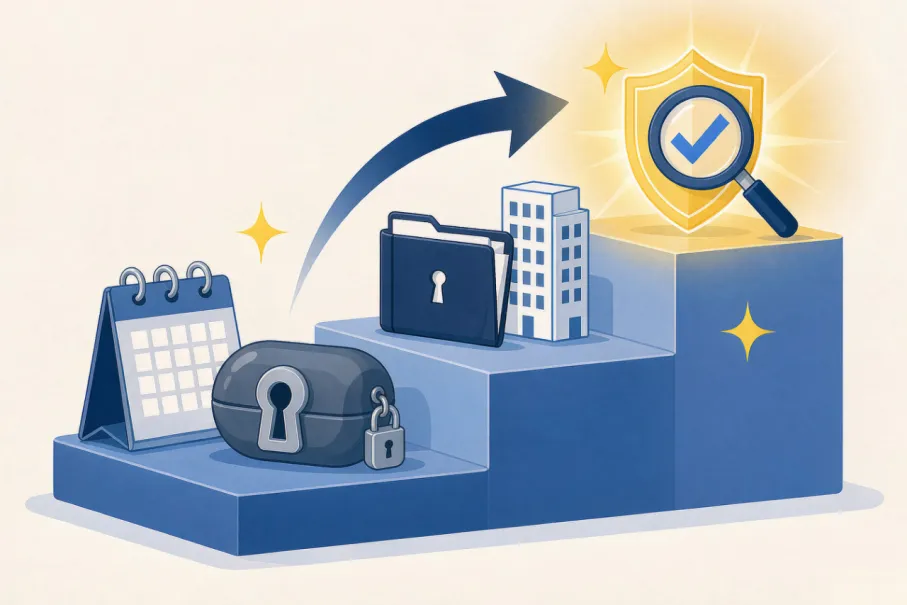
图04|三层价值,越往下越值钱:补记忆(时效)→ 补边界(私有)→ 补可信(可核对)
05一句话定位:大脑和书柜,各管一摊
到这里可以给知识库下一个准确定位了:
大模型的大脑负责理解和表达,知识库负责提供事实和口径。
一个管“会不会说话”,一个管“说得对不对”。
拆得更细一点:
大模型(大脑) | 知识库(书柜) | |
本质 | 训练出来的通用能力 | 你上传的私有材料 |
负责 | 理解、推理、组织语言 | 提供事实、数据、口径 |
更新方式 | 重新训练,成本高周期长 | 随时传、随时改、随时删 |
时效性 | 有训练截止日 | 永远是你给的最新版 |
出问题时 | 编得通顺但错 | 找不到或找错段落 |
归属 | 厂商的 | 你的资产 |
请注意最后一行。
模型是厂商的,所有人买的都一样。知识库是你的,别人拿不走。
当大家用着同样的模型时,决定AI 好不好用的,就是这个书柜里的东西。这是你在AI 时代少数能真正沉淀下来的资产。
06 (搭建知识库)三个坑,掉进去的人特别多
讲完价值,讲讲常见的翻车姿势。
坑一:以为传了文档,AI 就“学会”了
前面说过,再说一遍,因为这是最深的一个误解。
上传= 查阅,不是训练。
这意味着:AI 不会因此变聪明,它只是答题时有东西可翻。文档一删,当场失忆。
所以别指望靠传文档把一个弱模型变成强模型。它补的是信息,不是智力。
坑二:以为文档塞得越多越好
很多人的第一反应是把公司网盘整个拖进去。
结果更差了。
因为检索是在一堆材料里找最相关的几段。过期版本、作废方案、重复的旧稿混在一起,它会翻到旧的那版,还翻得理直气壮。
宁可少而准。一份准确的最新手册,价值远高于一百份历史文件。
坑三:以为有了知识库就不用人审核了
知识库解决的是“有没有依据”,不解决“这个依据本身对不对”。
如果库里的材料本身是错的,AI 会非常忠诚地照着错误材料回答,还附赠一个出处链接。
它能保证忠诚,不保证正确。
所以:重要结论,人得看一眼,最好仔细审核下。
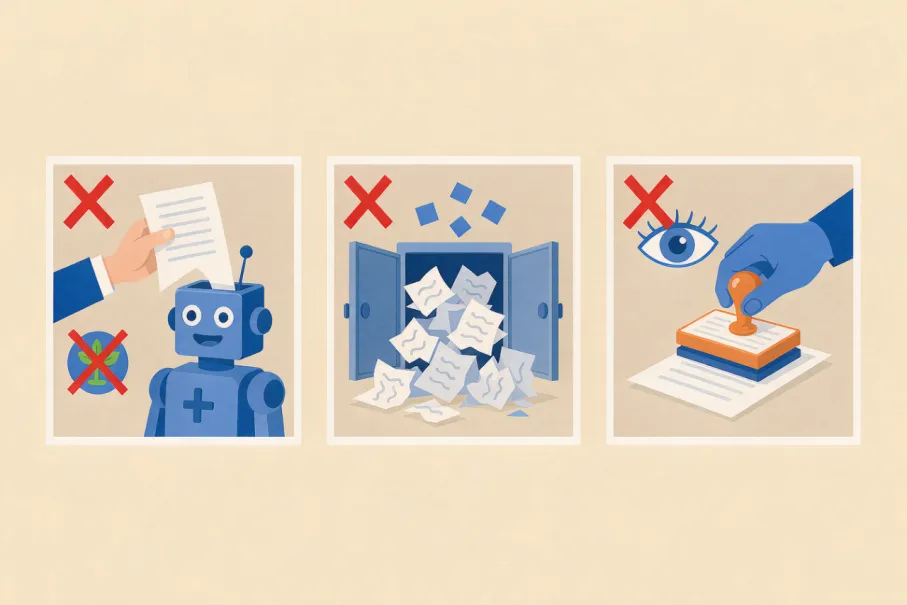
图05|三个高频误区:以为传了就会了、以为越多越好、以为不用人审
07如果你想动手,第一步别急着选工具
这是最实用的一段。
很多公司上来就问“买哪个知识库产品”,顺序反了。
建议的起手式是三步:
第一步,先建一个文件夹。挑一个最痛的场景——比如客服常见问题,或者新人入职问答。把这个问题域内准确的、最新的、不重复的材料归拢到一起。十份就够开始。
第二步,用现成的工具先跑起来。现在主流AI 平台基本都内置了知识库或文件上传能力。别搞RAG 工程,先传五份文档,用二十个真实问题去测。
第三步,从答错的题往回修。AI 答错,通常只有两个原因:库里没有,或者库里有但没翻到。前者补材料,后者改材料的写法(标题写清楚、内容别太长、一个文档讲一件事)。
跑顺这三个以前,别谈平台、别谈私有化部署、别谈向量数据库。
知识库不是买来的,是喂出来的。它的价值不在第一天,在第180 天。
08最后,留个问题给你
如果AI 每次回答都能准确告诉你“答案出自哪份文件第几页”,你会先把它用在什么地方?
是线上客户服务、新人入职培训、还是投标应答,还是你自己的学习笔记呢?
评论区聊聊,我挑个最典型的场景,下一篇拆给大家看。
记得——先别换模型,先给它搭书柜。