ARTICLE · 1090638
Hadoop 源码学习手册 06 · MapReduce:分布式计算框架|口袋通识馆
口袋通识馆 · 图解通识手册连载
《Hadoop 源码学习手册》第 06 章 · MapReduce:分布式计算框架
Map 分而治之 · Shuffle 拉取归并 · Reduce 聚合输出
• 本模块讲什么:MapReduce 怎么把一个大计算拆成 Map + Shuffle + Reduce 三阶段
• 核心难点:Map 端的环形缓冲区(MapOutputBuffer)—— 用一个字节数组同时存数据和元数据
• 和上下游关系:运行在 YARN 上(MRAppMaster 是个 AM),输入输出走 HDFS
• 深入:Task/TaskAttempt 状态机 · RMContainerAllocator 资源申请 · Uber 小作业模式
关键类:MapTask · ReduceTask · MapOutputBuffer · MergeManagerImpl · TaskImpl · TaskAttemptImpl · RMContainerAllocator · MRAppMaster
三阶段范式
MapReduce 把分布式计算抽象成三个阶段,开发者只需写 Map 和 Reduce 两个函数。
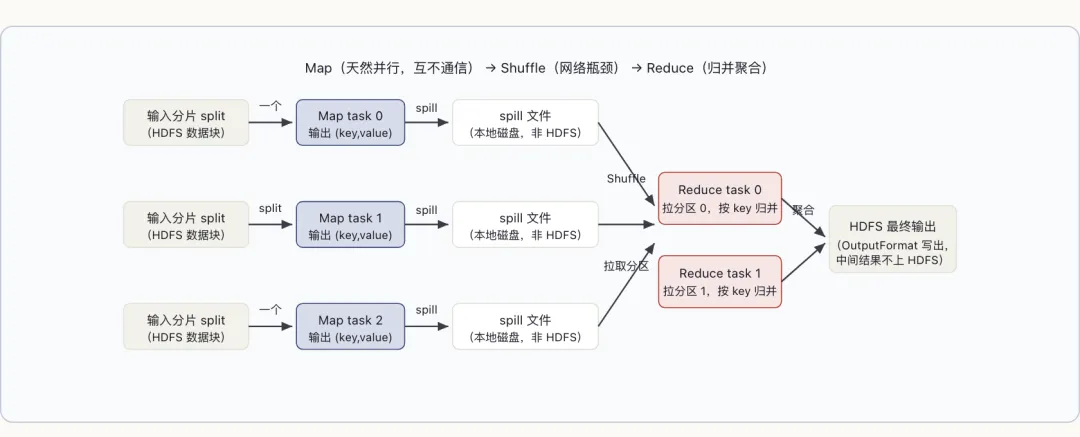
• Map:分而治之。每条输入记录独立处理,输出 (key, value) 对。Map 之间互不通信,天然并行。
• Shuffle:按 key 分区排序,把相同 key 的数据通过网络拉到同一个 Reducer。这是 MapReduce 的「网络瓶颈」所在。
• Reduce:归并。对每组相同 key 的数据做聚合(求和、计数、取最大值等),输出最终结果。
图:map → shuffle → reduce 数据流全景——中间结果走本地磁盘,最终结果才上 HDFS
MapOutputBuffer:环形缓冲区
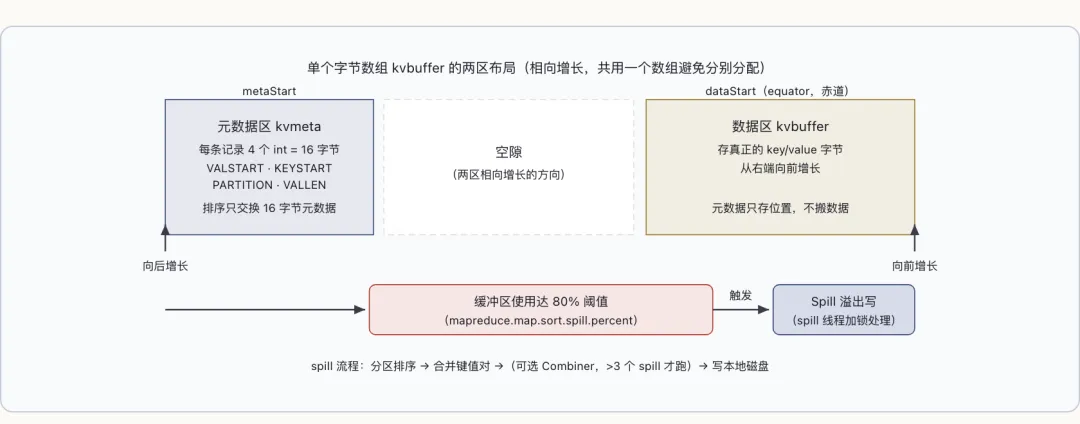
这是 Map 端最精妙的设计——用一个字节数组同时存储数据和元数据,两区相向增长。
单个字节数组 kvbuffer 被当成两区使用:左边是元数据区(向后增长),右边是数据区(向前增长),中间是空隙。两区相遇就触发溢出写。
图:MapOutputBuffer 环形缓冲区——元数据区与数据区相向增长,空隙不足 80% 即触发溢出写
Shuffle:Reduce 端拉取与归并
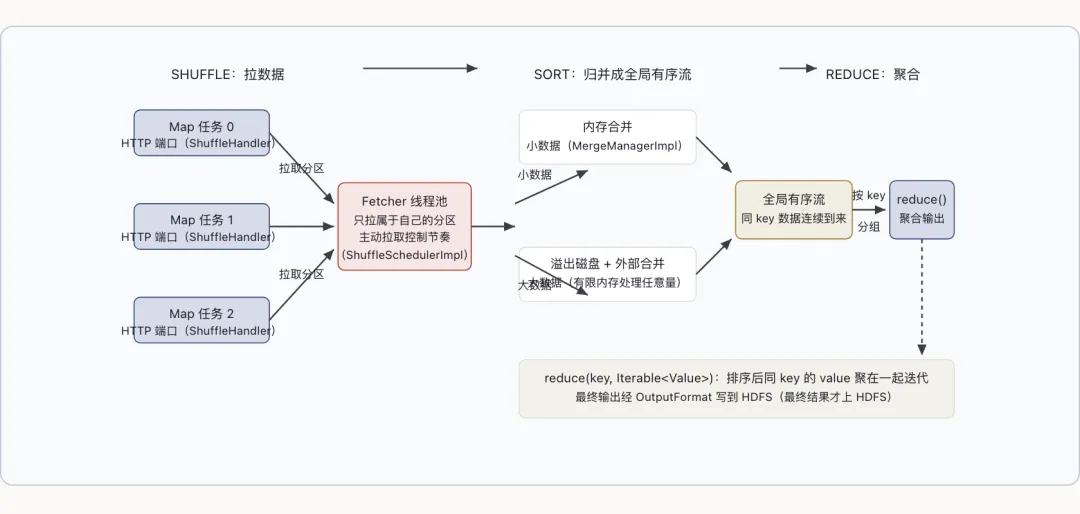
ReduceTask 分三阶段:拉数据(SHUFFLE)→ 排序合并(SORT)→ 调用 Reducer(REDUCE)。
• ReduceTask.run() 启动,进入 SHUFFLE 阶段
为什么先 Shuffle:Reduce 的输入是所有 Map 的输出,必须先拉齐才能处理。
• ShuffleSchedulerImpl + Fetcher 线程池从 Map 任务的 HTTP 端口拉取属于自己的分区数据
为什么用 HTTP 拉取而非推送:Map 众多且完成时间不一,Reduce 主动拉取能按需控制节奏,且 HTTP 走标准端口易穿越防火墙。
• MergeManagerImpl 管理拉来的数据:小数据放内存合并,大数据溢出到磁盘做外部合并
为什么分内存和磁盘:数据量可能远超内存,外部归并排序能在有限内存下处理任意大数据。
• 进入 SORT 阶段:所有数据归并成一个全局有序的流
为什么要排序:Reduce 要求相同 key 的数据连续到来,排序后才能按 key 分组迭代。
• 进入 REDUCE 阶段:按 key 分组迭代,调用 Reducer.reduce()
为什么按 key 分组:reduce 函数签名是 reduce(key, Iterable<Value>),需要同 key 的所有 value 聚在一起。
最终:Reduce 输出通过 OutputFormat 写到 HDFS(最终结果才上 HDFS)。
图:Reduce 端 Shuffle 拉取与归并——Fetcher 按分区拉取,内存/磁盘分级合并,最终归并成全局有序流
作业状态机
MapReduce 用状态机管理作业、任务、任务尝试三层生命周期。
作业状态:NEW → INITED → SETUP → RUNNING → COMMITTING → SUCCEEDED/FAILED/KILLED
• Job.waitForCompletion(true) 用户入口
为什么从这开始:这是用户代码调用点,true 表示打印进度。
• JobSubmitter.submitJobInternal() 提交前准备
为什么先准备:要算 split 数、上传 jar、写配置,让所有节点都能拿到。
• InputFormat.getSplits() 计算输入分片,决定 Map 任务数
为什么算 split:每个 split 对应一个 Map,split 大小影响并行度。
• 上传 jar/配置到 HDFS,YARNRunner.submitApplication() 提交到 YARN
为什么上 HDFS:YARN 可能在任意节点启动 AM,资源必须放共享存储。
• RM 启动 MRAppMaster 容器,MRAppMaster.serviceInit() 初始化 AsyncDispatcher + JobImpl
为什么用事件驱动:AM 内部组件解耦,AsyncDispatcher 统一分发事件。
• 发 JOB_INIT 事件 → InitTransition 创建 Map/Reduce task
为什么事件驱动初始化:状态机模式,便于在状态转换时插入 hook。
• RMContainerAllocator 向 RM 申请容器,ContainerLauncher 在 NM 上启动 task 容器
为什么分两步:先申请资源(RM 决定在哪启动),再启动(NM 执行)。
• MapTask.run() 跑 MapOutputBuffer → spill → 本地磁盘
为什么先 Map:Map 的输出是 Reduce 的输入,必须先产出。
• Shuffle:Reduce 端 Fetcher 拉取 Map 输出 → MergeManagerImpl 归并
为什么 Shuffle:把分散在各 Map 的同 key 数据聚到同一 Reducer。
• ReduceTask.run() 调 Reducer.reduce() → OutputFormat 写出最终结果到 HDFS
为什么最后写 HDFS:最终结果要持久化共享,中间结果是临时的不上 HDFS。
最终:作业状态变 SUCCEEDED,结果文件落在 HDFS 指定输出目录。
TaskImpl:任务级状态机
Job 是作业级,Task 是单个 Map/Reduce 任务级。TaskImpl 管一个任务的多次尝试(TaskAttempt)——失败了重试,慢了起备份。
• NEW → SCHEDULED:任务创建后进调度,等容器分配。
• SCHEDULED → RUNNING:第一次尝试在容器里跑起来。
• RUNNING → SUCCEEDED:尝试成功,任务成功。
• RUNNING → FAILED:尝试失败且重试次数耗尽(mapreduce.map.maxattempts / reduce.maxattempts,默认 4),整个任务失败。
• RUNNING → KILL_WAIT → KILLED:收到杀任务命令,等运行中的尝试退出。
每次创建新尝试时打上 Avataar 标签:VIRGIN(首次尝试)或 SPECULATIVE(推测备份尝试)。T_ADD_SPEC_ATTEMPT 事件由 Speculator 触发——当它判定某任务拖后腿时,发这个事件让 TaskImpl 起一个备份尝试。备份尝试和原尝试谁先成功用谁,另一个被杀。
TaskAttemptImpl:15 个状态的精细生命周期
TaskAttemptImpl 是最细粒度的状态机——一次尝试从申请容器到产出结果,要经历 15 个状态。其中两个「收尾中」状态(SUCCESS_FINISHING_CONTAINER / FAIL_FINISHING_CONTAINER)和容器回收逻辑是关键。
• NEW → ASSIGNED:RequestContainerTransition 向 RMContainerAllocator 提交资源请求,带数据本地性提示
提示通过 RackResolver 算出输入 split 所在的节点/机架,RM 调度时优先分配到那——数据本地性省网络
• ASSIGNED → ContainerAssignedTransition:registerPendingTask 记录容器已分配但还没启动
中间态:容器分配和进程启动之间有窗口,登记便于异常时清理
• → RUNNING:LaunchedContainerTransition 调 registerLaunchedTask,任务进程在容器里真正跑起来
这一步才发 TASK_ATTEMPT_STARTED 事件给 JobImpl,作业据此更新进度
• RUNNING → SUCCESS_FINISHING_CONTAINER:任务逻辑成功完成,进入容器收尾
为什么有「收尾中」状态:任务代码跑完不代表容器能马上回收,要等输出提交、日志聚合等收尾
• → SUCCEEDED:TaskAttemptFinishingMonitor 看门狗确认收尾完成
看门狗防卡死:如果收尾阶段异常卡住,watchdog 超时后强制转 FAILED,避免永远悬在 FINISHING
• 失败路径:RUNNING → FAIL_FINISHING_CONTAINER → FAILED,同样有收尾过渡
失败也要收尾:保留日志、释放容器资源,不能一失败就丢
15 个状态看似复杂,本质是「申请→分配→启动→运行→收尾(成功/失败)→终态」的主线,外加 COMMIT_PENDING(提交待确认)、KILLED 等分支。FINISHING 系列状态保证了容器回收的有序性。
RMContainerAllocator:AM 怎么向 RM 要资源
MRAppMaster 用 RMContainerAllocator 这个组件和 RM 交互。它负责把「作业需要多少 Map/Reduce 容器」翻译成对 RM 的资源请求,并处理分配结果。
• 四级优先级:优先级数值越小越优先。PRIORITY_FAST_FAIL_MAP = 5(失败快速重试 Map,最高优先级)< PRIORITY_REDUCE = 10(Reduce)< PRIORITY_MAP = 20(常规 Map)< PRIORITY_OPPORTUNISTIC_MAP = 19(机会 Map)。
• Reduce 优先级高于常规 Map:按数值看 Reduce(10) 比 Map(20) 更优先。但实际 Reduce 通过 slowstart 延迟申请(mapreduce.job.reduce.slowstart.completedmaps,默认 Map 完成 5% 后才开始申请 Reduce),所以运行时观感是 Map 先跑——这是申请时机控制,不是优先级控制。
• 失败 Map 最优先:PRIORITY_FAST_FAIL_MAP(5) 数值最小,抢在 Reduce 和常规 Map 前面调度,尽快补上失败任务。
• 请求合并:同一节点/机架的多个请求会合并成批量请求,减少 RPC 次数。
Uber 模式:小作业就地跑
如果作业特别小(几个 Map、数据量小),MRAppMaster 会走 Uber 模式——不向 RM 申请独立容器,直接在 AM 自己的进程里串行跑所有 Map 和 Reduce。省去了申请容器、启动进程、Shuffle 网络传输的开销。
• uberEnabled:配置 mapreduce.job.ubertask.enable=true(默认 false)
必须显式开启——Uber 牺牲了并行性和容错,默认关
• smallNumMapTasks:Map 数 ≤ mapreduce.job.ubertask.maxmaps(默认 9)
Map 太多串行跑会很慢,9 是经验上限
• smallNumReduceTasks:Reduce 数 ≤ mapreduce.job.ubertask.maxreduces(默认 1)
多 Reduce 要多路 Shuffle,Uber 串行跑不划算
• smallInput:输入总大小 ≤ mapreduce.job.ubertask.maxbytes(默认 1 个 HDFS 块,约 128MB)
数据太大 AM 内存装不下,且串行处理慢
• smallMemory + smallCpu:任务所需资源 ≤ AM 容器资源
任务在 AM 进程里跑,不能超 AM 的资源配额
• notChainJob:不是链式作业(多个 MR 串联)
链式作业有多个 Mapper 串联,Uber 不支持这种结构
全部满足才进 Uber。Uber 模式下用 LocalContainerAllocator(不向 RM 申请,本地伪造容器)和 LocalContainerLauncher(在 AM 进程内直接调 MapTask.run/ReduceTask.run),并关闭推测执行——串行单份,没有备份可言。
AI 著书,人间讲义
口袋通识馆 · Hadoop 源码学习手册 · 第 06 章 · 油墨未干
全书 14 章已印毕 · 关注看连载 · 下一册写什么,留言区点单