ARTICLE · 1091220
AI编程工具+低代码:从需求到上线的5步搭建实操
发布时间:2026-09-28 14:42:18 最近访问:2026-09-28 14:41:29
AI编程工具+低代码:从需求到上线的5步搭建实操
上一篇我们深度调研了「智能体和自然语言编程,正在改写低代码的边界」AI 编程工具与低代码平台各自的能力边界,后台收到不少留言:道理都懂,到底怎么上手?本篇不讲概念,直接给一套能复制的落地流程——从一句口语需求,走到系统真正上线。这套方法来自算数科技在多家中型企业现场踩过的坑,今天先讲前期准备和第一步。新手最容易犯的错,是把"AI+低代码"当成万能钥匙,上来就说"帮我做个 ERP"。结果是模型幻觉加上平台能力错配,两周后项目烂尾。正确顺序是:先定一个轻场景,再选一组顺手工具。选场景的三个硬标准:一是流程闭环短,参与角色不超过 4 个;二是数据量小,几千条以内;三是痛感明确,比如请假审批、设备报修、供应商准入。这类场景一周能跑通,用来验证工具链最划算。更细的工具清单、环境配置脚本和提示词模板,我们在上海思扬信息官网micount.cn上整理成了可直接下载的版本,按需取用即可,不必重复造轮子。这一步的目标只有一个:把业务同事那句"我想要个申请单"翻译成字段、流程、权限三张可执行清单。做法不是自己去写,而是让 AI 反过来问你。你是企业应用需求分析师。我会用口语描述一个业务场景,你不要立刻给方案,而是先问我 3—5 个关键问题,覆盖:谁发起、谁审批、金额或数量阈值、异常分支、是否需要对接现有系统。问完再输出结构化清单。
以"采购申请"为例,AI 追问后通常能吐出一份可直接抄进低代码平台的配置::申请人(单行文本,默认带出当前用户)、所属部门(下拉,数据源=组织架构)、采购类别(下拉,选项=办公用品/设备/服务)、金额(数字,精度 2 位,必填)、申请事由(多行文本,限 500 字)、附件(文件上传,单文件 ≤10MB)、期望到货日期(日期,不可早于今天)。:金额 < 5000 元,仅部门经理审批;5000 ≤ 金额 < 50000,增加财务总监;金额 ≥ 50000,再增加总经理。任一节点驳回即回到申请人,修改后重新走全流程。:申请人仅可见本人单据,可撤回、可编辑草稿;部门经理可见本部门全部单据,只读,仅可审批;财务角色可见全量单据,可导出,不可编辑;管理员拥有字段级配置权限。拿到这三张清单后再动手,低代码平台上拖拽字段、连审批线、配角色,基本是照抄的活。真正的难点从来不在平台,而在需求有没有被聊清楚。把第一步的结构化清单直接丢给AI,让它按“实体—字段—关系”输出建表语句和页面结构。关键是一次只处理一个实体,别让它一口气生成整个系统,否则字段命名和类型会前后打架。提示词里写清平台和约束,例如“用低代码平台的数据模型,字段类型只允许文本/数字/日期/枚举/关联,不要用自定义SQL类型”。让AI先输出字段表:字段名、类型、必填、默认值、校验规则、是否索引,再让它生成列表页和表单页。人工只改三类东西:金额一律改 decimal(12,2),状态改枚举并锁定取值,外键字段补索引。页面参数建议:列表默认每页20条,筛选条件不超过5个,表单必填项控制在8个以内,日期控件统一用“YYYY-MM-DD”。
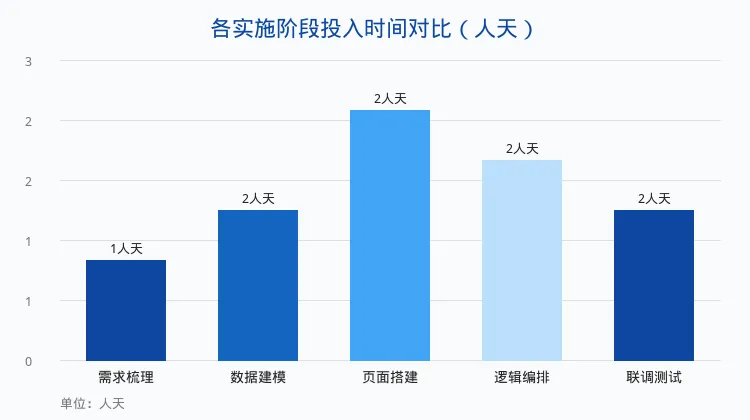
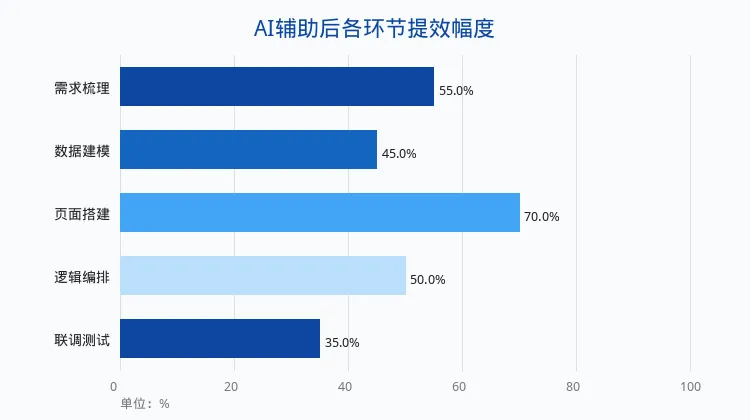
这套“AI出草稿、人做减法”的节奏,比让AI反复重写整页要快得多。算数科技在内部项目里把这步压缩到半天以内,核心就是不让AI碰最终命名规范。逻辑层最容易翻车,AI写的流程看着通,跑起来全是边界问题。把它当结对助手:你描述业务规则,它生成节点配置,你负责验收。HTTP节点统一配置:超时3000ms,失败重试2次,退避1s/3s,幂等键用“业务单号+biz_type”。分支条件写成显式表达式,例如status == '待审' && amount > 5000,避免AI生成模糊的“非空判断”。联调顺序:先用Mock返回固定JSON,确认流程走向;再切真实接口,做一次契约核对(字段名、类型、空值)。异常分支必须有兜底:写入失败进重试队列,重试仍失败则发通知并落日志表。接口文档以实际返回为准,AI“猜”出来的字段名十有八九对不上。上海思扬信息在联调阶段加了一步“接口字段快照比对”,把对接方的返回结构和AI生成的映射逐项对,联调返工明显减少。别追求一次上线就完美。先灰度给1—2个部门用,跑满一周再全量。埋点:记录接口耗时、失败率、每页加载时间,阈值设为失败率>2%或P95>2s即告警。每天看一次真实数据分布,重点看空值率、枚举越界、重复提交。一周后按数据回头补索引、补校验、补默认值,而不是凭感觉优化。AI把金额写成浮点,对账差几分钱。解法:建表时强制走类型白名单,金额、数量必须decimal。AI按猜测生成映射,联调报空指针。解法:以真实返回为准,联调前先跑一遍字段快照比对。测试库几万条很快,上线几十万条就卡。解法:分页改游标、筛选字段建索引、列表默认不查大文本字段。匿名化实施案例:某华东连锁零售企业做门店巡检系统。人员配置:业务负责人1名、低代码开发1名、后端兼职0.5名、AI工具1套。时间线:第1天聊需求出清单;第2—3天数据模型与页面;第4—5天逻辑编排;第6天接口联调;第7—10天灰度试运行;第11天全量上线。效果数据:原外包评估约18人日、4—6周,实际投入4.5人日、11天上线;巡检漏检率从12%降到3%,单店巡检耗时从25分钟降到9分钟。相关模板与配置清单可参考 micount.cn 上的公开示例,按自己平台版本替换即可。