ARTICLE · 1097056
FPGA TSN源码剖析:802.1CB FRER 如何在链路发生故障时,业务仍然能够保持连续传输
在工业控制、车载网络以及高可靠以太网系统中,网络真正需要解决的核心问题逐渐从“数据能否送达”转向“链路发生局部故障时,业务是否仍然能够保持确定性的连续传输”。
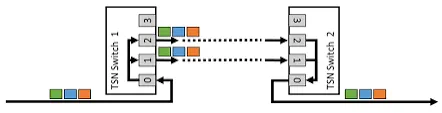
802.1CB FRER(Frame Replication and Elimination for Reliability)给出的工程答案,是沿两条独立路径复制同一业务帧,在接收侧依据序列号识别重复帧,并利用历史窗口判断乱序、重复与有效帧。
真正有价值的地方,在于它最终必须落成 FPGA 中的一组时序逻辑:一帧进入哪里、如何识别 CB 流、序号存在哪里、两个端口如何交换状态、什么时候丢帧、什么时候转发、什么时候写回状态,以及标签最终如何进入 MAC 数据流。
本文沿着源码真实层次逐步拆解这一过程。
01|先看系统:CB 位于 TSN Switch 的什么位置
TSN 子系统的结构很明确:
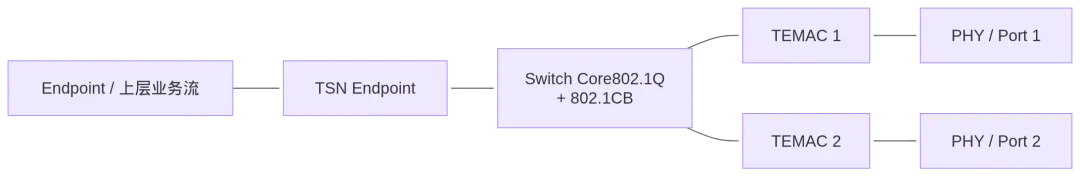
这里的关键点在于:
CB 并不是孤立的一颗 FRER IP,而是嵌在 Switch Core 的报文交换路径中。
源码顶层参数直接给出了这一层关系:
1 2 3 4 5 6 7 8 9 parameter NUM_PORTS = 3,parameter EN_FRER = 1,parameter MAX_FRAME_SIZE_P2Q = 2000,parameter MAX_FRAME_SIZE_P1Q = 2000,parameter MAX_FRAME_SIZE_P0Q = 2000,parameter EN_HW_ADDR_LEARNING = 0,parameter EN_CB_RSVD_BYTES = 0,parameter MAX_LEARNING_ENTRIES= 1920,parameter C_MAX_STREAM_GATES = 256, 其中:
NUM_PORTS | ||
EN_FRER | ||
MAX_FRAME_SIZE | ||
MAX_LEARNING_ENTRIES | ||
C_MAX_STREAM_GATES | ||
EN_CB_RSVD_BYTES |
TSN BD 的内部连接同样体现出 Endpoint、Switch Core 和两个 TEMAC 之间的报文与调度协同关系。
因此,理解 CB 的第一步不是寻找一个叫 CB 的模块,而是找到:
报文进入 Switch Core 后,哪一段逻辑开始把普通二进制流转换成“具有 FRER 语义的状态流”。
答案就在 frer_top。
02|第一层剖解:EN_FRER 把 CB 接入主数据通路
源码首先通过 generate 结构决定 FRER 是否进入实际数据路径:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 generate if (EN_FRER == 0) begin : DIS_FRER_FUNCTION ...end else begin : EN_FRER_FUNCTION switch_core_top_v1_0_11_frer_top #( .INTDT_WIDTH (INTDT_WIDTH), .NUM_PORTS (NUM_PORTS), .DMAC_TRANS_WIDTH (DMAC_TRANS_WIDTH-14), .SPID_SIZE (SPID_SIZE), .C_FAMILY (C_FAMILY), .INTDT_BCNT_LOG2 (INTDT_BCNT_LOG2) ) frer_top_inst ( .clk (clk), .reset (reset_rep_3), .PTP_CURRENT_TIME (PTP_CURRENT_TIME), ... );endendgenerate 真正值得注意的是输入输出。
输入
1 2 3 4 5 6 7 8 9 10 11 .ing_pkt_vld.ing_pkt_spid.ing_pkt_data.ing_pkt_sop.ing_pkt_eop.ing_pkt_err.ing_pkt_bcnt.ing_pkt_dpmap.ing_pkt_mc.ing_pkt_vpri.ing_pkt_dpri 输出
1 2 3 4 5 6 7 8 .frer_pkt_vld.frer_pkt_spid.frer_pkt_data.frer_pkt_sop.frer_pkt_eop.frer_pkt_err.frer_pkt_dpmap... 这说明 CB 数据面首先采用一种非常工程化的思路:
FRER 只改变报文的“语义状态”,并持续携带原始数据流。
因此可以把 frer_top 理解成:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 Ingress Packet │ ▼ FRER Context │ ┌────┴────┐ ▼ ▼Sequence RecoveryGeneration Engine │ │ └────┬────┘ ▼ Result / Decision │ ▼Egress Packet 这一步建立了整篇代码阅读最重要的坐标系。
03|第二层剖解:CB Filter 先解决“这是不是一条 FRER 流”
进入 frer_top 后,代码首先维护每个端口对应的 FRER 上下文:
1 2 3 4 5 6 7 8 9 10 11 reg [15:0] max_seq_id_1;reg [15:0] max_seq_id_2;reg [15:0] max_seq_id_3;reg [7:0] memberid_1;reg [7:0] memberid_2;reg [7:0] memberid_3;reg [NUM_PORTS-1:0] dpid_1;reg [NUM_PORTS-1:0] dpid_2;reg [NUM_PORTS-1:0] dpid_3; 随后在 SOP 时锁存:
1 2 3 4 5 6 7 8 9 if (frer_top_spid==VALID_PID_1 && frer_top_vld==1'b1 && frer_top_sop==1'b1) begin max_seq_id_1 <= frer_top_max_seq_id; memberid_1 <= frer_top_memberid; dpid_1 <= frer_top_dpid;end 这里已经出现了三个非常重要的概念:
memberid | ||
max_seq_id | ||
dpid |
源码随后通过 frer_fil_* 信号,把普通报文转换为真正进入 FRER Sequence Engine 的上下文:
1 2 3 4 5 6 7 8 frer_fil_spidfrer_fil_dpidfrer_fil_sopfrer_fil_memberidfrer_fil_seq_idfrer_fil_max_seq_idfrer_fil_eopfrer_fil_err 到这里,报文本身仍然是 64 bit 数据流。
变化发生在:
报文旁边开始携带一个稳定的“Member Context”。
这就是 FPGA 实现 FRER 的关键。
04|第三层剖解:源码怎样从帧里取出 CB Sequence ID
对于来自 MAC2/MAC3 的复制帧,代码进入专门的 CB Tag 解析状态机。
1 2 3 4 5 6 7 assign frer_ether_type = {frer_top_data[7:0], frer_top_data[15:8]};assign frer_seq_id = {frer_top_data[23:16], frer_top_data[31:24]}; 可以直接把这 32 bit 看成:
1 2 3 4 31 16 15 0+----------------------------+-------------+| Sequence ID | EtherType |+----------------------------+-------------+ 随后源码在端口 2 上按 SOP → VLAN → CB Tag 的时序逐拍推进:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 if (frer_top_spid==VALID_PID_2 && frer_top_sop==1'b1 && frer_top_vld==1'b1) begin frer_top_sop_r2 <= 1'b1; frer_top_vid_r2 <= 1'b0;endelse if (frer_top_spid==VALID_PID_2 && frer_top_sop_r2==1'b1 && frer_top_vld==1'b1) begin frer_top_sop_r2 <= 1'b0; frer_top_vid_r2 <= 1'b1;end 然后进入真正的 CB Tag 判断:
1 2 3 4 5 6 7 8 9 10 11 else if (frer_top_spid==VALID_PID_2 && frer_top_vid_r2==1'b1 && frer_top_vld==1'b1) begin if (frer_ether_type==FRER_ETHER_TYPE) begin frer_fil_seq_r2 <= frer_seq_id; frer_fil_vld_r2 <= 1'b1; frer_rem_cb_r2 <= frer_top_dpid[0]; endend 这里非常漂亮。
它没有把整个 Ethernet Parser 搬进 FRER,而是只等待几个必要的时间位置,然后提取:
1 2 3 4 5 EtherTypeSequence IDIngress PortDestination PortMember ID 这是一种典型的高速 FPGA Parser 思路:
协议字段只在真正参与决策的位置被提取,剩余报文字段继续作为流水数据向前传递。
05|第四层剖解:Sequence Generation,本质是一台“带记忆的状态机”
端口 0 是 Endpoint,因此对应 Sequence Generation:
1 2 3 4 5 6 7 8 9 10 switch_core_top_v1_0_11_seq_gen #( .SPID_VALUE (0)) seq_gen_inst ( .spid_in (2'b0), .sop_in (ep_sop_in), .memberid_in (ep_memberid_in), .max_seq_id_in(ep_max_seq_id_in), .eop_in (ep_eop_in), ...); 它的状态机非常清晰:
1 2 3 4 5 6 7 localparam IDLE = 3'b000;localparam SOF_PROCESSING = 3'b001;localparam MEM_READ = 3'b010;localparam WAIT_CYCLE = 3'b011;localparam SEQ_GEN = 3'b100;localparam WAIT_FOR_TLAST = 3'b101;localparam MEM_WRITE = 3'b110; 执行过程可以压缩成:
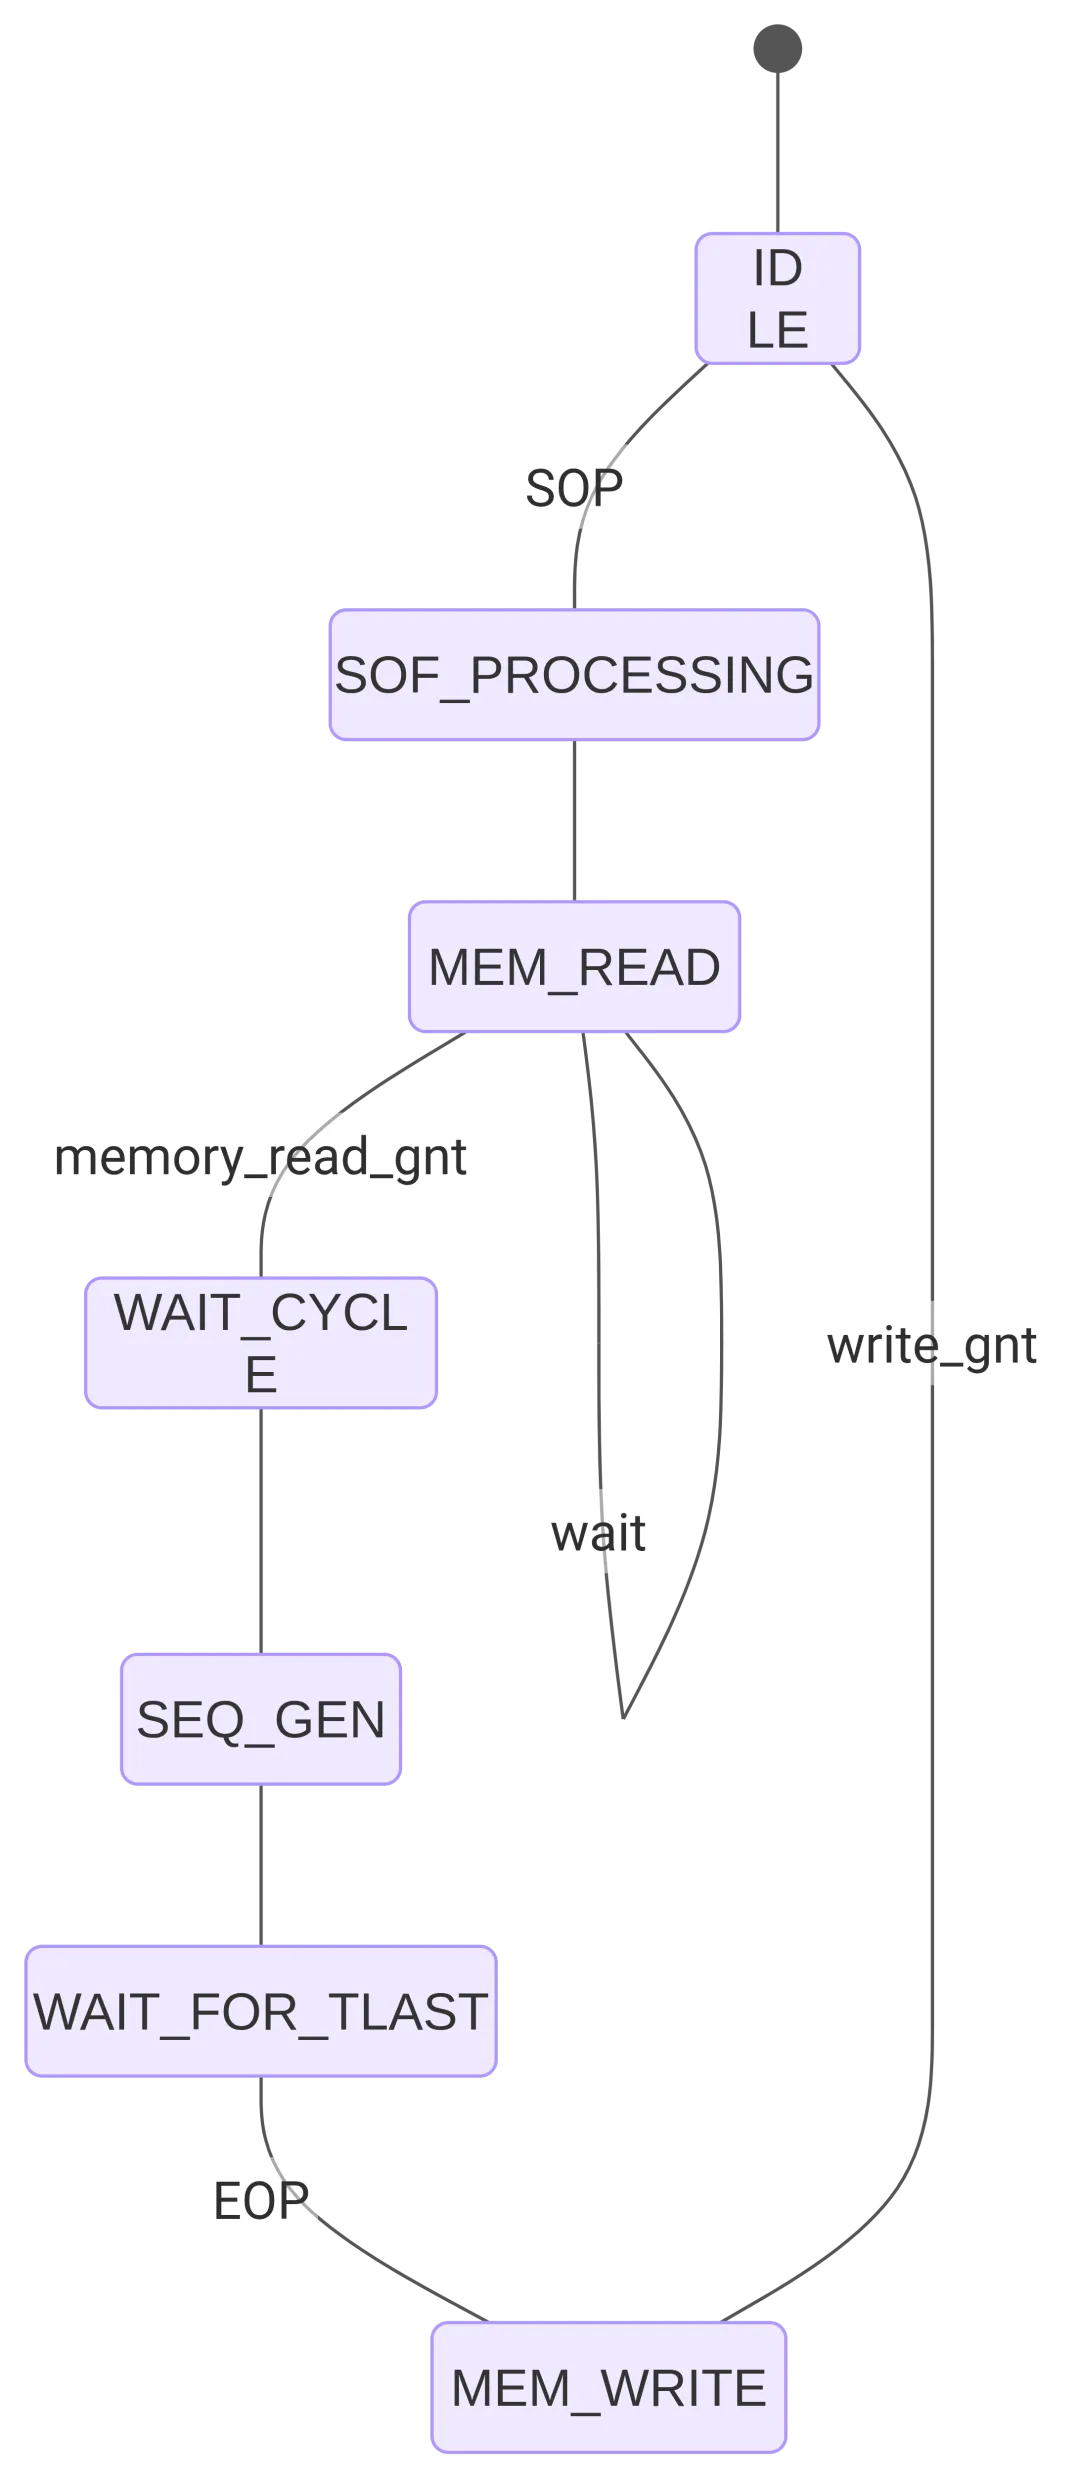
真正决定序号的代码只有几行:
1 2 3 4 5 6 7 8 if ((last_seq_id == max_seq_id) || latched_wrkmem_doutb[97] == 1'b1) running_seq_id = 0;else running_seq_id = last_seq_id + 1; 于是,整个 Sequence Generation 可以抽象为:
1 2 3 4 5 6 7 8 previous sequence │ ▼ last_seq_id │ ├── reached max ──► 0 │ └── ordinary ────► +1 这段逻辑背后真正重要的是:
序号递增本身非常简单,难的是把“上一次状态”安全地保留下来。
源码因此配套了一块 99 bit Working Memory。
06|99 bit Working Memory:CB 状态真正存在的地方
代码明确给出了 99 bit 状态布局:
1 2 3 4 5 6 7 8 [98] Egress port is EP[97] take_any[96] take_any_individual[95:80] last_recovered_sequence_number_individual[79:64] last_tick_count[63:48] remaining_ticks[47:32] last_recovered_sequence_number[31:0] history_vector 对应硬件状态:
98 | ||
97 | ||
96 | ||
95:80 | ||
79:64 | ||
63:48 | ||
47:32 | ||
31:0 |
这个设计很能说明 FRER 的硬件本质。
它并不是“比较一次 Sequence ID 就结束”。
而是:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 Member ID │ ▼Configuration Memory │ ├── sequence parameters ├── recovery parameters └── ingress/egress relation │ ▼Working Memory │ ├── last sequence ├── history window ├── timeout state └── recovery state 其中配置 RAM 为:
1 2 3 4 5 .MEMORY_SIZE (256*64).WRITE_DATA_WIDTH_A (64).READ_DATA_WIDTH_B (64).ADDR_WIDTH_A (8).ADDR_WIDTH_B (8) Working Memory 则为:
1 2 3 4 5 .MEMORY_SIZE (256*99).WRITE_DATA_WIDTH_A (99).READ_DATA_WIDTH_B (99).ADDR_WIDTH_A (8).ADDR_WIDTH_B (8) 也就是说,当前实现具有非常明确的硬件规模:
256 个 Member × 64 bit 配置状态 + 256 个 Member × 99 bit 运行状态。
这比“用寄存器实现 FRER”更接近真正可扩展的交换芯片结构。
07|第五层剖解:两个 Recovery Engine,真正形成“双路径比较”
进入 MAC1 与 MAC2 后,源码没有采用一个巨大统一状态机,而是实例化了两套 seq_rec:
1 2 3 4 5 6 switch_core_top_v1_0_11_seq_rec #( .SPID_VALUE (1), .PARTNER_SPID_VALUE (2)) seq_rec_inst_1 ( ...); 第二套正好反过来:
1 2 3 4 5 6 switch_core_top_v1_0_11_seq_rec #( .SPID_VALUE (2), .PARTNER_SPID_VALUE (1)) seq_rec_inst_2 ( ...); 这两行参数,本身就是整个双路径 FRER 架构最有价值的一处代码:
1 2 3 4 5 Recovery 1:MAC1 ←→ Partner MAC2Recovery 2:MAC2 ←→ Partner MAC1 两个 Recovery Engine 互相交换:
1 2 3 4 5 6 .partner_mac_seq_id.partner_mac_seq_id_individual.partner_mac_ticks.partner_mac_history_vector.partner_mac_type_sr.partner_mac_type_ir 最终通过双路状态结果完成一致性判断。
08|真正的“消重”发生在哪里
Recovery Engine 的输出定义得非常清楚:
1 2 type_sr_outtype_ir_out 代码已经把结果编码定义出来:
1 2 3 4 00 : drop duplicate01 : drop out of history window10 : forward11 : reserved / out-of-order 于是 FRER 的核心判定可以抽象成:
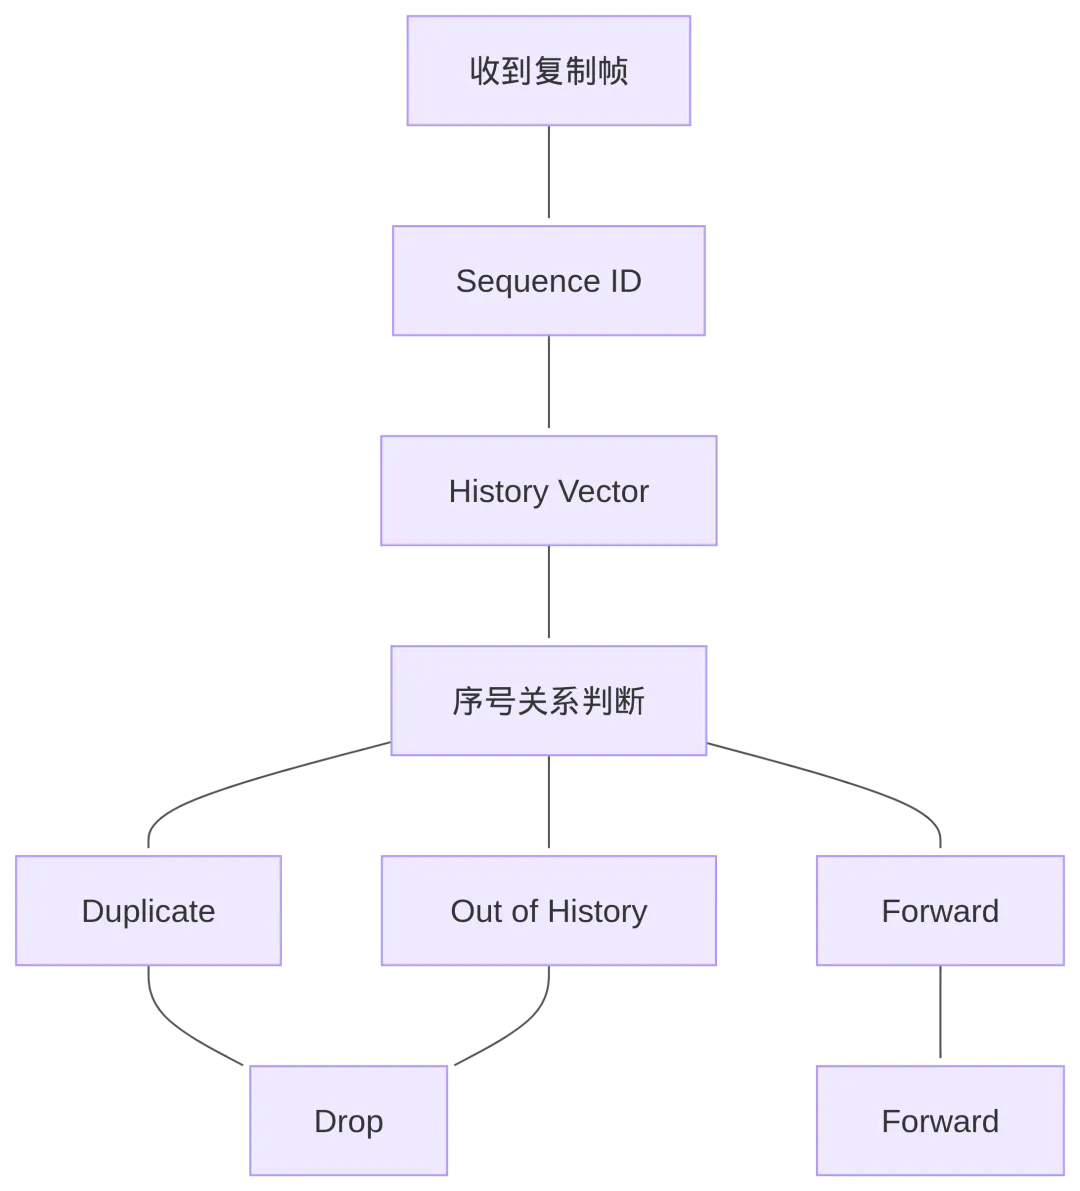
这里的硬件价值非常明确。
网络复制带来的两个核心问题:
1 2 相同帧重复到达乱序帧迟到 都被转换为:
1 2 3 4 5 6 7 Sequence ID +History Vector +Last Sequence +Recovery State 最终形成一个完全流水化的二进制决策。
09|History Vector:32 bit 让“窗口”真正变成硬件
源码:
1 2 3 4 5 assign last_history_vector = latched_wrkmem_doutb[31:0];assign history_length[5:0] = latched_cfgmem_internal_doutb[37:32]; Working Memory 保存:
1 history_vector[31:0] Config Memory 决定窗口长度。
所以恢复判断实际上建立在:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 current sequence │ ▼last sequence │ ▼sequence difference │ ▼history window │ ▼32-bit bitmap │ ▼duplicate / forward / old 这种结构的核心优势是:
窗口判断从软件算法变成了固定宽度的硬件状态更新。
对于 10G、25G 乃至更高速率的数据路径,这种实现方式比逐包进入 CPU 再做判断更符合 SmartNIC/TSN 数据面的设计原则。
10|第六层剖解:Split 不是简单复制,而是带着 Member Context 出口
Sequence Generation 的结果包含:
1 2 3 4 5 seq_id_outepid_outvlan_id_outmemberid_outdpid_out Recovery 同样提供:
1 2 3 4 5 memberid_outtype_sr_outtype_ir_outspid_outdpid_out 随后由:
1 switch_core_top_v1_0_11_split_out_mux 完成多路结果聚合。
源码对两个 Recovery Result 的最终选择明确依据 EOP:
1 2 3 4 5 6 7 8 9 10 11 if (vld_in == 1'b1 && eop_in == 1'b1 && spid_in == 1) vld_out <= vld_out_1;else if (vld_in == 1'b1 && eop_in == 1'b1 && spid_in == 2) vld_out <= vld_out_2; 这里体现的是一个非常重要的 FPGA 设计原则:
帧级决策在 EOP 时收束,数据级路径保持连续。
因此,FRER 对高速数据流的处理实际上分成两个维度:
1 2 3 4 5 数据流:64 bit payload ───────────────────────────►控制流:SOP → Member → Sequence → Result → EOP 两条路径最终在出口重新汇合。
11|第七层剖解:CB Tag 最终怎样进入真正的 Ethernet 帧
到目前为止,Sequence Engine 只产生:
1 2 3 4 frer_rslt_split_seq_idfrer_rslt_split_vlan_idfrer_rslt_split_epidadd_cb_tag_vld 真正把 Sequence ID 填进 Ethernet 帧的模块,是 epp_pktproc。
它的接口直接暴露出:
1 2 3 4 5 input add_cb_tag_vld;input frer_rslt_split_vld;input [1:0] frer_rslt_split_epid;input [11:0] frer_rslt_split_vlan_id;input [15:0] frer_rslt_split_seq_id; 然后进入数据拼接:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 else if (CFG_PID!=2'h0 && ing_pkt_spid_r=='h0 && ing_pkt_cb_r1==1'b1 && add_cb_tag_r1==1'b1) begin if (EN_CB_RSVD_BYTES==0) begin ing_pkt_data_r1 <= { 1'b0, ing_pkt_data_r[FIFO_WIDTH-2:64], ing_pkt_data_r[31:0], add_cb_seq_id[7:0], add_cb_seq_id[15:8], frer_type_value }; end 这段代码值得单独保存。
因为它完成了:
1 2 3 4 5 6 7 8 9 10 11 12 13 Sequence Engine │ ▼Sequence ID │ ▼CB EtherType │ ▼CB Tag Construction │ ▼Ethernet Data Stream 在 EN_CB_RSVD_BYTES==0 时,代码同时把:
1 ep_pkt_length_r <= ing_pkt_data[15:0] + 3'h4; 也就是说,当前路径下 CB Tag 按 4 Byte 增量进入报文长度计算。
扩展保留字段时:
1 ep_pkt_length_r <= ing_pkt_data[15:0] + 3'h6; 于是源码天然形成两种 Tag 模式:
EN_CB_RSVD_BYTES | ||
|---|---|---|
0 | ||
1 |
这个细节解释了一个很实际的问题:
协议字段最终必须映射到 FIFO 中连续的字节位置,控制面长度也必须同步更新。
因此 epp_pktproc 同时承担了:
1 2 3 4 5 6 7 Protocol Operation+Frame Length Update+Tag Insertion+Tag Removal 12|反向路径:Recovery 后为什么还存在 Remove CB Tag
源码专门输出:
1 frer_rslt_rem_cb_tag 然后在 EP 方向根据这个状态生成:
1 2 untag_data_r1untag_data_r2 代码:
1 2 3 4 5 if (CFG_PID==2'h0 && ing_pkt_vid_r1==1'b1 && frer_rslt_rem_cb_tag[0]==1'b1) untag_data_r1 <= 1'b1; 随后真正删除:
1 2 3 4 5 6 7 if (CFG_PID==2'h0 && (untag_data_r1==1'b1 || (ing_pkt_cb_r1==1'b1 && ing_pkt_data_r[15:0]==frer_type_value))) begin ing_pkt_data_r1 <= ... ;end 于是整个系统形成了一个完整闭环:

因此,FRER 在这份实现中的完整生命周期实际上是:
生成 → 复制 → 传输 → 恢复 → 判定 → 去重 → 标签处理 → 输出。
13|最后回到 PTP:CB 的时间状态从哪里来
源码中的 tick 模块直接使用:
1 PTP_CURRENT_TIME[23] 并维护:
1 reg [15:0] tick_count; 核心逻辑:
1 2 3 4 eight_ms_d1 <= PTP_CURRENT_TIME[23];if (eight_ms_d1 != PTP_CURRENT_TIME[23]) tick_count <= tick_count + 1; 随后 tick_count 进入 FRER Sequence Engine:
1 .tick_count(tick_count) 这意味着:
1 2 3 4 5 6 7 8 9 10 PTP RTC │ ▼Tick Counter │ ▼Recovery Timeout │ ▼Automatic State Recovery 因此 TSN 中的 PTP 与 CB 并不是两条完全独立的功能线。
在硬件实现层面:
PTP 提供统一时间基准,FRER 使用时间基准维护 Recovery 状态。
这也是 TSN Switch Core 中时间同步真正产生系统价值的地方。
14|把整个 CB 数据面压缩成一张图
把源码所有层次重新整理,可以得到一张非常接近硬件真实结构的图:
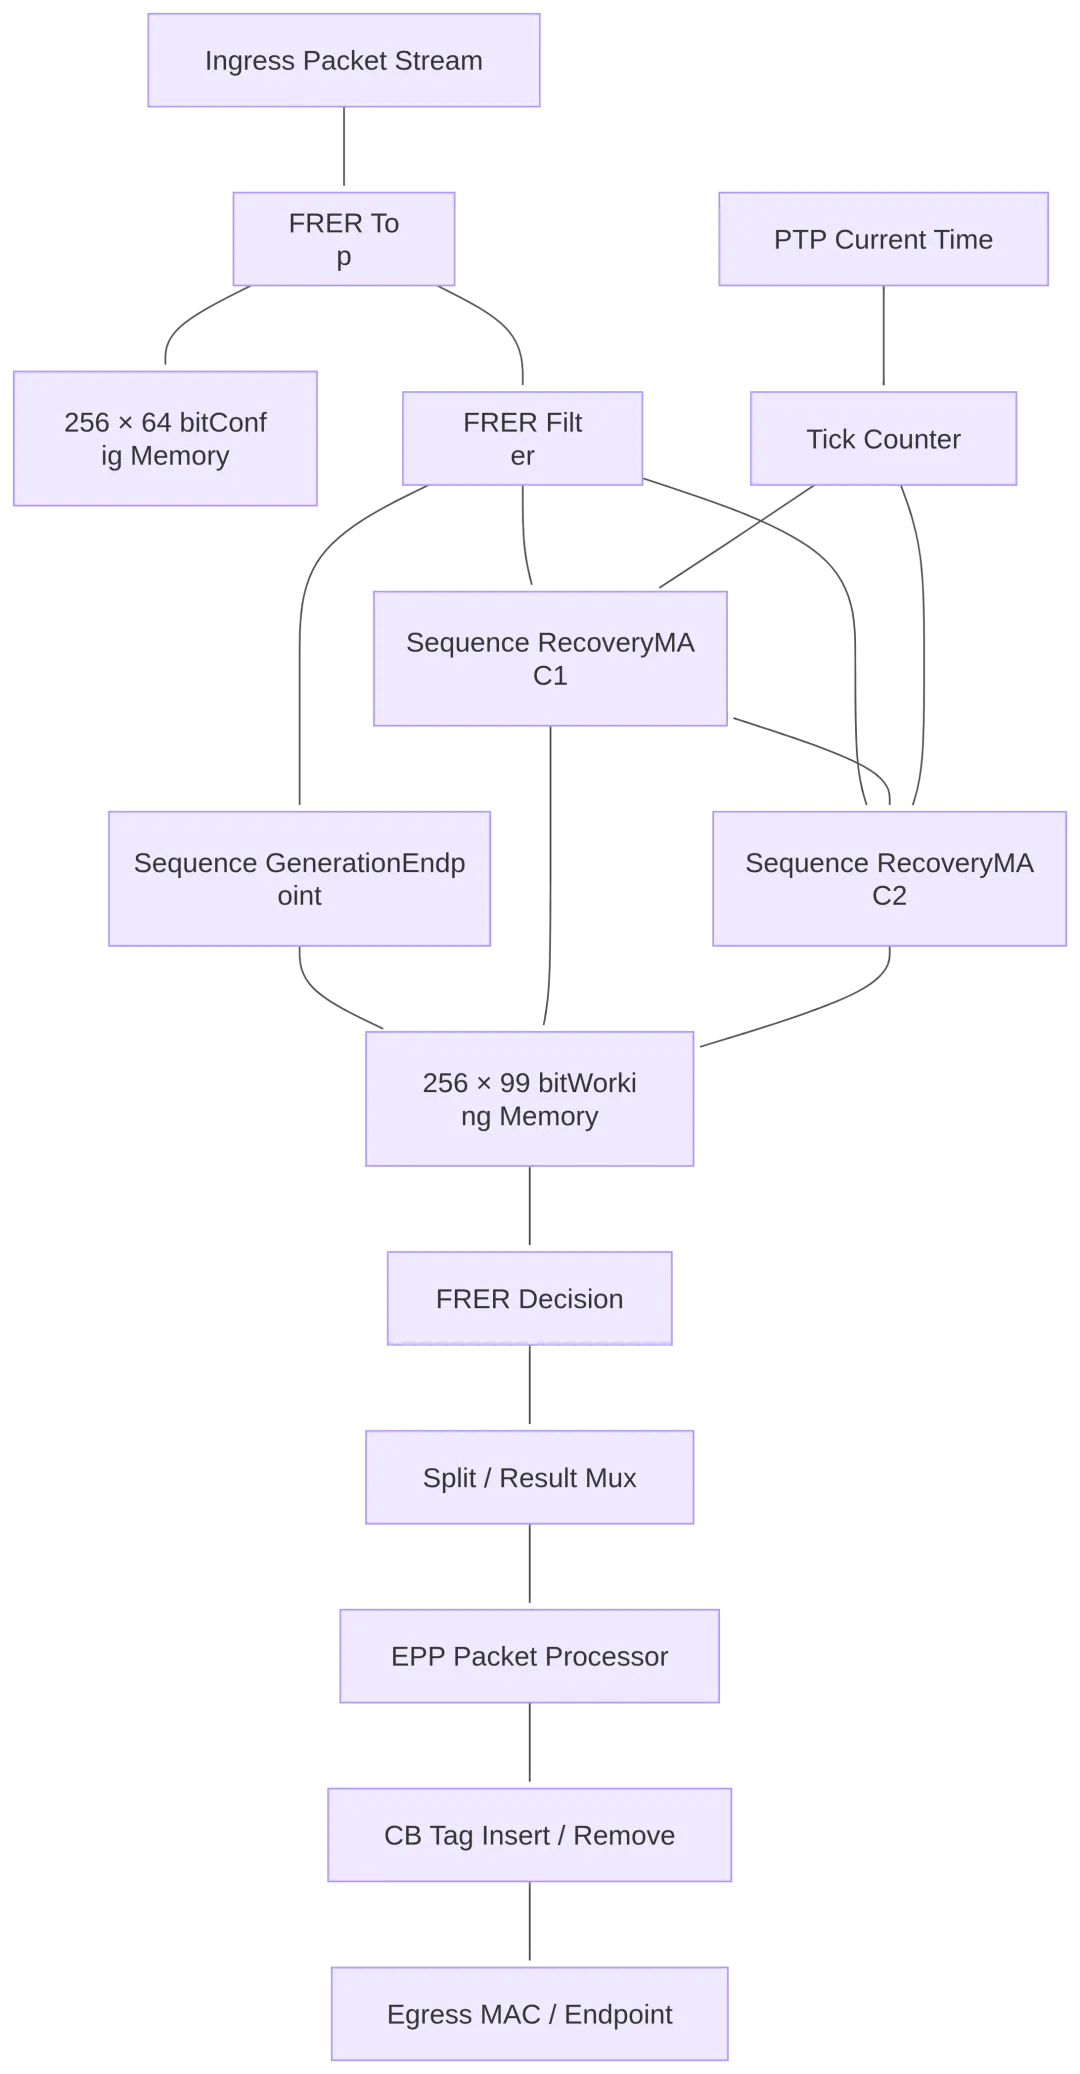
至此,switch_core_top_v1_0_rfs.sv 中庞大的源码可以被压缩成七个硬件动作:
1 2 3 4 5 6 7 ① Identify② Context Lookup③ Sequence Generate④ Sequence Recover⑤ History Compare⑥ Result Select⑦ Tag Transform 15|源码阅读真正值得带走的几个数字
这些数字构成了一个很典型的 FPGA TSN FRER 实现画像:
小型固定端口数 + BRAM 状态表 + 多级流水 + 帧级状态机 + 时间驱动 Recovery。
16|结语:真正的 CB,是一组状态机与存储器共同组成的协议处理器
从源码层面看,802.1CB 最具工程价值的部分恰恰落在协议文字之外。
它最终落成的是:
1 2 3 4 5 6 7 8 9 10 11 12 13 Packet Stream ↓Member Context ↓Sequence ID ↓History Vector ↓State Memory ↓Recovery Decision ↓Packet Transformation 其中最核心的关系可以浓缩为一句话:
Sequence ID 定义“这一帧是谁”,Working Memory 定义“这个流此前发生过什么”,Recovery FSM 决定“这一帧现在应该做什么”。
而在 TSN 子系统中,这套状态机又与 Endpoint、Switch Core、TEMAC 的报文与时间接口连接起来,最终形成一条完整的确定性网络数据通路。当前架构资料给出的 TSN 子系统也明确采用 Endpoint—Switch Core—双 TEMAC 的组织方式,并为 Switch Core 配置 FRER、硬件地址学习和队列/门控相关能力。
真正读懂这类源码的关键,于是也从“记住 FRER 标准”转向了另一种方法:
沿着一个 Sequence ID,追踪它从配置 RAM 诞生,经过 Filter,进入状态机,写入 Working Memory,参与下一帧判断,最终再回到 Ethernet 数据流。
这条路径一旦走通,整个 switch_core_top_v1_0_rfs.sv 的层次结构便开始呈现出非常清晰的硬件秩序。