ARTICLE · 1099540
我用 AI 拆完破局官网 2090 篇公众号文章,然后把它们做成了 7 个 Skill
摘要:2090 篇候选、150 篇全文、162 篇收录、7 个 Skill——我用 WorkBuddy 把破局官网的公众号文章整个拆了一遍。全过程、脚本和踩过的坑全部摊开,照抄就能跑。
先报数字:
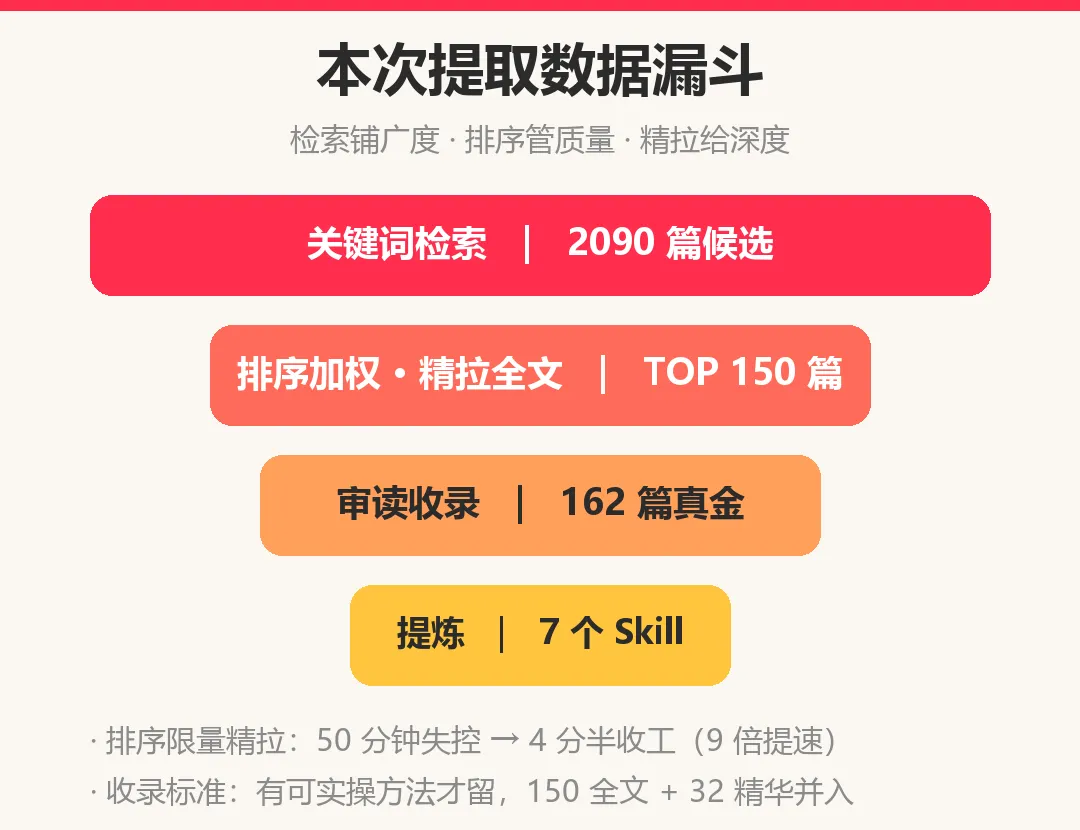
2090 篇候选文章,150 篇拉回全文,162 篇最终收录成库,7 个 Skill 从里面长出来。
这件事我是在 WorkBuddy 里完成的:我只负责提需求和验收,中间的安装工具、写脚本、跑数据、踩坑重试,全部是 AI 自己干的。
这篇就把它完整摊开——你会看到一条「官网语料 → 价值分析 → Skill」的流水线,以及它怎么把「刷帖子学运营」这件事,变成一个可复用的工程流程。
一、为什么要拆整个官网
做公众号的人都有同款日常:收藏夹里躺着几百篇干货,一篇没再看第二眼。
问题不在你不努力,在于碎片化的帖子构不成方法论。单篇帖子教你的是一个动作,而做成一个号需要的是整条流水线:选题从哪来、钩子怎么写、发了之后怎么接流量、流量来了怎么变现。
所以我换了个思路:与其收藏,不如把官网里公众号相关的帖子整个提出来,用数据的方式读一遍。
破局刚好提供了官方 CLI(@aipoju/breakout-cli),能把官网主题区的帖子程序化拉出来。素材源有了,剩下的就是工程问题。
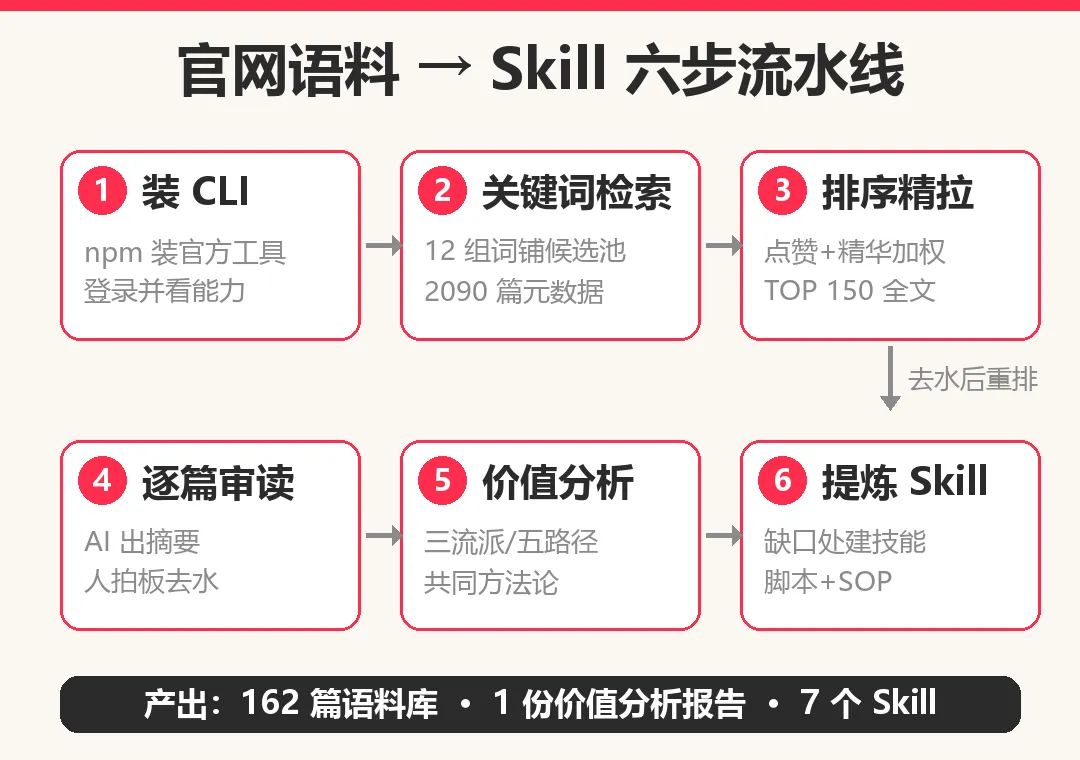
二、六步流水线,全程复盘
Step 1:装工具,两分钟
npm install -g @aipoju/breakout-cli@latestbreakout auth login (复用已有登录态,浏览器授权备用)breakout capabilities (查看能力清单,找到 topic.query)
Step 2:关键词检索,铺开候选池
用 12 组关键词(公众号 / 公众号运营 / 公众号写作 / 公众号排版 / 涨粉 / 流量主 / 10万+ / 爆文 / 变现 / 小绿书……)逐组分页检索,2 分钟拿到 2090 篇候选,每篇含标题、点赞、精华标记、AI 摘要。
Step 3:精拉全文,只拉值得拉的
这里踩了本次最大的坑。第一版脚本对 2000 多篇候选逐篇拉全文,跑了 50 分钟还没完。这次直接绕开:先按「点赞 + 精华加权」排序,只精拉 TOP 150,每篇间隔 0.35 秒防限流,每 20 篇增量落盘一次。4 分半收工。
一句话经验:检索管广度,排序管质量,精拉管深度。三步分开,别混在一起。
Step 4:逐篇审读,人做判断
AI 把 150 篇全文 + 32 篇精华帖生成审读摘要,我逐篇过了一遍,只干一件事:判断「这篇有没有可实操的方法」。结果很残酷—半数以上是变现故事、产品公告、训练营招生帖。它们沾着「公众号」的关键词,但没有一条能落地的打法。删掉之后,剩下 162 篇真金,归入 7 个分类。
Step 5:价值分析,让数据说话
162 篇审完,三个此前模糊的判断变得非常具体:
① 公众号内容已分成三大流派:贴图流(2026 新风口)、长文 AI 产线流、漫画流② 纯自动发文已死:做死号的人只自动化了「发」,没自动化「发什么能赚钱」的判断。活下来的全是「AI 生产 + 人工审核」③ 变现就五条路:流量主 → 商单 → 知识星球 → 咨询 → 带货导流,每条路都有人跑通了数据
Step 6:提炼 Skill,方法论变成可执行的东西
这是最有趣的一步。盘点本地技能库后发现:6 个已有 Skill 的方法论出处,恰好全在这批语料里——爆款标题工厂、公众号排版器、漫画工厂、监控雷达、基因蒸馏器、小红书工作台。等于交叉验证了一遍。
而语料同时暴露了一个能力缺口:贴图。它是 2026 年平台亲自喂饭的风口,但本地没有对应技能。于是新建了第 7 个——公众号贴图流水线(gzh-tie-tu-pipeline):
· SKILL.md:五段流水线主文件(定位→选题→卡片→发布→复盘)· topic_calendar.py:30 天选题日历生成器,输入赛道和人设,30 秒产出 30 天日历,每条带首图钩子、互动提问、SEO 关键词和发布建议,工作日自动偏干货、周末偏互动· references:四形式卡片模板 / 起号 SOP 与变现阶梯 / 发布前合规自检清单
三、这次踩过的 3 个坑(帮你省时间)
坑 1:服务端筛选参数会被静默忽略。传 filters 给列表接口,返回 total 看起来正常,实际根本没过滤。解法:全量拉取 + 本地过滤,别信服务端。
坑 2:「逐篇拉全文」必须先限量。不排序不限量地精拉,2000 篇能跑掉 50 分钟;排序后只拉 TOP 150,9 倍提速。
坑 3:关键词命中 ≠ 内容相关。标题含「公众号」的帖子里,一大半是变现故事和公告。最后一步必须人工(或 AI 逐篇)审读,这一步省不掉——但 AI 把它从一周压到了半小时。
四、你可以怎么抄这份作业
这套流程不挑平台,任何「帖子海 + 官方接口」的场景都能套:
① 找到数据源(官方 CLI / 开放 API / RSS)② 关键词铺候选池(元数据,快)③ 排序限量精拉全文(慢动作,只给好钢)④ 逐篇审读去水(AI 辅助 + 人拍板)⑤ 价值分析找结构(流派 / 路径 / 共同方法论)⑥ 缺口处提炼 Skill(能脚本化的脚本化,能 SOP 的 SOP 化)本次产出:162 篇语料库 + 一份价值分析报告 + 7 个 Skill。方法论全部标注了出处帖,可溯源。
结尾
整个过程里,人做的事其实只有两件:提出「拆官网」这个想法,以及在审读环节做最终判断。其余的——写脚本、跑数据、防限流、提炼方法论、搓 Skill——AI 在对话里自己完成了。
我的体感是:内容运营的下一个分水岭,不是「会不会用 AI 写」,而是「会不会把学习方法做成流水线」。
你现在收藏夹里躺着多少篇没看的干货?评论区报个数,超过 50 的,建议把这篇收藏——然后真的跑一遍。