ARTICLE · 1101537
【统计分析软件SPSS】188、时间序列分析——使用专家建模器构建模型(操作步骤)
本系列文章(基于SPSS 31版本)配套数据可通过百度网盘获取:
链接:https://pan.baidu.com/s/1AGizNngKrzAVapWtNcc-VA?pwd=mnsj提取码:mnsj
https://www.mizhushare.com/docs/
在时间序列分析领域,传统建模往往需要经历"反复试验-参数调整-模型比较"的漫长过程。但SPSS的时间序列建模器过程,特别是其中的专家建模器(Expert Modeler) 功能,让复杂的时间序列建模变得智能化和自动化。
专家建模器是SPSS时间序列建模器过程中的核心功能模块。简单来说,它是一个自动化的模型识别与估计引擎,能够:
自动识别:基于数据特征,智能判断最适合的模型类型;
自动估计:无需手动设定参数,自动完成模型参数估计;
自动比较:在多个候选模型中,自动选择最优模型;
该功能特别适合非专业建模人员或需要快速建模的场景。
一、加载并检查数据:
本次将使用「专家建模器」为全部85个市场生成未来三个月的预测,并将生成的模型保存到文件中。
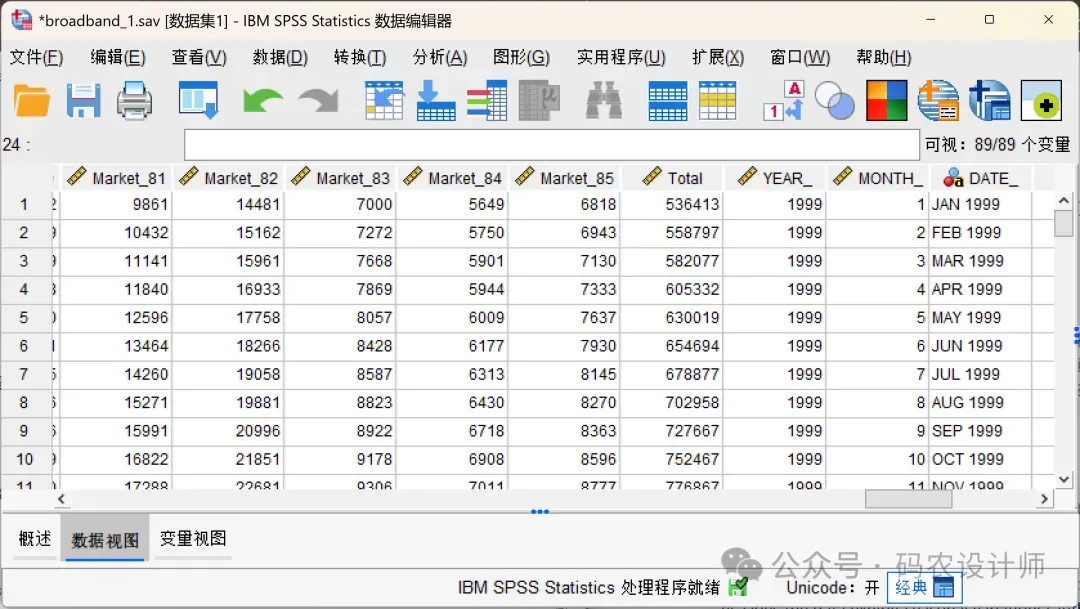
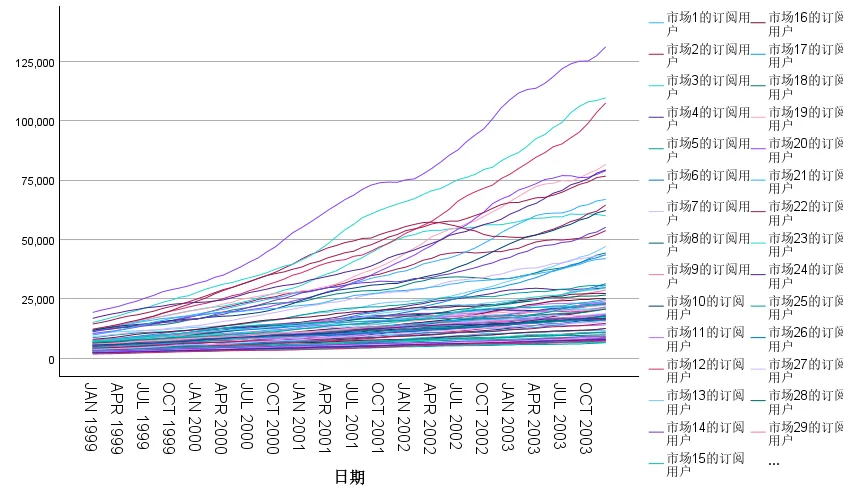
尽管「专家建模器」会自动为每个序列找到最佳的模型,但在构建模型之前,通过绘制序列图了解数据的性质(如,是否表现出季节性变化)仍是一个好习惯。例如,如果在数据中未发现季节性时,将模型限制为非季节性模型,通常可以获得更快的结果。
绘制序列图的相关内容可以查看以下文章:
通过绘制序列图对全部85个序列的检查,发现均显示出非常平滑的上升趋势,没有任何季节性变化的迹象。
二、构建模型:
点击顶部菜单栏的【分析→时间序列预测→创建传统模型】,在打开的对话框中进行相应设置。
1)、主对话框:
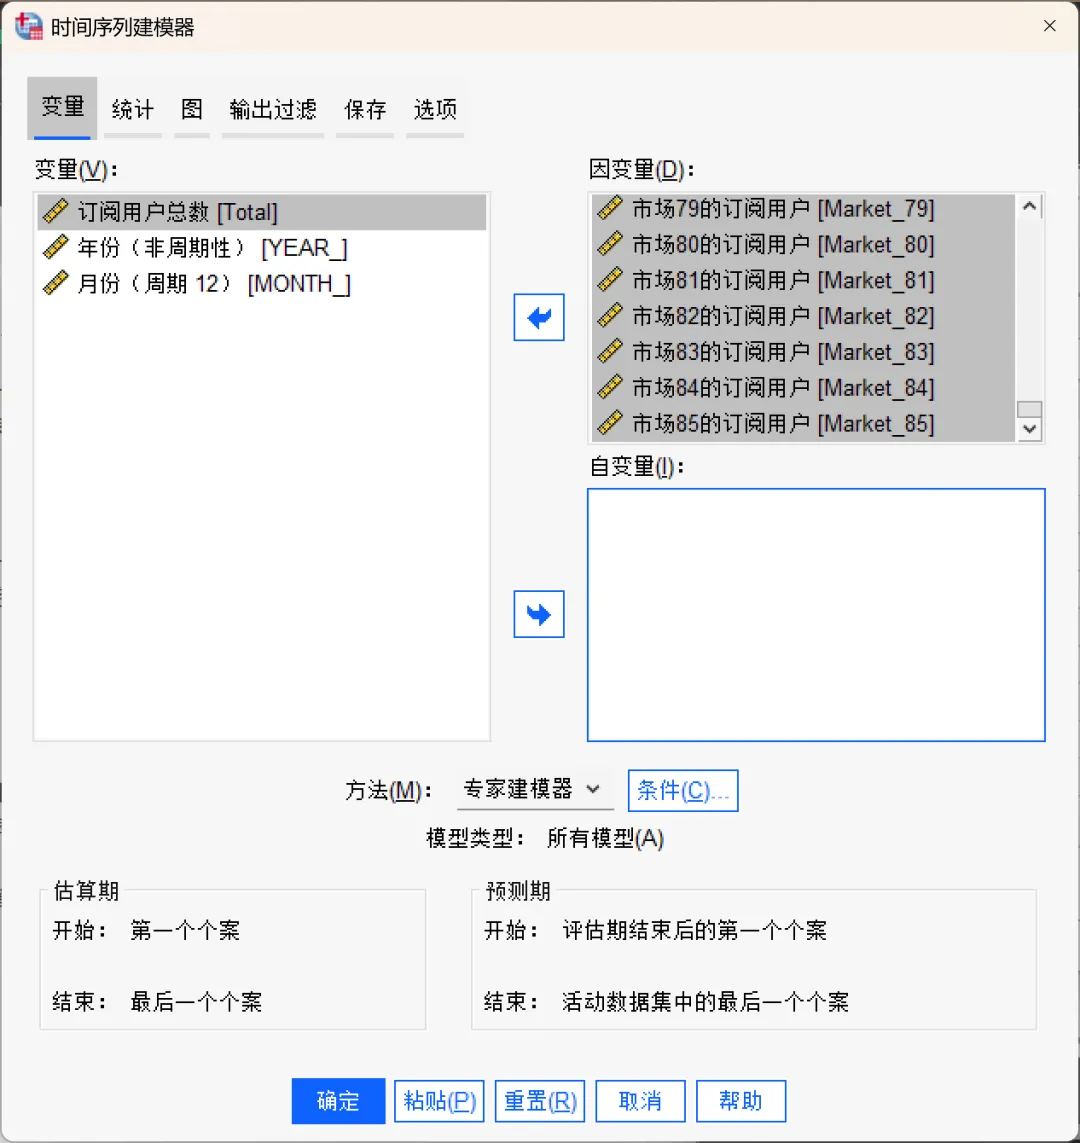
该对话框主要用于设置分析变量。
模型的因变量(即,要预测的目标变量)。 | |
用于指定外生变量(即,可能影响因变量的其他变量)。在本例中,仅对每个市场单独建模,因此该框为空。 | |
选择建模方法,包括:
| |
用于配置专家建模器(详见第二部分:条件对话框)。 | |
估算期定义了用于确定模型的个案集。默认情况下,估算期包含活动数据集中的所有个案。可以通过「选择个案」功能中「基于时间或个案范围」选项设置自定义估算期。 | |
预测期从估计周期后的第一个个案开始,默认情况下,一直持续到活动数据集中的最后一个个案。可以通过「选项」选项卡设置预测周期的结束时间。 |
本次选择「市场1的订阅用户」至「市场85的订阅用户」之间的全部变量作为因变量。在「方法」下拉列表中选择「专家建模器」。
2)、条件选项卡:
点击「条件」按钮即可打开条件选项卡,主要用于配置建模方法(本次示例用于配置专家建模器)。包含以下两个子选项卡:
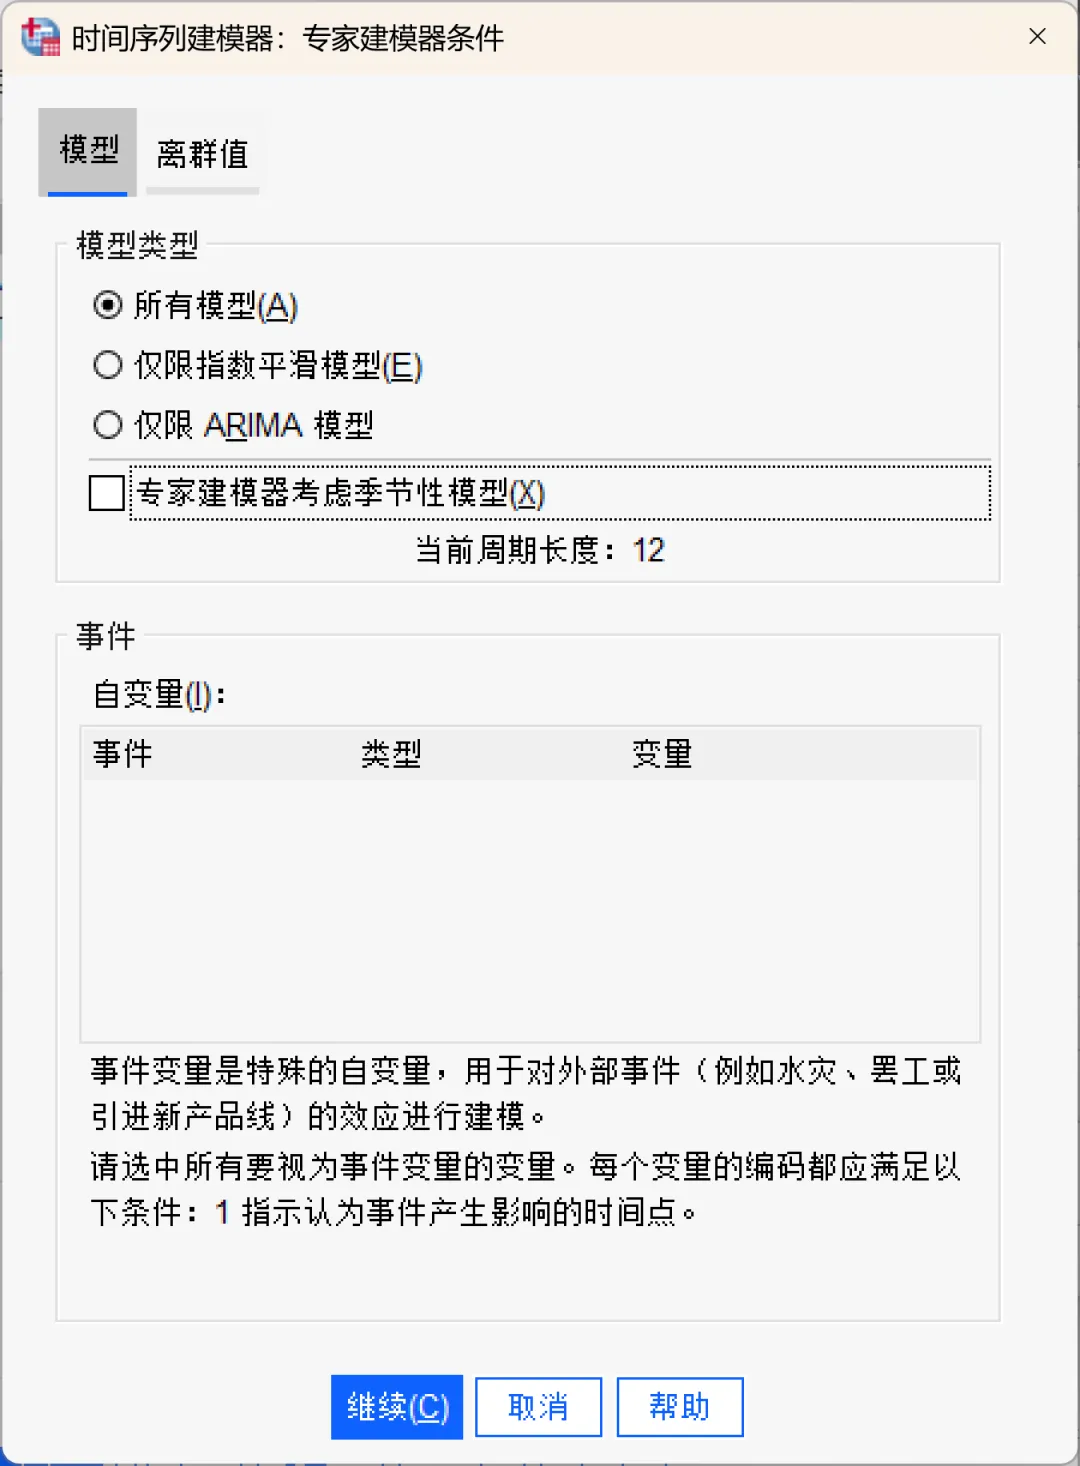
①、模型选项卡:
主要用于约束模型的选择范围,以及引入外部事件变量以提高模型准确性。
模型类型 | 提供以下选项:
|
事件 | 选择要作为事件变量处理的自变量。事件变量规则如下:
|
本次示例中,在「模型类型」组中取消勾选「专家建模器考虑季节性模型」。这是因为,数据虽然是按月统计且当前周期为12,但前面通过序列图发现数据没有任何季节性特征,因此无需考虑季节性模型,这将缩小专家建模器搜索的模型范围,并显著减少计算时间。
②、离群值选项卡:
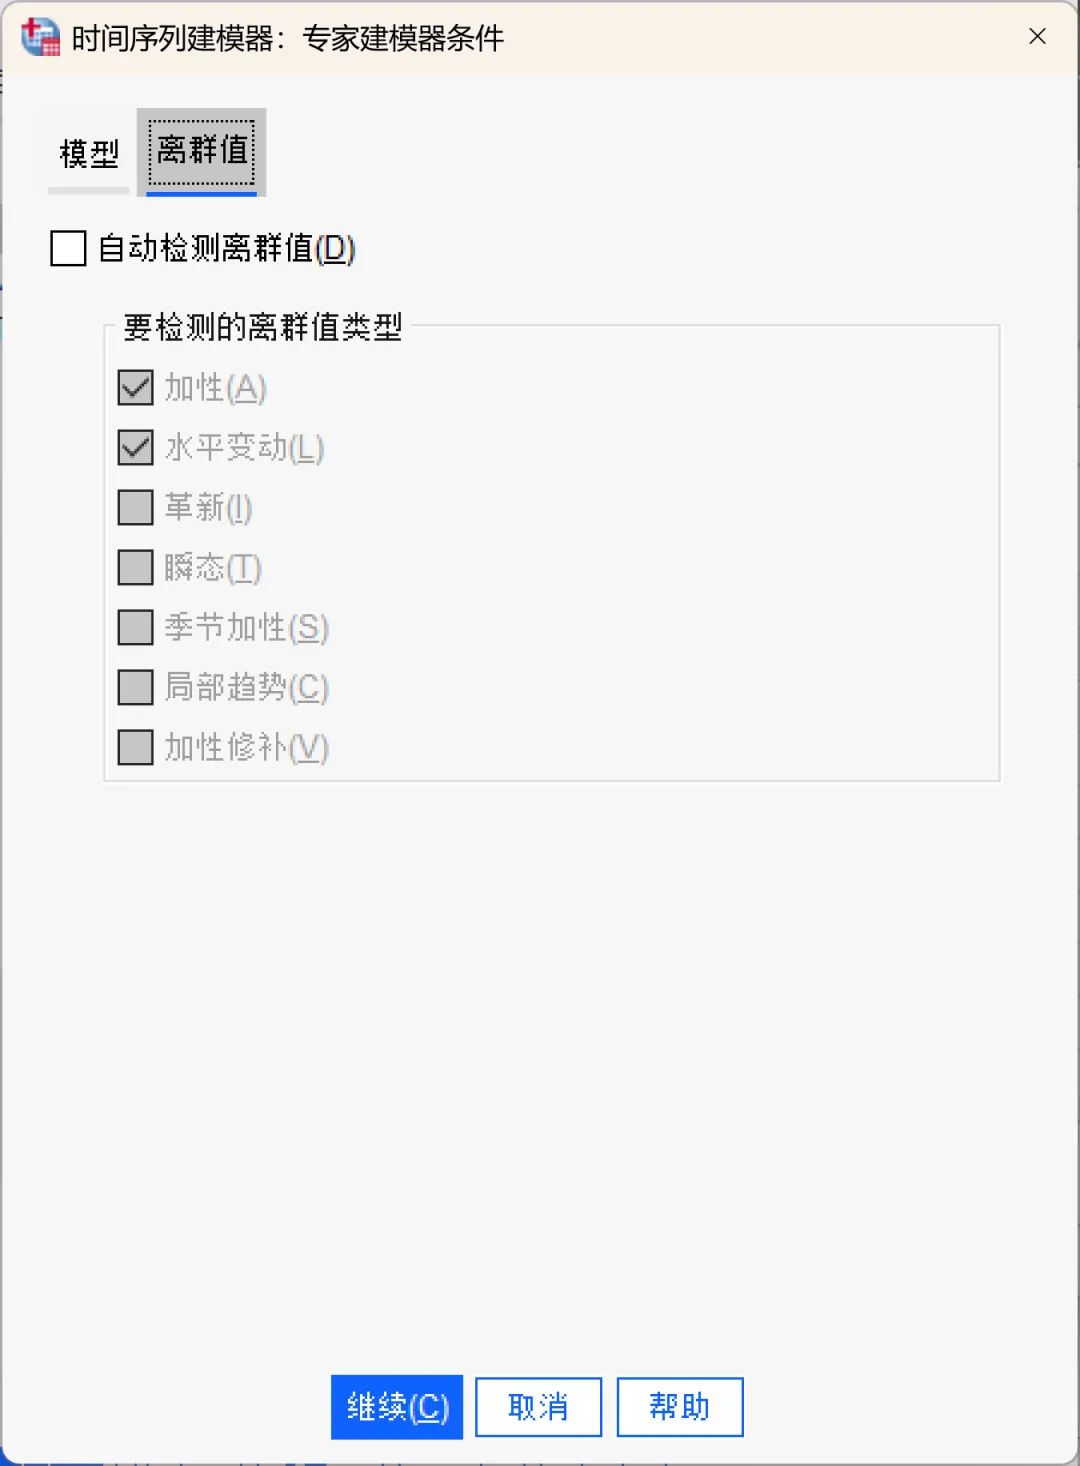
用于定义如何检测和处理数据中的离群值。在时间序列分析中,正确处理这些异常值对于提高预测准确性非常重要。
选中「自动检测离群值」选项以执行离群值自动检测,然后需要在「要检测的离群值类型」组中选择一种或多种离群值类型。
本次不执行离群值的自动检测。
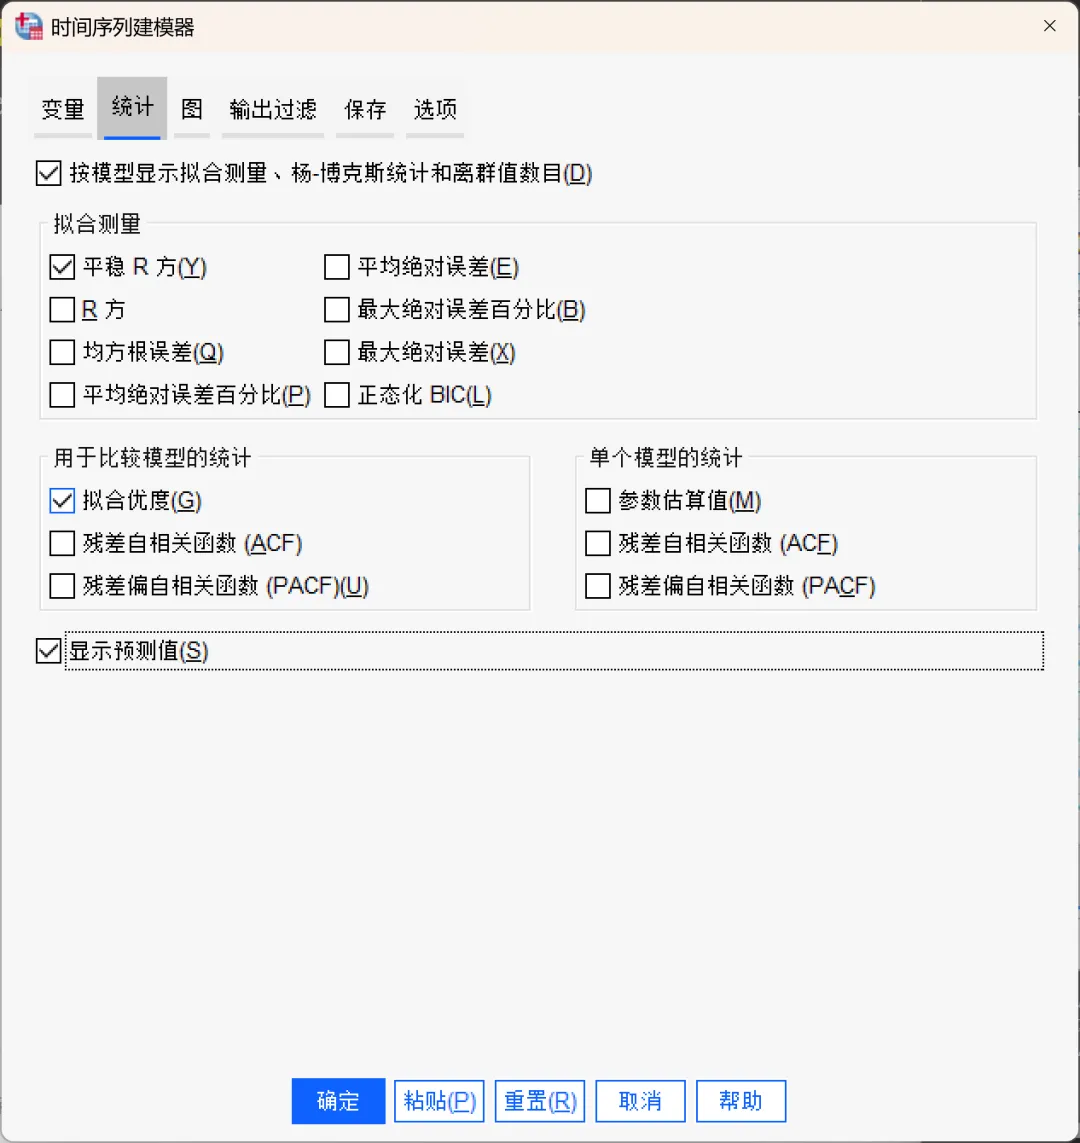
3)、统计选项卡:
勾选后表示将为每个模型生成以下统计信息:
| |
拟合测量 | 衡量模型对历史数据拟合程度的指标,包括:
|
控制所有估计模型计算出的统计量表格的显示:
| |
单个模型的统计 | 控制每个估计模型详细信息的表格显示。每个选项都会生成一个独立的表格:
|
为每个估计模型显示模型预测值和置信区间的表格。预测周期在「选项」选项卡中设置。 |
4)、图选项卡:
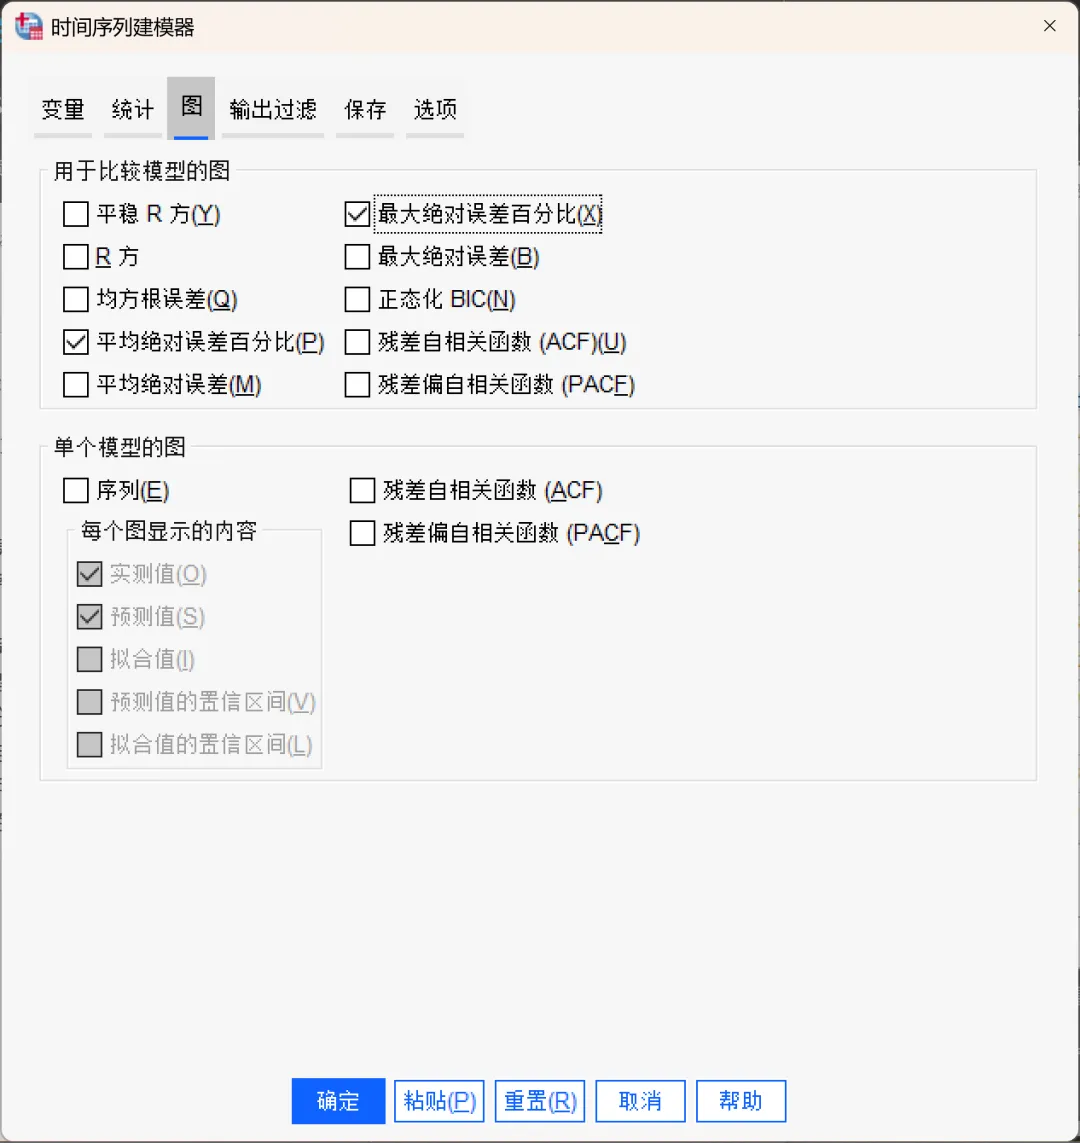
图表选项卡提供了用于显示模型结果图表的选项。
用于比较模型的图 | 该组选项控制着包含所有估计模型计算出的统计量的图表显示。每个选项都会生成一个独立的图表。各选项的含义详见「统计」选项卡部分。 |
单个模型的图 |
|
本次在「用于比较模型的图」组中,勾选「平均绝对误差百分比」和「最大绝对误差百分比」,绝对误差百分比衡量了因变量序列与其模型预测水平的偏离程度,通过检查所有模型的平均值和最大值,可以了解预测中的不确定性。再者,因为因变量序列代表了不同规模市场的用户数量,因此建议查看百分比误差的汇总图表,而不是绝对误差。
在「单个模型的图」组中,取消勾选「序列」,因为我们更感兴趣的是将预测结果作为新变量保存,而不是生成预测图。
5)、输出过滤选项卡:
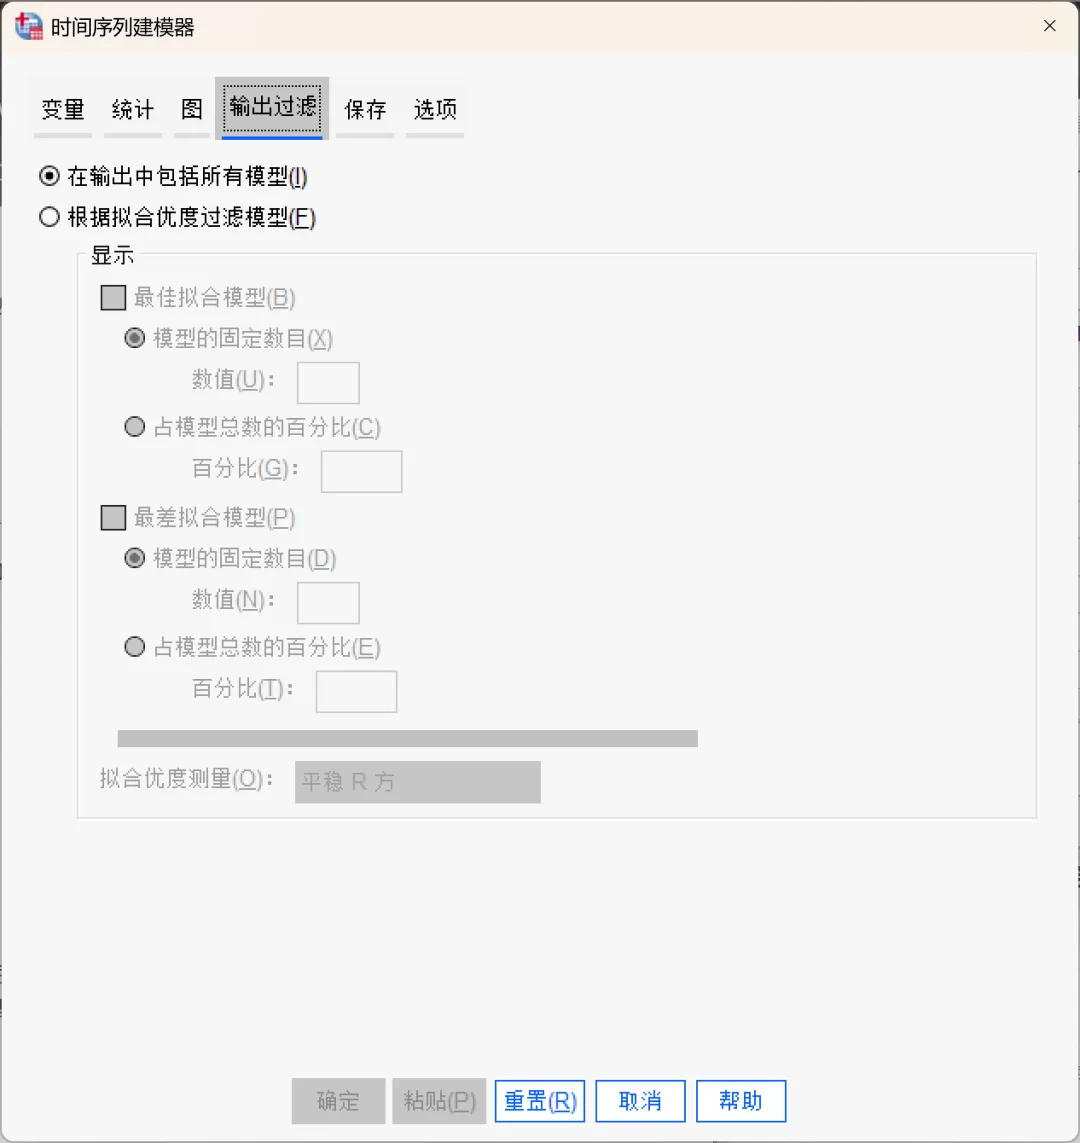
输出过滤器选项卡提供了将表格和图表输出限制为已估计模型子集的选项。默认情况下,所有估计的模型都会包含在输出中。
当需要处理大量时间序列(比如几百个产品销量)时,可以根据提供的拟合标准,选择仅输出拟合最好和(或)拟合最差的模型,避免被海量数据淹没。
选中该选项可将拟合最好的模型包含在输出中。
| |
选中该选项可将拟合最差的模型包含在输出中。
| |
拟合优度量 | 选择用于过滤模型的拟合优度量。默认值为平稳R方。 |
6)、保存选项卡:
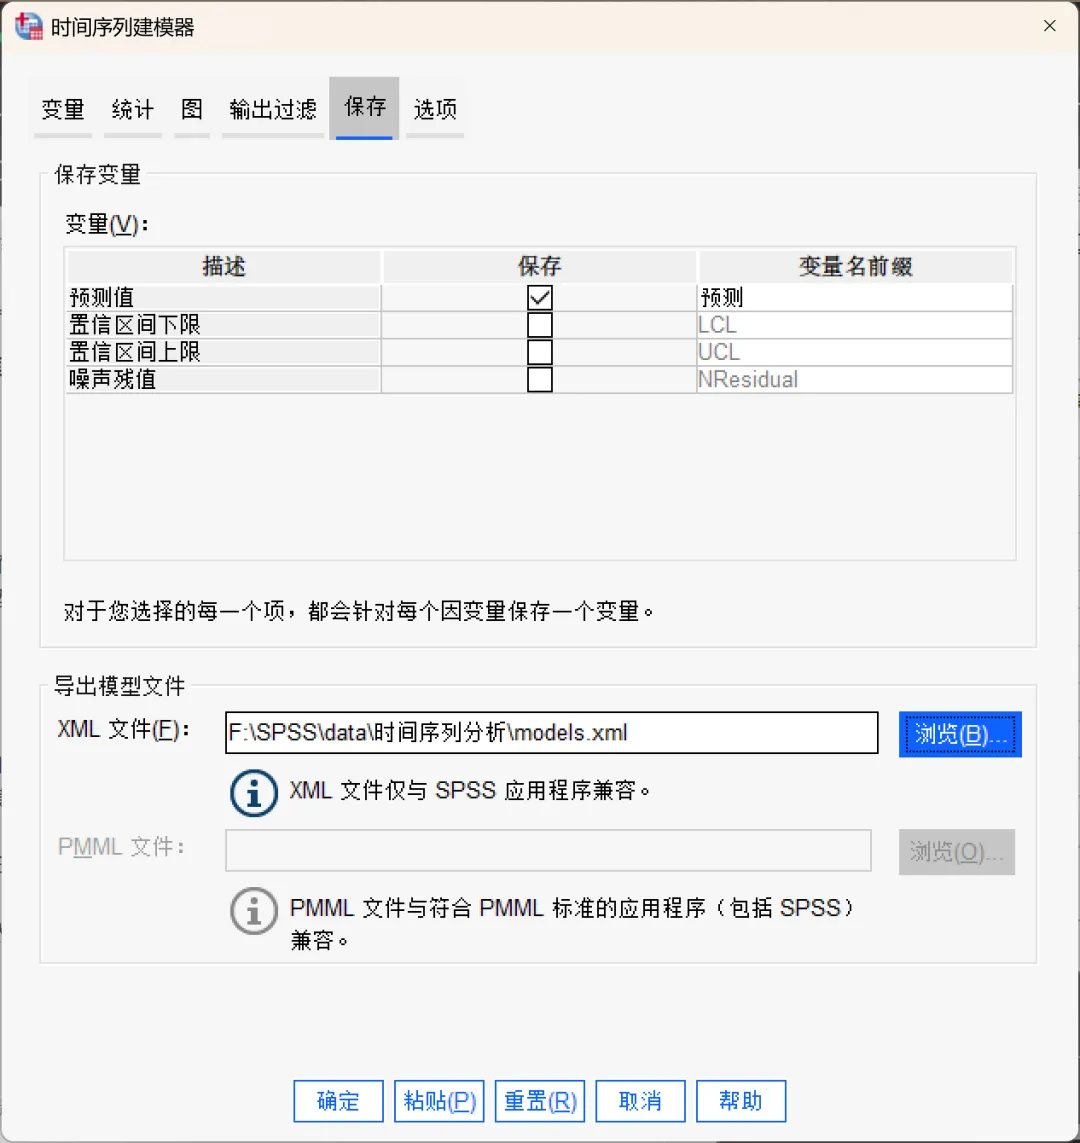
保存变量 | 可以将模型预测、置信区间和残差作为新变量保存到活动数据集中。每个因变量序列都会生成一组新变量,每个新变量都包含估计期和预测期的值。如果预测期超出了因变量序列的长度,系统会自动添加新个案。可指定用于新变量名的前缀,或者使用默认前缀。
|
导出模型文件 | 将模型保存到指定文件中,用于后续预测。包括XML文件和PMML 文件格式。 |
7)、选项选项卡:
该选项卡用于定义预测的时间范围、缺失值处理方式以及置信区间的宽度等底层逻辑。
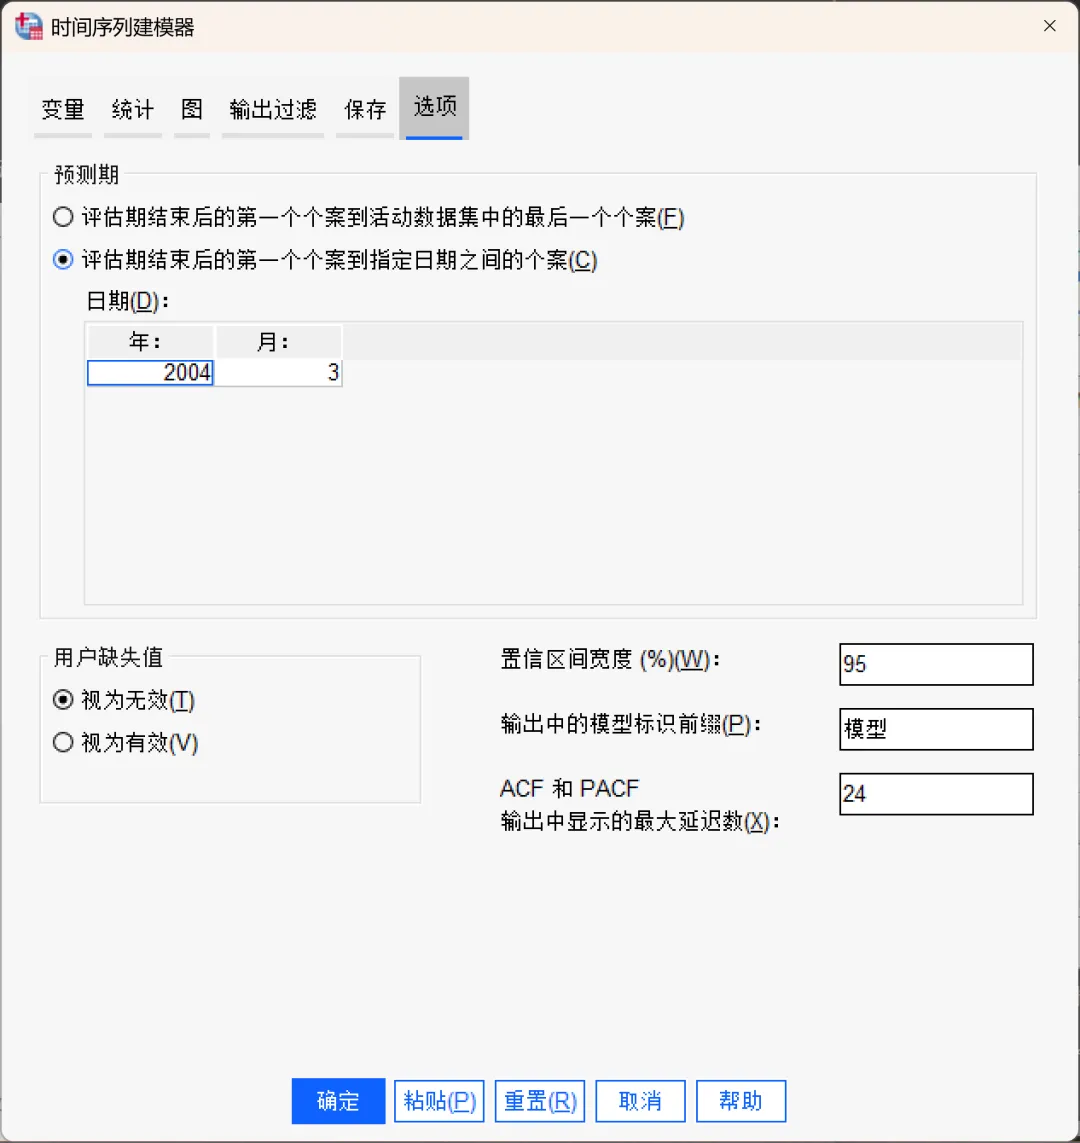
预测期 | 定义预测的时间范围:
|
用户缺失值 | 控制用户缺失值的处理方式。
以下规则适用于建模过程中缺失值(包括系统缺失值和被视为无效的用户缺失值)的处理:
|
置信区间宽度 (%) | 为模型预测和残差自相关计算置信区间。可以指定任何小于 100 的正值。默认值为95%。 |
输出中模型标识符的前缀 | 在「变量」选项卡中指定的每个因变量都会产生一个独立的估计模型。模型通过由可自定义前缀和整数后缀组成的唯一名称进行区分。可以输入自定义前缀或保留默认。 |
ACF和PACF 输出中显示的最大延迟数 | 可以设置在自相关和偏自相关表格及图表中显示的最大滞后阶数。 |
本次在「预测期」组中,选择「评估期结束后的第一个个案到指定日期之间的个案」,并在「日期」网格中输入年份2004和月份3(数据集包含从 1999年1月到2003年12月的数据。根据当前设置,预测期将为2004年1 月至2004年3月)。
设置完成,点击确定,SPSS自动运行专家建模器。
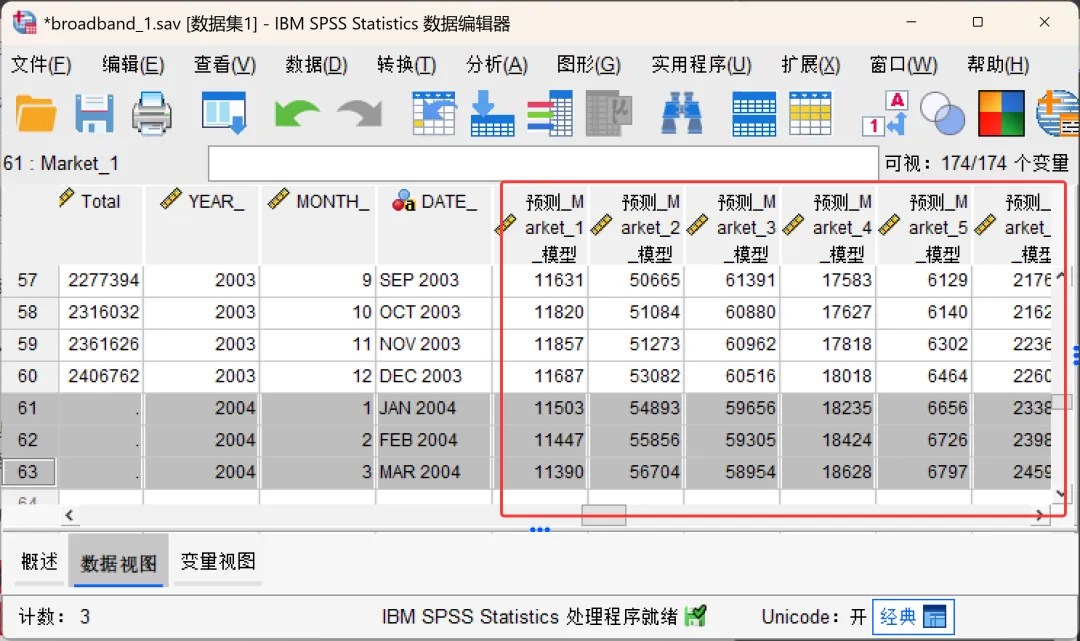
因为勾选了保存预测结果选项,因此可以看到在原始数据中共有85个表示模型预测结果的新变量(变量名称由默认前缀、关联的因变量名称以及模型标识符组成),分别对应于85个因变量序列。每个新变量都包含了估算期(1999年1月至2003年12月)的模型预测值,我们可以直观地看到模型对已知数值的拟合程度。
另外,在数据集中添加了三个新个案,其中包含2004年1月至3月的预测值,以及自动生成的日期标签。
输出结果的具体解释将在后续文章中进行介绍。