ARTICLE · 1109760
企业知识库建了就废:67% 的失败来自文档,不是模型
企业知识库建了就废:67% 的失败来自文档,不是模型
企业 AI 落地 · 知识管理 · 数据治理
1. 先看 2 个数字:67% 与 30 个百分点
据公开报道,有分析把 67% 的知识库部署失败归因于数据质量问题,而不是检索算法或模型选择。
更有说服力的是同架构对比:在模型、管线与参数都不变的前提下,治理过的语料检索准确率在 85% 到 92%,未治理的只有 45% 到 60%,差距约 30 到 45 个百分点。
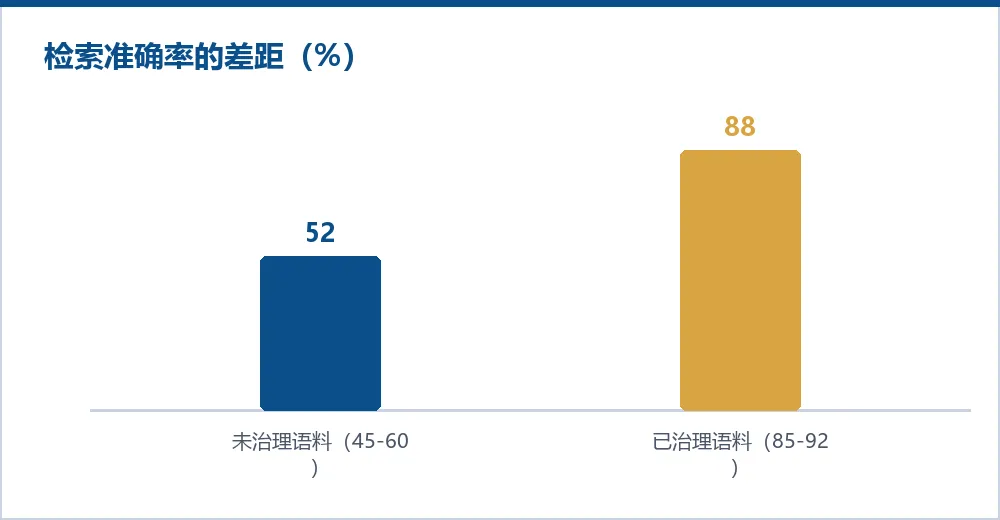
模型换不掉的问题,往往本来就该在文档层解决。
这解释了很多企业的困惑:换了更强的模型,答案还是不准。因为当2 份文档互相矛盾时,更强的模型只会更自信地把矛盾说出来。
2. 5 个最常见的失败模式
1. 矛盾不解决:3 份文档写着 3 个价格,都曾正确过,但没有任何标记说明哪份有效。
2. 没有时间信号:文档没有可靠日期,2021 年的制度与 2026 年的制度看起来同样权威。
3. 片段缺上下文:文档被切开后,「折扣适用于超过阈值的订单」这 1 句丢失了阈值定义。
4. 知识从没被写下来:大量经验活在人的对话里,系统检索不到,也不会告诉你缺失。
5. 格式不友好:扫描件、表格截图、靠单元格颜色编码的信息,对检索基本不可见。
据公开报道,有从业者的比喻是:AI 助手是 1 面镜子,照出的是你文档的真实状态。多数企业不喜欢看到的画面,然后断定镜子有问题。
把模型当替罪羊,是最容易、也最贵的选择。
3. 为什么先治理比先上线更省
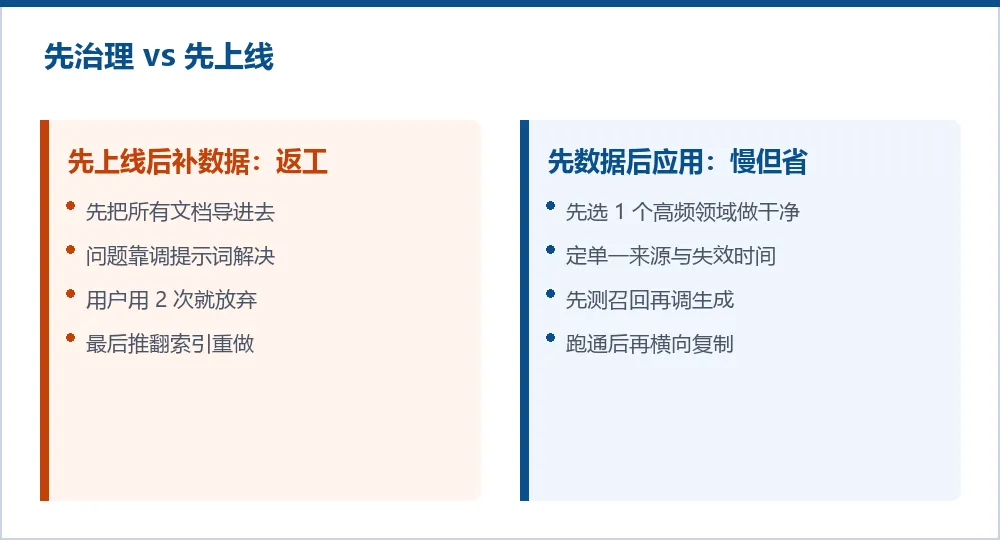
据公开报道,实践经验反复指向同 1 个结论:索引 1 万份高质量、当前有效的文档,效果好于索引 20 万份包含 2012 年旧政策的全部历史文档。
行得通的顺序是 3 段:数据治理、知识组织、AI 应用。据公开报道,跑通的项目都先补数据层,失败的项目都跳过了这 1 步。
先治理看起来慢,其实是把返工的时间提前省下来。
4. 4 个可直接做的修复动作
1. 选 1 个领域做到权威:挑提问最多的领域,例如定价、产品参数、人事制度,把它做到正确、完整、当前。
2. 为每类事实指定唯一来源:现价只存在 1 个地方,变更时在源头改,旧版本归档并移出召回范围。
3. 给每份文档配责任人与复核日期:超期内容被标记,要么重新确认,要么下架。
4. 按结构切分而不是按字符数:在标题与段落边界切,并携带小节上下文,让片段单独也能读懂。
没有责任人的内容会安静地腐化。
还要补 1 件事:把召回质量与生成质量分开测。准备 1 组真实问题与对应的正确文档,先看文档有没有被召回出来。如果正确文档不在召回结果里,再调提示词也是浪费。
5. 上线前向供应商提的 4 个问题
1. 权限在哪层生效? 答案应该是召回之前就过滤,而不是生成之后再删除。
2. 用什么指标衡量召回质量?「我们人工看看」和「看用户满意度」都不算治理。
3. 召回到的内容不足以回答时会怎样? 合格的系统会说「现有文档里找不到」,而不是编 1 个答案。
4. 索引多久更新 1 次,谁决定哪些内容进索引? 这是流程问题,不是技术问题。
这 4 个问题的答案能区分「真的做过企业级部署」和「演示效果很好」。
6. 今天就能做的 3 件事
1. 抽查 10 个问题:用真实问题问内部助手,看答案引用的文档是否仍在有效期内。
2. 列出矛盾清单:把同 1 个事实有多个版本的地方记下来,这是最高优先级的修复项。
3. 指定 1 个负责人:为知识库指定 1 位内容负责人,不必新设岗位,但必须有明确名字。
这 3 件事都不依赖预算,但它们决定了后面每次「答得不准」的抱怨有没有解。知识库的瓶颈从来不在模型,而在有人为内容负责。
① 转给需要的人
如果你身边有正在做企业知识库的负责人,把这篇转给他,第 4 节的 4 个动作可以直接执行。
② 说说你的情况
你们的知识库,最头疼的是没人更新还是答案不准?留 1 或 2,我按多数情况出 1 篇修复方案。
③ 领取资料包
《企业知识库治理清单》:含来源唯一性定义模板、责任人字段、召回质量测试集样例。
添加姜姐微信,可获取《企业AI内容获客行动万字手册》
常见问题
是不是换个更好的模型就行了?
同架构对比显示,差距主要来自语料治理而非模型。当2 份文档互相矛盾时,更强的模型只会更自信地输出矛盾。
文档太多,从哪开始治理?
从提问最多的 1 个领域开始,例如定价或产品参数。窄而可信胜过宽而矛盾,跑通后再横向复制。
多久能看到效果?
只治理 1 个领域,通常 2 到 4 周就能测出召回准确率的变化。先测召回,再调生成,顺序不要反。