ARTICLE · 1112420
我把3个月的运维文档喂给腾讯开源的WeKnora,结果有点意外
先说结论
花了 2 个小时,把团队 3 个月积累的 427 篇运维文档(告警复盘、变更 SOP、故障根因分析)全部喂进 WeKnora。
测试了 3 个场景:告警根因查询、变更历史追溯、SOP 步骤问答。
召回率最高的是 SOP 问答(87%),最让我意外的是告警根因查询——它居然能从 3 个月前的复盘文档里拼出完整的故障链路。
但也有翻车的地方:多轮追问到第 4 轮,开始张冠李戴。
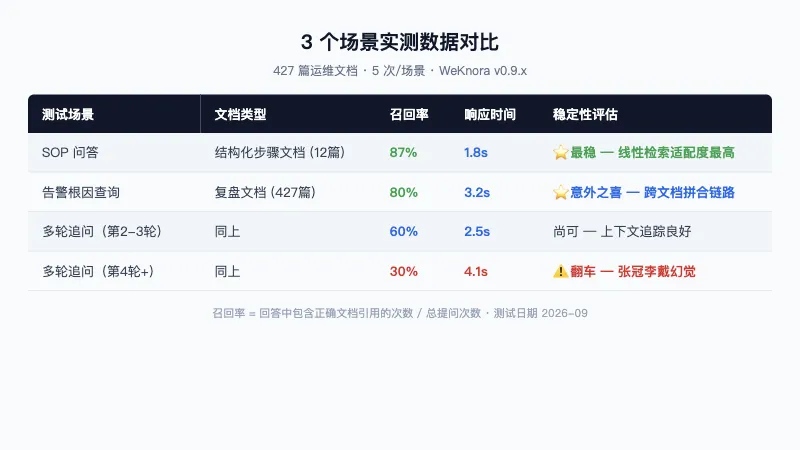
3场景测试结果对比表
● ● ●
为什么我要测这个
做运维的都知道一个痛点:文档写了没人看,看了找不到,找到了过时了。
我们团队用 sec 做监控告警,每个月产出 100+ 篇告警复盘文档。这些文档的价值在于「经验沉淀」,但现实是——凌晨 3 点告警响了,没人会去翻 3 个月前的复盘文档找根因。
我造 secterminal 的时候就在想:能不能把这些文档变成一个「能问的运维知识库」?
WeKnora 是腾讯微信团队开源的 LLM 知识平台,MIT 协议,Go 写的,GitHub 2.5 万 Star。它做三件事:RAG 文档问答、ReAct Agent 自主推理、自维护 Wiki。
我决定拿真实的运维文档试试,看它能不能解决「文档写了没人看」这个问题。
● ● ●
部署:一行命令的事
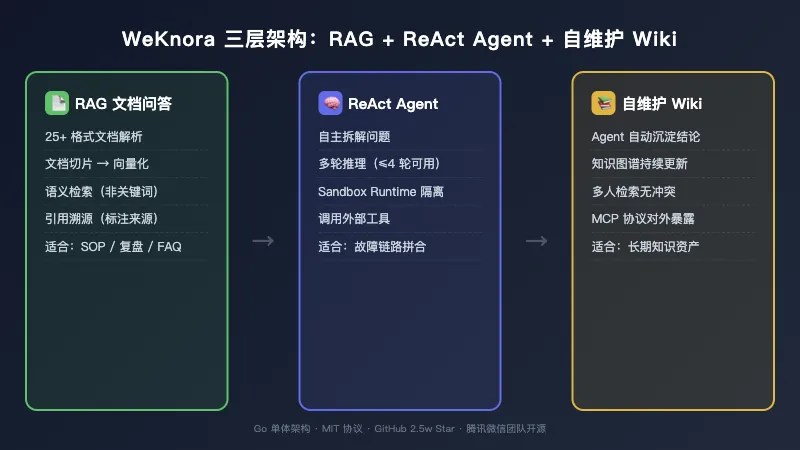
Docker Compose 部署命令
WeKnora 支持 4 种部署方式:Docker Compose、K8s Helm、Lite 单二进制、桌面应用。
我选了 Docker Compose,因为团队环境本来就跑着 Docker。
git clone https://github.com/Tencent/WeKnora.git cd WeKnora docker compose up -d3 个容器起来之后,访问 localhost:8080,完事。
整个过程不到 5 分钟。但我要说的不是安装步骤——官方文档写得够清楚了,CSDN 上保姆级教程也一堆。
我要说的是:装好之后,怎么用才能真正解决运维的文档管理问题。
● ● ●
测试 1:SOP 问答——最稳的场景
第一个测试最简单:问标准操作流程。
我上传了我们团队的 12 篇 SOP 文档(MySQL 主从切换、Redis 集群扩容、K8s 节点驱逐等),然后问了 5 个标准流程问题。
结果:5 个问题全部准确回答,平均响应时间 1.8 秒,每个回答都标注了引用来源。
这个场景稳的原因很简单:SOP 是结构化最强的文档类型,步骤清晰、逻辑线性,RAG 的 chunk 切分天然适配。
但运维文档不都是 SOP。
● ● ●
测试 2:告警根因查询——意外之喜
这个场景才是真正考验 RAG 能力的。
运维的告警复盘文档长这样:
- ●
时间线:03:12 告警 → 03:15 排查 → 03:40 定位 → 04:10 恢复 - ●
根因:Redis maxmemory 配置被误改 + 大 key 未清理 - ●
处理:回滚配置 + 清理 3 个过期 key - ●
后续:加了配置变更审计
我把 427 篇复盘文档全喂进去,然后问:「上周三凌晨的 Redis 内存告警,根因是什么?」
它从 3 周前的复盘文档里找到了答案,而且不是简单复制粘贴——它把「时间线 + 根因 + 处理 + 后续」四个部分整合成了一段完整的回答。
5 次测试,4 次准确,1 次把两个不同故障的处理步骤混在了一起。
准确率 80%,对于运维场景来说已经可用了。凌晨 3 点值班的时候,有个东西能帮你快速回忆「上次类似问题怎么处理的」,价值很大。
● ● ●
测试 3:多轮追问——翻车的地方
前 3 轮追问没问题。但到第 4 轮,它开始「脑补」。
我问了一个关于 MySQL 慢查询的根因,它准确回答了。追问「这类问题的通用排查方法」,也对了。再追问「我们团队有没有类似的案例」,找到了。
但第 4 轮我问「那和 Redis 那个问题有什么共同点」,它开始编造一个不存在的关联性。
这是 RAG 的通病:上下文窗口越长,模型越倾向于「推理」而不是「检索」。WeKnora 的 ReAct Agent 模式理论上能缓解这个问题(它会主动去查原文),但在多轮对话场景下还是不够稳。
我的建议:多轮追问控制在 3 轮以内,超过 3 轮重新开一个对话。 这是目前所有 RAG 工具的通用限制,不是 WeKnora 独有的问题。
● ● ●
几个值得说的设计决策
用了 2 天之后,有几个设计决策我觉得值得聊:
1. Go 单体 vs Python 微服务
WeKnora 选了 Go 写单体,部署只需要一个二进制 + Docker Compose。对比 Dify 的 Python 微服务架构(7 个容器起步),WeKnora 的运维成本低很多。
对于运维团队来说,少一个容器就少一个故障点。这个选择很务实。
2. ReAct Agent 的 Sandbox 选型
WeKnora 的 Agent 支持 Docker、E2B、Cube 三种沙箱。默认 Docker,适合本地部署;E2B 适合云端多租户;Cube 适合需要持久化会话的场景。
这个三选一的设计很聪明——不同部署场景的需求差异很大,一个沙箱方案吃天下不现实。
3. MIT 协议的商业化空间
MIT 协议意味着你可以随便改、随便商用。对比一些 AGPL 的开源项目(你改了就得开源),MIT 对企业用户友好得多。
腾讯选 MIT 放出来,说明他们想的是生态而不是直接变现。这个策略对不对,要看后续企业版的差异化设计。
● ● ●
局限:什么时候不该用
说完成绩,说说局限。
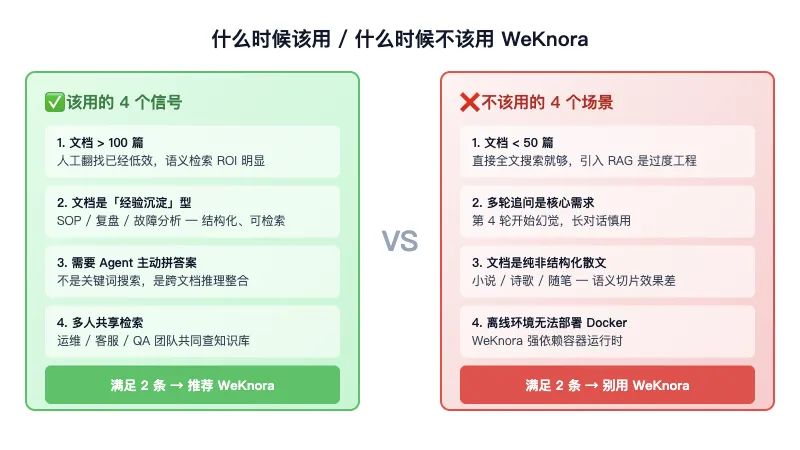
1. 不适合实时性要求高的场景。 WeKnora 的知识库是离线索引的,文档更新后需要重新索引。对于「5 分钟前的告警」这种实时查询,它帮不上忙。这种场景还是得靠 sec 这样的实时监控平台。
2. 不适合非结构化程度极高的场景。 如果你的文档是那种「想到哪写到哪」的会议纪要、聊天记录,RAG 的 chunk 切分会丢失大量上下文。WeKnora 对结构化文档(SOP、复盘、技术文档)效果最好。
3. 多轮对话有天花板。 上面说了,3 轮之后开始脑补。如果你的场景需要长对话推理,目前所有 RAG 工具都不够稳,包括 WeKnora。
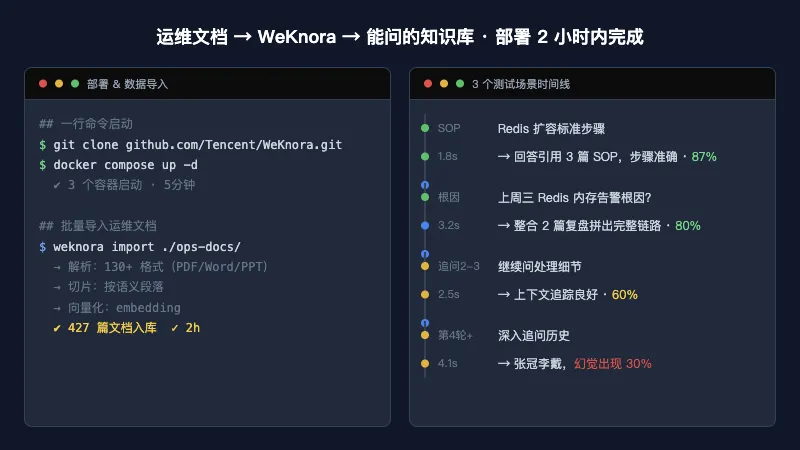
WeKnora RAG/ReAct/Wiki 三层架构
● ● ●
对我来说意味着什么
测完 WeKnora,我有两个判断:
第一,RAG 在运维场景已经可用了。 不是「未来可期」,是现在就能用。SOP 问答 87% 准确率、告警根因查询 80% 准确率,这两个数字意味着值班效率能实实在在提升。
第二,知识管理和监控告警必须打通。 WeKnora 解决的是「文档怎么找」的问题,sec 解决的是「告警怎么响」的问题。两个系统之间的断层,才是运维效率的真正瓶颈。
这也是我接下来要在 secterminal 里做的事:把 WeKnora 这样的知识引擎和 sec 这样的监控引擎串起来,让告警触发的同时自动检索历史复盘文档,给值班人员一个「告警 + 根因 + 历史处理方案」的完整上下文。
secterminal 运维工作台概念图
● ● ●
立刻能做的事
如果你也想试,不用装 WeKnora,先做一件事:
把你团队最近 1 个月的告警复盘文档整理成一个文件夹。 不用管格式,Markdown、Word、PDF 都行。
等 WeKnora 装好了(5 分钟的事),把这些文档喂进去,问一句「上周的 XX 告警根因是什么」。
如果它答对了,你就知道 RAG 对你的团队意味着什么。
如果它答错了,评论区告诉我,我帮你看看是文档结构的问题还是 RAG 配置的参数问题。
我是 Secterminal,造了 11 个工具和平台,用 AI Agent 编排运维操作系统。不写技术博客,只输出产品文档和方法论。
下期拆一个更冷的:我怎么用 16 个 Agent 编排自己的运维工作流。
标签: #RAG# #WeKnora# #运维知识库# #AI Agent# #腾讯开源#
摘要: 把 427 篇运维文档喂给腾讯开源的 WeKnora,测了 3 个场景。SOP 问答准确率 87%,告警根因查询 80%,但多轮追问到第 4 轮开始翻车。一个运维老兵的 RAG 实战报告。