ARTICLE · 1113696
传统游戏运维转AI时代运维:最大的思维壁垒是只会救火不会建体系
传统游戏运维转AI时代运维:最大的思维壁垒是只会救火不会建体系
主品类:跨品类(以SLG、MMORPG、格斗游戏多游戏矩阵为背景)次要标签:运维转型、SRE、AIOps落地、Agent平台化关键链路:告警触发→人工排查→Toil消耗→工具链建设→Agent自主调查→体系沉淀峰值事件:新服开放、跨服活动、版本更新、赛季重置核心指标:MTTR、Toil占比、告警压缩率、AI工时、误操作次数、新人上手周期平台:K8s / 多云部署形态:Agent平台 + MCP工具链 + 只读默认护栏不适用边界:本文聚焦运维认知转型与体系化建设,不覆盖游戏客户端性能与研发效能
一、痛点与场景:为什么“救火越快”反而越危险
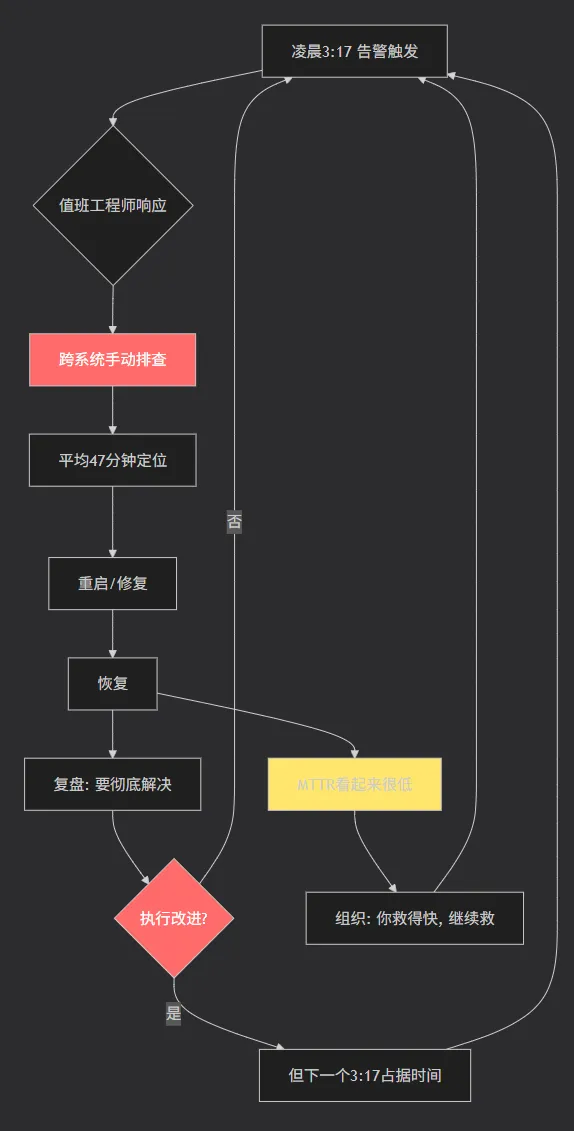
凌晨3:17,告警群炸了。值班工程师从床上弹起来,打开电脑,开始排查。40分钟后找到原因,重启服务,恢复。看了眼时间——4:02。第二天下午复盘会上,领导说“要彻底解决”。他心里清楚:今晚可能还有下一个3:17。
这个场景里,有一个被反复误读的信号:MTTR(平均恢复时间)。很多团队把MTTR当成运维能力的核心KPI,MTTR越低,说明团队越强。但真相恰恰相反——MTTR最低的团队,往往是最不健康的团队。因为他们已经习惯了在废墟上快速重建,而不是阻止废墟的产生。
行业公开的运维现状数据揭示了这个悖论:跨10+系统排查导致平均恢复时间(MTTR)高达47分钟,过半时间消耗在切换控制台与拉通人员上;告警风暴达200+条/分钟,其中80%为误报。某游戏公司的运维团队在复盘全流程后梳理出六大核心瓶颈:数据孤岛突出、工具链与流程碎片化、专家经验难以沉淀、效能价值无法量化、行业实践与人才储备不足、安全合规顾虑重重。
“救火文化”的恶性循环在于:救火是消耗性的,改进是投资性的。当你100%的时间都在消耗,0%用于投资,系统的熵只增不减。更隐蔽的问题是——救火能力越强,组织越倾向于让你继续救火,因为“你救得快”。于是,7人的运维团队支撑45个云账号、5个K8s集群、多款游戏7×24运行,成为行业常态。
AI时代运维最大的思维壁垒,不是“不会用大模型”,而是只会救火,不会建体系。救火是一种“点状响应”,建体系是一种“面状设计”。前者让你在故障发生时快速恢复,后者让你在故障发生前就让系统不具备“产生故障的条件”。
控制台命令:量化“救火文化”的真实代价
在讨论转型之前,先用数据说话。以下命令帮助团队量化“救火模式”的真实代价:
# 确认当前kubectl上下文kubectl config current-context# 预期输出: game-prod-sg-01# 列出所有游戏项目的命名空间(多游戏矩阵)kubectl get namespaces | grep -E "game-|slg-|mmo-|fighting-"# 预期输出: game-slg-ant, game-mmo-moonrise 等# 提取过去7天的告警总量(按游戏项目分组)kubectl exec -n ops-monitoring alertmanager-0 \ -c alertmanager -- \ curl -s localhost:9093/api/v2/alerts?silenced=false \ | jq 'group_by(.labels.game) | map({game: .[0].labels.game, count: length})'# 统计告警到恢复的平均时长(MTTR基线)kubectl exec -n ops-monitoring prometheus-0 \ -c prometheus -- \ curl -s "localhost:9090/api/v1/query?query= avg(alert_duration_seconds{alertstate='resolved'}) by (game, severity)"# 预期: P0级MTTR约30-47分钟# 统计人工介入的告警比例(Agent可自动化的潜力)kubectl exec -n ops-monitoring alertmanager-0 \ -c alertmanager -- \ curl -s localhost:9093/api/v2/alerts \ | jq '[.[] | select(.labels.auto_resolved == "false")] | length'# 比例越高,说明“救火”消耗的人力越不可替代# 统计误报率(告警噪音对救火文化的贡献)kubectl exec -n ops-monitoring alertmanager-0 \ -c alertmanager -- \ curl -s localhost:9093/api/v2/alerts \ | jq '[.[] | select(.labels.false_positive == "true")] | length'二、思维壁垒的本质:从“点状响应”到“面状设计”的认知断层
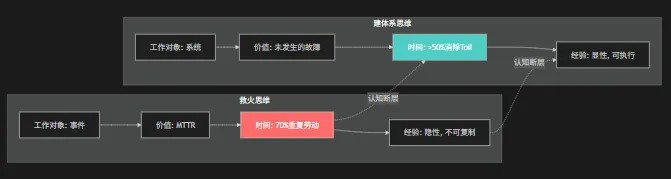
“只会救火不会建体系”的本质,是工作对象的错位。救火的工作对象是“事件”:某个Pod挂了、某个接口超时、某个数据库连接满了。建体系的工作对象是“系统”:SLO定义、容量模型、变更管理、护栏规则、经验沉淀。
这个错位带来三个认知断层:
第一,价值度量的断层。 救火的价值可以用MTTR度量,因为事件有明确的“开始”和“结束”。但建体系的价值是负向的——它体现为“没有发生的故障”。如果今天没有故障,是体系在起作用,还是运气好?这个问题很难回答。于是组织倾向于奖励“看得见的救火”,忽视“看不见的建体系”。
第二,时间分配的断层。 行业调研显示,传统运维模式下70%的精力消耗在重复的人工处理中。这里有一个关键区分:不是所有重复劳动都是Toil。Toil的定义是“手动的、重复性的、可自动化的、战术性的、缺乏持久价值的”工作。如果一个工程师每天花6小时手动处理告警,这6小时是Toil;但如果他花2小时写自动化脚本消除这6小时的Toil,这2小时是投资。问题在于,救火模式下,工程师没有“2小时”可以用于投资。
第三,经验沉淀的断层。 救火模式下,资深工程师的经验是“隐性的”——他知道“这个告警一般是因为缓存雪崩,先看Redis内存”,但这个知识存在于他的脑子里,无法被团队复制,无法被Agent执行。当他休假或离职时,这个知识就消失了。建体系的核心动作之一,就是把隐性经验显性化、可执行化、可验证化。
行业实践中已经出现了明确的应对思路:“AI只做建议,不做决定。……落地上分三层:AI输出、系统规则、人工确认。”关键不是信不信AI,而是“能不能解释、能不能回滚、有没有控制边界”。这套原则的背后,就是“建体系”的思维——不是让AI替你拍板,而是让AI帮你把决策过程结构化、可审计化。
控制台命令:度量思维断层的三个维度
# 1. 度量Toil占比(手动操作 vs 自动化操作)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s "localhost:8080/api/v1/metrics/toil?period=7d" \ | jq '{manual_ops: .manual, automated_ops: .automated, toil_percent: (.manual / (.manual + .automated) * 100)}'# Toil > 50% 说明还在“救火思维”阶段# 2. 检查SLO定义是否存在(建体系的核心动作)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s "localhost:8080/api/v1/config/slos" | jq '.[] | {service: .name, slo: .target}'# 如果没有SLO,说明还没有进入“建体系”阶段# 3. 检查告警的“投资”比例(主动巡检 vs 被动告警)kubectl exec -n ops-monitoring prometheus-0 \ -c prometheus -- \ curl -s "localhost:9090/api/v1/query?query= sum(alert_type{type='proactive'}) / sum(alert_type)"# 比例越高,说明“防火”能力越强# 4. 检查专家经验是否已显性化(Skills是否存在)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/skills | jq '.[].name'# 没有Skills,说明经验还是“隐性的”三、环境准备:搭建从“救火”到“建体系”的三座桥
转型不是“买一个AIOps工具”就能完成的。行业调研揭示了一个被忽视的成本:跨10+系统排查导致MTTR高达47分钟,过半时间消耗在切换控制台与拉通人员上。这不是“工具不够多”的问题,是“工具之间不连通”的问题。
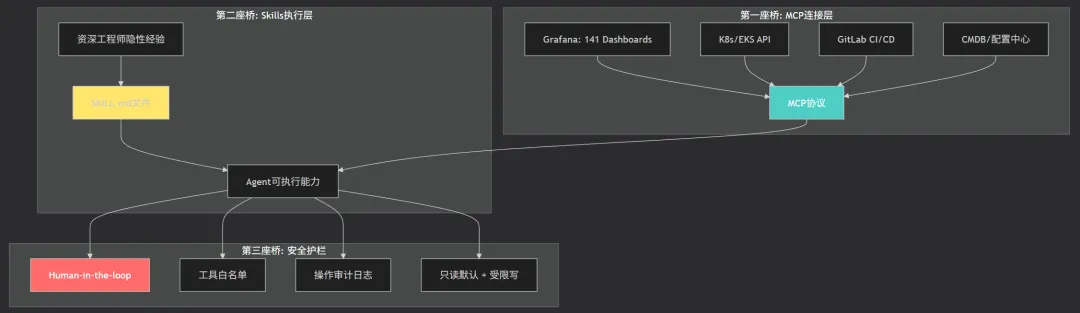
从“救火”跃迁到“建体系”,环境准备的核心是三座桥:
第一座桥:连接层(MCP协议)。将MCP协议定位为Agent的“USB接口”,将原本复杂的N×M集成复杂度降维至N+M标准化连接。行业实践中,某运维团队已基于Grafana构建了141个Dashboard的统一监控平台,Agent的Grafana MCP能力直接读取现有数据,保护既有投入,而非要求团队重建数据管道。
第二座桥:执行层(Skills编码)。将SRE核心能力从“资深工程师的隐性经验”转化为可执行的SKILL.md文件,使团队整体能力拉平至顶尖水平。行业经验也强调“故障模式库”的重要性:坚持每周作故障模式库,积累大量的故障知识库,使得AI辅助定位问题成为可能。
第三座桥:安全护栏(Human-in-the-loop)。落地原则是“AI输出→系统规则→人工确认”三层,确保关键操作需人工确认。工具白名单、操作日志全链路追踪防止越权,生产环境工具调用默认只读。
这座桥的价值在行业数据中得到验证:问题定位时长平均缩短3倍,整体运维效率提升50%,MTTR缩短70%以上。从“被动救火”转变为“主动防火”,靠的不是更多的救火能力,而是让数据流动、让经验可执行、让Agent有边界。
控制台命令:三座桥的环境验证
# 1. 验证MCP连接层(以Grafana为例)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/mcp/grafana/health# 预期: {"status": "connected", "dashboards": 141, "datasources": 66}# 2. 列出已加载的Skills(检查隐性经验是否已编码)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/skills | jq '.[].name'# 预期: ["slg_p0_diagnosis", "mmo_cross_server_check", "fighting_room_recovery"]# 3. 验证Skills的YAML定义(检查护栏是否内置)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \cat /etc/agent/skills/slg_p0_diagnosis.yaml# 内容: name, trigger_conditions, steps, mcp_tools, guardrails# 4. 检查RBAC权限(Agent只读,执行受限)kubectl auth can-i --list -n game-slg-ant \ --as=system:serviceaccount:ops:devops-agent | grep -E "get|list|watch|patch"# 预期: get/list/watch有,patch/delete无# 5. 验证审计日志链路kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/audit?last=1h | jq '.[0:5]'# 预期: 包含操作人(Agent)、目标资源、操作类型、结果四、分场景实战:从“救火”到“建体系”的三个典型场景
场景一:SLG新服开放——从“手动检查50项”到“Agent预检体系化”
痛点:SLG游戏新服开放时,流量面临10倍以上峰值。传统模式下,运维工程师需要在开服前手动检查EKS节点、RDS连接池、Redis内存、配置中心参数,检查项超过50项,耗时30分钟以上,且容易遗漏。
建体系方案:将开服前检查编码为slg_new_server_precheck Skill,Agent在开服前1小时自动触发,并行执行四类检查:K8s节点就绪状态、数据库连接池水位、缓存内存余量、配置中心版本一致性。检查完成后输出预检报告,异常项自动标注并附带修复建议。
认知跃迁:运维工程师的工作从“逐项检查”变为“定义检查项、审核预检报告、优化Skill”。这里的关键转变是——检查项本身成了可版本管理的资产。当新服出现新问题时,工程师不是“再手动检查一遍”,而是“把新检查项加入Skill”,让体系自我进化。行业数据显示,游戏开服场景MTTR从15分钟降至3分钟,运维人力节省60%。
控制台命令:新服预检Agent触发与结果
# 1. 手动触发新服预检Skillkubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -X POST localhost:8080/api/v1/skills/slg_new_server_precheck/execute \ -d '{"game": "ant", "server_id": "s42", "check_before_hours": 1}'# 2. 查看预检进度kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/skills/executions/latest \ | jq '{status: .status, progress: .progress, findings: [.findings[] | {item: .name, passed: .passed}]}'# 3. 查看异常项与修复建议kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/skills/executions/latest/failures \ | jq '.[] | {item: .check_name, severity: .severity, suggestion: .remediation, evidence: .evidence_link}'场景二:MMORPG故障闭环——从“47分钟跨系统排查”到“9分钟根因体系化”
痛点:MMORPG的故障涉及调用链超50个服务环节,跨10+系统排查导致MTTR高达47分钟。过半时间消耗在切换控制台与拉通人员上。
建体系方案:将P0级故障诊断编码为mmo_p0_rca Skill,Agent并行执行:Prometheus指标异常检测、Loki日志语义聚类、GitLab变更关联、拓扑链路分析。
认知跃迁:运维工程师的工作从“跨系统排查”变为“审核Agent的RCA结论、确认证据链完整性、优化Skill的推理逻辑”。这里的关键转变是——排查过程本身成了可复现的资产。每次故障后,不是“重新排查一遍”,而是“复盘Agent的RCA,如果错了,优化Skill”。行业实践中,资深专家经验转化为Agent固化能力后,MTTR从45分钟断崖式缩减至9分钟;新人独立值班培养周期由3个月压缩至3周。
控制台命令:MMO故障闭环的Agent调查
# 1. 触发P0故障调查kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -X POST localhost:8080/api/v1/investigate \ -d '{"alert": {"severity": "P0", "service": "mmo-cross-server", "symptom": "cross_server_latency_spike"}, "game": "moonrise"}'# 2. 查看并行调查的中间发现kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/investigations/latest/findings \ | jq '[.findings[] | {source: .source, finding: .finding, confidence: .confidence, evidence: .evidence}]'# 3. 获取最终RCA报告kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/investigations/latest/rca \ | jq '{root_cause: .root_cause, affected_radius: .blast_radius, mitigation: .mitigation, evidence_chain: .evidence}'场景三:格斗游戏房间恢复——从“手动重启”到“受限自动执行体系化”
痛点:格斗游戏的房间服务偶发泄漏,导致新玩家无法进入对战。传统模式下,工程师需要手动执行kubectl delete pod重启泄漏的房间Pod,操作可重复但需要人工判断“是否真的泄漏”。
建体系方案:将“房间泄漏检测+受限重启”编码为fighting_room_recovery Skill,Agent先执行诊断(检查房间生命周期指标、连接数异常),确认泄漏后自动执行重启(白名单操作),并记录审计日志。对于合服/清档类操作,Agent仅输出建议,等待人工确认。
认知跃迁:运维工程师的工作从“手动重启Pod”变为“定义白名单边界、审核自动执行记录、优化检测阈值”。这里的关键转变是——操作边界本身成了可审计的资产。哪些操作可以自动执行,哪些必须人工确认,这个边界定义本身就是体系的核心。行业实践中强调“AI只做建议,不做决定。……系统规则判断这个操作是否允许,人工确认或灰度执行。”
控制台命令:受限自动执行的配置与验证
# 1. 验证受限执行的权限边界kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/config/guardrails | jq '.'# 预期: auto_approved: ["restart_pod", "scale_replicas"], # human_required: ["delete_data", "merge_server"]# 2. 模拟房间泄漏检测kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -X POST localhost:8080/api/v1/skills/fighting_room_recovery/detect \ -d '{"namespace": "fighting-1v1", "threshold_minutes": 30}'# 3. 查看检测结果与建议动作kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s localhost:8080/api/v1/skills/executions/latest \ | jq '{leaked_rooms: .leaked, action: .recommended_action, auto_approved: .auto_approved}'# 4. 如果auto_approved,Agent自动执行重启kubectl get pods -n fighting-1v1 -l app=battle-server \ --field-selector=status.phase=Running | grep -v "5m"五、根因与预防:从“救火文化”到“体系文化”的闭环
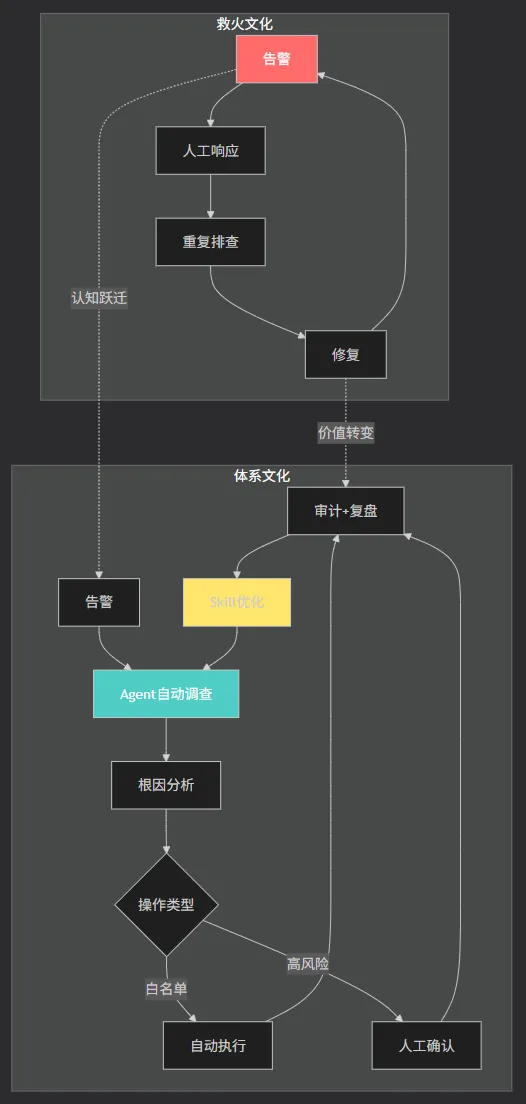
三个场景的共同根因可以归纳为一句话:“只会救火”的团队,工作对象是“事件”;“会建体系”的团队,工作对象是“系统”。事件有明确的开始和结束,可以被度量、被奖励;系统没有明确的“完成标准”,需要自己定义SLO、建立反馈循环、持续改进。
这个转变的核心不是“让Agent做更多”,而是重新定义人与Agent的分工边界。行业实践中将这一认知跃迁定义为三阶段演进:L1-预设流程智能化(确定性流程交由Agent执行)、L2-跨智能体自主编排(多Agent协作处理复杂场景)、L3-数字分身(主动发现、自主规划、智能编排)。
行业实践给出了一个务实的落地原则:“AI只做建议,不做决定”。落地分三层:AI输出(可能原因+风险提示+建议操作)、系统规则(判断操作是否允许)、人工确认或灰度执行。关键不是信不信AI,而是“能不能解释、能不能回滚、有没有控制边界”。
从“救火队员”到“体系建设者”的核心工作转变:
- 救火时代
:排查故障、修复服务、手动操作、被动响应 - 体系时代
:定义SLO与护栏规则、编码专家经验为Skills、审核Agent产出、持续优化Agent决策质量
行业度量体系提供了一个量化框架:将模型的推理时长与工具执行时长融合,定义为新的度量标准,使“智能体价值”可被核算。落地效果验证了这个方向:问题定位时长平均缩短3倍,整体运维效率提升50%,MTTR缩短70%以上。
控制台命令:从“救火”到“体系”的度量验证
# 1. 统计Agent自动调查的占比(目标: >80%的P1告警)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s "localhost:8080/api/v1/metrics/investigations?period=7d" \ | jq '{total_alerts: .total, agent_investigated: .agent, auto_resolved: .auto_resolved, human_only: .human}'# 2. 统计Skills的执行成功率与优化频率kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s "localhost:8080/api/v1/metrics/skills?period=7d" \ | jq '[.skills[] | {name: .name, executions: .count, success_rate: .success_rate, last_optimized: .last_update}]'# 3. 计算AI工时与传统工时的对比kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s "localhost:8080/api/v1/metrics/ai_hours?period=7d" \ | jq '{ai_hours: .ai, traditional_hours: .traditional, saved_hours: .saved, saved_percent: (.saved / .traditional * 100)}'# 4. 检查新人上手周期(从“月”到“周”的压缩)kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ curl -s "localhost:8080/api/v1/metrics/ramp_up" | jq '{weeks: .avg_weeks}'六、Agent评估与验证:体系建设者的“新度量体系”
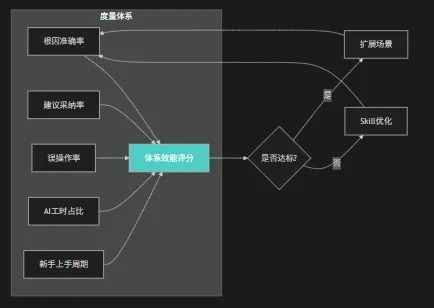
Agent平台的评估需要从“救火时代的MTTR”升级为多维度的“体系效能度量”。行业提出的“AI工时”体系提供了一个可操作的框架:不再以“修复了多少故障”衡量价值,而是以“Agent自主处理了多少决策密集型任务”来衡量。
核心评估维度包括:根因准确率(Agent输出的RCA与事后确认的一致率)、建议采纳率(工程师审核Agent建议后采纳的比例)、误操作率(Agent自动执行操作中导致新问题的比例,目标为0)、AI工时占比(Agent处理的工时占总运维工时的比例)、新手上手周期(新人独立值班的培养时间,从“月”到“周”的压缩)。
行业实践中的观点值得再次引用:“AI的核心价值是将运维从‘出了问题再找原因’推向‘更快知道可能哪里出了问题’。” 评估Agent的价值,不是评估它“做对了多少”,而是评估它“让工程师省下了多少‘找原因’的时间”——这恰恰是“建体系”思维的度量方式。
控制台命令:Agent平台评估执行
# 运行平台效能评估kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \ python /opt/agent/eval_platform.py \ --period 30d \ --output /tmp/platform_eval.json# 查看评估摘要kubectl exec -n ops-agent devops-agent-0 \ -c agent -- \cat /tmp/platform_eval.json | jq '{ rca_accuracy: .accuracy, suggestion_acceptance: .acceptance, error_rate: .error_rate, ai_hours_percent: .ai_hours, new_hire_weeks: .ramp_weeks }'七、Runbook与交验:体系建设者的运维手册
Runbook: Agent平台运维值班手册
| Agent平台健康检查 | |
| 告警触发验证 | |
| 护栏检查 | |
| Skill优化 | |
| 跨账号权限 | |
| 升级条件 |
交付物:Skills定义文件、护栏配置、AI工时度量脚本、平台健康检查脚本。
八、总结与延展
“只会救火不会建体系”,是传统运维转AI时代最大的思维壁垒。这个壁垒的根源不在于“不会用大模型”,而在于工作对象的错位——把“事件”当成了工作对象,而不是“系统”。
从“救火”到“建体系”的跃迁,本质上是三个转变:
- 价值度量
:从“MTTR有多低”到“SLO有没有达标” - 时间分配
:从“70%用于救火”到“50%以上用于消除Toil” - 经验沉淀
:从“隐性在脑子里”到“显性在Skill里”
行业实践数据显示,Agent落地后P0级告警响应及处理时长从30分钟缩减至5分钟(提升6倍),MTTR平均缩短40%+,云成本实现年优化10%-20%,新人上手周期从3个月压缩至3周。某网络公司的数据更具体:问题定位时长平均缩短3倍,整体运维效率提升50%。
认知跃迁的口诀:先定义“什么叫好”,再选工具;先编码经验,再追求自主;先划定护栏,再放开执行。 体系建设者的时间公式 = 定义目标 + 审核把关 + 持续优化,而非重复排查 + 手动修复 + 被动响应。
从“救火队员”到“体系建设者”的跃迁,不是“学更多技术”,是换一种方式定义自己的价值。
关于作者:专注于 AIOps 相关研究。欢迎关注公众号评论区交流讨论。
话题标签:#游戏运维 #AIOps #SRE转型 #Kubernetes #LLM应用