ARTICLE · 1129111
V4L2 源码深度解析(七):把缓冲区交出去——QBUF 与 PREPARE_BUF
前两篇已经把缓冲区池和映射建立起来。沿用同一个例子:VIMC 使用 640 × 480 的 RGB24,REQBUFS 成功返回四块缓冲区,每块容量为 921600 字节。应用通过 mmap 得到了四个访问地址。
不过,有了地址,并不表示采集端可以立刻往里面写。应用可能还在处理某块缓冲区的上一轮数据;驱动也不知道这一次应该使用哪几块。双方需要一个明确的交接动作。
这一篇就从这里继续:先解释准备与排队的含义,再沿 vb2_ioctl_qbuf()、vb2_core_qbuf() 进入驱动的 buf_queue(),同时看清 PREPARE_BUF 为什么能够提前完成部分工作。
主线仍是普通 CAPTURE、MMAP、vmalloc 后端,不使用 Media Request。实现采用 prepared、synced、min_buffers_needed 和固定 bufs[] 的这套代码。其他内存模式只交代分支位置;具体流启动和完成出队,留在各自的章节继续展开。
1. 内存已经能访问,为什么还要交接?
1.1 QBUF 提交的是一块可使用的存储
对采集设备,应用提交 buffer 0 的意思是:这块存储本轮可以交给采集流程,后续图像可以写到这里。这里的“空缓冲区”,是指尚未取得本轮采集结果,不是要求里面每个字节都为零。
同一块存储可以重复使用。它上一轮保存的图像即使还留在内存里,也不影响下一轮提交;采集端在正确的处理时刻写入新结果。框架真正需要记录的是:它属于哪个池、索引是多少、是否准备好、是否已经提交,以及现在由谁负责。
因此,MMAP CAPTURE 的 QBUF 不会把整个映射区当作参数再复制进内核。像素存储已经存在,这次送进去的是 struct v4l2_buffer 描述。内核用 index 找到相应管理对象,再安排本轮使用。
OUTPUT 方向则不同:应用先准备好待设备消费的数据,再提交缓冲区,并提供实际数据量等信息。本文以 CAPTURE 为主;不能把采集路径中可清零的输入字段原样照搬到输出路径。
1.2 “准备好”和“已经排队”是两个阶段
在把缓冲区送入执行队列以前,框架还要核对描述,驱动要检查容量是否满足当前格式,内存后端也可能需要处理 CPU 与设备之间的访问交接。
这些工作可以在 QBUF 内部一起完成。也可以先调用可选的 VIDIOC_PREPARE_BUF,提前准备,等真正需要提交时再调用 QBUF。
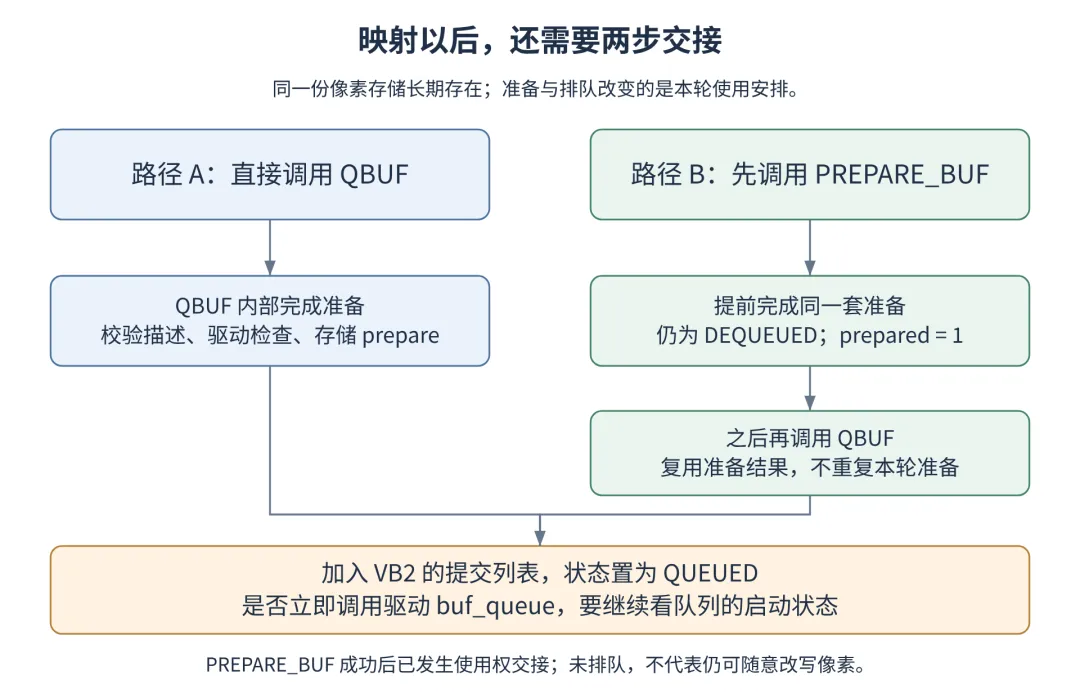
图 1:比较的是同一轮缓冲区使用。路径 A 从未准备的对象开始;路径 B 提前准备,再复用准备结果。图中只画成功主线。
PREPARE_BUF 不是申请新内存,也不是多提交一次。它只把本来可能发生在 QBUF 中的准备工作提前。对当前 MMAP 场景,存储本身并没有因此重新分配。
1.3 不能用“地址还在”判断能否继续改写
准备可能包含缓存清理或失效处理。完成准备以后,再通过映射地址改写内容,后续 QBUF 可能直接复用准备结果,不会替这些新写入重新执行全部同步。
所以,PREPARE_BUF 成功后就应遵守本轮交接约定,不能把“尚未加入队列”当成可以继续任意访问的许可。没有显式 PREPARE_BUF 时,成功 QBUF 同样表示已经提交本轮使用。
这里的使用权交接,与 q->owner 不是一个概念。前者针对某块缓冲区本轮由谁访问;后者用打开上下文身份限制某些队列操作。owned_by_drv_count 又记录真正交给驱动回调、尚未归还的对象数量。三个名称都涉及“归属”,但记录的层次不同。
接口约定可对照文末的 PREPARE_BUF 与 QBUF 页面。下面的具体检查顺序、状态与错误返回,以各函数实现为准。
2. 先发出一条最小的 QBUF 请求
2.1 单平面 MMAP CAPTURE
假设池已经建立,索引 0 有效,当前缓冲区尚未准备或排队:
structv4l2_bufferb = {0};

b.type = V4L2_BUF_TYPE_VIDEO_CAPTURE;
b.memory = V4L2_MEMORY_MMAP;
b.index = 0;

if (ioctl(fd, VIDIOC_QBUF, &b) < 0) {
    perror("VIDIOC_QBUF");
/* 按本次操作已经完成到的阶段,进入相应清理。 */
}
这次没有传 mmap 返回的指针,也没有重新填写分配地址。MMAP 模式下,核心已经知道 buffer 0 对应的存储和容量,不需要应用再告诉它“从这个虚拟地址开始写”。
type 必须与队列一致,memory 必须与当前内存方式一致,index 必须落在实际分配数量之内。结构清零使保留字段有确定的值,也避免把上一次返回的状态标志误当成这一次的请求。
对这份单平面 CAPTURE 实现,输入 bytesused 不被当作本次结果长度;准备输入时会将相应暂存值设为零。最终有效数据量应由采集处理路径填写。本例不能用 b.bytesused = 921600 来“告诉框架已经有一帧”。
2.2 多平面还要提供描述数组
多平面接口仍然通过 index 选择一整组缓冲区,但要额外提供平面描述数组:
structv4l2_bufferb = {0};
structv4l2_planeplanes[VIDEO_MAX_PLANES] = {0};

b.type = V4L2_BUF_TYPE_VIDEO_CAPTURE_MPLANE;
b.memory = V4L2_MEMORY_MMAP;
b.index = 0;
b.m.planes = planes;
b.length = VIDEO_MAX_PLANES;
这里的 b.length 是数组可容纳的元素数量,不是图像字节数。当前校验要求它不少于实际平面数,也不超过支持的上界。应用需要保证这段数组在 ioctl 执行期间有效且可按接口读写。
MMAP 路径会从内部对象取得各平面的既有长度与偏移。USERPTR、DMA-BUF 则需要按照对应模式提交外部地址或描述符和长度,不能照搬这段 MMAP 示例。
VIMC 的这个捕获节点采用单平面接口。多平面代码用于说明 V4L2 参数组织,并不是声称该节点支持多平面格式。
3. 两个入口在什么地方汇合?
VIMC 的 ioctl 操作表建立了两个连接:
.vidioc_qbuf       = vb2_ioctl_qbuf,
.vidioc_prepare_buf = vb2_ioctl_prepare_buf,
标准命令分发分别经过 v4l_qbuf() 和 v4l_prepare_buf();它们先检查格式类型,再调用对应的操作表成员。这里不重复展开前面已经介绍的 ioctl 参数编组,只保留进入 VB2 的位置。
两条调用路径可以这样阅读:
QBUF
  → vb2_ioctl_qbuf
  → vb2_qbuf
      ├─ vb2_queue_or_prepare_buf:共享检查与描述整理
      └─ vb2_core_qbuf
           ├─ 未 prepared 时调用 __buf_prepare
           └─ 加入队列,按条件移交驱动或触发延后启动

PREPARE_BUF
  → vb2_ioctl_prepare_buf
  → vb2_prepare_buf
      ├─ vb2_queue_or_prepare_buf:共享检查与描述整理
      └─ vb2_core_prepare_buf
           ├─ __buf_prepare
           └─ 填回描述;不排队
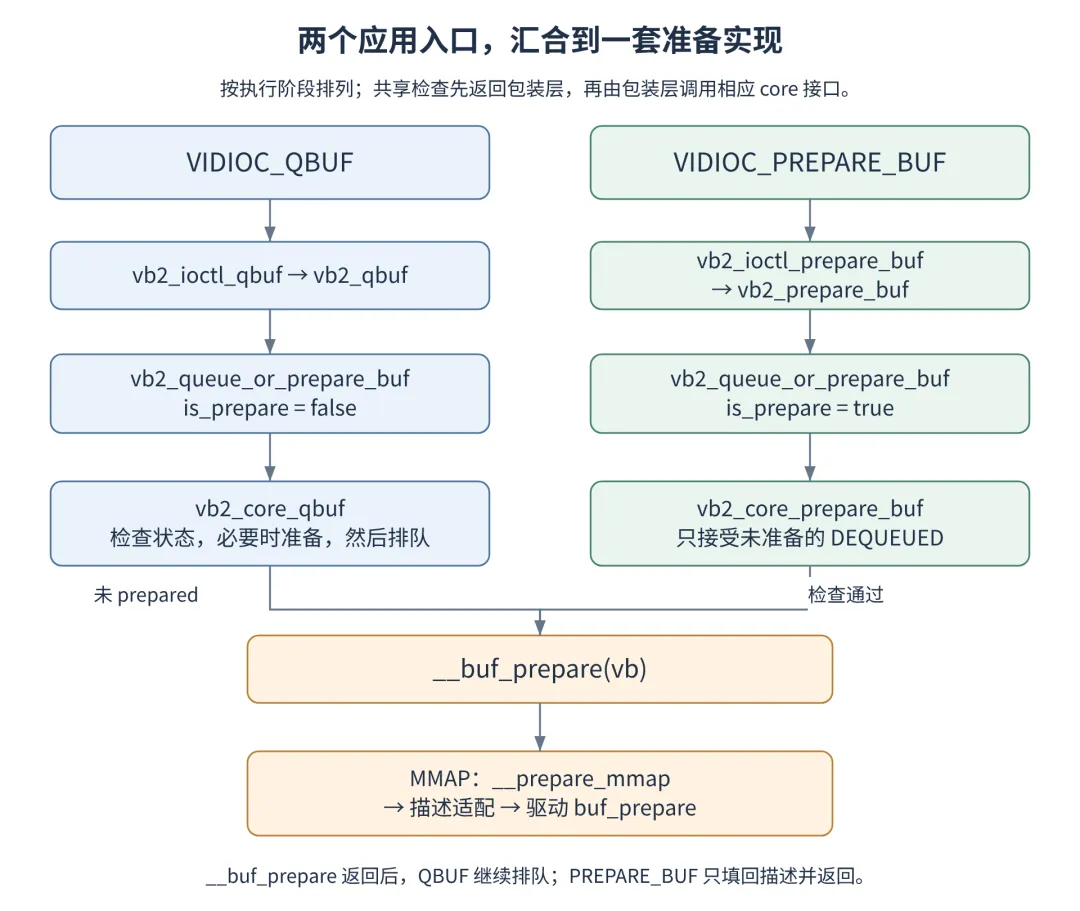
图 2:按执行阶段展开。共享检查函数返回包装层以后,由包装层继续调用对应的 core 函数;不是共享检查函数直接调用 core。
3.1 最外层先检查队列归属
intvb2_ioctl_qbuf(struct file *file, void *priv, struct v4l2_buffer *p)
{
structvideo_device *vdev = video_devdata(file);

if (vb2_queue_is_busy(vdev->queue, file))
return -EBUSY;
return vb2_qbuf(vdev->queue, vdev->v4l2_dev->mdev, p);
}
intvb2_ioctl_prepare_buf(struct file *file, void *priv,
              struct v4l2_buffer *p)
{
structvideo_device *vdev = video_devdata(file);

if (vb2_queue_is_busy(vdev->queue, file))
return -EBUSY;
return vb2_prepare_buf(vdev->queue, vdev->v4l2_dev->mdev, p);
}
两个函数都先调用 vb2_queue_is_busy()。对于本文的节点级队列,它判断的是:队列已有 owner,而且不是当前 file->private_data。冲突时返回 -EBUSY,尚未进行后续准备或入队。
这与“是不是另外一个进程”不同。dup 得到的描述符可以共用同一个打开上下文;两次独立 open 则通常不同。这里沿用文件句柄篇的结论,不再展开其分配过程。
3.2 包装层还要处理 fileio 和 Request
QBUF 的包装实现为:
intvb2_qbuf(struct vb2_queue *q, struct media_device *mdev,
         struct v4l2_buffer *b)
{
structmedia_request *req = NULL;
int ret;

if (vb2_fileio_is_active(q)) {
        dprintk(q, 1, "file io in progress\n");
return -EBUSY;
    }

    ret = vb2_queue_or_prepare_buf(q, mdev, b, false, &req);
if (ret)
return ret;
    ret = vb2_core_qbuf(q, b->index, b, req);
if (req)
        media_request_put(req);
return ret;
}
vb2_fileio_is_active() 判断 VB2 的文件 read/write 辅助机制是否已经占用队列,并不是判断“是否存在一个普通打开文件”。存在该类占用时,不能同时按这条显式队列路径操作。
普通直接排队中 req == NULL。启用 Request 时,共享检查可能取得一个请求引用;调用核心以后,包装层归还这次临时取得的引用。不要把它画成只有成功才归还。
PREPARE_BUF 的包装实现则为:
intvb2_prepare_buf(struct vb2_queue *q, struct media_device *mdev,
            struct v4l2_buffer *b)
{
int ret;

if (vb2_fileio_is_active(q)) {
        dprintk(q, 1, "file io in progress\n");
return -EBUSY;
    }

if (b->flags & V4L2_BUF_FLAG_REQUEST_FD)
return -EINVAL;

    ret = vb2_queue_or_prepare_buf(q, mdev, b, true, NULL);

return ret ? ret : vb2_core_prepare_buf(q, b->index, b);
}
这份实现明确拒绝带 V4L2_BUF_FLAG_REQUEST_FD 的显式 PREPARE_BUF,返回 -EINVAL。Request 绑定的缓冲区有自己的准备回调路径,不能认为所有叫“prepare”的工作都必须先经过这个应用命令。
4. 共享检查怎样找到并整理 buffer 0?
4.1 先确认对象存在,再解释内容
vb2_queue_or_prepare_buf() 依次检查 type、index、q->bufs[index] 是否存在、memory,再检查多平面描述数组。找到有效对象后,才继续整理本轮输入。
核心函数通常只接收已经过适配层检查的 index,并直接访问 q->bufs[index]。因此,驱动自行调用 vb2_core_qbuf() 或 vb2_core_prepare_buf() 时,必须满足这些前提,不能把底层入口当成能接收任意外部参数的完整防护接口。
但共享函数并没有替所有路径完成最终状态检查。普通 QBUF 的排队状态由 vb2_core_qbuf() 再判断;显式 PREPARE_BUF 的限制由 vb2_core_prepare_buf() 判断。检查放在哪一层,要沿真实返回关系阅读。
4.2 尚未准备时,才重新整理这一轮描述
关键部分是:
if (!vb->prepared) {
        set_buffer_cache_hints(q, vb, b);
/* Copy relevant information provided by the userspace */
memset(vbuf->planes, 0,
sizeof(vbuf->planes[0]) * vb->num_planes);
        ret = vb2_fill_vb2_v4l2_buffer(vb, b);
if (ret)
return ret;
    }
这里有两个动作。先处理缓存提示,再清空 V4L2 扩展中的平面暂存区,调用 vb2_fill_vb2_v4l2_buffer() 把本轮参数整理进去。
vbuf->planes[] 是内部扩展对象里的描述暂存区域,不是应用传入的 planes[],也不是实际像素页。对于未准备的单平面 MMAP CAPTURE,整理结果包括:长度与映射偏移取内部既有值,data_offset 为零,bytesused 暂置零;序号等结果相关字段也会按相应规则复位。
__verify_length() 对 CAPTURE 直接返回,不使用应用输入的载荷长度去证明图像已经有效;OUTPUT 才需要按其规则核对有效数据量。设备要求的最小容量还会在驱动准备回调中检查。不能把这一层的返回成功等同于全部硬件条件都已满足。
4.3 描述要经过两次不同的转换
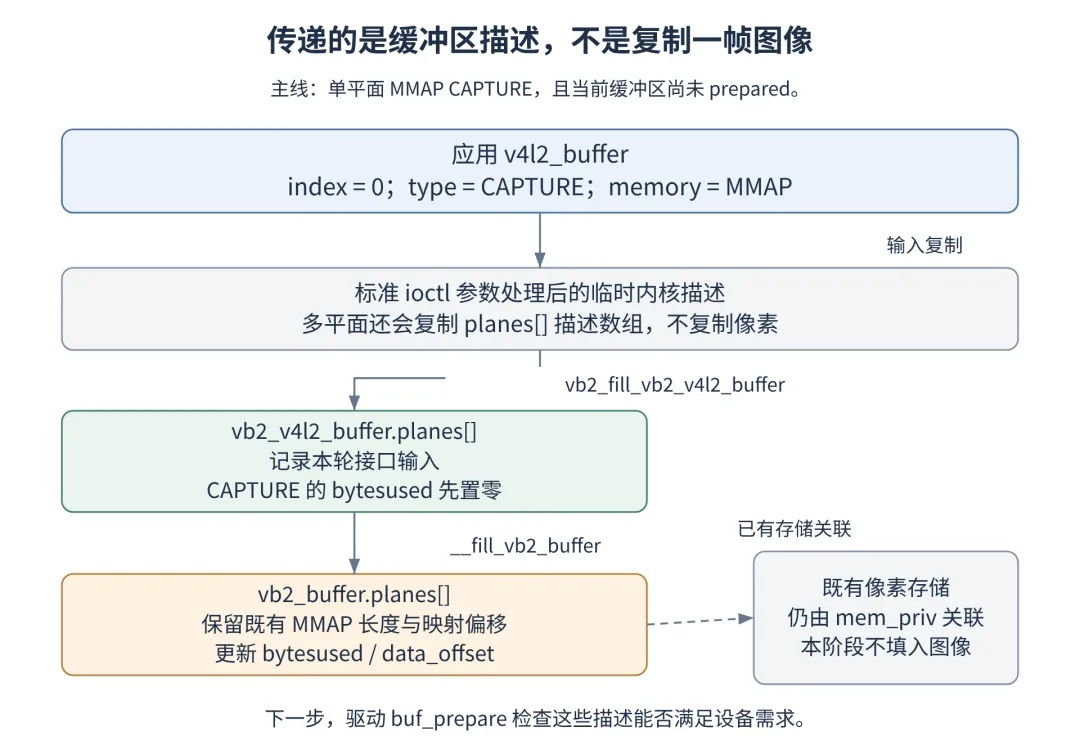
图 3:箭头表示描述的复制或整理。虚线只表示既有存储关联,不表示当前阶段复制了像素。
第一次由 vb2_fill_vb2_v4l2_buffer() 把应用接口信息整理到 vb2_v4l2_buffer 的暂存字段;第二次由 __fill_vb2_buffer() 把这些信息交给核心平面描述。
第二个函数为:
staticint __fill_vb2_buffer(struct vb2_buffer *vb, struct vb2_plane *planes)
{
structvb2_v4l2_buffer *vbuf = to_vb2_v4l2_buffer(vb);
unsignedint plane;

if (!vb->vb2_queue->copy_timestamp)
        vb->timestamp = 0;

for (plane = 0; plane < vb->num_planes; ++plane) {
if (vb->vb2_queue->memory != VB2_MEMORY_MMAP) {
            planes[plane].m = vbuf->planes[plane].m;
            planes[plane].length = vbuf->planes[plane].length;
        }
        planes[plane].bytesused = vbuf->planes[plane].bytesused;
        planes[plane].data_offset = vbuf->planes[plane].data_offset;
    }
return0;
}
对 MMAP,既有容量和存储选择信息不会在这里被应用输入替换;主要更新本轮 bytesused 和 data_offset。对另外两种内存模式,地址或描述符与长度也需要传给核心准备路径。
因此,这里不是“重复复制同一帧”。两次转换是在跨越应用接口、V4L2 扩展和通用 VB2 对象的表示方式,像素存储没有因此复制两份。
4.4 已经 prepared,并不等于完全不检查参数
vb->prepared == 1 时,共享检查仍然核对类型、索引、内存模式和平面数组;跳过的是上述缓存提示和本轮描述重新整理部分。
这也是提前准备的收益所在。但它同时带来使用约束:PREPARE_BUF 后再悄悄换掉 USERPTR 地址、DMA-BUF 描述符或载荷布局,不能假定后续 QBUF 会自动按新参数重新取得存储。
另一方面,“全部输入字段都被冻结”也不准确。普通 QBUF 在正式排队后仍会调用 copy_timestamp;OUTPUT 的时间戳和 timecode 等可在对应条件下由该适配器处理。应明确哪些字段被跳过、哪些还有独立入口,不能一句话概括成“后一次结构体完全不看”。
缓存提示也只是特定队列和内存模式允许的优化。未允许时,相关提示位会被清理。本文不启用这些提示;NO_CACHE_CLEAN 等标志不能随意添加来换取所谓的“零延迟”。
实现对照:vb2_queue_or_prepare_buf()、vb2_fill_vb2_v4l2_buffer()、__fill_vb2_buffer()、set_buffer_cache_hints() 与 __copy_timestamp()。
5. __buf_prepare:这一轮准备究竟做了什么?
5.1 先看完整的公共准备函数
staticint __buf_prepare(struct vb2_buffer *vb)
{
structvb2_queue *q = vb->vb2_queue;
enum vb2_buffer_state orig_state = vb->state;
int ret;

if (q->error) {
        dprintk(q, 1, "fatal error occurred on queue\n");
return -EIO;
    }

if (vb->prepared)
return0;
    WARN_ON(vb->synced);

if (q->is_output) {
        ret = call_vb_qop(vb, buf_out_validate, vb);
if (ret) {
            dprintk(q, 1, "buffer validation failed\n");
return ret;
        }
    }

    vb->state = VB2_BUF_STATE_PREPARING;

switch (q->memory) {
case VB2_MEMORY_MMAP:
        ret = __prepare_mmap(vb);
break;
case VB2_MEMORY_USERPTR:
        ret = __prepare_userptr(vb);
break;
case VB2_MEMORY_DMABUF:
        ret = __prepare_dmabuf(vb);
break;
default:
        WARN(1, "Invalid queue type\n");
        ret = -EINVAL;
break;
    }

if (ret) {
        dprintk(q, 1, "buffer preparation failed: %d\n", ret);
        vb->state = orig_state;
return ret;
    }

    __vb2_buf_mem_prepare(vb);
    vb->prepared = 1;
    vb->state = orig_state;

return0;
}
它同时服务于直接 QBUF、显式 PREPARE_BUF 和 Request 的准备协作,因此先保存进入时的 orig_state,而不是假定任何调用都从同一个状态开始。
对于本文的普通直接路径,进入准备前为 DEQUEUED。函数执行过程中短暂变成 PREPARING,成功后仍恢复 DEQUEUED。真正变成 QUEUED 的动作在后续核心排队代码中。
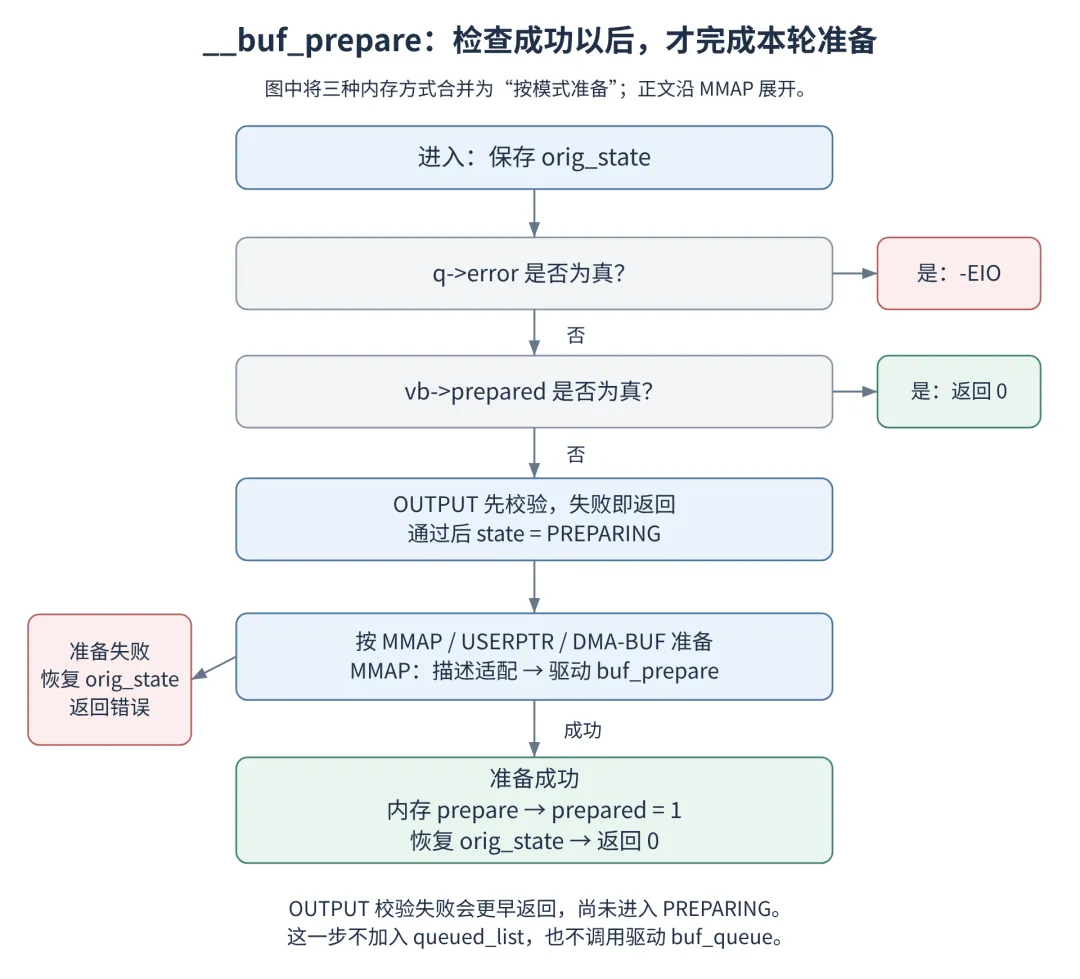
图 4:准备失败恢复进入时的状态;成功才设置准备标志。OUTPUT 的前置校验失败发生在 PREPARING 之前。
5.2 q->error 与 prepared 的检查顺序
函数先检查队列错误,再判断是否已经 prepared。于是即便对象已准备,在队列处于错误状态时也不能通过这个入口直接当作成功。
WARN_ON(vb->synced) 检查的是不合理的组合:尚未 prepared,却已经保留了内存 prepare 的记录。它只是告警,不会清除标志,也不能代替正确的清理。
OUTPUT 可选的 buf_out_validate 发生在设置 PREPARING 之前。这里失败,状态还没有进入临时准备阶段;MMAP、USERPTR 或 DMA-BUF 的实际准备则尚未执行。
5.3 MMAP 分支很短,但连接了两种职责
staticint __prepare_mmap(struct vb2_buffer *vb)
{
int ret = 0;

    ret = call_bufop(vb->vb2_queue, fill_vb2_buffer,
             vb, vb->planes);
return ret ? ret : call_vb_qop(vb, buf_prepare, vb);
}
先执行 buf_ops->fill_vb2_buffer,再执行驱动的 ops->buf_prepare。前者把接口描述整理成核心需要的形式;后者检查设备相关条件。
本分支没有 mem_ops->alloc(),也没有重新 mmap。它使用的是 REQBUFS 已建立、应用已经映射的存储。其他模式才会在各自分支中取得或复用外部存储关联,本篇不将其展开成第二条主线。
5.4 VIMC 的回调真正检查了什么?
队列操作表把 .buf_prepare 接到 **vimc_capture_buffer_prepare()**。注意实际函数名中是 buffer_prepare:
staticintvimc_capture_buffer_prepare(struct vb2_buffer *vb)
{
structvimc_capture_device *vcapture = vb2_get_drv_priv(vb->vb2_queue);
unsignedlong size = vcapture->format.sizeimage;

if (vb2_plane_size(vb, 0) < size) {
        dev_err(vcapture->ved.dev, "%s: buffer too small (%lu < %lu)\n",
            vcapture->vdev.name, vb2_plane_size(vb, 0), size);
return -EINVAL;
    }
return0;
}
VIMC 从当前格式取得 sizeimage,再用 vb2_plane_size(vb, 0) 取得平面容量。容量不足返回 -EINVAL,不会进入后面的排队和驱动接收。
这时检查的是“能不能装下”,不是“里面是否已有正确图像”。它没有解析 RGB 内容,也没有填入图像、修改序号或报告完成。VIMC 的实际填帧代码位于后续 process_frame() 路径。
既然申请时已经按照格式分配,为什么准备还要检查一次?因为准备回调属于通用设备接口,不只服务于本文最简单的首次 MMAP 分配;后续追加缓冲区、外部内存和驱动自己的布局约束都可能需要这里的校验。对当前固定格式 MMAP 主线,它提供的是再次确认,而不是另一轮分配。
6. 驱动检查以后,为什么还要内存 prepare?
6.1 先让 CPU 检查,再交给后端处理访问同步
__prepare_mmap() 成功返回后,__buf_prepare() 才调用 __vb2_buf_mem_prepare():
staticvoid __vb2_buf_mem_prepare(struct vb2_buffer *vb)
{
unsignedint plane;

if (vb->synced)
return;

    vb->synced = 1;
for (plane = 0; plane < vb->num_planes; ++plane)
        call_void_memop(vb, prepare, vb->planes[plane].mem_priv);
}
调用顺序有实际意义。驱动的 buf_prepare 在 CPU 侧仍可按约定检查或整理数据;随后内存后端的 prepare 处理下一阶段的存储交接。对于需要 DMA 缓存维护的后端,相关同步应当放在正确的交接位置,而不是先交出去再由 CPU 任意改写。
mem_ops->prepare 的类型是 void。这层调用不是“返回一个失败码再由 __buf_prepare 回滚”的接口。可失败的存储取得和设备检查必须在相应的前置路径处理。
6.2 synced 是配对记录,不是硬件状态报告
函数先设置 vb->synced = 1,再逐平面调用可选的 prepare。下次看到这个标志,会避免重复执行;配对的 __vb2_buf_mem_finish() 则在需要时清零标志并调用内存 finish。
这一字段记录的是框架走过了哪个阶段,不是在探测 CPU 缓存是否有脏数据,也不是证明所有 DMA 设备都已同步。
本例的 vb2_vmalloc_memops没有提供 .prepare 和 .finish 回调。调用包装宏会跳过不存在的可选回调,但 synced 仍然按框架规则变化。所以看到 synced = 1,不能宣称 VIMC 刚刚执行了某次 DMA cache flush。
同理,在带 DMA 的实现中,实际动作还取决于方向、分配属性、导入方式和缓存提示,不能把一次 prepare 统一翻译成“刷新全部缓存”。
6.3 几个相似名字,到这里再放在一起看
VIDIOC_PREPARE_BUF | ||
__buf_prepare() | ||
ops->buf_prepare | ||
mem_ops->prepare | ||
ops->buf_queue |
这些函数不是同一件事的不同叫法。尤其不能因为执行过驱动 buf_prepare,就断言驱动已经通过 buf_queue 收到了对象。
7. PREPARE_BUF 为什么返回后仍然是 DEQUEUED?
7.1 核心入口先限制状态和重复准备
intvb2_core_prepare_buf(struct vb2_queue *q, unsignedint index, void *pb)
{
structvb2_buffer *vb;
int ret;

    vb = q->bufs[index];
if (vb->state != VB2_BUF_STATE_DEQUEUED) {
        dprintk(q, 1, "invalid buffer state %s\n",
            vb2_state_name(vb->state));
return -EINVAL;
    }
if (vb->prepared) {
        dprintk(q, 1, "buffer already prepared\n");
return -EINVAL;
    }

    ret = __buf_prepare(vb);
if (ret)
return ret;

/* Fill buffer information for the userspace */
    call_void_bufop(q, fill_user_buffer, vb, pb);

    dprintk(q, 2, "prepare of buffer %d succeeded\n", vb->index);

return0;
}
显式 PREPARE_BUF 只接受 DEQUEUED 且尚未 prepared 的对象。对已经准备成功的同一对象再调用一次,会返回 -EINVAL,不是无条件成功的幂等接口。
这与 __buf_prepare() 中“已经 prepared 就返回 0”的短路不矛盾。外层明确拒绝重复的显式准备;普通 QBUF 则允许复用已有准备结果,而且可以直接跳过再次调用公共准备函数。
7.2 返回描述,不代表提交到执行列表
准备成功后,fill_user_buffer 将内部信息填回应用描述,但这里没有 list_add_tail(),没有增加 queued_count,也没有调用 __enqueue_in_driver()。
此时典型状态为:
state       = VB2_BUF_STATE_DEQUEUED
prepared    = 1
synced      = 1
queued_list 中不存在当前对象
驱动尚未通过 buf_queue 接收当前对象
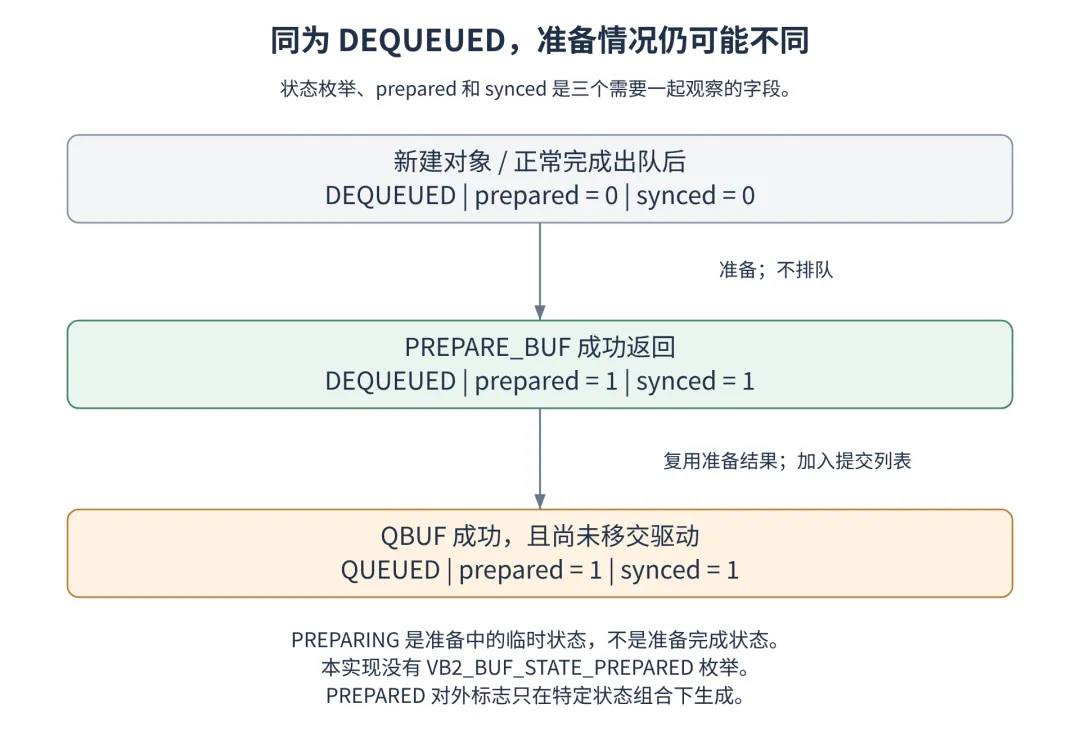
图 5:本图只描述成功的普通路径。DEQUEUED 加上准备标志,才能判断当前对象的实际阶段。
这份代码没有 VB2_BUF_STATE_PREPARED 枚举。准备完成由布尔标志记录,PREPARING 则只用于准备过程中的临时状态。不能从接口标志 V4L2_BUF_FLAG_PREPARED 推导出一个同名内部枚举。
7.3 PREPARED 对外标志怎样生成?
__fill_v4l2_buffer() 的条件为:
if ((vb->state == VB2_BUF_STATE_DEQUEUED ||
         vb->state == VB2_BUF_STATE_IN_REQUEST) &&
        vb->synced && vb->prepared)
        b->flags |= V4L2_BUF_FLAG_PREPARED;
普通显式准备成功时满足 DEQUEUED + synced + prepared,所以返回 PREPARED 标志。随后 QBUF 将状态改成 QUEUED,即使内部 prepared 仍为 1,对外也不再按这个条件设置 PREPARED;而是根据状态返回 QUEUED 等标志。
因此,“QBUF 后 PREPARED 位不见了”不表示准备被撤销。对外标志是根据内部状态组合生成的接口视图,不是每个内部字段的原样拷贝。
8. vb2_core_qbuf:真正加入队列的地方
8.1 普通排队与 Request 先分流
核心先检查 q->error,再核对直接排队与 Request 模式是否兼容。带 Request 的缓冲区可以先进入 IN_REQUEST,而不立即进入普通提交列表。本篇不设置 V4L2_BUF_FLAG_REQUEST_FD,所以继续普通路径。
这里不能忽略一个边界:共享检查返回成功后,核心仍会再次维护模式与状态约束。驱动直接调用 core 接口,不能绕过这些条件自行假定必然可排队。
对普通路径,核心状态检查和准备部分为:
if (vb->state != VB2_BUF_STATE_IN_REQUEST)
        q->uses_qbuf = 1;

switch (vb->state) {
case VB2_BUF_STATE_DEQUEUED:
case VB2_BUF_STATE_IN_REQUEST:
if (!vb->prepared) {
            ret = __buf_prepare(vb);
if (ret)
return ret;
        }
break;
case VB2_BUF_STATE_PREPARING:
        dprintk(q, 1, "buffer still being prepared\n");
return -EINVAL;
default:
        dprintk(q, 1, "invalid buffer state %s\n",
            vb2_state_name(vb->state));
return -EINVAL;
    }
正常的应用直接 QBUF 从 DEQUEUED 开始。IN_REQUEST 分支同时服务于 Request 内部后续提交,并不是普通应用可以随便重新提交任何已绑定对象的许可。
QUEUED、ACTIVE、DONE、ERROR 等状态不能在这里再直接排队。完成对象要经过正确出队,才开始下一轮;重复 QBUF 不是“再提醒驱动处理一次”。
q->uses_qbuf 的设置在这段状态判断之前。即使后续准备失败,它也不一定恢复原值。这说明失败返回不保证所有队列字段都从未改变,尤其不能在失败后任意切换 Request 模式。
8.2 正式排队修改了哪些信息?
以下是连续的主线节选:
    orig_state = vb->state;
    list_add_tail(&vb->queued_entry, &q->queued_list);
    q->queued_count++;
    q->waiting_for_buffers = false;
    vb->state = VB2_BUF_STATE_QUEUED;

if (pb)
        call_void_bufop(q, copy_timestamp, vb, pb);

    trace_vb2_qbuf(q, vb);

/*
     * If already streaming, give the buffer to driver for processing.
     * If not, the buffer will be given to driver on next streamon.
     */
if (q->start_streaming_called)
        __enqueue_in_driver(vb);

/* Fill buffer information for the userspace */
if (pb)
        call_void_bufop(q, fill_user_buffer, vb, pb);
queued_entry 是当前管理对象中的链表成员,q->queued_list 是 VB2 的提交列表。list_add_tail() 把这个成员挂进去,不移动像素页,也不分配第二个 buffer。
queued_count 增加后,记录已经提交但尚未正常出队的数量。它不是当前 DMA 正在处理的任务数。waiting_for_buffers = false 表示已经有缓冲区提交,不表示完成队列里已经出现图像。
状态在加入列表后变成 QUEUED。再根据启动情况决定是否移交驱动。最后仍需要填回接口描述,因此这个函数既修改持久的队列状态,也构造本次 ioctl 的返回内容。
8.3 为什么 copy_timestamp 出现在这里?
copy_timestamp 是接口适配回调。当前 CAPTURE 主线不靠应用提供拍摄时间戳;OUTPUT 则可能按配置复制时间戳与 timecode。
它在排队阶段仍可执行,所以提前准备后并非“一切字段都完全不再处理”。同样,pb == NULL 的分支服务于部分内部调用,此时跳过接口描述相关工作;普通应用 ioctl 会提供 pb。
源码节选保留这些条件,是为了避免把内部辅助入口的行为强行描述成全部应用调用的行为。
9. 入队之后,什么时候真正调用驱动?
9.1 尚未请求流:留在 QUEUED
应用常见做法是先 QBUF 几块,再 STREAMON。此时 streaming == 0、start_streaming_called == 0。QBUF 只完成准备和排队,当前对象暂时保留在 VB2 的提交列表。
所以,预排成功却还没有命中 vimc_capture_buf_queue(),不一定是漏调用;应先确认启动状态。PREPARE_BUF 的位置更早,它连提交列表都没有加入。
9.2 驱动启动入口已经执行:立即移交
当 q->start_streaming_called 为真,QBUF 调用:
staticvoid __enqueue_in_driver(struct vb2_buffer *vb)
{
structvb2_queue *q = vb->vb2_queue;

    vb->state = VB2_BUF_STATE_ACTIVE;
    atomic_inc(&q->owned_by_drv_count);

    trace_vb2_buf_queue(q, vb);

    call_void_vb_qop(vb, buf_queue, vb);
}
顺序是先设置 ACTIVE,再增加 owned_by_drv_count,然后调用驱动 buf_queue。这使驱动很快甚至同步报告完成时,完成入口已经能够看到相应的已接收状态。
buf_queue 返回类型是 void,不能像 buf_prepare 那样通过负返回码拒绝这次接收。驱动接收后必须安排处理或按协议归还,不能把对象丢在无人负责的位置。
ACTIVE 表示驱动已经接收对象。它可以还在驱动自己的待处理列表里,未必已经被硬件写入。反过来,真实驱动可以很快完成,QBUF 返回时对象不保证仍停留在 ACTIVE;状态图中的 ACTIVE 是移交时刻的观察,不是持续时间承诺。
9.3 已请求流,但之前数量不足:这次 QBUF 可能触发启动
第三种情况是 streaming == 1、start_streaming_called == 0。流请求已经接受,但预排数量暂未达到下限。新的 QBUF 让数量达到要求以后,会尝试真正启动:
if (q->streaming && !q->start_streaming_called &&
        q->queued_count >= q->min_buffers_needed) {
        ret = vb2_start_streaming(q);
if (ret) {
/*
             * Since vb2_core_qbuf will return with an error,
             * we should return it to state DEQUEUED since
             * the error indicates that the buffer wasn't queued.
             */
            list_del(&vb->queued_entry);
            q->queued_count--;
            vb->state = orig_state;
return ret;
        }
    }
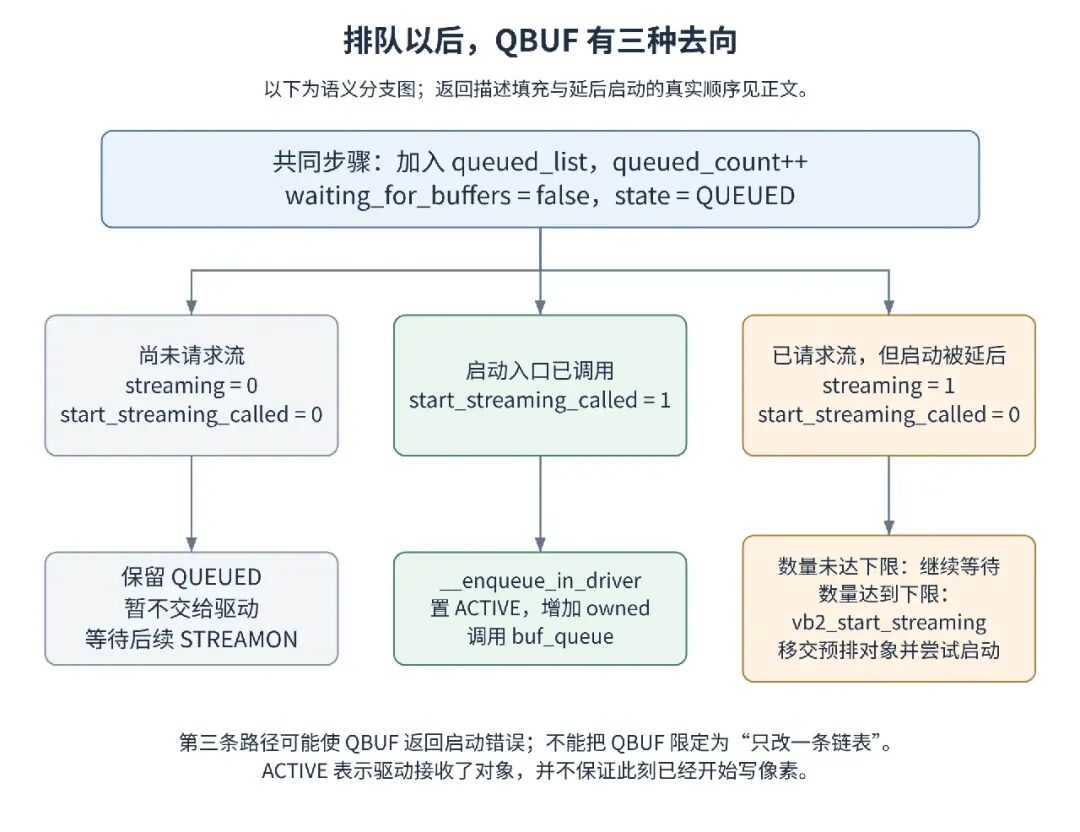
图 6:表示各场景下的主要去向,不是将所有分支画成同时成立。第二、第三条路径需要关注驱动回调和启动错误。
注意代码顺序:前一节的 fill_user_buffer 在这次延后启动检查之前。因此本轮填好的返回描述,不一定反映随后启动时发生的每一次状态变化。
这也是 QBUF 不能简单定义成“只做一个链表尾插”的原因:它可能执行准备、进入驱动,甚至触发启动并收到启动错误。下一篇会完整解析 STREAMON;这里保留这个分支,是为了讲清 QBUF 自身的行为边界。
10. 到了 VIMC,buffer 0 又被放在哪里?
实际 buf_queue 为:
staticvoidvimc_capture_buf_queue(struct vb2_buffer *vb2_buf)
{
structvimc_capture_device *vcapture = vb2_get_drv_priv(vb2_buf->vb2_queue);
structvimc_capture_buffer *buf = container_of(vb2_buf,
structvimc_capture_buffer,
vb2.vb2_buf);

    spin_lock(&vcapture->qlock);
    list_add_tail(&buf->list, &vcapture->buf_list);
    spin_unlock(&vcapture->qlock);
}
container_of() 从通用 vb2_buffer 找回外层 vimc_capture_buffer。这个扩展对象里有 VIMC 自己的 list 成员,用来加入 vcapture->buf_list。
此时存在两套关系。VB2 的 queued_entry 仍在 queued_list 中;驱动扩展中的 list 又加入 VIMC 的待处理列表。两条列表没有复用同一个 list_head,也不是把一块像素存储从一个数组搬到另一个数组。
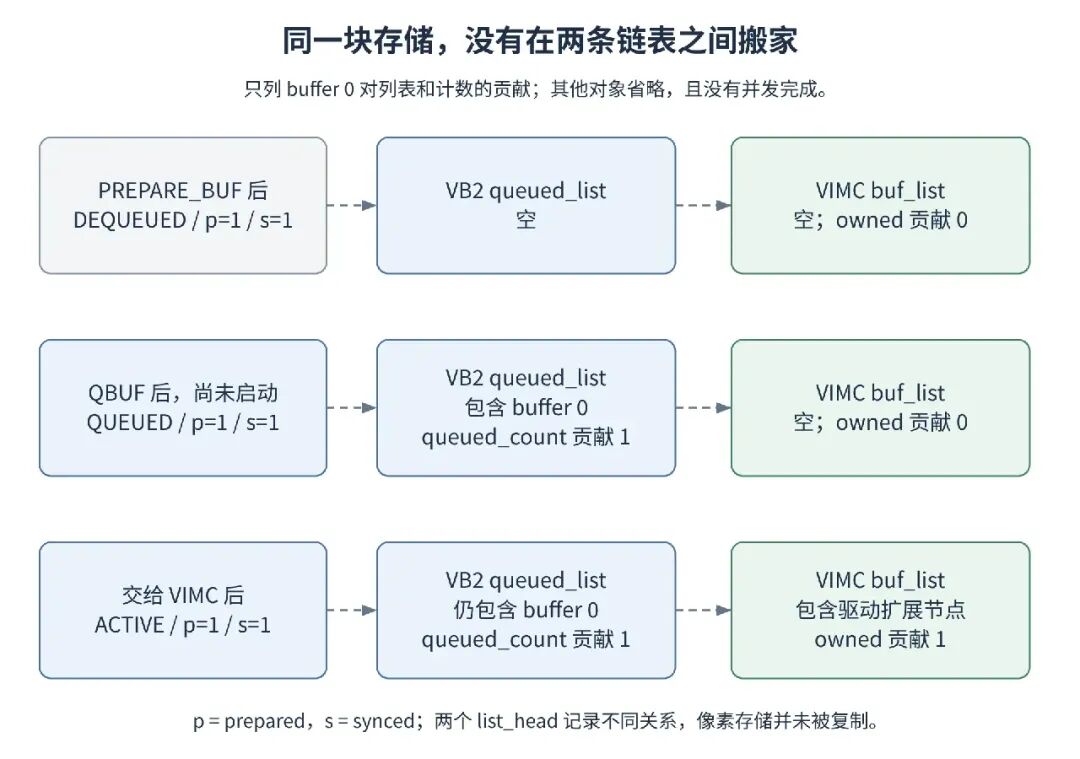
图 7:只观察 buffer 0 对各列表和计数的贡献。实际池里可以有其他缓冲区;图中没有模拟驱动的并发完成。
这里使用的 qlock 是 VIMC 自己保护私有列表的自旋锁,不是整个 ioctl 操作的互斥锁。buf_queue() 只把对象挂入待处理列表;后续由软件处理线程取走它、写入像素并调用 vb2_buffer_done()。
这条函数里没有 memcpy(),没有产生一帧,也没有执行 mmap。VIMC 的填帧实现是软件处理,不应在这一张回调图里加上并不存在的“DMA 启动寄存器”步骤。
至此可以明确区分三个节点:PREPARE_BUF 准备本轮使用;QBUF 登记提交;buf_queue 表示驱动已经接收。 三者可能发生在不同时间。
11. 失败以后,缓冲区并不总是回到同一种状态
11.1 错在进入核心之前
owner 冲突、fileio 占用、类型或内存模式不一致、索引越界、平面数组不符合要求,都会在对应的前置层返回。尚未发生本次提交列表的新增。
但“不曾入队”和“没有修改过任何内部字段”不能画等号。未准备对象的接口暂存字段可能已被整理,核心也可能已记录直接排队模式。应按实际失败点判断影响,而不是只看最后的 errno。
11.2 驱动 buf_prepare 失败
如果 MMAP 描述适配成功,但 VIMC 的容量检查失败,__buf_prepare() 恢复 orig_state,不执行成功段的内存 prepare,也不设置 prepared = 1。QBUF 不继续尾插列表。
恢复 state 不会自动撤销驱动回调自己已经产生的一切副作用。驱动在 buf_prepare 内取得的可失败附加资源,必须自行设计失败清理,不能指望框架立即为这次失败调用 buf_finish 或 buf_cleanup。
对本文正常初始化的 MMAP 对象,这种失败之后仍为 DEQUEUED / prepared=0 / synced=0。它与下一种失败留下的状态不同。
11.3 延后启动失败:本次新增对象退回去,但准备还在
假设最低需要两块,buffer 0 已经预排,STREAMON 已接受流请求,但尚未真正启动。应用再 QBUF buffer 1。
核心先准备 buffer 1,再把它加入列表。数量达到两块后,启动辅助函数先把预排对象交给驱动,再调用 start_streaming。驱动如果启动失败,应撤销已经发生的实际处理,并用 VB2_BUF_STATE_QUEUED 归还所有已接收对象。
QUEUED 归还不是一帧完成结果:它不加入 done_list,也不走正常完成的内存 finish。启动辅助函数返回错误以后,QBUF 的失败分支只摘除本次新增的 buffer 1,减少一次计数并恢复它的 orig_state。
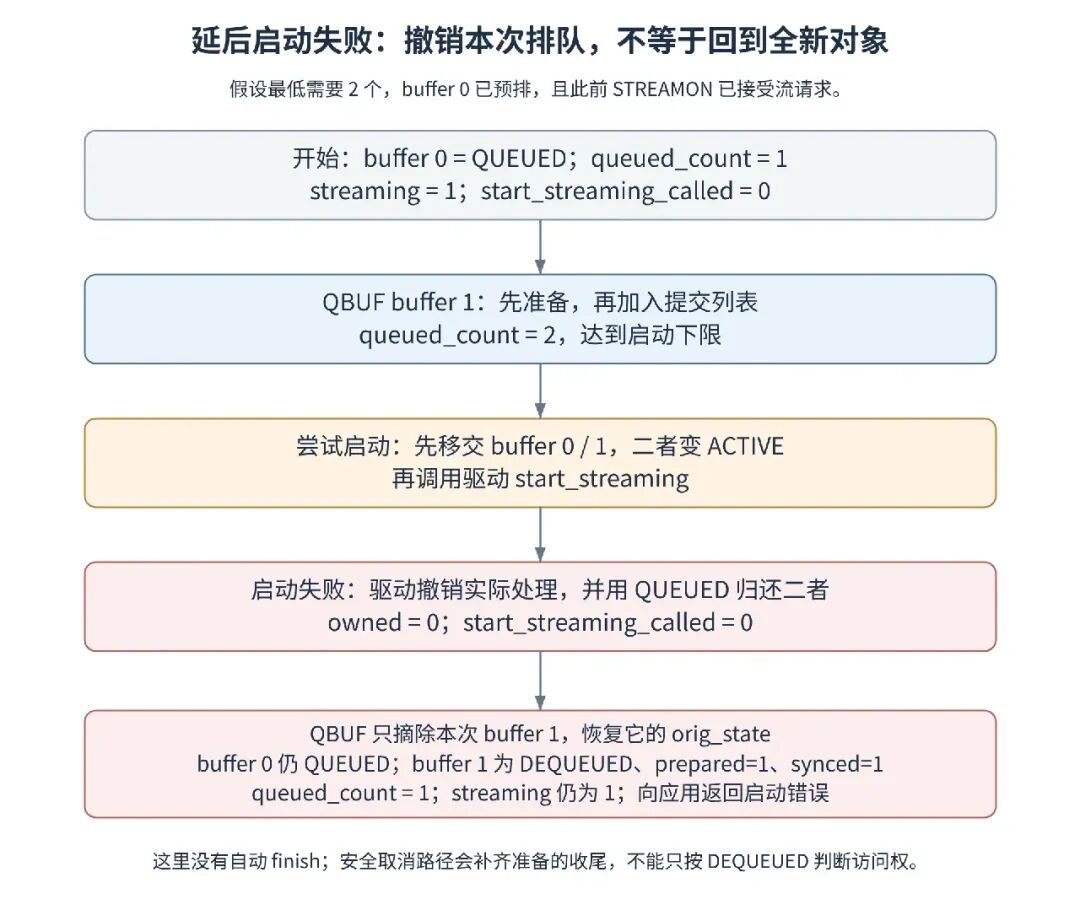
图 8:假定驱动正确按 QUEUED 归还。buffer 0 的已有提交仍然保留,buffer 1 的本次排队被撤销;两者的本轮准备未因此自动取消。
于是 buffer 1 可以呈现 DEQUEUED、prepared=1、synced=1,而不是新对象的全零准备状态。q->streaming 也不会在这个 QBUF 分支里自动清零。
这解释了一个容易误判的现象:QBUF 返回错误、对象看起来已不在队列中,仍不能只凭 DEQUEUED 就重新任意改写像素。需要根据实际状态执行安全取消或正确重试;驱动自身更不能让失败后的 DMA 或软件任务继续写入已宣布归还的对象。
11.4 回调成功,参数回写仍可能失败
标准 ioctl 层在 VB2 返回以后,还要把描述写回应用地址。回写失败可以使系统调用返回 EFAULT,即使内部准备或排队已经成功。
此时不能盲目重复 PREPARE_BUF 或 QBUF。第一次可能已经改变了状态,第二次会遇到“已经准备”或“已经排队”。本层没有为描述回写失败自动撤销全部内核状态的事务机制。
排障时应分别记录:进入的 VB2 函数、其返回值、实际对象状态,以及整次 ioctl 的最终结果。成功的内部日志不等于应用已成功收到所有描述。
11.5 不再提交了,怎样取消已经做过的准备?
没有一个通用的 UNPREPARE_BUF 应用命令来只取消任意单块准备。对这份 VB2 实现,STREAMOFF 即使在从未 STREAMON 的情况下,也会进入队列取消流程,收回已准备或预排的对象。
取消路径先按需要停止实际处理,再为仍有 synced 的对象执行内存 finish,为 prepared 对象调用可选驱动 buf_finish,最后恢复可复用状态。REQBUFS(0) 或相应关闭路径则进一步撤销缓冲区安排;它们作用于队列,不是只撤销某一个索引。
munmap() 只解除映射,不等于取消队列提交。不要先释放应用还在使用的映射,再假定任何异步消费者已经停止。
12. 操作锁保护哪里,哪些地方不自动加锁?
12.1 两个命令使用队列类选锁规则
当前命令表里,QBUF 和 PREPARE_BUF 都带 INFO_FL_QUEUE,但没有 INFO_FL_PRIO。标准分发会按队列类规则选择锁;这两项本身并不会触发统一的 V4L2 优先级比较。遇到 EBUSY,应先查 owner、fileio 和模式冲突等实际分支,不能笼统归因于“优先级不够”。
VIMC 的 q->lock 与 vdev->lock 指向同一个 vcapture->lock。标准 ioctl 路径在进入命令适配器前取得它,跨过本轮 VB2 检查、准备和排队,直到标准分发返回时释放。
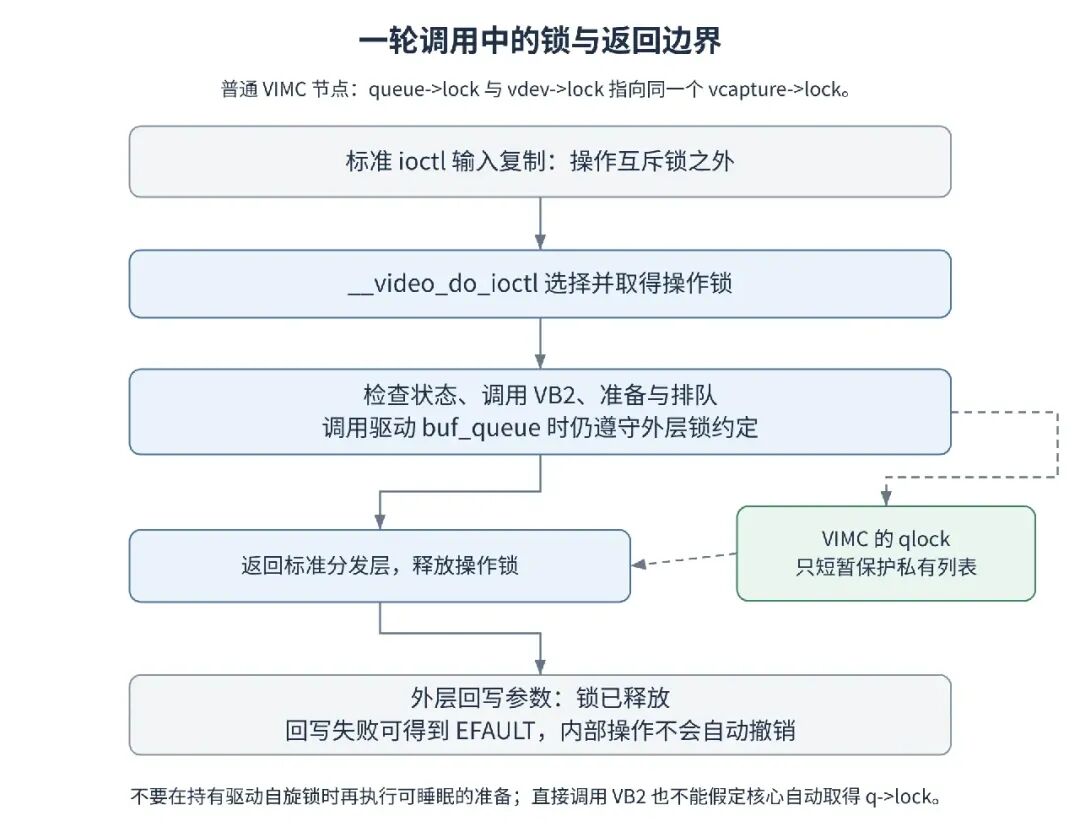
图 9:虚线表示实际调用驱动 buf_queue 时的短暂私有列表保护;不是每次 PREPARE_BUF 都会取得 qlock。
12.2 核心辅助函数不能代替调用方完成所有同步
直接调用 vb2_core_qbuf(),并不意味着它会自行获取 q->lock。驱动的自定义入口必须遵守相应串行化约定,也必须保证目标对象和相关存储仍有效。
同样,不能在持有自旋锁时任意调用可能睡眠的准备路径。USERPTR 或 DMA-BUF 准备可能取得外部存储,驱动自己的 buf_prepare 也可能涉及需要进程上下文的工作。VIMC 的 qlock 只短暂覆盖列表操作,不包住整个公共准备流程。
正常完成和 DQBUF 的锁协作有另外的路径,本篇只说明入口边界;不要把“操作互斥锁保护了 QBUF”进一步推导成所有异步完成都被同一把锁自动串行化。
12.3 两次 ioctl 不是一个原子操作
PREPARE_BUF 和 QBUF 是两个独立系统调用。第一次成功后到第二次进入之间,可以发生其他受允许的操作。使用多个线程或共享描述符时,要在应用侧维护提交顺序,不能指望内核一直替这两个调用保留操作锁。
“提前准备”适合把可预测的工作前移,但并没有把整个程序变成跨调用的原子事务。队列重建、取消和再次使用仍需要完整协议。
13. 用一次不启动采集的实验核对前半条路径
完整程序放在配套 code/qbuf_prepare_probe.c。它选择 CAPTURE 队列的当前格式,申请并映射 MMAP 缓冲区,只测试准备、预排和取消,不调用 STREAMON,也不读写映射中的像素。
实验按同一组对象执行:
申请并映射至少两块
    → QUERYBUF buffer 0:观察初始标志
    → PREPARE_BUF buffer 0:观察准备标志
    → 再次 PREPARE_BUF buffer 0:观察重复准备的拒绝
    → QBUF buffer 0:复用准备
    → 再次 QBUF buffer 0:观察重复排队的拒绝
    → QBUF buffer 1:不显式准备,走内部准备
    → STREAMOFF:取消本次未启动的预排
    → QUERYBUF:观察取消后的标志
    → munmap、REQBUFS(0)、close
程序需在空闲测试节点运行。申请、排队和取消都会改变队列状态;不启动采集不代表不会影响正在被其他操作使用的设备。对其他内核版本或自定义驱动,错误码和标志要以实际实现核对。
核心观察代码可以写成:
/* b 已根据队列类型和实际平面数初始化。 */
if (ioctl(fd, VIDIOC_PREPARE_BUF, &b) == 0) {
printf("prepared flags: %#x\n", b.flags);
}

/* 重新构造本次描述,不直接沿用全部返回标志。 */
init_buffer(&b, planes, type, 0, nplanes);
if (ioctl(fd, VIDIOC_QBUF, &b) == 0) {
printf("queued flags: %#x\n", b.flags);
}
这里的 init_buffer() 是示例程序定义的辅助函数,不是 V4L2 API。MMAP CAPTURE 重新构造描述主要填写类型、模式、索引及多平面数组,不改动已准备存储。
本实现上的预期关系是:显式准备成功出现 PREPARED;未启动时 QBUF 后出现 QUEUED,并不继续要求 PREPARED 同时置位;STREAMOFF 取消后,两者都不再表示本轮准备或提交。MAPPED 可以因映射仍存在而保留,它与上述状态不是同一维度。
编译方式:
cc -std=c11 -Wall -Wextra -Werror -O2 \
   qbuf_prepare_probe.c -o qbuf_prepare_probe
./qbuf_prepare_probe /dev/video0
仅靠这些应用输出,不能证明已经发生过某一次 cache flush 或驱动 buf_queue。要验证内部连接,可在 __buf_prepare()、vimc_capture_buffer_prepare()、__enqueue_in_driver() 和 vimc_capture_buf_queue() 观察调用次数。本文未请求流,VIMC 的后两个入口不应仅因预排就被无条件调用。
测试边界与实际执行记录见配套复核说明。编译、单线程控制流测试与真实内核、实际硬件验证是不同层次,不相互替代。
14. 读完这条路径,应当能判断哪些现象?
回到开头那四块已经映射的存储。PREPARE_BUF 可以提前完成本轮准备;QBUF 负责把对象加入 VB2 的提交安排;当启动条件允许时,buf_queue 才把它交给具体驱动。每一步改变的状态不同,实际像素仍在原来的存储中。
下一步需要完整回答的,是预排对象怎样参与启动、VIMC 的处理线程如何运行,以及启动失败怎样收回已经接收的缓冲区。本篇已经保留它与 QBUF 相接的入口,而不把“准备成功”“提交成功”“启动成功”和“获得一帧”混成同一个时刻。