ARTICLE · 1129541
AI编程工具与大模型选型?
核心提问:
中国国内软件开发工程师,现在AI编程工具与大模型组合,Codex、ChatGPT、GLM、DeepSeek、Harness、Claude、workBuddy 、Cursor 等从专业软件公司工程师编程工程实践,业余软件开发爱好者,两个大方向。5个维度:token花费成本,编程效果,迭代可控,项目大小场景,使用用户量,等5个维度角度 对比分析,给出主流的推荐方案,因为我是软件架构师,现在转型 AI编程、AI架构师,落地一些有价值的智能体,开发一些实用的软件工具、网站 进行创业实践?
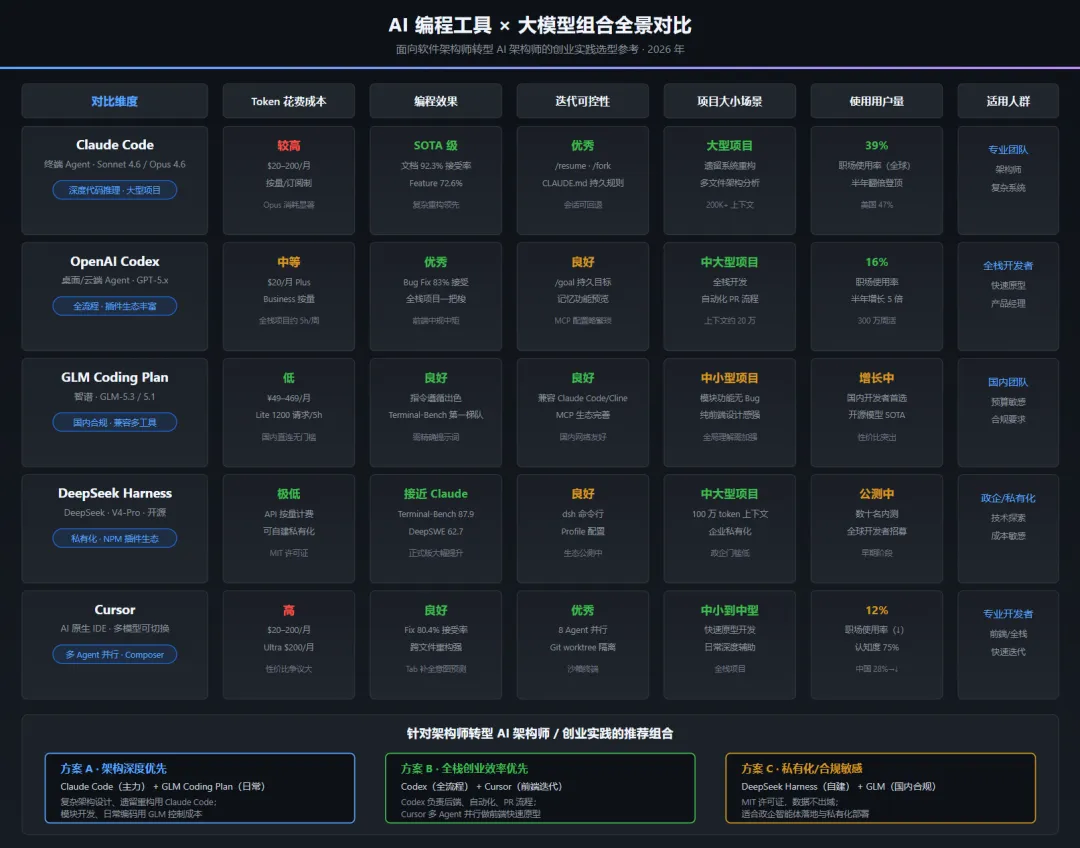
你从架构师转型做 AI 编程创业,选工具这件事本身就需要用工程化思维来拆——不是挑“最好的”,而是按场景和成本预算做组合。以下从五个维度对比分析,并给出针对你创业场景的分层推荐方案。
关键判断
当前 AI 编程工具的竞争重心,已经从“谁的 IDE 更好用”转向“谁的 Agent 能真正接手开发工作”。这意味着对你的创业场景而言,终端 Agent 的编排能力比 IDE 的交互体验更重要,因为你需要的是能自主执行长程任务的“数字员工”,而不是更聪明的自动补全。
五维度对比分析
Token 花费成本
对你的意义:创业初期烧自己的钱做产品验证,Token 成本是真实支出。GLM-5.3 和 DeepSeek 的性价比优势在“多轮迭代、反复调试”场景下会被急剧放大。
编程效果
根据 Stanford VeriBench 的独立压力测试数据(IC1 指标衡量可验证正确性):
- Codex (GPT-5.4): IC1 = 1.000
- Claude Code (Sonnet 4.6): IC1 = 1.000
- 单次调用 LLM: IC1 = 0.310
Agent 框架的加持是数量级的。同样的模型,用 Agent 模式跑,可验证正确率从 0.31 拉到 1.00。这说明工具编排方式比模型选择本身更影响最终效果。
在国产模型中,GLM-5.3 在 Terminal-Bench 3.0 得分 28.3(前代 4.6),DeepSWE v1.1 得分 66.9(前代 46.2),编程体感“接近 Claude Fable 5”。DeepSeek-V4.1-Flash 在 Terminal-Bench 2.1 拿到 90.6,甚至超过自家 Pro 版的 87.9。
迭代可控
这是你作为架构师最该关注的维度,因为创业产品需要可预测的迭代节奏。
Claude Code 的优势在于“委托制”:你给目标,它自主跑长时间任务,适合架构层面的系统重写。实测中 Opus 5.5 可在一天内完成 68 万行代码迁移,成本比 Fable 5.1 低 51%。
Cursor 的优势在于“协作制”:你留在编辑器里,每一轮修改都可见、可干预。适合前端调优、交互逻辑打磨这类需要人工判断的场景。
Codex 提供了 /goal 命令,可以设定持久目标让 Agent 自主工作数小时,但上下文限制约 20 万 token,处理大型代码库时容易“失忆”。
GLM/DeepSeek + 自建 Harness 的迭代可控性最高——因为你控制框架本身。DeepSeek 官方甚至专门为 Codex 适配了 Responses API 格式,说明“模型 + Harness 组合”是官方认可的路径。
项目大小场景
使用用户量
JetBrains 2026 年开发者生态调查(1.5 万+ 专业开发者样本):
- Claude Code: 工作场景使用率 39%,半年翻倍,美国市场达 47%
- GitHub Copilot: 21%,持续下滑
- OpenAI Codex: 16%,半年增长约 5 倍,认知度从 27% 升至 65%
- Cursor: 12%,不升反降,中国市场从 28% 跌至 16%
用户量的迁移趋势很明确:Agent 形态的工具正在吃掉 AI IDE 的份额。Cursor 的问题不是产品不好,而是“AI IDE”这个产品范式的红利期正在被“终端 Agent + 可委托任务”取代。
给你的分层推荐方案
基于你的背景——软件架构师,创业做智能体和实用工具,预算敏感,需要长程任务能力——推荐以下组合:
主力方案:GLM-5.3 + 自建/开源 Harness
理由:你是做智能体创业的,核心能力应该沉淀在自己的编排框架里,而不是被绑定在某个闭源 IDE 中。GLM-5.3 提供开源权重(发布两周后开放),你可以做本地部署或私有化调优,这对创业产品的差异化至关重要。同时它的 Token 效率优于 Claude,在批量跑 Agent 任务时成本可控。
Harness 层面可以用 OpenCode 作为起点——它支持 75+ 模型、开源、LSP 自动加载、插件生态已开始涌现。
辅助方案:Claude Code (Opus 5.5) 用于“硬骨头”
理由:当遇到需要深度重构、大型代码库审计、或 GLM 反复调试不通的复杂问题时,Claude Code 的长程任务能力目前仍是断层领先。Opus 5.5 价格比 Opus 5 降了 20%,缓存读取降了 60%,作为“按需调用”的攻坚工具,边际成本可以接受。
快速原型方案:DeepSeek-V4.1-Flash API 直调
理由:当你需要快速验证一个想法、写一个工具脚本、或做 Demo 时,DeepSeek 的成本几乎可以忽略。Terminal-Bench 2.1 得分 90.6,能力足够覆盖大部分中小任务。
暂不推荐作为主力
Cursor:用户量下滑趋势明显,且其核心价值(AI IDE 交互)对“做智能体产品”的架构师来说,边际效益在递减。你的产品本身可能就是下一个“Cursor”,不需要把时间花在另一个 IDE 的熟练度上。
Codex:20 万上下文限制对架构级任务太致命,且默认只能跑 GPT 系列模型,灵活性不足。
一句话总结
用 GLM-5.3/DeepSeek 做日常迭代和产品级 Agent 任务,
用 Claude Code 攻坚复杂系统重构,把省下的 Token 预算投入到你自己的 Agent 编排框架的打磨上。
你的核心竞争力不应该是“会用哪个工具”,而是“能设计出什么样的多 Agent 协作系统”。