ARTICLE · 1131100
第六讲:编程与软件开发智能体(下)
第六讲:编程与软件开发智能体(下)
这是我精读卡耐基梅隆大学(CMU)公开课「AI Agents(11-768)」系列第六讲的下集。在往下读之前,先快速回顾前五讲以及第六讲前两集 —— 每一讲我都写了中文精讲,建议连起来看: 先用一句话把整讲的世界观接起来: 上集解决了「会写代码的模型」,中集把它放进了「定位—编辑—验证」的循环并讲了训练场。下集把视野放宽 —— 看这套能力在前端和更广义的软件开发里怎么延伸,再落到一个更前沿的方向:让模型预测代码的行为,最后收束成一份设计清单。
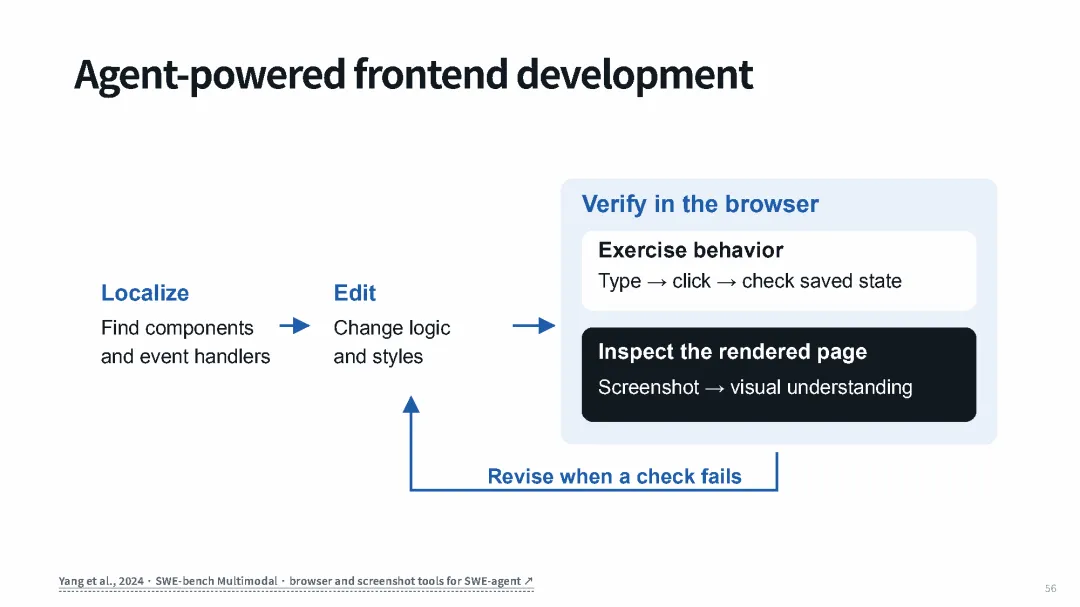
前端开发有个专门的 benchmark:SWE-bench Multimodal(只聚焦修前端 bug,不是从零造前端)。做多模态前端模型有两点不同: 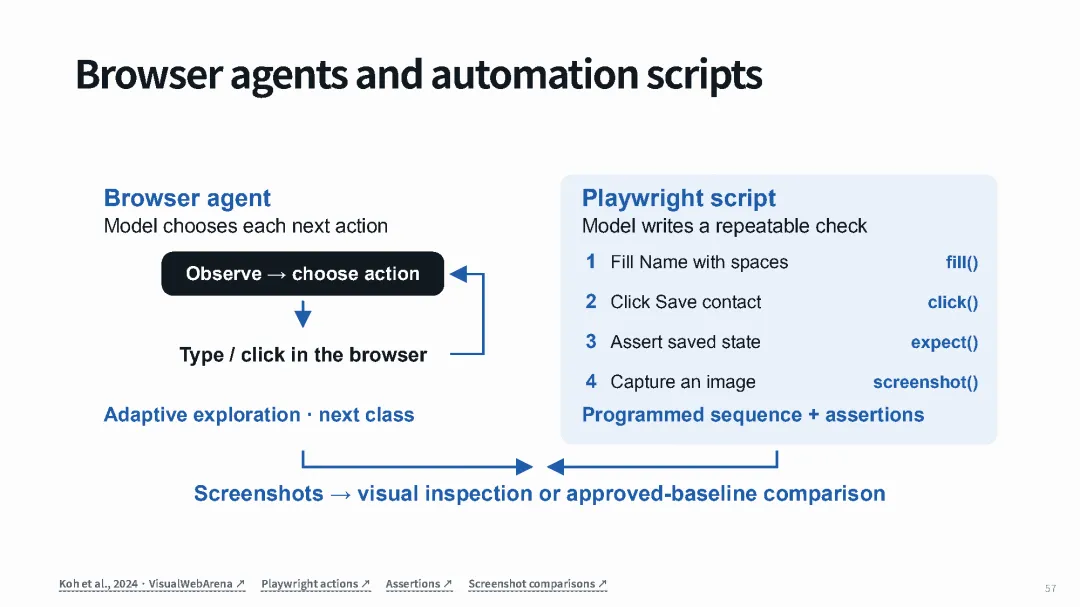
一种是用 GUI 智能体作为编程智能体的组件(GUI 智能体是下节课的主题);另一种是写脚本测 GUI—— Playwright 是常用的 GUI 测试库。 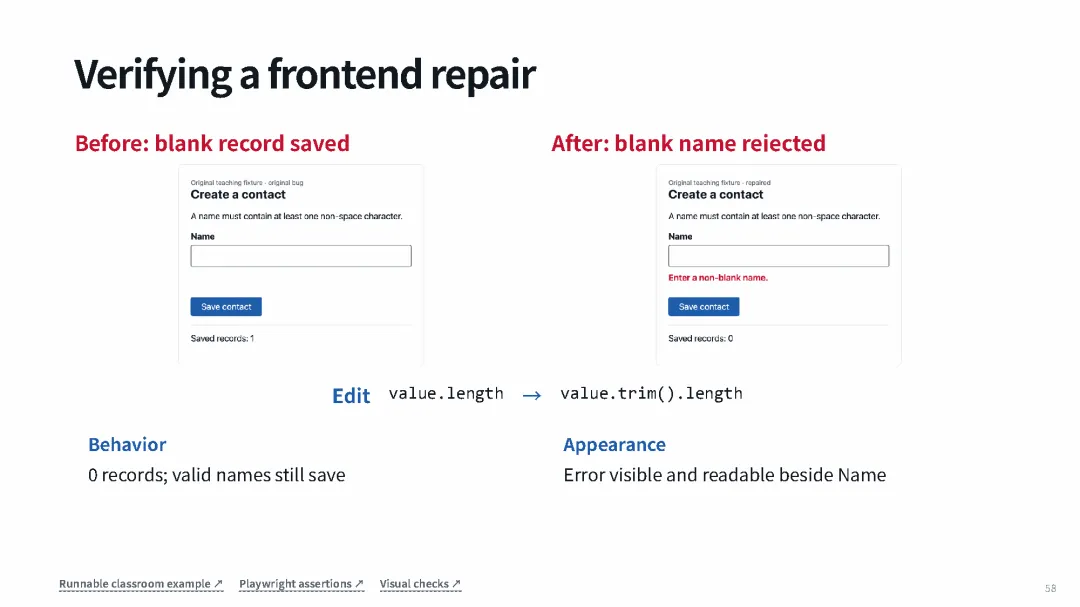
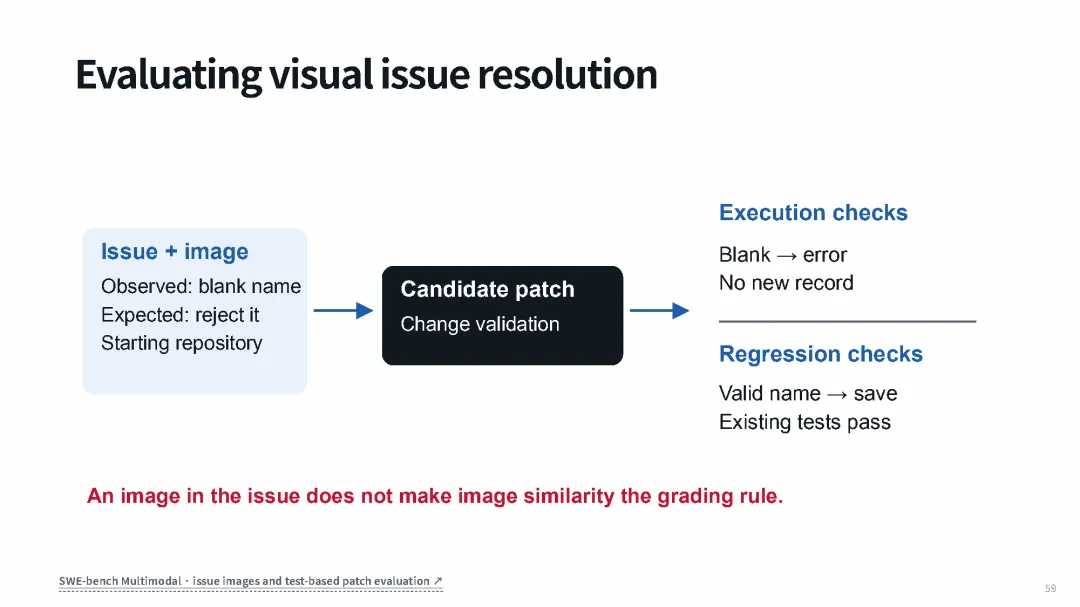
一个很震撼的结果:几个月前有个流行模型 GLM(GLM 4.5/4.6 一代)不是多模态模型,却在前端设计 arena 拿了第一。这动摇了 Neubig 的假设 ——做好前端编程智能体,到底需不需要多模态?他仍认为多模态大概率重要,但这个反例很值得琢磨。(注意:issue 里带张图,不意味着「图像相似度」就是评分标准 —— 最终还是靠执行检查和回归测试。)
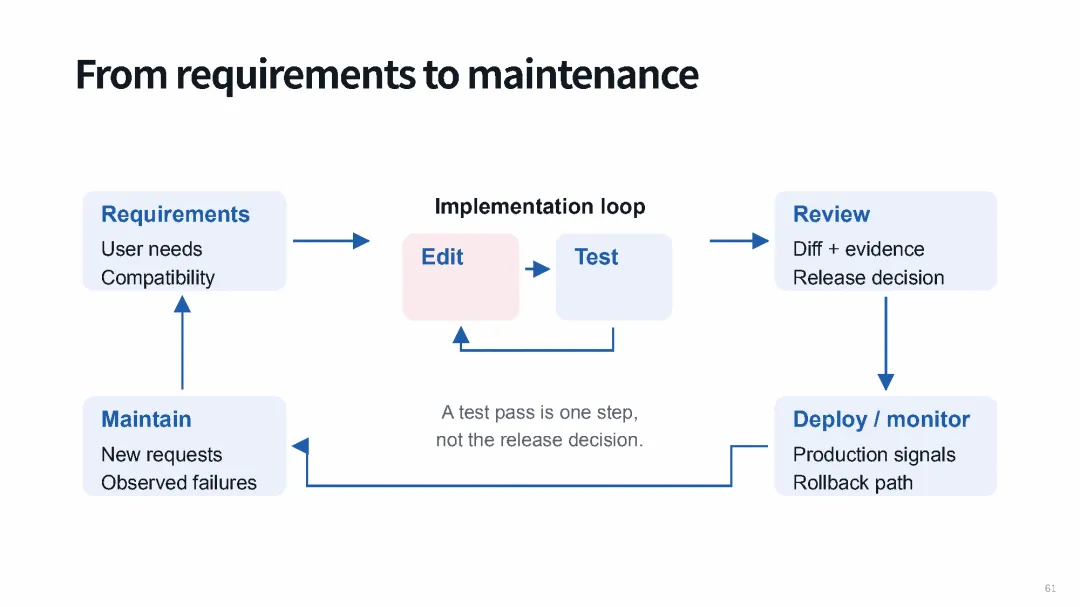
「内循环 vs 外循环」:前面讲的内循环是修 bug、测试这套迭代。而外循环是其余一切 —— 代码评审、部署监控、维护、规划与需求。理想上我们希望智能体都能帮上忙,但这些更难定义、也更难找训练数据。 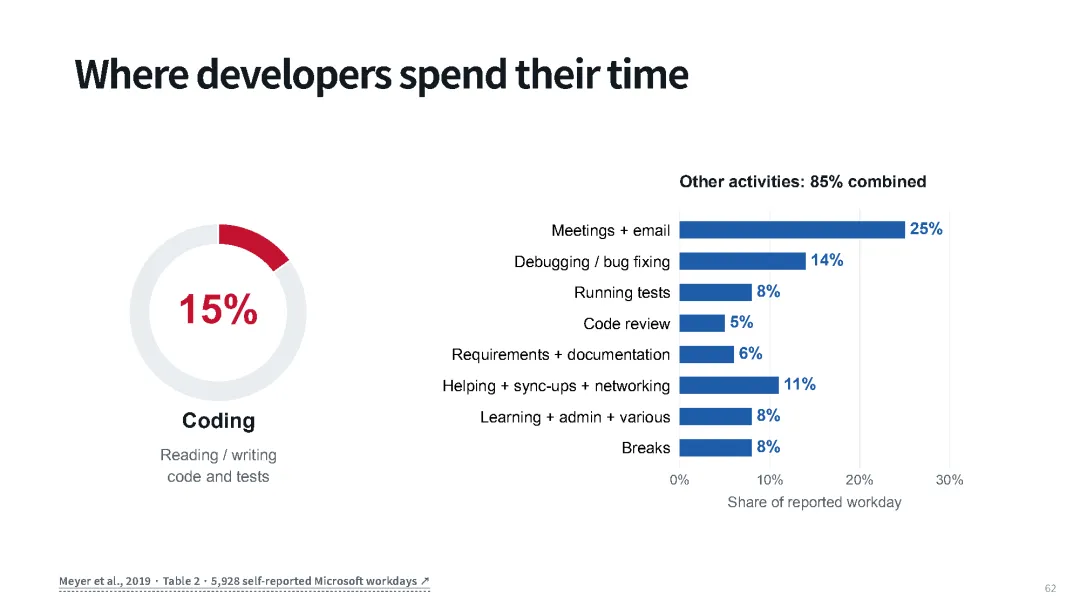
微软 2019 年一项对 5928 个工作日的调查显示:开发者只有 15% 的时间在真正读写代码,其余 85% 是会议邮件(25%)、调试(14%)、跑测试(8%)、评审、需求文档等。所以软件开发里「不是写代码」的那部分才是大头。 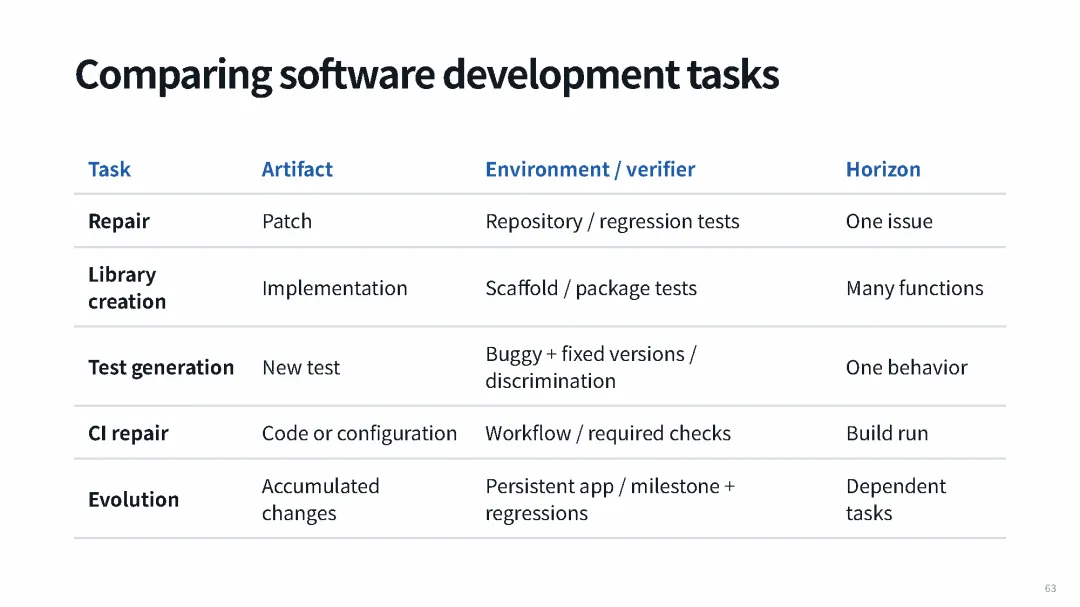
于是可以把软件开发任务谱系化,每类任务有不同的产物、环境/验证器、时程。逐一看几个: 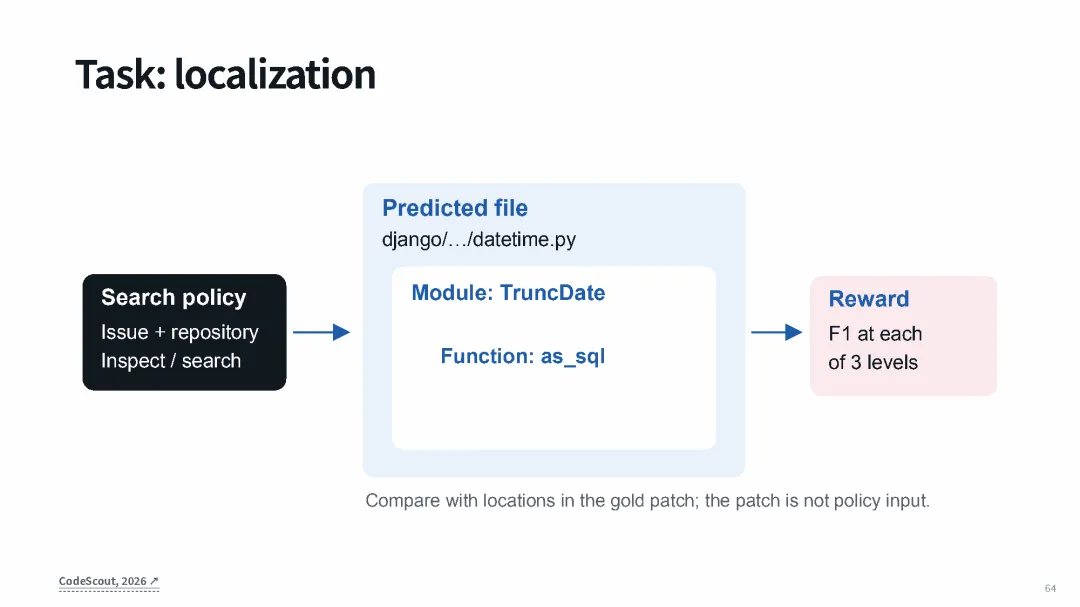
定位(CodeScout):专门训一个擅长「定位到文件/模块/函数」的模型,用 F1 做奖励。Neubig 说这个适合做课程 project 里的 RL 题目—— 像编程智能体,但更可控、小模型也能做。 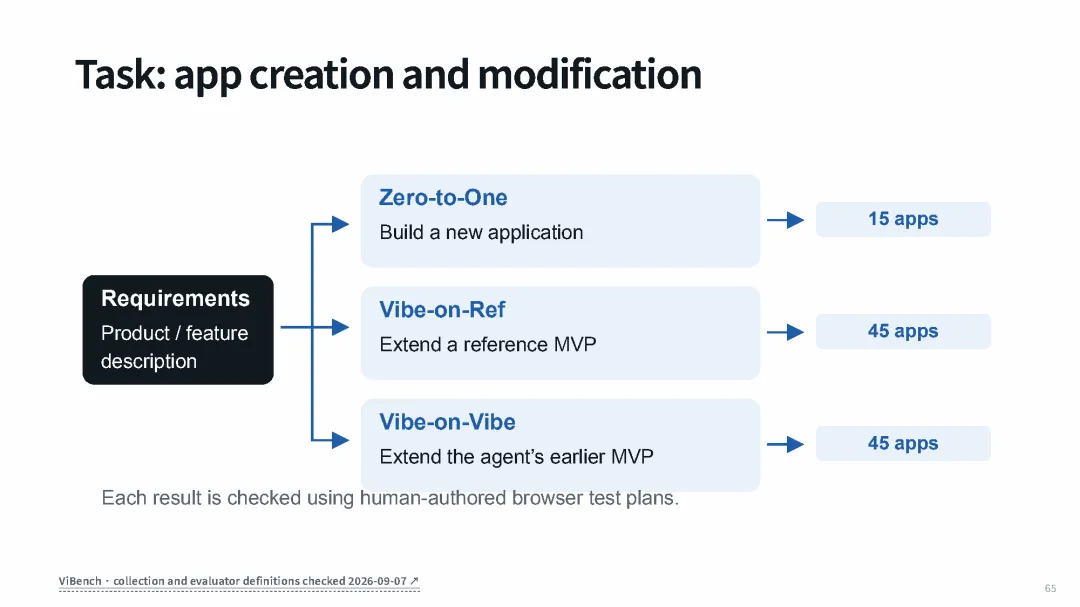
App 创建(ViBench):评估智能体「Vibe Coding」能力(从零造、扩展参考 MVP、扩展自己的 MVP)。难点在怎么正确评估—— 需要好的验证器(这里用人工编写的浏览器测试计划)。 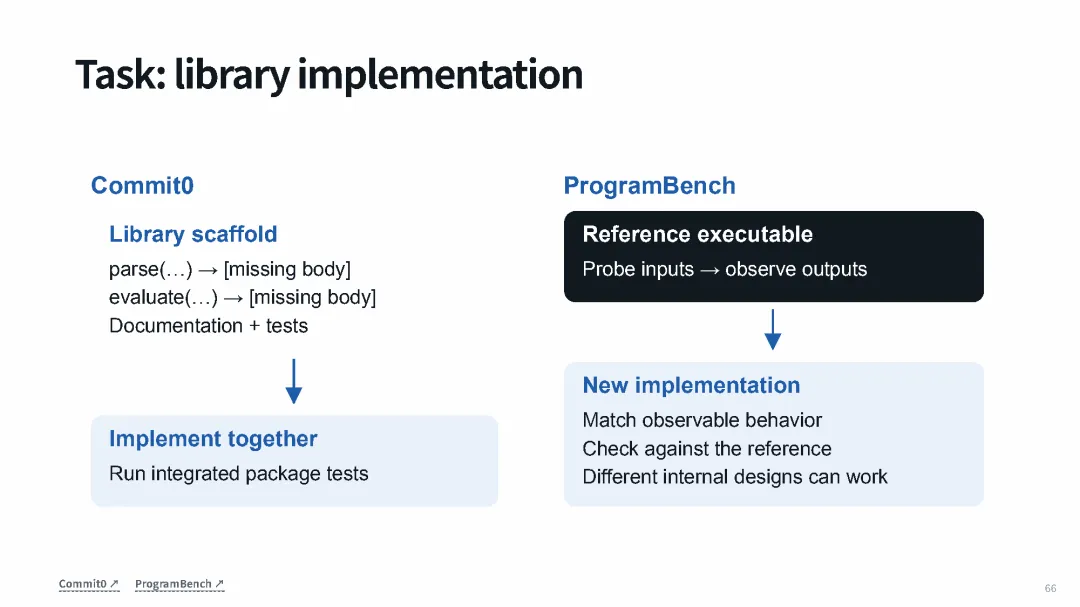
库实现:老的 Commit0、新流行的 ProgramBench(要逆向工程一个二进制并从零重新实现 —— 很长时程,是随着短时程任务变简单后的新挑战)。 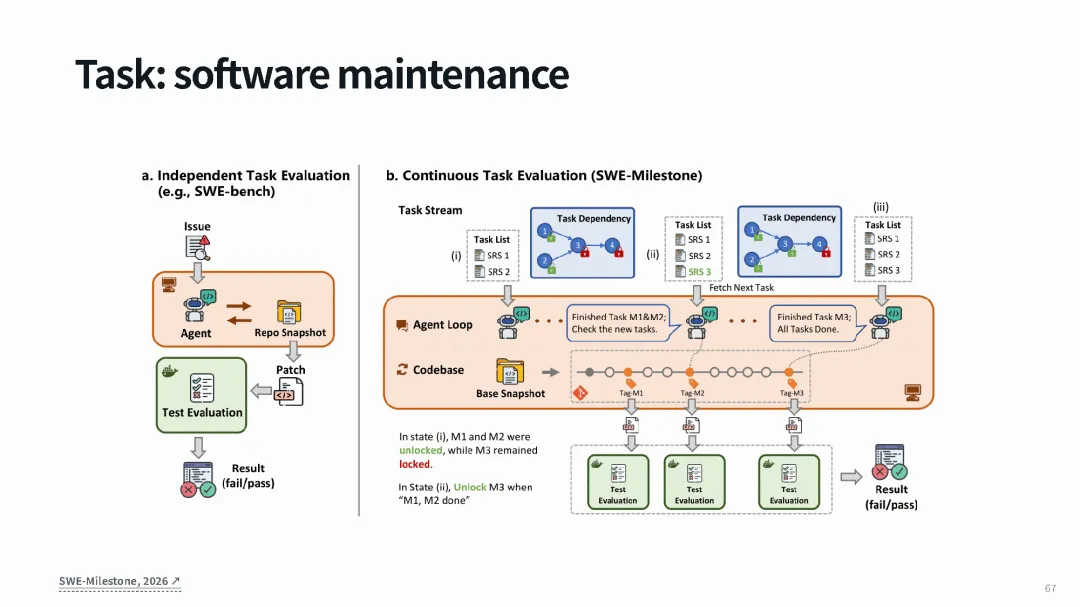
软件维护(SWE-Milestone):不是修单个 issue,而是在一个周期里逐个实现多个 issue,还要保证不把代码库搞乱、越来越难维护(这是某些编程智能体的大毛病)。 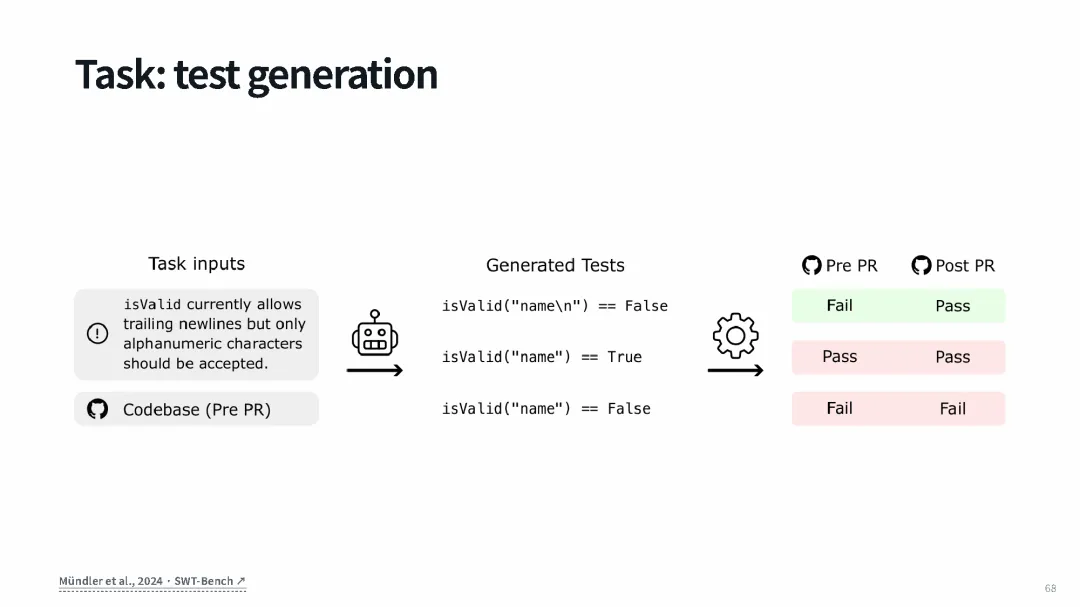
测试生成(SWT-Bench):Neubig 特别强调 ——现在能写出好测试来验证 issue 是否解决,就等于赢了一半(你把任务规格定清楚了,智能体很擅长在上面迭代)。 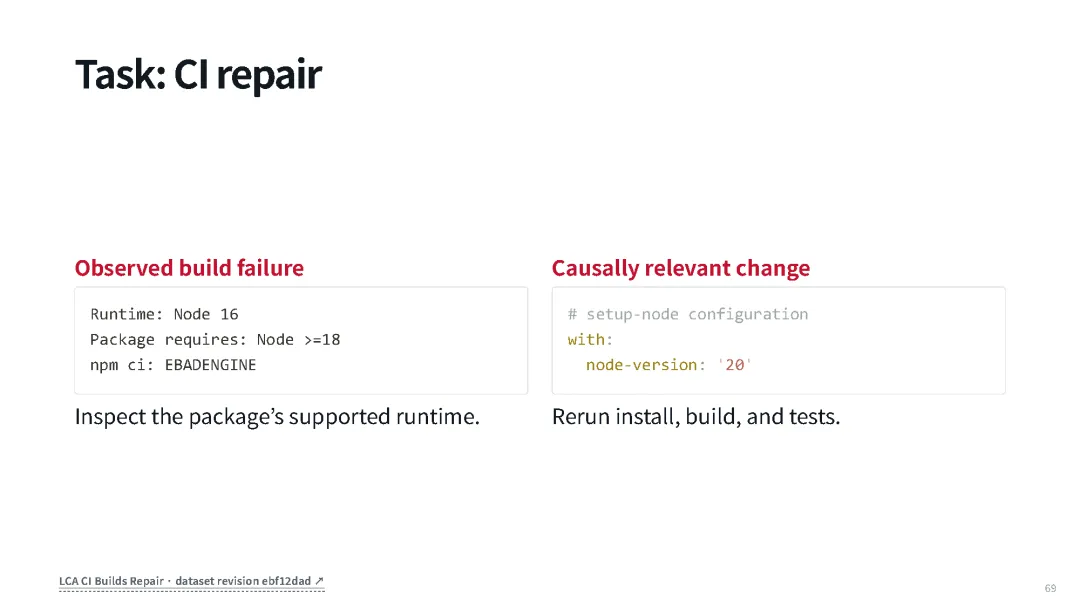
CI 修复:如让 build 失败的 Node 版本问题,改配置再重跑。这类操作性任务(部署等)目前还没有很好的 benchmark,因为需要真实基础设施。 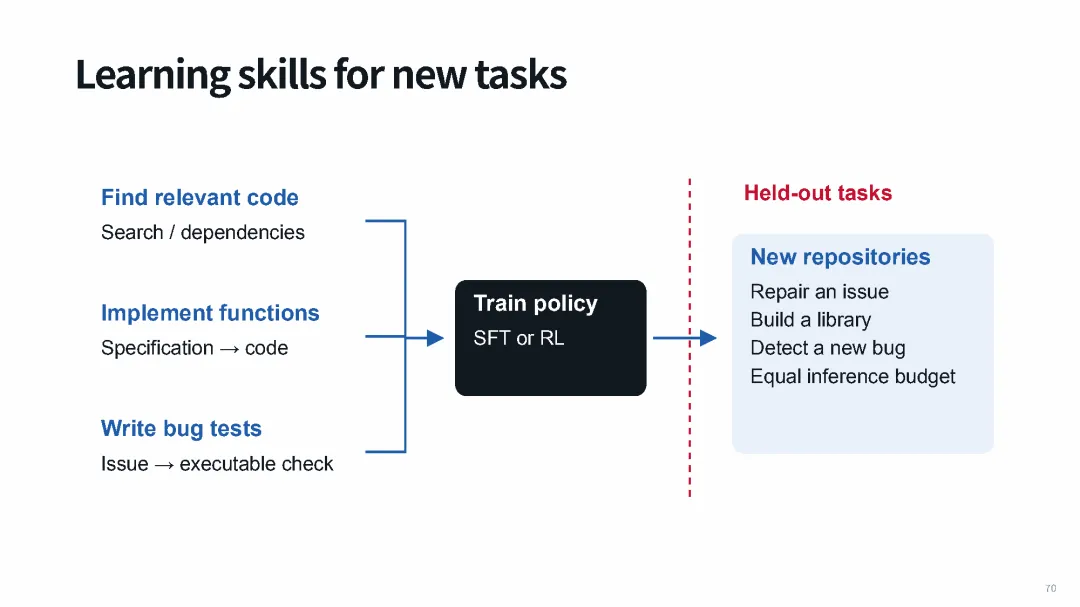
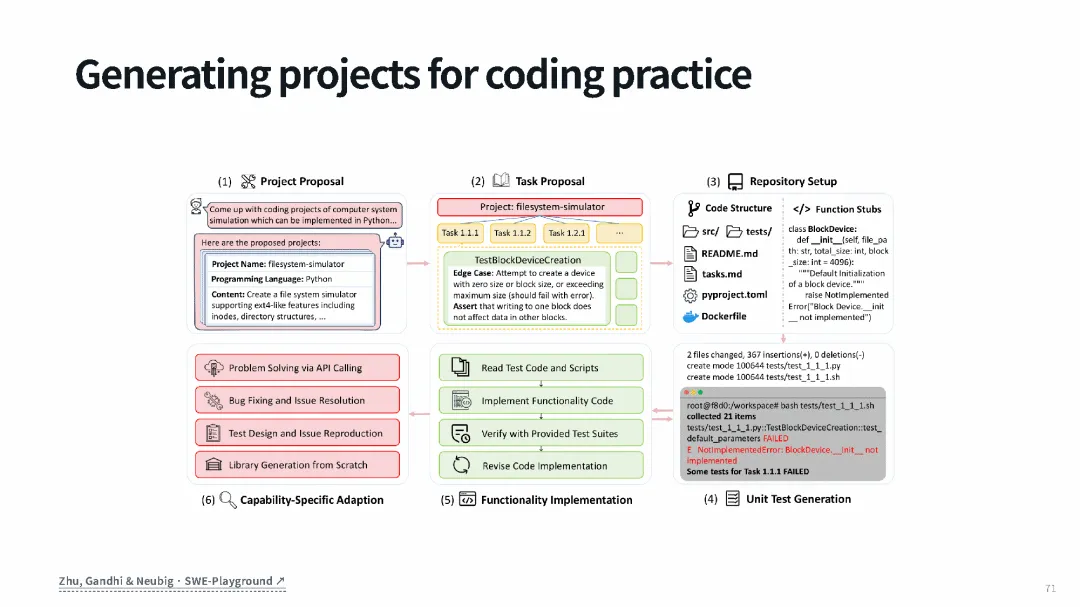
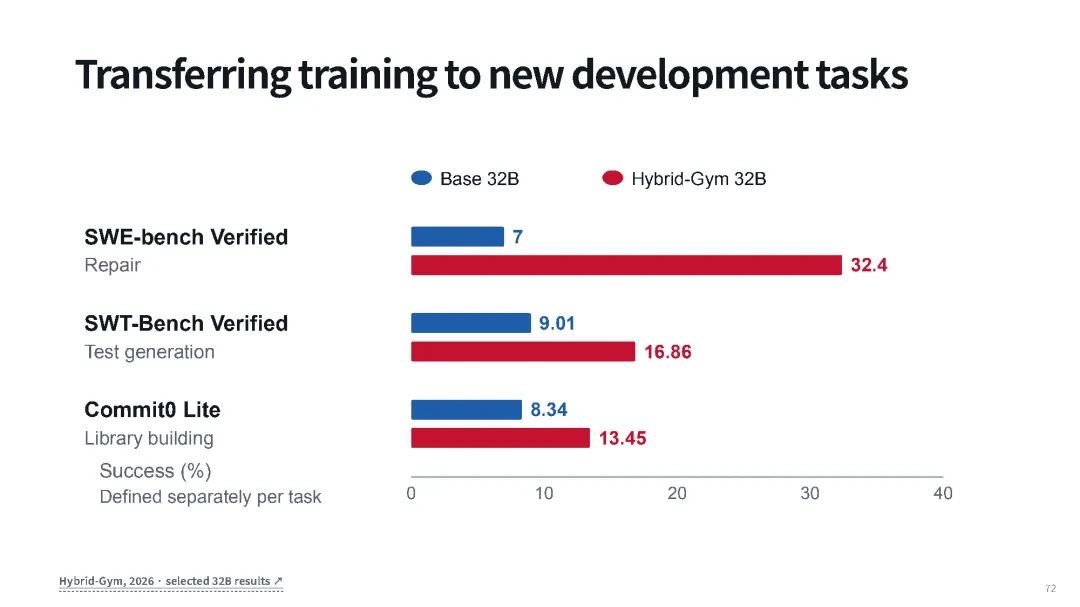
Neubig 团队还有 SWE-Playground / Hybrid-Gym—— 自动创建编程之外、软件工程其他任务的 benchmark,并证明在多任务上训练能迁移到新开发任务上。
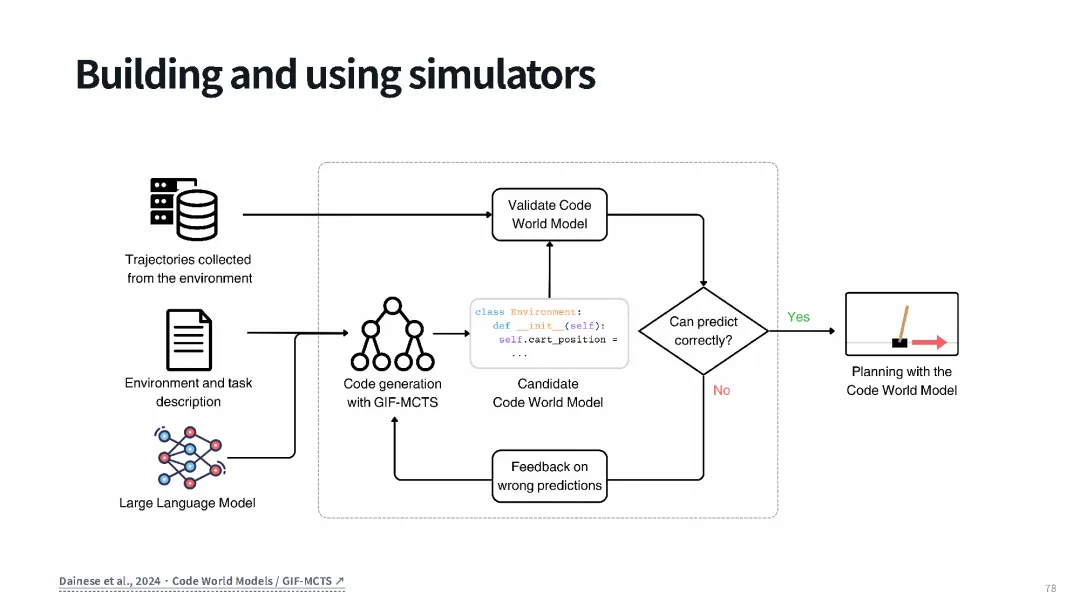
最后一节因为时间关系讲得很快。核心思路是给智能体一个「世界模型」—— 不只选动作,还能预测动作的效果。 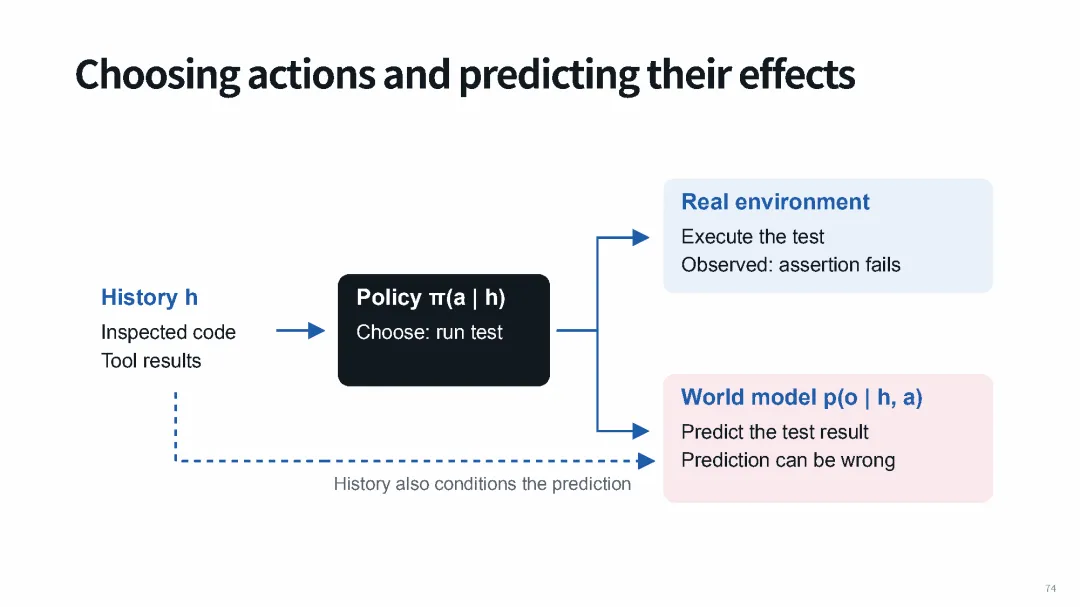
Policy 根据历史选动作,世界模型(World model)根据历史和动作预测观察结果(比如「跑这个测试会得到什么」)。但预测可能出错: 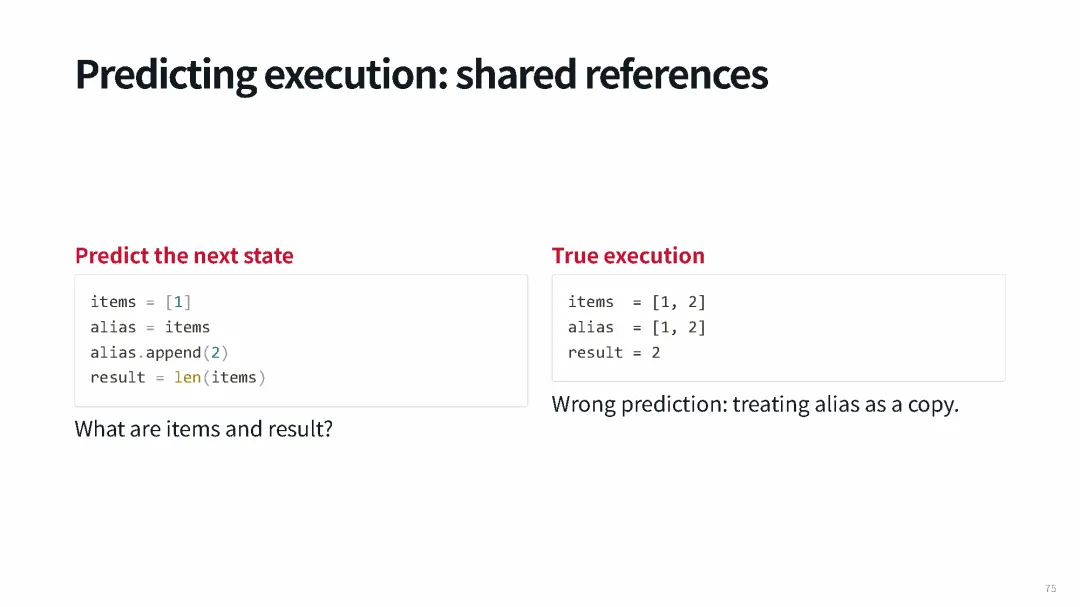
一个典型的坑是别名/共享引用:alias = items 之后 alias.append(2),items 也会变 —— 模型如果把 alias 当成拷贝就会预测错。 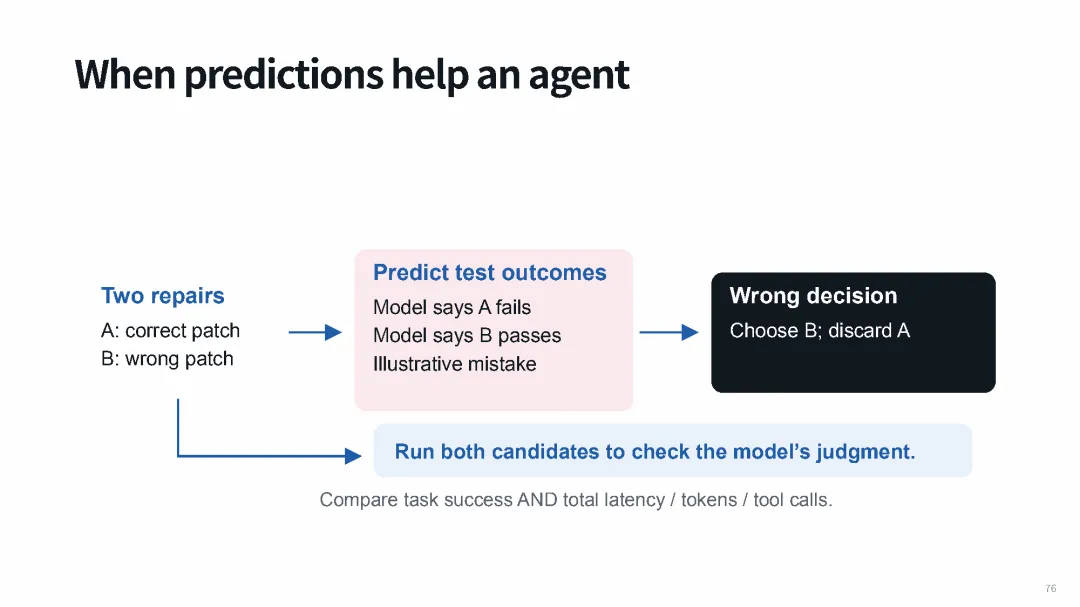
预测有用的场景:比如预判两个候选补丁哪个会过,从而少跑几次真实测试。但要小心 ——模型可能判断错(说 A 会挂、B 会过,结果 A 才是对的)。所以要同时比较任务成功率和总成本(延迟/token/工具调用),而不是只看省了多少次执行。 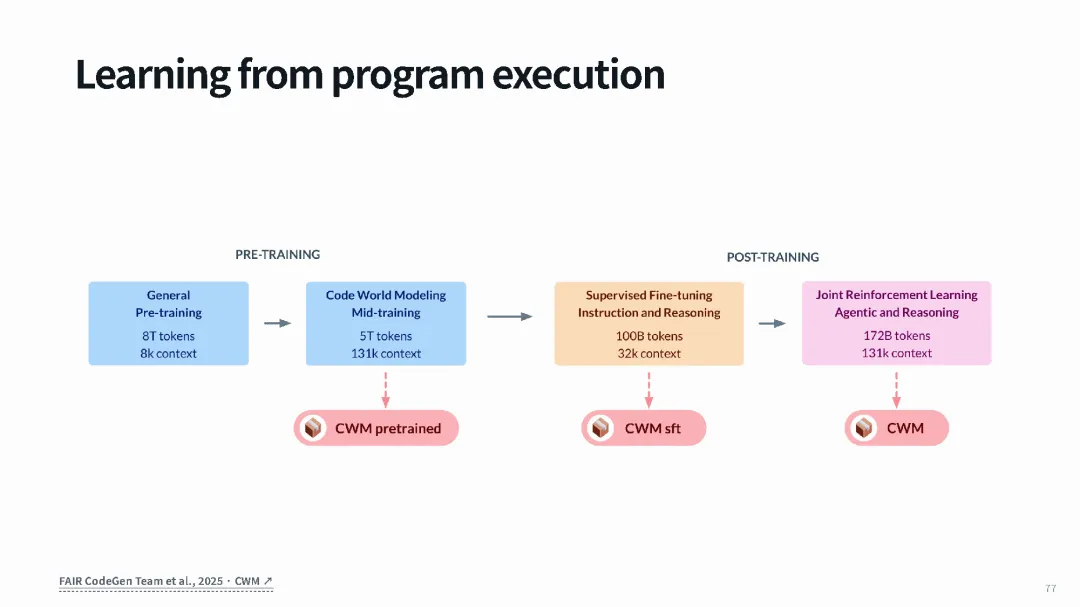
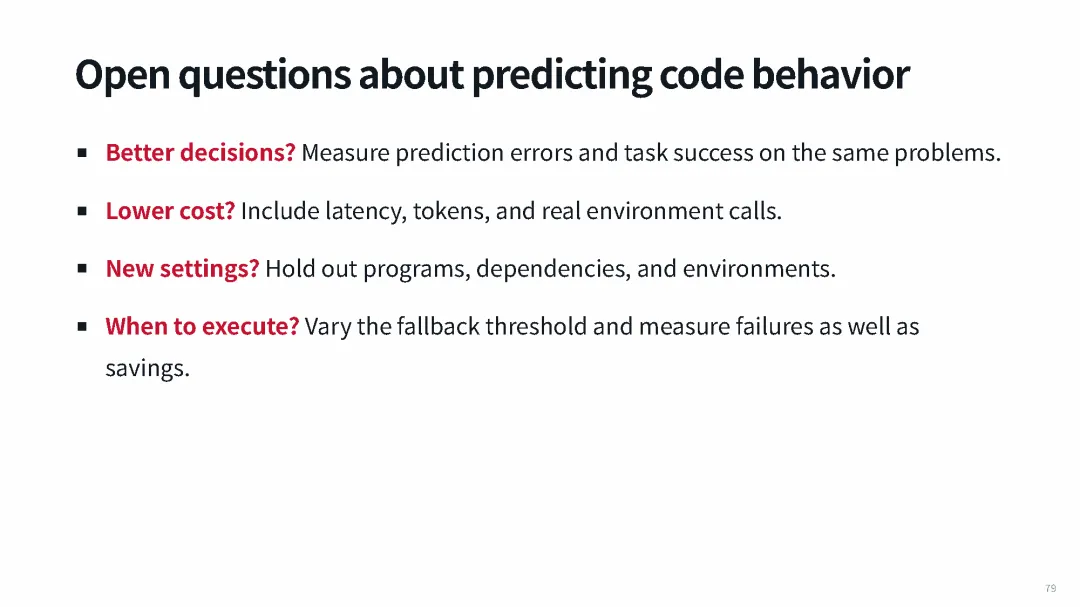
这方向还有很多开放问题:预测到底能不能带来更好决策、能不能真的降本、在新程序/依赖/环境上还成不成立、以及什么时候该直接执行、什么时候可以信预测。
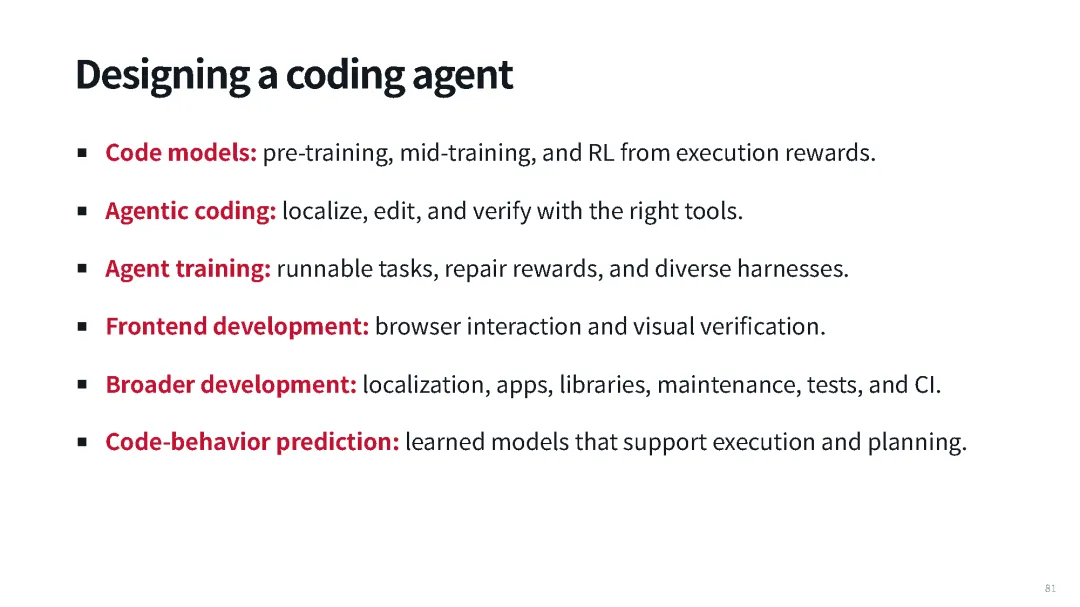
把整讲收束成一张图,设计一个编程智能体要想清楚六件事: 一句话记住这一讲: 下一讲预告:Domains 2 — GUI Agents(GUI 智能体),会讲怎么造能在浏览器/界面里操作的智能体 —— 正好补上这一讲前端验证里留的坑。 如果你也想认真啃一啃「Agent 到底怎么造出来、又怎么越用越聪明」,这门课的全部材料都免费公开: 朋友们,我们下一讲再见!
本文首发于 Haowen.AI 微信公众号。如果这篇分享对你有启发,欢迎点赞、收藏、转发给同样在学习路上的朋友。
第一讲:AI Agents 概述和工作原理—— Agent = 一个跑在循环里的模型(a model in a loop)。 第二讲:语言模型智能体的工具调用—— 工具,是让模型从「只会说」跨到「能做」的接口。 第三讲:智能体的长上下文建模—— 单个任务内历史越堆越长,系统怎么既用得动、又供得起。 第四讲:智能体的记忆与技能—— 别让 Agent 每次从零开始,把有价值的经验沉淀成可复用的外部产物。 第五讲:智能体的规划与任务分解—— 规划是一份「打算怎么做」的显式表示,带来模块化、反馈、长时程与控制。 本文是第六讲的下集,前面还有上集与中集:上集探讨了会写代码的模型 + 代码评估(第六讲:编程与软件开发智能体(上));中集专注在智能体化编程 + SWE-bench 训练(第六讲:编程与软件开发智能体(中))。强烈建议先读上、中两集。
要造一个好的编程智能体,你需要三样东西:一个会写代码的模型、一套定位/编辑/验证的工具与循环、以及一批可运行的评测环境来训练和检验它。三者缺一不可。
四、前端开发
通常需要一个能吃图像的多模态模型来理解输入。 需要在浏览器里验证—— 两条路:写浏览器里跑的测试,或看输出(截图)。
五、更广义的软件开发
六、让模型预测代码的行为(Code World Models)
七、结语:设计一个编程智能体
代码模型:预训练(含代码的大语料)、中训练(代码混合 + 长上下文)、从执行奖励做 RL。 智能体化编程:用对的工具做定位—编辑—验证(尤其编辑/diff 格式别选错)。 智能体训练:可运行任务、修复奖励、多样 harness。 前端开发:浏览器交互 + 视觉验证。 更广义开发:定位、造 app、造库、维护、测试生成、CI 修复 —— 记住开发者85% 的时间不在写代码。 代码行为预测:让模型学会预测执行结果,支持执行与规划。
编程智能体 = 一个会写代码的模型(训练三步) + 一套定位/编辑/验证的循环与工具(diff 格式很关键) + 一批可运行的评测环境(既是评测也是 RL 训练场)。而真正难的,往往是那 85% 不在写代码的部分 —— 评估、测试、维护和外循环。
课程主页:https://cmu-agents.com本讲视频:https://www.youtube.com/watch?v=1BWeH1oOM7k&list=PLSN0qpDfUvTM