ARTICLE · 1139643
AI怎样从结果中学会选择?从萨顿看懂强化学习
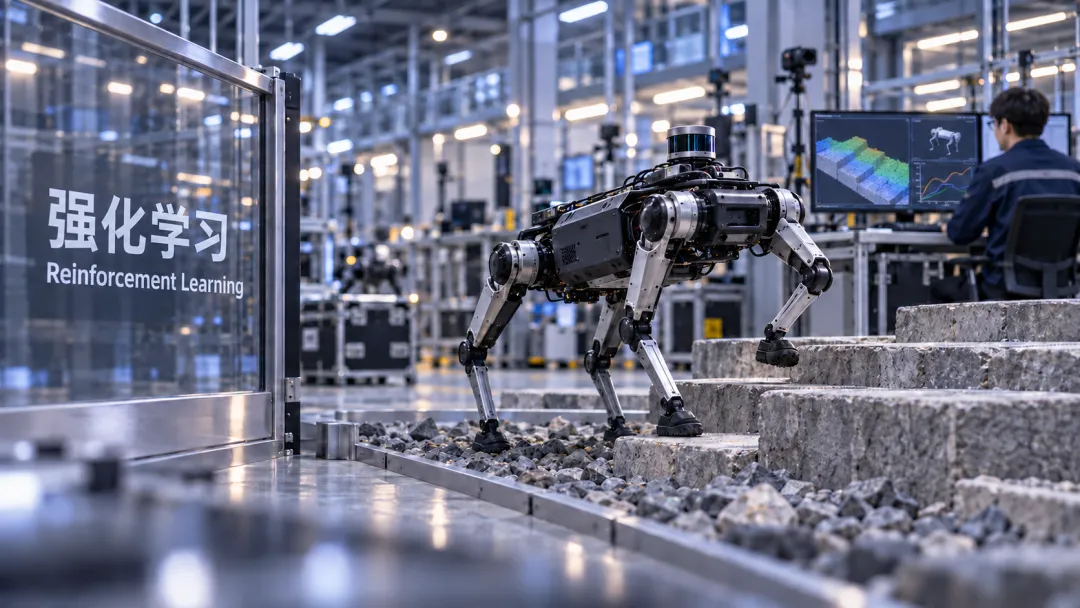
AI怎样从行动结果中学会选择?本文从萨顿的研究出发,结合围棋、机器人和大模型等案例,解释强化学习如何用经验改进策略,以及为什么奖励分数提高,还要检验实际效果。

让AI辨认一张照片,可以告诉它画面里是什么;让AI下一盘棋,就很难事先告诉它每一步该走哪里。一着棋的好坏,往往要等很多步以后才能看清。
强化学习处理的,就是行动与后果之间的这种联系。系统尝试行动,得到反馈,再据此调整选择的方法。它的目标是提高一段时间内的累计回报,因此,一次眼前的得分和一整局的胜利,可能需要不同的打法。
从围棋程序到大模型的部分训练环节,这种学习方式已经产生了实际影响。但“根据反馈学习”只是一个概括。反馈怎样变成经验,经验怎样改变下一次行动,才是理解强化学习的关键。
让经验成为
可以计算的东西
2025年3月5日,美国计算机协会宣布,将2024年图灵奖授予安德鲁·巴托和理查德·萨顿,表彰他们对强化学习概念与算法基础的贡献。两人曾是师生,萨顿在马萨诸塞大学阿默斯特分校攻读博士期间,与巴托开展研究。
他们长期关注的一个问题是:计算机能否根据行动的结果,逐步学会怎样行动?
这个问题有心理学背景。人和动物会在尝试中调整行为,一次成功或失败,会影响下一次选择。但要让计算机采用类似的学习方式,就必须说清楚:它能观察什么,能够采取哪些行动,什么结果值得追求,以及得到新信息之后,原先的判断应该怎样修改。
从20世纪80年代开始,巴托、萨顿及其他研究者逐步建立起相关概念与算法。1998年,两人合著的《强化学习导论》出版,将这一领域的主要思想系统地整理出来。
理解他们的贡献,可以先记住一个变化:在一些任务中,人可以提供评价结果的方法,让机器通过经验寻找行动策略。逐步示范每一个正确动作,有时成本很高,有时连人自己也无法事先列出完整答案。
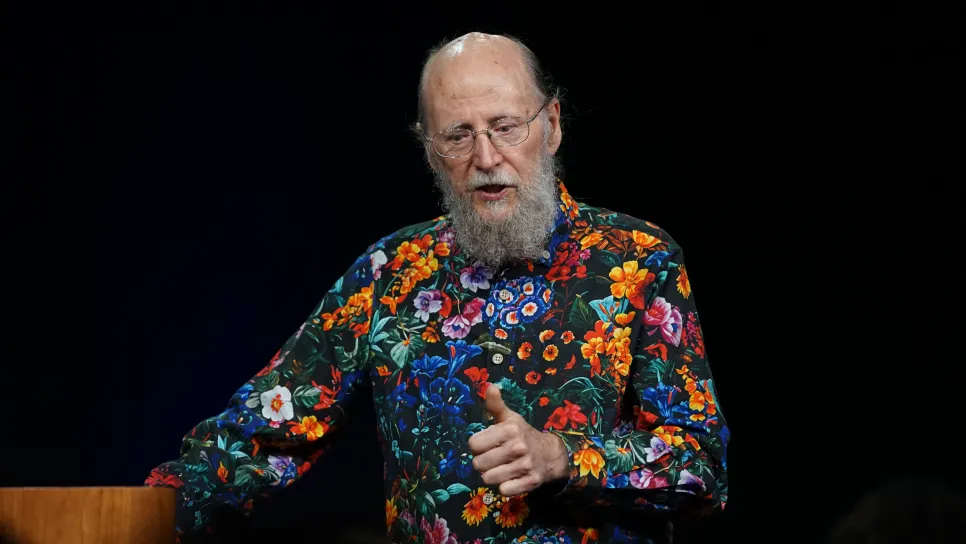
图1 理查德·萨顿。摄影:Xuthoria / Wikimedia Commons,CC BY-SA 4.0
一局游戏里的学习过程
设想让一个程序学习打乒乓球电子游戏。屏幕上有球和球拍,程序可以控制球拍向上、向下移动,或者停在原地。
程序得到球的位置、运动方向和球拍位置等信息,选择一个动作,游戏局面随之变化。我们可以规定:赢下一分,奖励记为1;丢掉一分,记为−1;其余时刻记为0。这是一个用于说明原理的简化设置。
在强化学习中,作出选择的程序叫“智能体”,游戏构成它面对的“环境”。球和球拍的情况属于它用来判断局面的信息,移动球拍是“动作”,得分与失分对应“奖励”。
还有一个更重要的概念,叫“策略”。它描述的是,在某种局面下,程序怎样选择动作。例如,球即将落向下方时,球拍向下移动的可能性应该有多大。
训练时,系统可以记录一段段经验:当时看到了什么,采取了什么动作,得到多少奖励,随后进入什么局面。学习算法利用这些经验,更新对动作好坏的估计,或者直接调整策略。如此反复,目标是让它在后续对局中更容易得分。
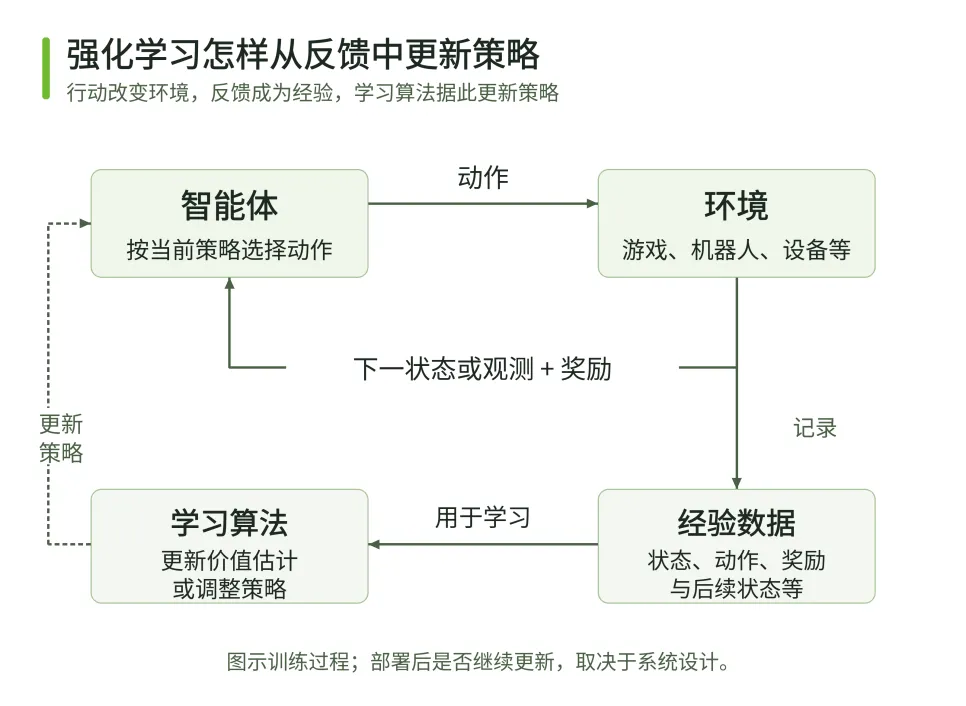
图2 强化学习的反馈与更新过程。根据 Sutton 与 Barto 的框架绘制
这并不意味着每次赢球都证明此前的动作正确。对手失误也会让它得分;一次合理的击球,也可能因为后续处理不好而丢分。算法需要从许多次尝试中,逐渐识别更可靠的行动方式。
如果游戏画面复杂,很难逐一列出所有局面,就可以用神经网络表示策略,或估计某个局面下未来可能获得的回报。强化学习与深层神经网络结合,便形成了深度强化学习。
这里还要区分训练和使用。训练阶段会更新模型;部署后,系统可以使用已经学到的策略作出选择。它是否继续学习,取决于具体设计,并非每使用一次就自动更新一次。
结果来得很晚时
怎样学习?
乒乓球游戏还能较快地得到得分反馈。围棋更麻烦:下了很多步,最后才分出胜负。
如果输了,只把责任归给最后一步,显然不合理。问题可能早在几十步之前就已经埋下。赢棋也是如此,获胜的一方并不一定每一步都走得好。
这涉及强化学习中的“信用分配”:一连串行动之后出现的结果,应当怎样影响对前面各个行动的评价。
萨顿研究的时间差分学习,为更新这类评价提供了一种方法。系统不必等到整局结束,才开始修正判断。它可以把刚获得的奖励与对后续回报的新估计结合起来,再与原先的估计比较,用两者的差距进行更新。
以棋局为例,程序原先认为某个局面比较有利,但走一步后发现,对手能够作出很强的回应。即便此时还没有输棋,它也可以据此下调之前对局面的评价。经过大量对局,后续局面的信息逐步影响前面的判断。
新的估计当然也可能出错。时间差分学习提供的是持续更新估计的方法,更新幅度、经验质量和算法稳定性,都会影响学习效果。
与此同时,程序还要决定该尝试哪些动作。如果它一直沿用目前最熟悉的打法,就可能错过更好的选择;如果始终随机乱走,又无法充分利用已经学到的经验。
训练需要在尝试新选择与使用已有经验之间作出取舍,这就是“探索与利用”。探索能提供新信息,也会消耗时间和资源。因此,试得多并不必然学得好,尝试了什么、怎样评价、如何更新,同样重要。
理论研究怎样把
学习变得可靠?
强化学习背后有一个常用的数学框架,叫马尔可夫决策过程。它把问题写成状态、动作、状态如何变化,以及奖励之间的关系。建模时,需要让当前状态足以概括影响下一步的历史信息;如果传感器只能看到局部情况,还要处理信息不完整的问题。
在这个框架下,贝尔曼方程把一个局面的价值与眼前收益、后续局面的价值联系起来。动态规划、概率统计和优化方法,由此进入强化学习。研究者据此发展出不同的学习方法。
一种方法是先学习评价动作。Q-learning持续估计:在某个状态下采取某个动作,之后可能得到多少回报。系统根据这些估计选择行动。面对复杂画面,DQN使用深度神经网络估计动作价值。2015年,Mnih等人在《自然》发表的研究,展示了DQN从游戏画面与得分反馈中学习控制的能力。
另一种方法是直接改进策略。策略梯度方法调整策略参数,让获得较高回报的行为更有可能出现。2017年提出的PPO,就是这一方向的代表方法之一,它通过设计更新目标,尽量避免一次更新把策略改动过大。Actor-Critic则把两件事结合起来:一部分负责选择动作,另一部分估计价值,为策略更新提供依据。
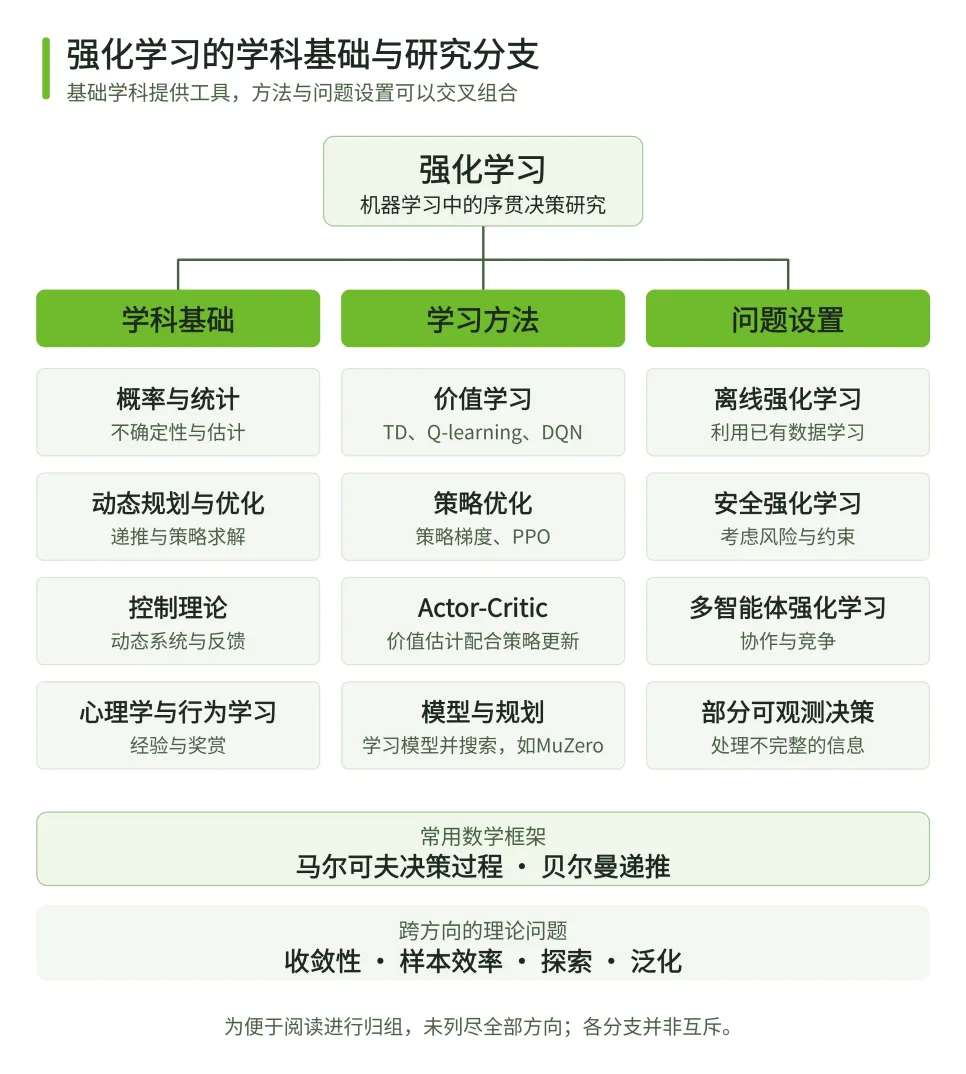
图3 强化学习的学科基础、学习方法与问题设置。为便于理解进行归组,分支可以交叉组合
还有一条路线是学习环境模型,再利用模型进行规划。它尝试根据已有经验预测行动之后会发生什么,再比较可能的选择。MuZero是其中的代表:它学习对规划有用的信息,例如奖励、策略与价值,再结合搜索选择行动,不要求复原环境中的每一个细节。模型预测若有偏差,规划结果也会受到影响。
这些方法可以组合使用。理论研究还要回答更基础的问题:算法在什么条件下会稳定下来,稳定之后离理想策略有多远,以及需要多少经验才能达到一定效果。
例如,Watkins与Dayan在1992年给出了Q-learning的收敛证明,但结论有适用条件,包括离散的表格表示、充分采样及合适的学习率。把表格换成复杂神经网络后,不能直接沿用同样的保证。论文中表现良好,也不等于对所有环境都有效。
真实任务又提出了新的研究问题。安全强化学习研究怎样在优化回报的同时满足约束;多智能体强化学习则要应对其他参与者也在调整策略的情况。伙伴和对手都在学习时,某个智能体面对的环境也会跟着变化。
从棋盘到大模型
2016年击败李世石的AlphaGo,曾从人类棋谱中学习,并结合强化学习与搜索。2017年,DeepMind公布的AlphaGo Zero进一步省去了利用人类对局数据训练棋艺这一步,通过自我对弈积累经验。
在这个系统里,神经网络负责提出落子选择、评价局面,搜索算法帮助比较后续可能出现的变化。自我对弈产生的新数据,又被用来训练网络。对局、搜索和学习相互配合,使系统逐步提高棋力。
DeepMind报告称,经过三天训练,AlphaGo Zero以100比0击败了此前与李世石对战的AlphaGo版本。不过,这里的“从零开始”有明确范围:它没有使用人类棋谱学习下棋,围棋规则、网络架构、搜索方法和计算资源仍然由研究者提供。
围棋适合开展这类研究,因为胜负能够明确判定,对局可以大量重复,失败也不会损坏真实设备。这样的条件,使行动与反馈之间容易建立稳定的联系。
大模型中的一些任务,也具备类似条件。
一道有确定答案的数学题,可以检查最终结果;一段程序,可以运行测试。模型生成不同解答,训练系统依据这些反馈调整它的生成策略。这里的动作变成了接下来生成什么内容,奖励则来自对解答的评价,部分评价可以由程序自动完成。
2025年公布的DeepSeek-R1研究展示了这种训练方式。R1-Zero在已经预训练的基础模型上直接进行强化学习,省去了前置的监督微调步骤;DeepSeek-R1则采用了包含监督微调和强化学习的训练流程。
R1-Zero所用的基础模型已经具备一定的语言和知识能力,强化学习继续调整它解决任务的方式。因此,“没有先做监督微调”,不能理解为没有预训练、没有数据积累。
棋局和数学题也提醒我们注意一个条件:结果比较容易核验。换成“这份经营建议三年后是否有效”,评价就困难得多。最终结果还会受到市场、资源和执行等因素影响,训练系统很难得到同样清晰、及时的反馈。
强化学习在机器人、芯片
和科学计算中的应用
机器人行走,需要连续调整动作。脚下是碎石还是台阶,身体有没有倾斜,都会影响下一步。2022年,苏黎世联邦理工学院等团队发表的研究,将学习得到的控制策略与地形感知结合,让ANYmal四足机器人在多种自然和城市场景中行走。项目还在瑞士一条2.2公里的山路上进行了测试。这里学习的是具体的运动控制能力,研究结果对应这些测试条件。
工业控制关心的是设备怎样运行。制冷系统需要根据温度、负荷等信息调整控制参数,同时兼顾能耗与运行要求。2022年,DeepMind、Google与特灵科技等团队发表研究,介绍了在两处真实设施开展的强化学习制冷控制实验。当前的调整会影响之后的温度和设备状态,因此必须评价一段运行过程的整体效果。
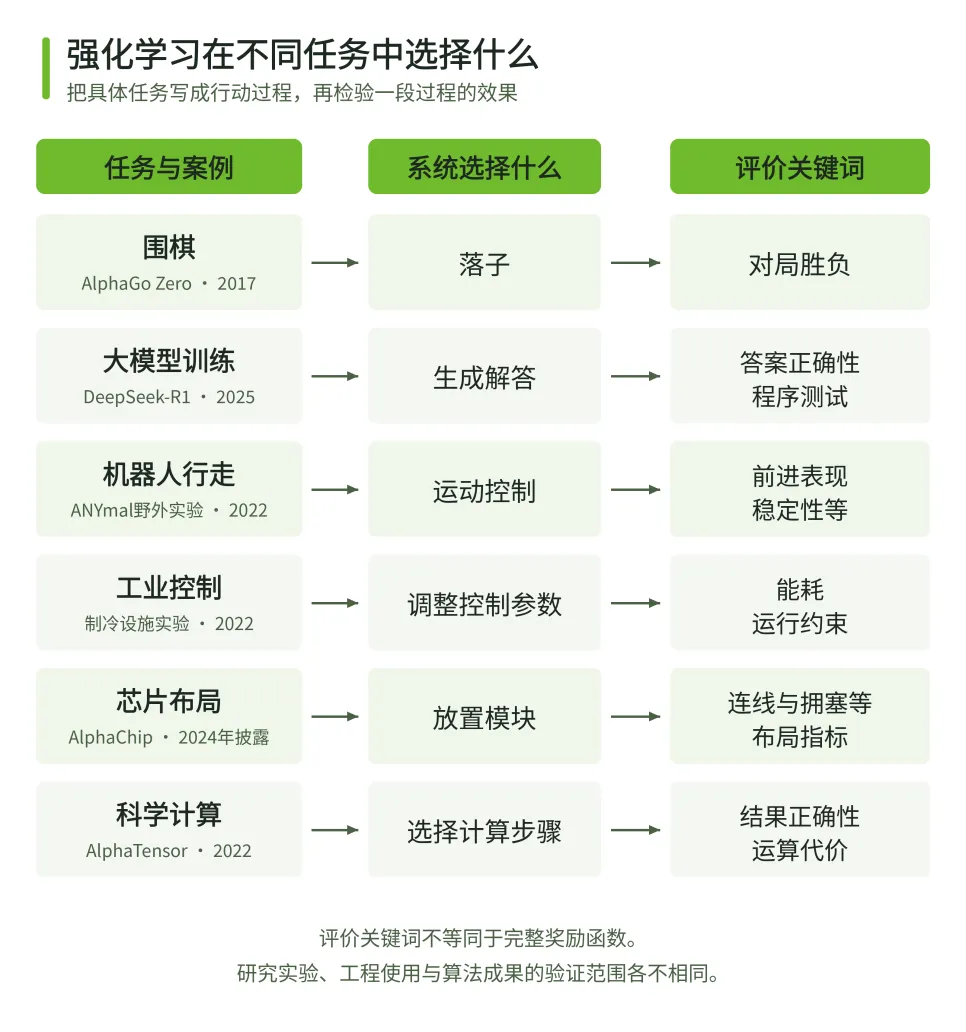
图4 从任务到行动,再到效果评价。各案例的验证范围不同,详见正文及参考资料
芯片设计中的部分问题,也能写成连续选择。AlphaChip依次安排芯片模块的位置,再根据布局质量得到反馈。连线、拥塞等因素相互影响,前面放置的模块会限制后面的选择。Google DeepMind在2024年的公开介绍中表示,这项方法已用于多代TPU的部分芯片布局。它处理的是芯片设计中的布局环节,完整设计还需要其他工具与工程流程。
强化学习还被用于寻找计算方法。2022年公布的AlphaTensor,把矩阵乘法算法的搜索转化为一连串可评价的操作。研究者给出的一个例子是:将4×5矩阵与5×5矩阵相乘,直接计算需要100次乘法,系统找到了一种使用76次乘法的算法。这里比较的是特定问题下的乘法次数;实际运行速度还会受到加法开销、内存访问和硬件条件影响。
这几个案例的进展程度不同。机器人和制冷案例展示了真实环境中的实验验证,AlphaChip有公开披露的工程使用记录,AlphaTensor则展示了算法搜索的科研成果。判断一种技术离应用有多远,需要看它经过了什么检验。
走出实验以后
还要检验什么?
在真实设备上,失败可能意味着停机或损耗,一次试验也未必能迅速重来。
在真实设施中,用电量下降,未必全是控制策略的功劳。天气变凉、设备负荷减少,都可能降低能耗。要判断策略是否有效,必须考虑这些条件,选择合理的比较方法。
为了减少现场试验,研究者发展出离线强化学习:利用已经收集的数据训练策略,不在这一训练过程中新增在线交互。它让历史运行记录有机会成为训练材料,但历史数据记录的是过去实际发生过的过程,未必覆盖新策略可能采取的全部动作。对于很少出现的状态,模型可能高估某个动作的收益。怎样发现并控制这种误差,是离线强化学习的核心研究问题之一。
模拟环境可以降低试验成本,也会引入另一种偏差。模拟器里的摩擦、传感器误差和设备响应,很难与现实完全一致。策略在仿真里有效,仍然需要检验它在真实条件下是否可靠。
因此,实际应用常常需要先利用已有数据或模拟环境训练,再在限定范围内验证。Google在2018年介绍数据中心制冷控制系统时,就明确写到:动作需要经过约束检查,现场操作人员可以随时退出AI控制,切换回原有控制方式。
这些安排决定了系统可以尝试什么,以及出现异常时怎样处理。强化学习能否进入生产环境,与这些工程条件密切相关。
奖励分数之外
还有实际目标
决策智能关注的是如何在目标与约束下选择行动,并检验执行效果。强化学习为此提供了一类根据经验改进策略的方法,尤其适用于行动会影响后续状态、需要连续作出选择的任务。
但一个完整的决策问题,还包含算法开始学习之前就必须回答的问题:目标是什么,哪些条件不能突破,结果怎样衡量。
仍以制冷为例。如果只按耗电多少评价策略,却没有纳入温度要求和设备约束,那么减少制冷甚至停止设备,就可能得到较好的节能分数。这样的分数对实际运行没有意义。温度上限、设备能力和运行要求,需要进入系统设计。
“奖励”是研究者提供给算法的评价信号,它能否代表真实目标,需要验证。奖励设计不充分时,训练越有效,系统越可能把偏差执行得更彻底。
这也是其他学科会参与决策智能的原因。因果推理帮助分析某项干预带来了什么变化;运筹优化帮助处理资源分配与约束;涉及多个参与者时,博弈论还要考虑他人的回应。不同方法可以组合使用,强化学习承担其中从经验改进策略的部分。
对一套制冷系统来说,只有在温度达标、设备运行稳定的前提下,降低的那部分能耗才有实际价值。
[1] 马萨诸塞大学阿默斯特分校。巴托与萨顿获2024年图灵奖。2025年3月5日。
[2] Sutton, R. S.; Barto, A. G. Reinforcement Learning: An Introduction. 第2版,MIT Press,2018。
[3] Sutton, R. S. Learning to Predict by the Methods of Temporal Differences. Machine Learning, 3: 9–44, 1988。
[4] Watkins, C. J. C. H.; Dayan, P. Q-learning. Machine Learning, 8: 279–292, 1992。
[5] Mnih, V. 等。Human-level control through deep reinforcement learning. Nature, 518: 529–533, 2015。
[6] Schulman, J. 等。Proximal Policy Optimization Algorithms. 2017。
[7] Schrittwieser, J. 等。Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model. 预印本2019年,Nature论文2020年。
[8] Achiam, J. 等。Constrained Policy Optimization. ICML / PMLR 70: 22–31, 2017。
[9] Lowe, R. 等。Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments. 2017。
[10] Silver, D.; Hassabis, D. AlphaGo Zero: Starting from Scratch. Google DeepMind,2017年10月18日。
[11] DeepSeek-AI。DeepSeek-R1研究论文与官方项目说明。2025。
[12] Miki, T. 等。Learning robust perceptive locomotion for quadrupedal robots in the wild. Science Robotics,2022。
[13] Luo, J. 等。Controlling Commercial Cooling Systems Using Reinforcement Learning. 2022。
[14] Goldie, A.; Mirhoseini, A. How AlphaChip transformed computer chip design. Google DeepMind,2024年9月26日。
[15] Google DeepMind。Discovering novel algorithms with AlphaTensor。2022年10月5日。
[16] Levine, S. 等。Offline Reinforcement Learning: Tutorial, Review, and Perspectives on Open Problems. 2020。
[17] Gamble, C.; Gao, J. Safety-first AI for autonomous data centre cooling and industrial control. Google DeepMind,2018年8月17日。