ARTICLE · 1143840
【统计分析软件SPSS】190、时间序列分析——使用保存模型进行预测
本系列文章(基于SPSS 31版本)配套数据可通过百度网盘获取:
链接:https://pan.baidu.com/s/1AGizNngKrzAVapWtNcc-VA?pwd=mnsj提取码:mnsj
https://www.mizhushare.com/docs/
在前面的文章中,我们使用「专家建模器」生成了一个模型,并将其保存到了一个外部XML文件中。
【统计分析软件SPSS】188、时间序列分析——使用专家建模器构建模型(操作步骤)
本次,我们将把已保存的模型应用于更新后的数据集,从而在无需重建模型的情况下,将预测期再延长三个月。
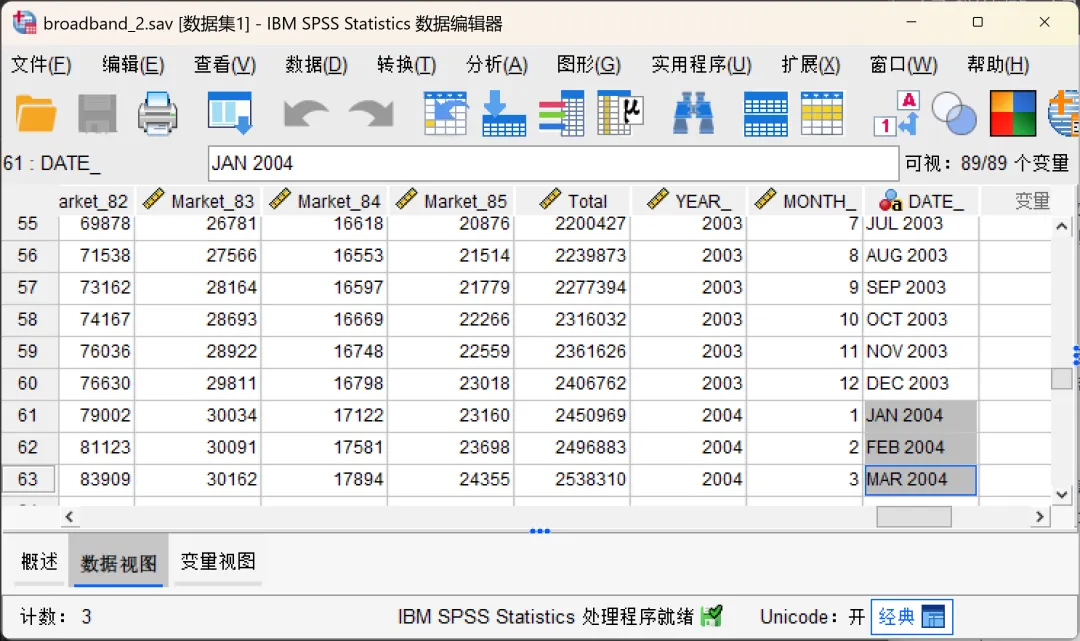
点击顶部菜单栏的【分析→时间序列预测→应用传统模型】,在打开的对话框中进行相应设置。
对话框各选项卡中各选项的含义与「创建传统模型」时一致,本次只介绍具体操作步骤,各选项的具体内容可以查看以下文章:
【统计分析软件SPSS】188、时间序列分析——使用专家建模器构建模型(操作步骤)
主对话框:
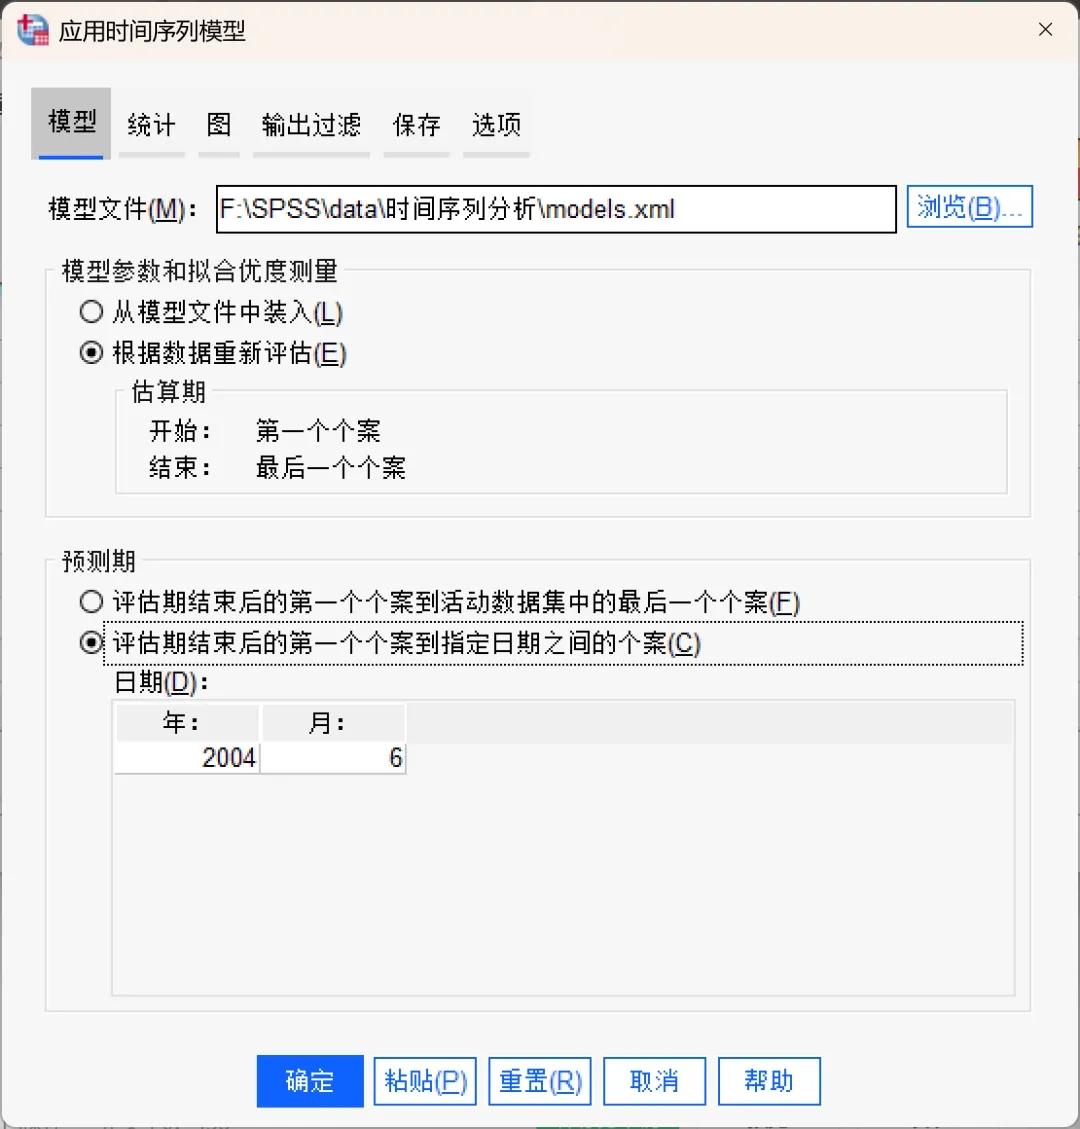
加载模型:点击「浏览」按钮,选择保存的模型文件(models.xml)。
将最新观测值纳入预测:勾选「根据数据重新估计」,系统将基于更新后的数据对模型参数进行重新估计。需要注意的是,此过程仅更新参数,模型结构(如ARIMA阶数或指数平滑类型)保持不变,因此计算速度远快于初次建模。为确保新数据被用于重新估计,可以使用默认的估算期(即,从第一个个案到最后一个个案)。若需自定义估计范围,可在「数据→选择个案」对话框中选择「基于时间或个案范围」并手动指定。
设置预测周期:在「预测期」组中,选择「评估期结束后的第一个个案到指定日期之间的个案」,并在「日期」网格中输入年份2004和月份6(数据集包含从1999年1月到2004年3月的数据。根据当前设置,预测期将为2004年4月至2004年6月)。
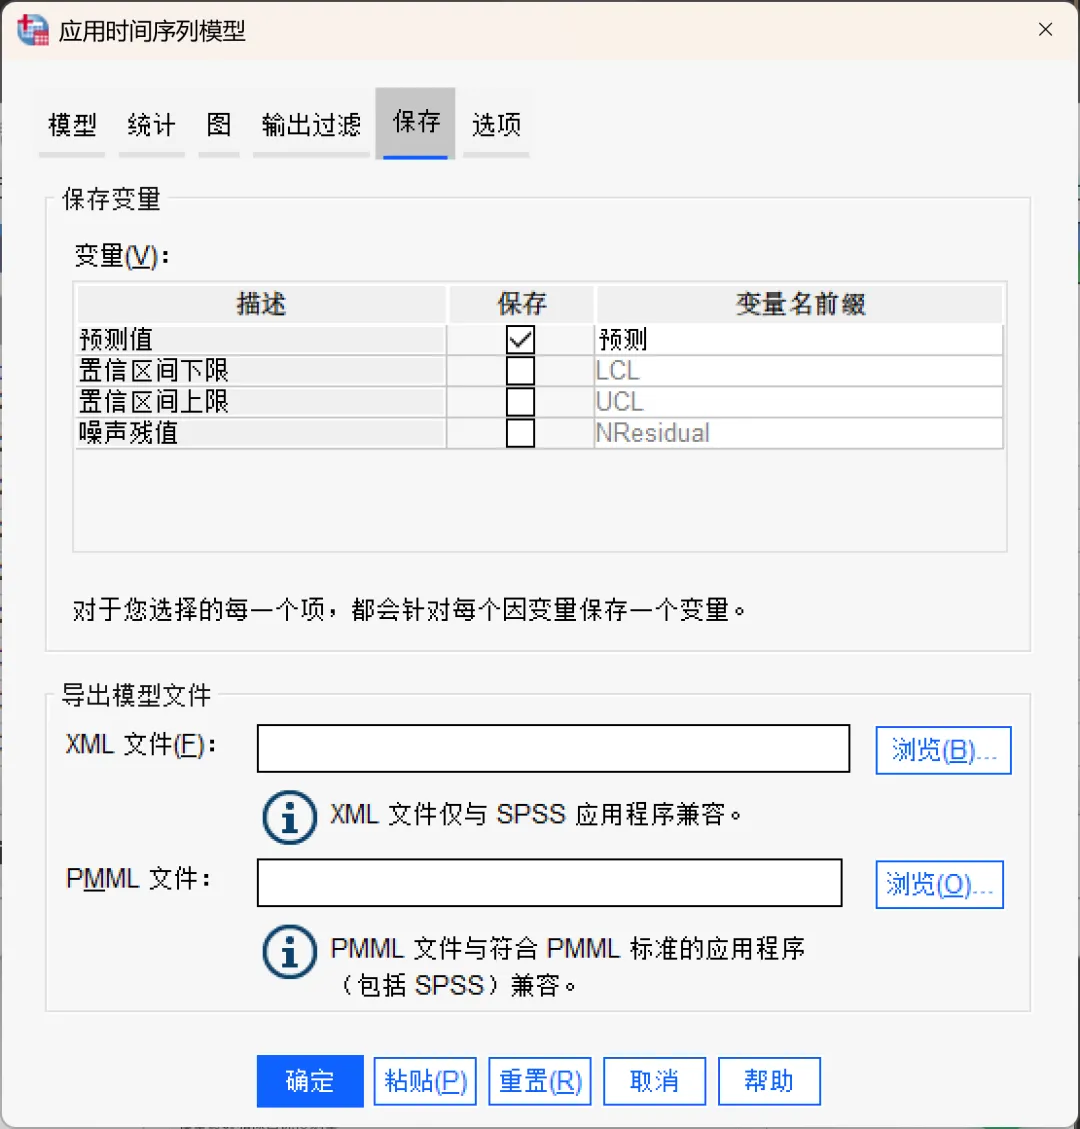
保存选项卡:
本次在「保存变量」组中,勾选「预测值」,后续模型预测值将作为新变量保存在活动数据集中,并使用前缀「预测」命名。
图选项卡:
在「单个模型的图」组中,取消勾选「序列」,因为我们更感兴趣的是将预测结果作为新变量保存,而不是生成预测图。
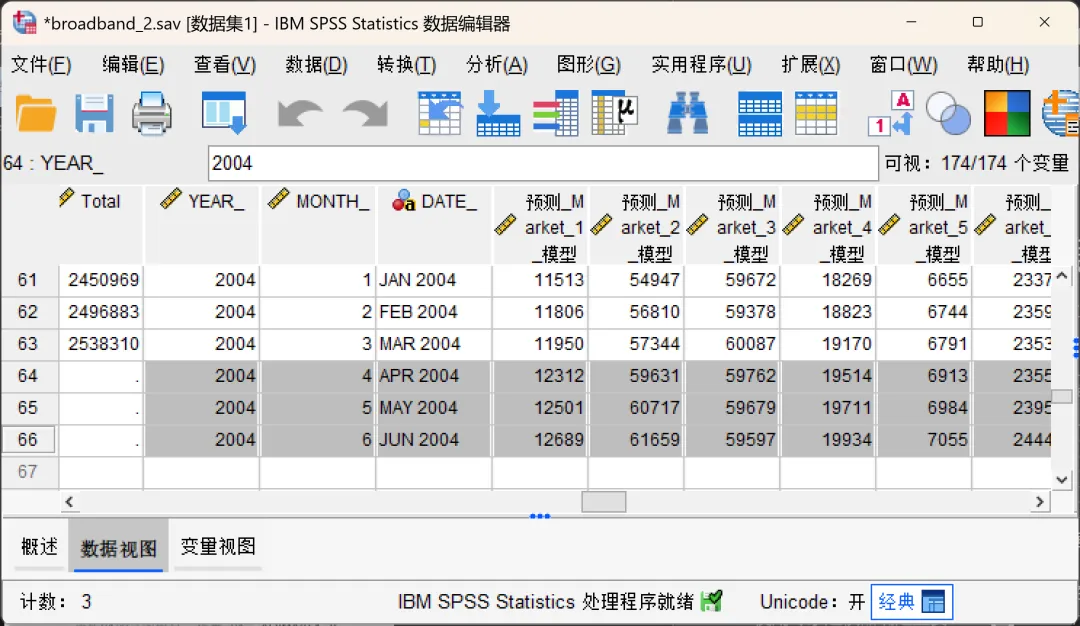
输出结果一:模型预测
通过应用已保存的模型,成功生成了未来三个月(2004年4月、5月、6月)的预测数据。
在SPSS数据编辑器中,新增了85个以「预测_Market_X_模型」命名的变量,分别对应85个本地市场的用户订阅量预测值。另外,数据集新增了3行记录,分别代表预测期的三个时间段,同时自动生成了日期标签。
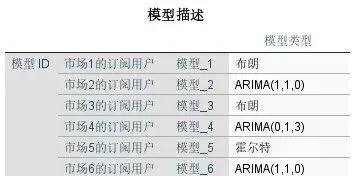
输出结果二:模型描述
该表格详细列出了为85个本地市场(Market_1 至 Market_85)各自建立的时间序列模型的类型和结构。
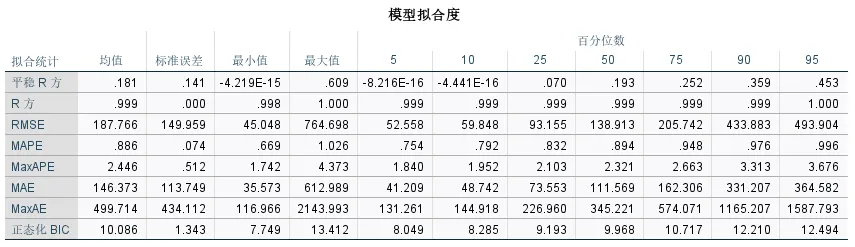
输出结果三:模型拟合度
模型拟合表提供了所有序列模型计算的拟合统计量,简明地总结了参数重新估计后的模型对数据的拟合程度。
在本次示例中,表格显示每个模型预测的平均不确定性约为1%,最大不确定性约为2.5%(MaxAPE的平均值),最坏情况约为4%。同样的,误差是否属于可接受范围,取决于具体应用目的和业务需求。
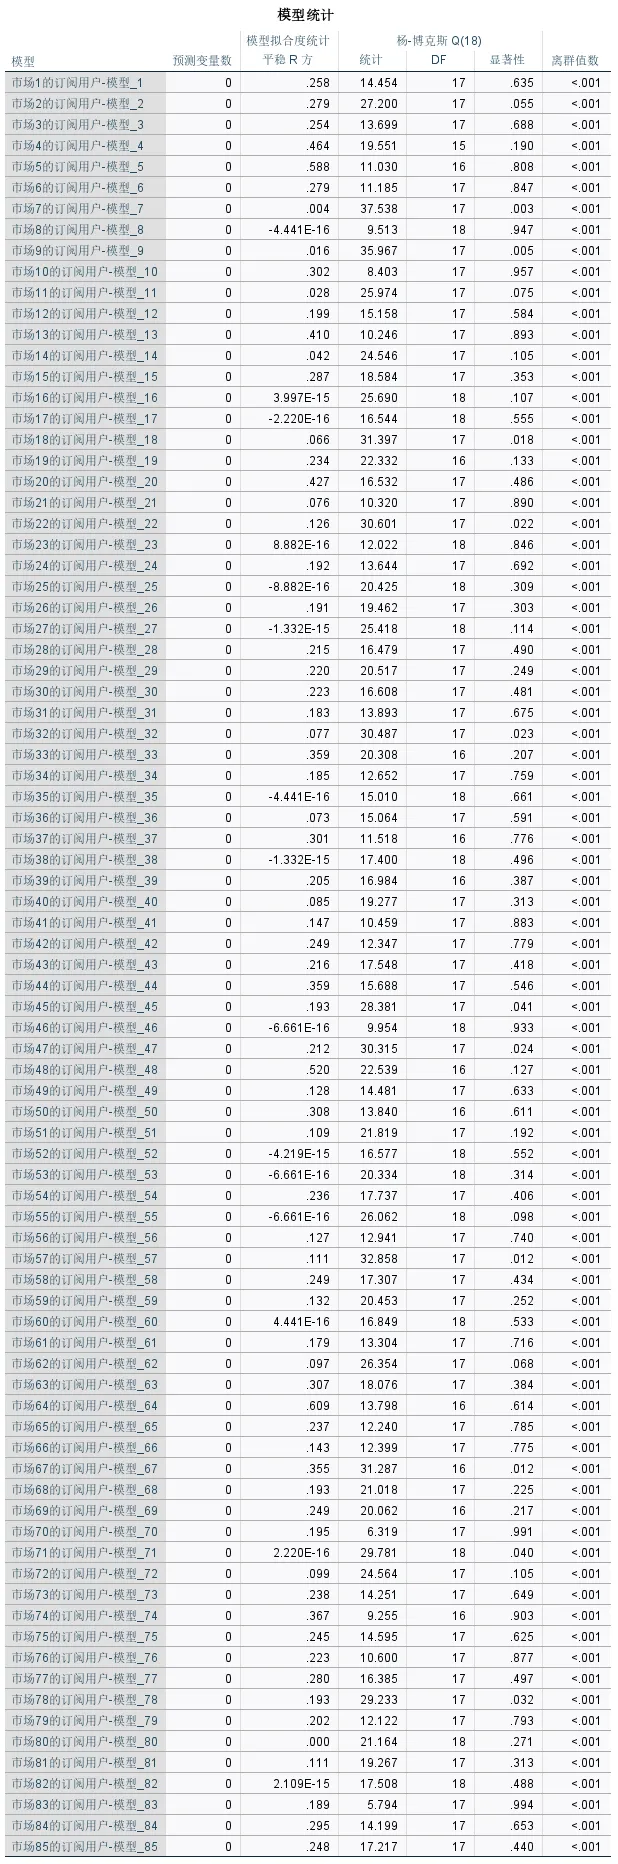
输出结果四:模型统计
该表展示了每个序列模型的拟合质量与残差检验结果。