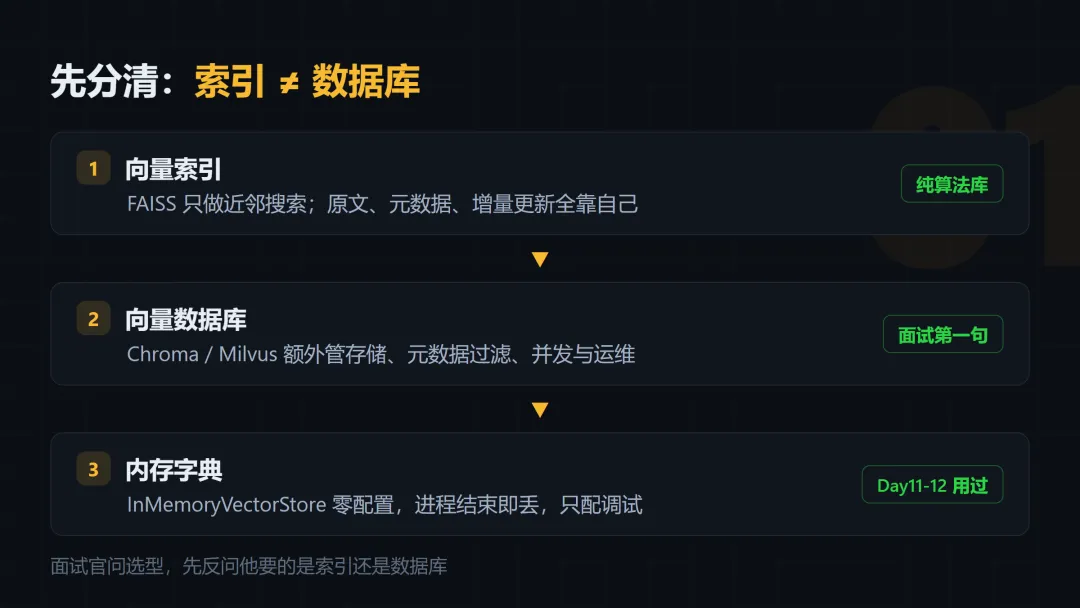
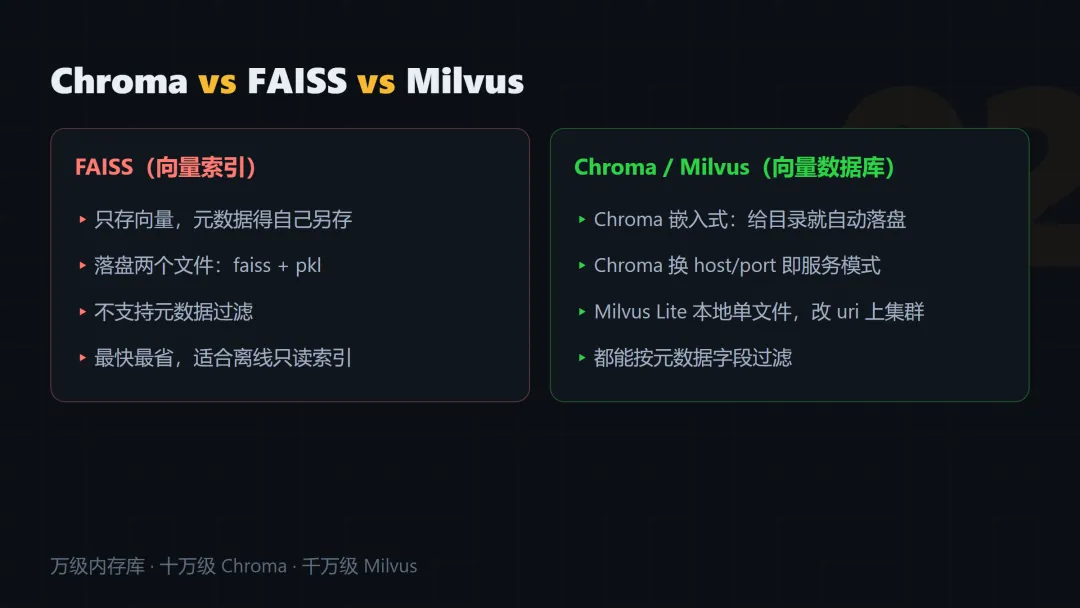
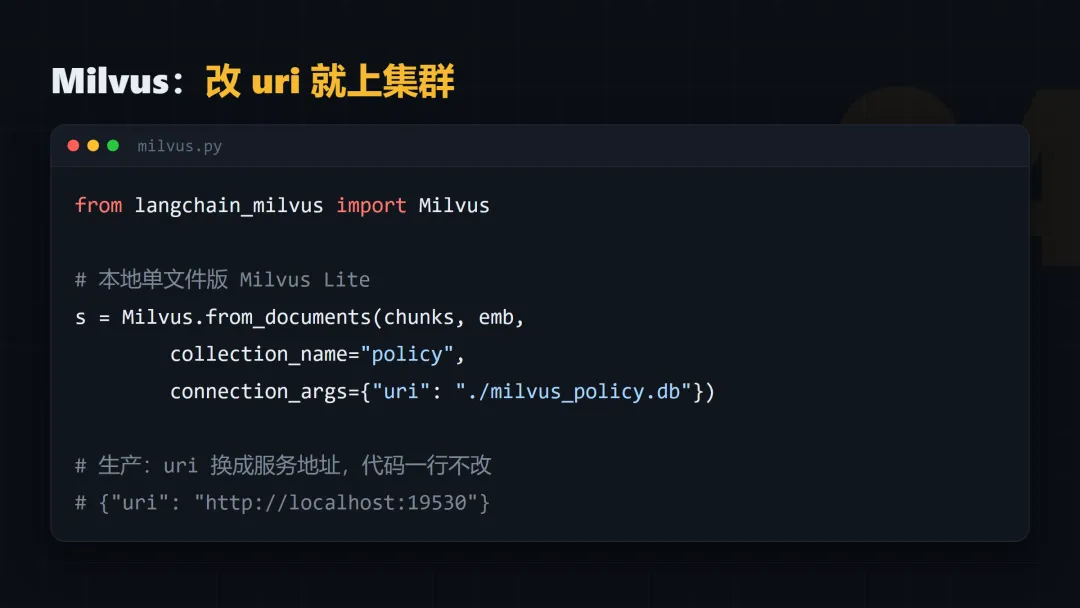
面试官:Chroma、FAISS、Milvus 你选哪个?为什么?Day11、Day12 我们一直在用 InMemoryVectorStore——一个跑在内存里的字典。它能跑通,但它有个致命问题:进程一关,库就没了。真实项目里这显然不行,于是下一个问题必然被追问:"你的向量数据存在哪?" "FAISS、Chroma、Milvus 你选哪个?为什么?" "FAISS 不是最流行的吗,为什么你们没用它?" "换一个 embedding 模型,你的向量库要怎么办?"这组问题很能区分人。背八股的人会背"FAISS 快、Milvus 分布式、Chroma 轻量";真正做过的人会先反问一句:你问的是"向量索引"还是"向量数据库"? ——这一句话就能把话题从选型清单拉到架构层面。今天这篇我们把 Day12 那个报销知识库,同时灌进 InMemory / Chroma / FAISS / Milvus 四套存储,用一套统一接口对比它们的落盘、过滤、延迟,并且回答那个最贵的坑:换 embedding 模型到底要付多大代价。全部代码约 190 行,没有 API Key 也能完整跑通(Milvus 用的是本地单文件版 Milvus Lite)。1. 选型题:Chroma、FAISS、Milvus 怎么选?各自适合什么规模?2. 概念题:FAISS 是向量数据库吗?它和 Milvus 的本质区别是什么?3. 原理题:HNSW 和 IVF_PQ 有什么区别?为什么不用暴力搜索?4. 工程题:换 embedding 模型要做什么?代价在哪?答题万能公式:先划层(索引 ≠ 数据库:索引只管向量近邻搜索,数据库还要管存储、元数据、过滤、并发、运维)→ 再按四个维度选(数据规模 / 要不要持久化 / 要不要元数据过滤 / 团队有没有运维能力)→ 给索引与度量(HNSW 召回 95%+、IVF_PQ 省内存、余弦 vs L2)→ 讲代价(换 embedding = 整库重建)。最后那句"换 embedding 等于整库重建,这才是向量库真正的迁移成本"是加分项。因为它不是从文档里背来的,是只有重建过库的人才会说的话。这是整个选型题的地基,很多人答不好就是因为这两件事混在一起说了。所以 FAISS 不是"另一种数据库",它是一个库。 你用 FAISS 的时候,文档原文、metadata、权限、增量更新全都要自己在别处实现——这些加起来才是"数据库"的部分。① InMemoryVectorStore(langchain_core 自带):进程内字典,零依赖、零配置。只适合调试和单测,进程结束数据就没了。前面 Day11、Day12 用它,是因为我们只想讲检索本身。② FAISS(Meta 开源,faiss-cpu):纯向量索引库,速度最快、最省资源,save_local() 落两个文件(index.faiss + index.pkl)。没有元数据存储,所以 LangChain 的 FAISS 封装里,原文和 metadata 是塞在 pickle 里的——这也是 load_local() 必须显式传 allow_dangerous_deserialization=True 的原因(反序列化 pickle 有执行任意代码的风险,只加载自己生成的索引)。适合:离线、只读、规模固定的索引。③ Chroma(嵌入式向量数据库):底层是 SQLite + DuckDB,persist_directory 一给就自动落盘,支持元数据过滤,还能切服务模式(host/port)给整个团队共用。适合:十万级以内、要快速落地的业务。它是"能跑起来的最小数据库"。④ Milvus(分布式向量数据库):存算分离、可水平扩展,支持分片、副本、分区键,千万到十亿级。它的 Milvus Lite 是本地单文件版本——同一套 SDK,把 `uri` 从 `./xxx.db` 换成 `http://host:19530`,代码一行不改就上了集群。这也是我今天把它放进演示的原因:本地能跑,生产能扩。1. 数据规模多大? 万级以内随便选;十万级选 Chroma 或 Milvus 单机;千万级以上基本只有 Milvus(或云厂商托管版)。2. 要不要持久化? 只是临时实验 → InMemory;要落盘 → 其余三个。3. 要不要按元数据过滤? 这是最容易被忽略、但上线后一定会遇到的一条:比如"只在 2024 年的文档里搜""只搜某个部门的知识库"。要过滤,就不能用 FAISS。4. 团队有没有运维能力? 没人维护中间件就选嵌入式(Chroma)或云服务,别硬上分布式。▸ FLAT:暴力全量比对,100% 准确,数据量小的时候其实最快(今天 6 条数据就是 FLAT)。▸ HNSW:分层可导航小世界图,工业界默认选择。召回率 95%+,代价是额外约 1.5 倍内存存图结构。▸ IVF_PQ / SQ8:聚类 + 量化压缩,内存能压到原来的 1/10 到 1/30,代价是精度损失,适合亿级。一句话总结:HNSW 用内存换召回,PQ 用精度换内存,FLAT 用算力换准确。距离度量:余弦(cosine)看方向,L2 看距离,内积(IP)介于两者之间。用 OpenAI / 通义的 embedding 时,向量本身已经归一化过,余弦和 L2 的排序结果一致——这也是为什么不同向量库默认度量不同,但换库之后检索结果几乎不变(今天的代码会实测验证这一点)。换大模型是改一行配置;换 embedding 模型,是整库重建:1. 维度可能变(256 → 1536),不同维度的向量不能混在一个索引里;2. 即使维度一样,两个模型的向量空间完全不同,混着检索等于把噪声喂给模型;3. 所以必须全量重算 embedding → 重建索引 → 灰度切流 → 保留旧库一段时间。面试时补一句"所以我会在入库时把 embedding 模型名和维度写进 metadata",基本就稳了——这是防止混库最省事的一招。pip install langchain==1.4.3 langchain-openai==1.6.6 langchain-text-splitters==1.1.2 langchain-chroma==1.1.0 langchain-milvus==0.4.0 milvus-lite langchain-community==0.4.2 python-dotenv
几个包的说明:langchain-chroma、langchain-milvus 是官方独立集成包(LangChain 1.x 推荐这种拆包方式);FAISS 目前还在 langchain-community 里,导入时会有一条 sunset 弃用提示,代码里用 warnings.filterwarnings 静默掉,不影响使用;milvus-lite 是 Milvus 的本地单文件版,装上才能用 uri=./xxx.db 这种本地连接。没有 API Key 也能跑:代码内置了 LexicalEmbeddings(字符 bigram 哈希向量)和 OfflineChat(脚本化回放的假模型)两个本地替身,四个库全部真实建库、真实检索。填了 .env 就自动切换成真实的 text-embedding-3-small + gpt-4o-mini。OPENAI_API_KEY=sk-xxxxOPENAI_BASE_URL=https://api.openai.com/v1OPENAI_MODEL_NAME=gpt-4o-miniEMBEDDING_MODEL=text-embedding-3-small
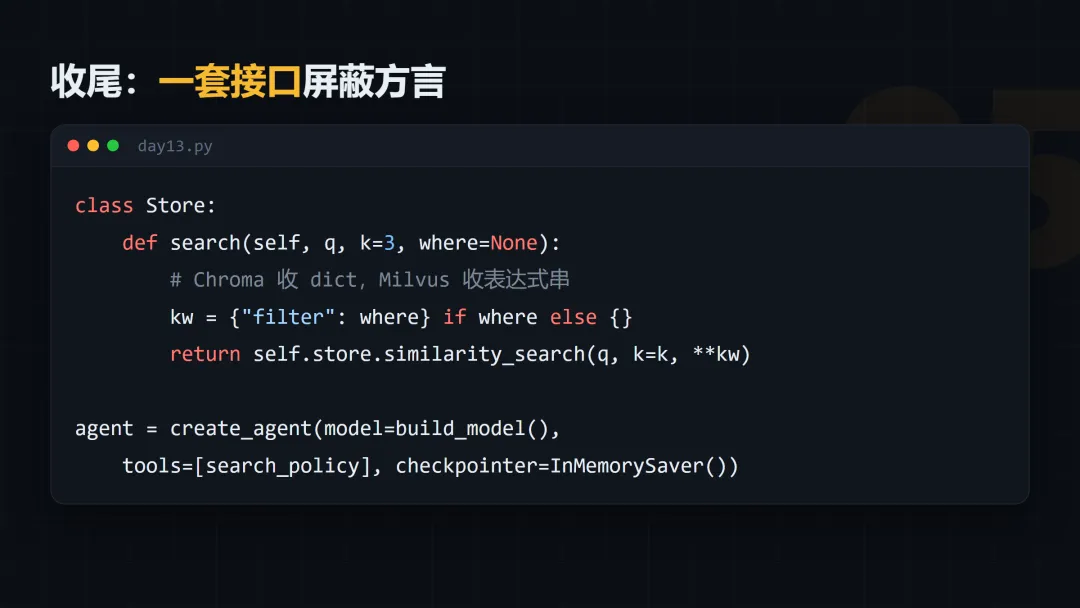
下面就是完整实现(注意看 `Store` 这个门面类:上层 Agent 只调 search(),换库只改 build() 里的一个分支):# uv add langchain==1.4.3 langchain-openai==1.6.6 langchain-text-splitters==1.1.2 langchain-chroma==1.1.0 langchain-milvus==0.4.0 milvus-lite langchain-community==0.4.2 python-dotenv# ---------------- 0. 依赖 ----------------import os, re, time, warnings, zlibfrom dotenv import load_dotenvfrom langchain_core.documents import Documentfrom langchain_core.embeddings import Embeddingsfrom langchain_openai import OpenAIEmbeddingsfrom langchain_text_splitters import RecursiveCharacterTextSplitterload_dotenv() # 读 .env:填了 Key 就自动切真模型# ---------------- 1. 语料切分:沿用 Day12 的报销制度,多给每块挂一个 category ----------------DOC = """【员工报销制度 v3.2】1. 差旅住宿标准:一线城市每晚不超过 600 元,二线城市 450 元,其他城市 350 元。2. 交通标准:高铁二等座,飞机经济舱;连续乘车超过 6 小时可升级高铁一等座。3. 报销时效:费用发生后 30 天内提交,跨年度费用必须在次年 1 月 10 日前提交。4. 审批流程:单笔 1000 元以下由直属主管审批;1000 至 5000 元由部门负责人审批; 超过 5000 元需要财务总监审批,且必须附上级书面说明。5. 发票要求:必须提供增值税发票原件,电子发票需打印并附支付凭证。6. 违规处理:虚报费用一经查实,全额追回并取消当年评优资格。"""CATEGORIES = ["差旅", "交通", "时效", "审批", "发票", "违规"]def build_chunks() -> list[Document]:"""切分时给每块挂上 category 元数据——能不能按元数据过滤,是库和索引的分水岭""" splitter = RecursiveCharacterTextSplitter( chunk_size=60, chunk_overlap=15, # 中文必须自定义分隔符 separators=["\n\n", "\n", "。", ";", ",", " "], ) chunks = splitter.split_documents([Document(page_content=DOC)])for c in chunks: nums = re.findall(r"(\d+)\.\s", c.page_content) # 按「1. 2. 3.」认领类目if nums and int(nums[0]) <= len(CATEGORIES): c.metadata["category"] = CATEGORIES[int(nums[0]) - 1]return [c for c in chunks if c.metadata.get("category")]class LexicalEmbeddings(Embeddings):"""没 Key 时的本地替身:字符 bigram + 哈希桶,256 维,输出 L2 归一化向量""" DIM = 256def _vec(self, t: str) -> list[float]: v = [0.0] * self.DIM s = re.sub(r"\s+", "", t.lower())for i in range(len(s) - 1): v[zlib.crc32(s[i:i + 2].encode("utf-8")) % self.DIM] += 1.0 norm = sum(x * x for x in v) ** 0.5or1.0# 归一化:余弦与 L2 排序一致return [x / norm for x in v]def embed_documents(self, texts: list[str]) -> list[list[float]]:return [self._vec(t) for t in texts]def embed_query(self, text: str) -> list[float]:return self._vec(text)def build_embeddings() -> Embeddings:if os.getenv("OPENAI_API_KEY"):return OpenAIEmbeddings(model=os.getenv("EMBEDDING_MODEL", "text-embedding-3-small"), base_url=os.getenv("OPENAI_BASE_URL") orNone)return LexicalEmbeddings()# ---------------- 2. 四套存储,一套接口 ----------------from langchain.agents import create_agentfrom langchain.tools import toolfrom langchain_chroma import Chromafrom langchain_core.language_models.fake_chat_models import FakeMessagesListChatModelfrom langchain_core.messages import AIMessagefrom langchain_core.vectorstores import InMemoryVectorStorefrom langgraph.checkpoint.memory import InMemorySaverclass Store:"""统一门面:上层(Agent/Retriever)只见 search(),换库只改下面的 build()"""def __init__(self, name, store, note, can_filter): self.name, self.store, self.note, self.can_filter = name, store, note, can_filterdef search(self, q: str, k: int = 3, where: dict | None = None):"""where 统一写 dict;各库方言不同——Chroma 收 dict,Milvus 收布尔表达式串""" kw = {}if where and self.can_filter:if self.name == "Milvus": kw["expr"] = " and ".join(f"{key} == {val!r}"for key, val in where.items())else: kw["filter"] = wherereturn self.store.similarity_search(q, k=k, **kw)def build(backend: str, chunks: list[Document], emb: Embeddings) -> Store:"""后端工厂:新增一种向量库 = 加一个 if 分支,其它代码一动不动"""if backend == "memory": s = InMemoryVectorStore(emb) s.add_documents(chunks) # 进程内字典,进程结束即消失return Store("InMemory", s, "无落盘,重启即丢", False)if backend == "chroma":# 嵌入式库:persist_directory 一给就自动落盘;换成 host/port 就是服务模式 s = Chroma.from_documents(chunks, emb, collection_name="policy", persist_directory="./chroma_policy")return Store("Chroma", s, "自动落盘 ./chroma_policy", True)if backend == "faiss": warnings.filterwarnings("ignore", category=DeprecationWarning) # 官方集成包正在迁移from langchain_community.vectorstores import FAISS s = FAISS.from_documents(chunks, emb) s.save_local("./faiss_policy") # 只有 index.faiss + index.pkl s = FAISS.load_local("./faiss_policy", emb, allow_dangerous_deserialization=True)return Store("FAISS", s, "纯索引,只有 .faiss/.pkl", False)if backend == "milvus":from langchain_milvus import Milvus# Milvus Lite:本地单文件版,uri 换成 http://host:19530 就直连分布式集群 s = Milvus.from_documents(chunks, emb, collection_name="policy", connection_args={"uri": "./milvus_policy.db"}, drop_old=True)return Store("Milvus", s, "Lite 本地库 / 改 uri 上集群", True) raise ValueError(f"未知后端:{backend}")# ---------------- 3. 离线模型替身(无 Key 时按脚本回放) ----------------class OfflineChat(FakeMessagesListChatModel):def bind_tools(self, tools, **kwargs):return self # 补上基类缺失的 bind_toolsdef build_model():if os.getenv("OPENAI_API_KEY"):from langchain_openai import ChatOpenAIreturn ChatOpenAI(model=os.getenv("OPENAI_MODEL_NAME", "gpt-4o-mini"), base_url=os.getenv("OPENAI_BASE_URL") orNone, temperature=0)return OfflineChat(responses=[ AIMessage(content="", tool_calls=[{"name": "search_policy","args": {"query": "虚报费用 追回 评优 资格"}, "id": "c1"}]), AIMessage(content="根据第 6 条:虚报费用一经查实,全额追回并取消当年评优资格。"), AIMessage(content="", tool_calls=[{"name": "search_policy","args": {"query": "电子发票 打印 支付凭证"}, "id": "c2"}]), AIMessage(content="根据第 5 条:必须提供增值税发票原件,电子发票需打印并附支付凭证。"), ])def build_agent(store: Store):@tooldef search_policy(query: str) -> str:"""在员工报销制度中检索相关条款,返回最相关的原文片段。"""return"\n\n".join(f"[{i}] {d.page_content.strip()}"for i, d in enumerate(store.search(query), 1))return create_agent(model=build_model(), tools=[search_policy], system_prompt="你是报销制度助手,先检索再作答,无依据就说「资料未提及」。", checkpointer=InMemorySaver())CASES = [("住一晚最多能报多少?", "差旅"), ("报销时效是多久?", "时效"), ("电子发票要怎么处理?", "发票"), ("超过五千谁审批?", "审批"), ("虚报费用会怎样?", "违规"), ("高铁一等座什么条件?", "交通")]def main() -> None: chunks = build_chunks() emb = build_embeddings() reused = os.path.exists("./chroma_policy") # 第二次运行:库已经在盘上了print(f"[1] 语料:{len(chunks)} 条 chunk,向量维度 {len(emb.embed_query('测试'))}"f" | 磁盘上{'已有' if reused else '还没有'}落盘数据") stores = {}for b in ["memory", "chroma", "faiss", "milvus"]:try: stores[b] = build(b, chunks, emb)except Exception as exc: # 缺依赖就跳过,不打断整体演示print(f"[2] 建库 {b:<12} 跳过:{type(exc).__name__}(pip 装对应包后可复现)") continue tag = "复用盘上数据"if reused and b != "memory"else"重新灌库"print(f"[2] 建库 {stores[b].name:<12} {tag} | {stores[b].note}")print(f"\n[3] 同一个问题在四个库上的 Top1({len(CASES)} 条)") hit = {b: 0for b in stores}for q, want in CASES: row = []for b, s in stores.items(): ok = want in s.search(q, 1)[0].page_content hit[b] += ok row.append(f"{s.name}:{'√' if ok else '×'}")print(f" {q:<12}" + " ".join(row))print(" → " + " ".join(f"{stores[b].name} {v}/{len(CASES)}"for b, v in hit.items()))print("\n[4] 延迟对比(每库 20 次查询;6 条数据,绝对数字无意义,看量级)")for b, s in stores.items(): t0 = time.perf_counter()for _ in range(20): s.search(CASES[0][0], 3)print(f" {s.name:<12} 平均 {(time.perf_counter() - t0) / 20 * 1000:.2f} ms")print("\n[5] 元数据过滤:一句「报销标准」会命中哪些类目?(各取 Top2)") q = "报销标准是什么"for b, s in stores.items(): where = {"category": "差旅"} if s.can_filter elseNone cats = [d.metadata.get("category", "-") for d in s.search(q, 2, where)]print(f" {s.name:<12} {'按[差旅]过滤' if where else '不支持过滤':<8} 命中类目 {cats}")print("\n[6] 生产形态怎么切:Chroma 服务模式 / Milvus 集群,只改连接参数")print(" Chroma(collection_name='policy', host='localhost', port=8000, embedding_function=emb)")print(" Milvus(embedding_function=emb, connection_args={'uri': 'http://localhost:19530'})") agent = build_agent(stores["chroma"]) cfg = {"configurable": {"thread_id": "day13-demo"}}print()for question in ["虚报费用被查出来会怎么样?", "那电子发票呢?"]:print(f"[问] {question}") res = agent.invoke({"messages": [{"role": "user", "content": question}]}, cfg)print(f"[答] {res['messages'][-1].content}\n")if __name__ == "__main__": main()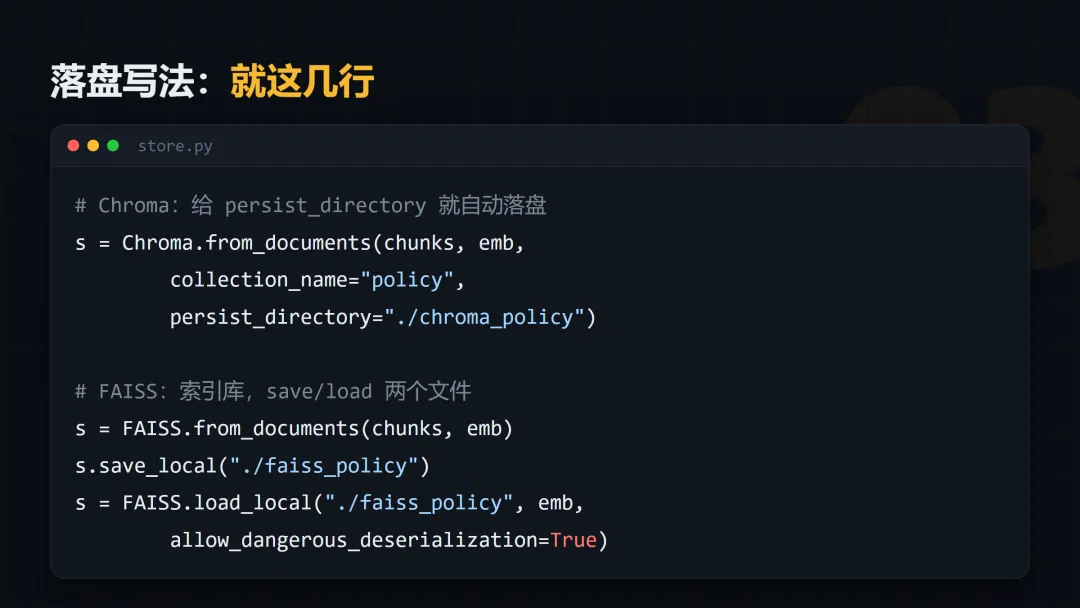
 不填 Key 直接
python day13_向量库选型与本地实操.py:[1] 语料:6 条 chunk,向量维度 256 | 磁盘上还没有落盘数据[2] 建库 InMemory 重新灌库 | 无落盘,重启即丢[2] 建库 Chroma 重新灌库 | 自动落盘 ./chroma_policy[2] 建库 FAISS 重新灌库 | 纯索引,只有 .faiss/.pkl[2] 建库 Milvus 重新灌库 | Lite 本地库 / 改 uri 上集群[3] 同一个问题在四个库上的 Top1(6 条) 住一晚最多能报多少? InMemory:× Chroma:× FAISS:× Milvus:× 报销时效是多久? InMemory:√ Chroma:√ FAISS:√ Milvus:√ 电子发票要怎么处理? InMemory:√ Chroma:√ FAISS:√ Milvus:√ 超过五千谁审批? InMemory:× Chroma:× FAISS:× Milvus:× 虚报费用会怎样? InMemory:√ Chroma:√ FAISS:√ Milvus:√ 高铁一等座什么条件? InMemory:√ Chroma:√ FAISS:√ Milvus:√ → InMemory 4/6 Chroma 4/6 FAISS 4/6 Milvus 4/6[4] 延迟对比(每库 20 次查询;6 条数据,绝对数字无意义,看量级) InMemory 平均 0.18 ms Chroma 平均 0.89 ms FAISS 平均 0.06 ms Milvus 平均 1.32 ms[5] 元数据过滤:一句「报销标准」会命中哪些类目?(各取 Top2) InMemory 不支持过滤 命中类目 ['交通', '审批'] Chroma 按[差旅]过滤 命中类目 ['差旅'] FAISS 不支持过滤 命中类目 ['交通', '审批'] Milvus 按[差旅]过滤 命中类目 ['差旅'][6] 生产形态怎么切:Chroma 服务模式 / Milvus 集群,只改连接参数 Chroma(collection_name='policy', host='localhost', port=8000, embedding_function=emb) Milvus(embedding_function=emb, connection_args={'uri': 'http://localhost:19530'})[问] 虚报费用被查出来会怎么样?[答] 根据第 6 条:虚报费用一经查实,全额追回并取消当年评优资格。[问] 那电子发票呢?[答] 根据第 5 条:必须提供增值税发票原件,电子发票需打印并附支付凭证。[1] 语料:6 条 chunk,向量维度 256 | 磁盘上已有落盘数据[2] 建库 Chroma 复用盘上数据 | 自动落盘 ./chroma_policy[2] 建库 FAISS 复用盘上数据 | 纯索引,只有 .faiss/.pkl[2] 建库 Milvus 复用盘上数据 | Lite 本地库 / 改 uri 上集群
① 四个库的 Top1 命中率一模一样,都是 4/6。 这是今天最重要的结论:换向量库不改变检索准确率。准确率由切分、embedding、召回策略决定(Day12 的三板斧),向量库只决定落盘、过滤、并发、运维。所以面试官问"换个库效果会不会更好",正确答案是"不会,问题不在库"。② 错的两条还是"住一晚最多能报多少"和"超过五千谁审批"。 和 Day12 一模一样——因为那两条本来就是向量检索的短板(数字和跨句长条件),得靠 BM25 和重排救,跟用哪个库没关系。③ 元数据过滤是"库"和"索引"的分水岭。 一句"报销标准是什么",不过滤时命中【交通】【审批】(语义上都像,但答非所问);加上 category == 差旅 过滤后只命中【差旅】。FAISS 和 InMemory 做不了这件事——这就是"为什么我们没用最流行的 FAISS"最实在的答案。④ 延迟数字别当真,看量级就好。 6 条数据下都是零点几毫秒,这个对比没有统计意义;真实差异要到十万级以上、并且开启 HNSW/IVF 之后才会显现。面试时不要背"FAISS 比 Chroma 快 10 倍"这种话,说出"小规模下差异可忽略,规模上去后瓶颈在索引类型和内存"才像做过的。再补一个工程视角:Store 这个门面类把四个库的差异(连接方式、过滤方言、落盘方式)全部关在了 build() 和 search() 里。Chroma 的过滤收 dict、Milvus 收表达式字符串,这种方言差异就是做一层封装的全部理由——上层 Agent 一行都不用改。面试官问"你怎么保证以后能换库",答案就是这层封装。1. 跑通上面的代码(没 Key 也能跑)。然后再跑一次,观察第【2】步是不是变成"复用盘上数据"——去目录里看看 chroma_policy/、faiss_policy/、milvus_policy.db 这三个产物分别长什么样。2. 把第【5】步的过滤条件从 {"category": "差旅"} 改成 {"category": "发票"},观察命中类目的变化。然后想一想:如果业务要求"只在 2024 年之后的文档里搜",FAISS 要怎么实现?进阶(可选): 在 .env 里填上 OPENAI_API_KEY,重跑一次。观察第【1】步的向量维度从 256 变成 1536——然后回答:如果库里已经存了 256 维的老数据,会发生什么?(提示:维度不匹配,旧索引必须整个重建。)✅ 已完成: Day1 概念 → Day2 工具调用 → Day3 记忆 → Day4 ReAct → Day5 LangChain 框架 → Day6 记忆实战 → Day7 周项目① → Day8 CrewAI 多智能体 → Day9 LangGraph 入门 → Day10 RAG 核心原理 → Day11 LangChain 1.x 最小 RAG 实战 → Day12 RAG 调优 → Day13 向量库选型与本地实操(今天) | | |
|---|
| | D9 LangGraph · D10 RAG 原理 · D11 RAG 实战 · D12 RAG 调优 · D13 向量库选型(今天) · D14 周项目② 知识库问答 |
| | D15 LCEL · D16 反思机制 · D17 流式观测 · D18 工具审批 · D19 MCP · D20 安全幻觉 · D21 周项目③ |
| | D22 框架对比 · D23–25 面试专项 · D26 简历包装 · D27 模拟面试 · D28 收官 |
📌 本系列工作日更新,周末休息,工作日早上的内容当晚跑完代码效果最佳。明天 Day14 是第 2 周的周项目:把 Day10–Day13 的 RAG 全链路串起来,做一个本地知识库问答助手(约 200 行,支持 TXT/MD 文件)。今天选好的向量库,明天就要真正用上了。"选型我会先区分向量索引和向量数据库:FAISS 是索引,只做近邻搜索,元数据、权限、增量更新都要自己实现;Chroma 和 Milvus 是数据库,管存储、元数据过滤和并发。我按四个维度选:规模、要不要持久化、要不要元数据过滤、团队有没有运维能力。万级调试用内存库,十万级要落盘和过滤就用 Chroma,千万级以上、要分片副本才上 Milvus,Milvus Lite 本地开发和集群是同一套 SDK 只改连接 uri。索引上小数据用 FLAT,上规模用 HNSW 用内存换召回,极大规模式用 IVF_PQ 用精度换内存。另外我特别会强调一点:换 embedding 等于整库重建,维度不同不能混在一个索引里,所以我会把模型名和维度写进 metadata,采用重建加灰度切流的方式迁。"明天 Day14,把 RAG 全链路串成本地知识库助手 👋