ARTICLE · 1158001
运维知识库(三):文档自动更新后,怎么验证 RAG 找得准?
先做一个小测试:你把 MySQL 排障手册改成了新版,机器人也提示“同步完成”。这时再问同一个问题,怎样证明它用的是新文档?
A. 看回答是不是更长了。
B. 看它有没有引用链接。
C. 看检索结果的文档身份、版本、权限和实际片段。
要验收更新,先选 C。 链接指向最新版,并不意味着送进模型的内容也是最新版;回答流畅,也可能只是把旧步骤说得更像真的。
《手把手教你用AI搭一个运维知识库》解决了知识怎么进入系统,《AI运维知识库(二):飞书机器人+RAG实战》把问答接进工作入口。这一篇补上持续使用后容易缺失的一环:每次更新之后,都能解释它找到了什么、漏掉了什么,以及哪些内容根本不该出现。
下面提供完整的本地验收脚本,不需要模型密钥或向量数据库。它读取你导出的检索结果,检查版本、权限和排名。样例全部是构造数据,演示的是验收方法,不是某个生产知识库的准确率。
一、先把“同步成功”拆成三件事
第一件是源文档抓到了。第二件是新内容进入索引、旧内容得到处理。第三件是提问时确实检索到正确证据。三件事中任何一件失败,机器人都可能继续给出貌似合理的回答。
建议每批更新至少留下下面这些信息,而不是只记录“新增了多少段”:
标题适合展示,不适合独自充当身份。路径移动、页面改名不应悄悄生成两套互相竞争的答案;同一个错误码出现在不同服务的文档里,也不能简单去重成一份。
哈希也不是万能的。正文没变但权限收紧,仍然必须更新检索侧权限;文档原文变了,解析器却没有读到被修改的表格,仅比较解析后正文的哈希可能发现不了问题。因此抓取、解析和索引要各留结果,抽查原文与解析文本的差异。
二、更新可以重试,删除必须有依据
可以从一个保守流程开始:获取本次完整清单,比较文档版本,给变化的文档重新分块并写入候选索引,验收后切换读流量。候选索引只是实现选择,小规模知识库也可以用事务或明确的版本过滤完成相同目标。
关键是别把“这次没抓到”当成“已经删除”。接口超时、分页没读完、权限临时失效,都可能让清单变短。只有明确的删除事件,或确认完整且有权覆盖该范围的源端清单,才能作为删除依据。
例如一次应读取十页却只成功读了第一页,此时应该标记同步失败,保留此前有效内容并告警,不能把其余九页统统清空。若收到明确撤权或删除通知,则应立即阻止相应内容继续被检索,不能以“等待下一次全量”为由继续暴露。
重试时还要避免越写越多:相同文档版本和分块规则,应得到可重复识别的片段。更新后检查旧版本片段、检索缓存和回答缓存;数据库里已经换成新内容,机器人仍可能命中此前缓存的答案。
权限检查应发生在内容交给模型之前。以 Qdrant 为例,检索过滤器可以组合元数据条件;但身份必须来自可信登录态,不能让提问者自己填写权限字段。过滤能力不等于已经接好完整的权限系统。过滤文档:https://qdrant.tech/documentation/search/filtering/
三、运维文档分块,先保住“命令为什么能执行”
命令本身经常只有一行,真正决定能不能用的却是前后的前提:适用版本、执行身份、实例范围、预期输出,以及会不会改变现场。
比如 MySQL 连接排查,把 SHOW GLOBAL STATUS 与状态变量解释分开,模型可能只找到命令,却把累计高水位当成当前连接数。这也是《MySQL Too many connections 怎么解决?连接池排查与容量核算》中需要反复区分的口径。
分块时优先沿标题层级切分,把代码围栏、表格和紧邻解释作为完整单元。过长的章节可以继续拆,但每块带上文章标题、章节路径和必要的适用条件;不要为了保持整段而无限扩大上下文。
验收时可以故意问一句“这个命令能直接在生产执行吗”,看返回片段是否包含执行条件。只返回代码而缺前提,应当记成证据不完整,不能因为找到了同名文档就算全部通过。
下文脚本先做文档级检查,适合发现明显回归。要评价分块质量,需要继续检查实际片段和行号;文档级命中率不会替你完成这部分工作。
四、先攒一套小题库,再比较检索方案
起步不必追求几千题。可以从最近处理过的工单和值班问题中人工整理约三十题,记录问题、提问身份、应返回的证据、关键前提和不该出现的文档。没有真实工单时先用构造题跑通流程,再补真实问题。
同一道题的十种近似说法,不能替代十类问题。给每类单独看结果,才能发现总分上涨时某类关键问题反而退步。调参数使用一组题,最后验收另留一组;不要把所有题都调到命中,再宣称泛化效果得到证明。
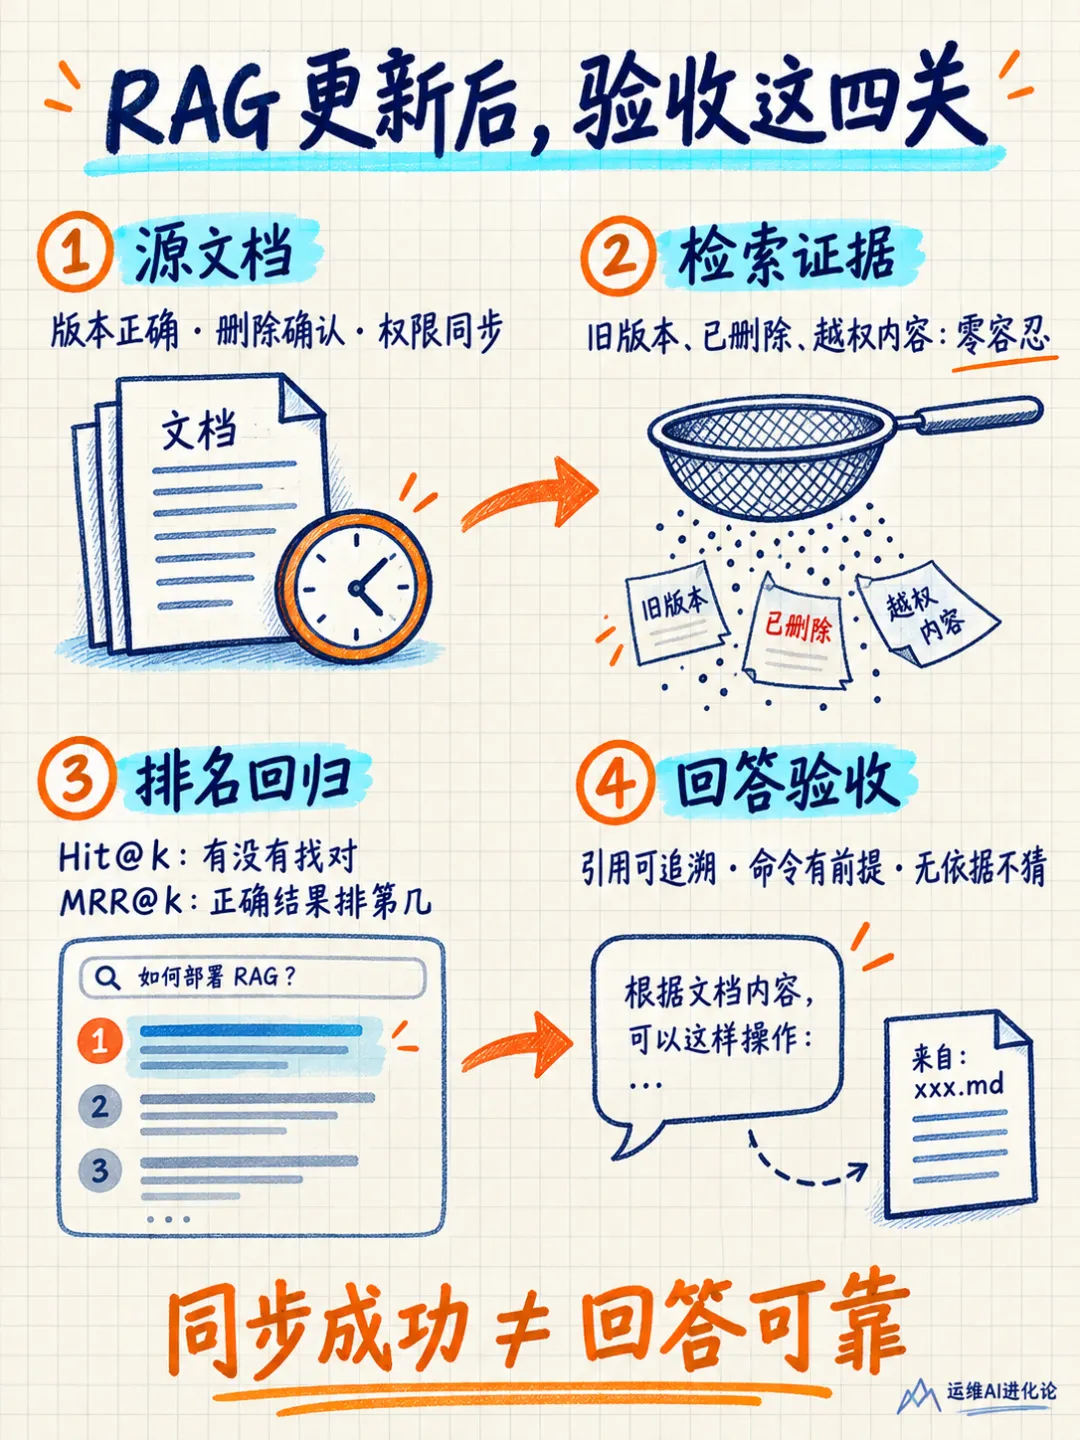
五、看三个分数,再看三个必须为零的错误
本文固定取最终送往模型的前 k 条检索结果,以当前身份可访问、版本正确的文档作为有效证据。
Hit@k 看每道题有没有至少命中一份标准证据,再对题目取平均。Recall@k 看找回了多少份已标注的相关文档,再对题目取平均。相同文档重复出现多个片段,不重复增加 Recall。
MRR@k 看第一份有效相关证据的排名:第一名记 1,第二名记 1/2,前 k 名没有则记 0,再取平均。排名不因清除错误结果而前移。排名评估的官方说明:https://www.elastic.co/docs/reference/elasticsearch/rest-apis/search-rank-eval
如果一道题需要两份文档,只找到一份,Hit 可以是 1,Recall 却只有 1/2。两项都不等于“最终回答正确率”。同时必须单列旧版本、源快照中不存在的文档、越权文档;这三类不能被不错的平均分掩盖。
这里的“相关”来自人工标注。少标了正确证据,会低估检索效果;把仅仅同主题的文档也标成正确,会让分数虚高。首次建题库时,值得找另一位同事复核争议题,尤其是涉及重启、删除和参数修改的答案。
六、完整脚本:把失败原因直接打出来
保存为 evaluate.py,Python 3.9 及以上即可运行,仅使用标准库。
documents 是从源端独立核对过的当前快照,不要从待测索引反向生成,否则旧索引可能自己证明自己正确。readers 在演示中是允许访问的身份列表;真实系统应接入自己的权限判断。results 按最终排名原样导出,不能先人工清理再验收。
#!/usr/bin/env python3
"""只读评估已导出的检索结果;不连接模型或向量库。Python 3.9+。"""
import argparse
import json
import sys
from pathlib importPath


defevaluate(data,k=3):
ifnotisinstance(data,dict):
raiseValueError('输入根节点必须是对象')
iftype(k)isnotintork<1:
raiseValueError('k 必须是正整数')
ifdata.get('complete')isnotTrueornotdata.get('snapshot'):
raiseValueError('必须提供完整、带版本号的源文档快照')
docs,cases=data['documents'],data['cases']
ifnotisinstance(docs,dict)ornotisinstance(cases,list)ornotcases:
raiseValueError('documents 必须是对象;cases 必须是非空列表')
fordocindocs.values():
ifnotisinstance(doc,dict):
raiseValueError('文档记录必须是对象')
ifnotisinstance(doc['version'],str)ornotdoc['version']:
raiseValueError('文档 version 必须是非空字符串')
ifnotisinstance(doc['readers'],list)ornotall(
isinstance(x,str)forxindoc['readers']):
raiseValueError('readers 必须是身份字符串列表')
rows,seen_ids=[],set()
forcaseincases:
ifnotisinstance(case,dict):
raiseValueError('题目必须是对象')
qid,principal=case['id'],case['principal']
ifnotisinstance(qid,str)ornotqidorqidinseen_ids:
raiseValueError('问题 id 必须非空且唯一')
seen_ids.add(qid)
ifnotisinstance(principal,str)ornotprincipal:
raiseValueError('principal 必须是非空身份字符串')
ifnotisinstance(case['relevant'],list)ornotcase['relevant']:
raiseValueError('本评估器仅接收有正确证据的题目')
gold=set(case['relevant'])
ifany(dnotindocsorprincipalnotindocs[d]['readers']fordingold):
raiseValueError('标准证据必须存在且对该身份可见')
ifnotisinstance(case['results'],list):
raiseValueError('results 必须是按排名排列的列表')
found,first,invalid=set(),0,[]
forrank,resultinenumerate(case['results'][:k],1):
ifnotisinstance(result,dict):
raiseValueError('结果记录必须是对象')
doc_id,version=result['doc_id'],result['version']
ifnotisinstance(doc_id,str)ornotisinstance(version,str):
raiseValueError('结果中的 doc_id 与 version 必须是字符串')
current=docs.get(doc_id)
reason=None
ifcurrentisNone:
reason='missing_or_deleted'
elifprincipalnotincurrent['readers']:
reason='forbidden'
elifversion!=current['version']:
reason='stale'
ifreason:
invalid.append({'rank':rank,'doc_id':doc_id,'reason':reason})
elifdoc_idingold:
found.add(doc_id)
first=firstorrank
rows.append({'id':qid,'hit':int(bool(found)),
'recall':len(found)/len(gold),
'rr':1/firstiffirstelse0,'invalid':invalid})
count=len(rows)
bad=sum(len(row['invalid'])forrowinrows)
return{'snapshot':data['snapshot'],'k':k,'questions':count,
'hit_at_k':sum(row['hit']forrowinrows)/count,
'recall_at_k':sum(row['recall']forrowinrows)/count,
'mrr_at_k':sum(row['rr']forrowinrows)/count,
'invalid_results':bad,
'passed':bad==0andall(row['hit']forrowinrows),'rows':rows}


defmain():
parser=argparse.ArgumentParser(description=__doc__)
parser.add_argument('input',type=Path)
parser.add_argument('--k',type=int,default=3)
args=parser.parse_args()
try:
report=evaluate(json.loads(args.input.read_text(encoding='utf-8')),args.k)
except(OSError,ValueError,KeyError,TypeError)aserror:
print(f'输入错误:{error}',file=sys.stderr)
return2
print(json.dumps(report,ensure_ascii=False,indent=2))
return0ifreport['passed']else1


if__name__=='__main__':
sys.exit(main())
脚本仅接受有标准证据的题目。无答案题要另做回答层验收,不能简单把“检索结果为空”当成唯一合格条件,因为系统可能找到背景材料,但仍应拒绝编造具体结论。
下面是完整的故意包含错误的构造样例,保存为 example-bad.json。v1/v2/v3 只是便于阅读的版本代号,生产导出应使用实际版本标识。
{
"snapshot": "demo-s2", "complete": true,
"documents": {
"mysql": {"version": "v2", "readers": ["ops"]},
"nginx": {"version": "v3", "readers": ["ops"]},
"secret": {"version": "v1", "readers": ["admin"]}
  },
"cases": [
    {"id": "q1", "question": "MySQL 1040 先看哪些连接指标?",
"principal": "ops", "relevant": ["mysql"],
"results": [{"doc_id": "mysql", "version": "v2"}]},
    {"id": "q2", "question": "Nginx 504 怎么区分上游连接超时和读取超时?",
"principal": "ops", "relevant": ["nginx"],
"results": [{"doc_id": "mysql", "version": "v2"},
                 {"doc_id": "nginx", "version": "v3"}]},
    {"id": "q3", "question": "更新后的 MySQL 连接排查步骤是什么?",
"principal": "ops", "relevant": ["mysql"],
"results": [{"doc_id": "mysql", "version": "v1"},
                 {"doc_id": "removed", "version": "v1"},
                 {"doc_id": "secret", "version": "v1"}]}
  ]
}
运行:
python3evaluate.pyexample-bad.json--k3
这组样例的实际离线输出是 Hit@3=2/3、Recall@3=2/3、MRR@3=0.5,第三题分别报 stale、missing_or_deleted、forbidden,退出码为 1。它证明检查能抓住预设问题,不代表真实检索性能。
可用下面这段代码制作一份修正后的样例,再跑一次:
import json
from pathlib importPath
p=Path('example-bad.json')
data=json.loads(p.read_text(encoding='utf-8'))
data['cases'][2]['results']=[{'doc_id':'mysql','version':'v2'}]
Path('example-good.json').write_text(
json.dumps(data,ensure_ascii=False,indent=2),encoding='utf-8')
python3evaluate.pyexample-good.json--k3
修正样例的 Hit@3=1、Recall@3=1、MRR@3=5/6,无违规结果,退出码为 0。输入缺失、快照不完整或题库无效时退出码为 2,避免坏输入被算成“全部通过”。
passed 的默认规则只是“每道题至少命中一次,且前 k 条无违规”。它没有要求全部相关文档找齐,也没有比较历史 MRR;正式流水线需要在此基础上加上关键题、分组得分和回归阈值,不能直接把这个布尔值当上线许可证。
七、先定位漏在哪一层,再考虑混合检索
关键词检索擅长保留错误码、参数名等字面信息;向量检索可以补充语义相近但措辞不同的问法。两者各自返回结果后,可以融合排名再重排,但组合得更多并不自动保证效果更好。
一种实现是 RRF,根据各结果列表中的排名融合,而不是直接把不同检索器的原始分数相加。Elastic 的 RRF 说明:https://www.elastic.co/docs/reference/elasticsearch/rest-apis/reciprocal-rank-fusion
比较方案时固定文档快照、问题、身份、k 和上下文预算,分别记录关键词、向量、混合方案的结果与耗时。每次只改一项:分块变了就先验分块,别同时换嵌入模型、重排器和提示词,否则涨跌都很难解释。
若错误码题漏了,先看解析结果是否保留错误码;若原始召回有正确文档而最终结果没有,查重排和截断;若只有某个身份漏了,核对权限条件。正确文档根本没进索引时,换更强的模型通常解决不了问题。
八、最后再问:模型有没有忠实使用这些证据
检索通过以后,再检查回答中的每个关键结论是否有实际片段支持。引用地址能打开只是起点,还要确认对应版本、章节、命令参数及执行条件确实存在。
回答层至少抽查三种情形:证据充分时步骤是否完整;新旧材料冲突时是否识别版本;缺少环境、版本或权限时是否先追问。文档里的命令是待核对的数据,不能因为被检索出来就自动升级为操作授权。
这与《Grafana 大盘怎么用 AI 生成?从 PromQL 到可导入 JSON》里的验收思路相通:能生成不等于算得对。RAG 也要把同步、检索、回答分开验收。
每批发布保存源快照编号、索引与模型版本、题库版本、检索导出及失败题。出现回归时先定位具体变化,再决定是否回退索引;回退不能恢复已撤销的访问权限或重新暴露已删除内容。这样下次有人问“更新后到底好没好”,能拿出来的是可复核结果。
下一篇预告: Load average 很高但 CPU 不忙。沿着运行队列、D 状态和 I/O 等待,把“机器很忙”拆成可以核对的证据。
觉得有用?分享给更多运维同行看到 👇
转发给正在给知识库加自动同步的同事,更新之后,把旧版本和越权内容也一起验掉。
相关阅读:
AI运维知识库(二):飞书机器人+RAG实战,3步打造团队共享检索
MySQL Too many connections 怎么解决?连接池排查与容量核算
我是「运维AI进化论」,一个用AI武装自己的运维工程师。分享运维+AI实战干货。关注我,一起进化 🚀