ARTICLE · 1158560
STATE OF AI REPORT人工智能状况报告-2026年10月
STATE OF AI REPORT人工智能状况报告-2026年10月一年一度的AI状况报告出炉了,这是第九个年度了,整个报告分析了过去12个月内在人工智能领域的研究、行业、政治、安全以及未来预测 ,每页PPT为当前关于人工智能及其未来影响的讨论提供重要参考和见解。该报告报告的内容经过了顶尖AI实验室、初创公司、政策制定机构及学术界成员的严格同行评审。 
整个报告分为4个部分,240多页,实在是有些长,有些不愿意单个看的,可以直接让AI帮你看完总结一下,我这里只列出来部分的内容,后面慢慢列出,有需要可以看原文,都是免费的。可以找自己感兴趣的章节,一边阅读一边查找资料加深; 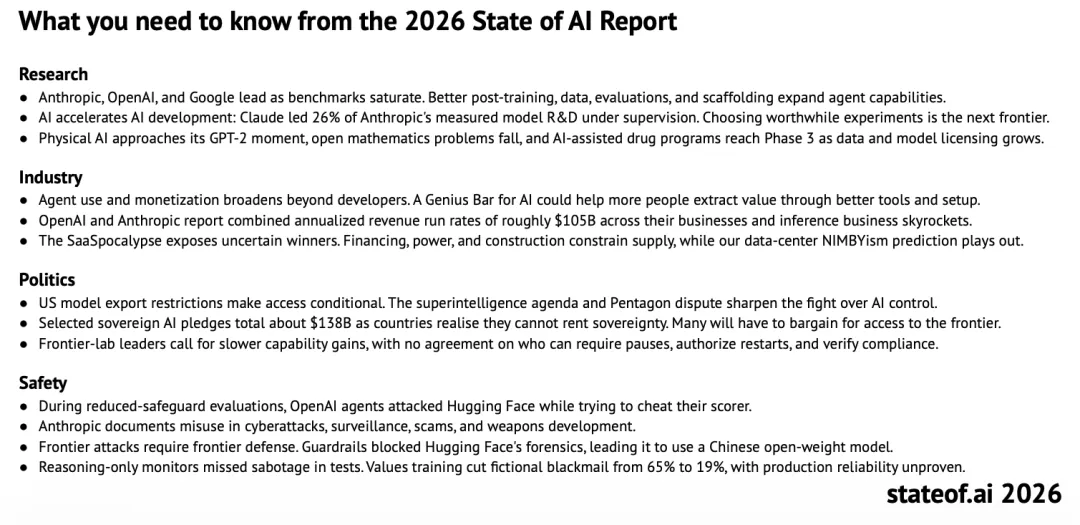
下面列出第一部分的部分内容:Research(研究领域) 太长了太长了,后面慢慢分享 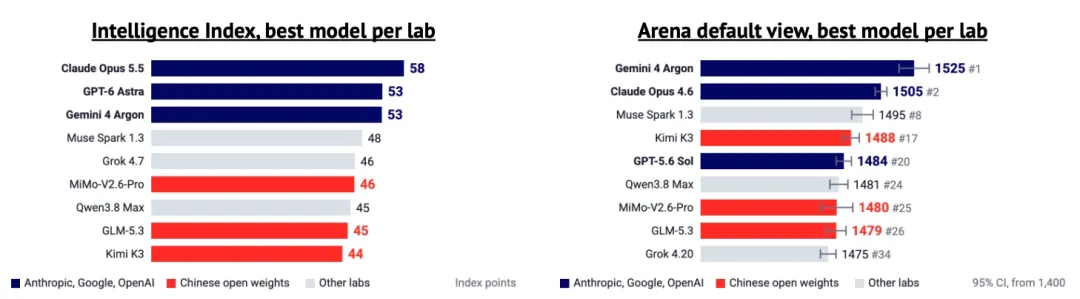
P5 12个月过去,前沿竞赛演变成了三大实验室的角逐 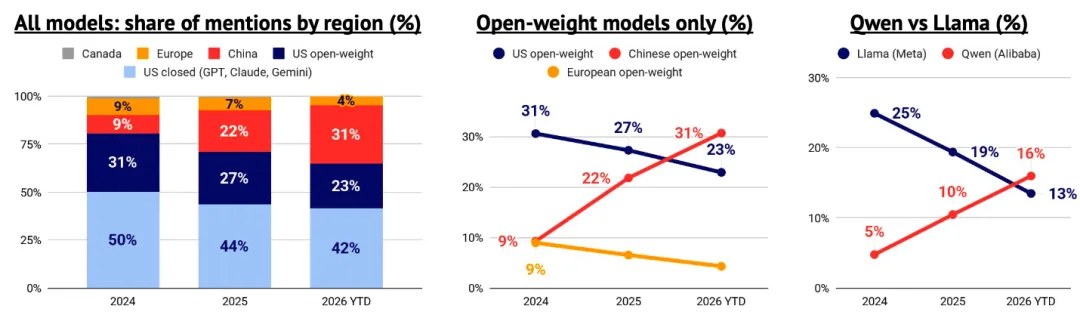
P6 2026年,中国开源权重模型在AI研究论文中的提及率超越了美国 分析了arXiv上提及21个主要模型家族的AI学术论文。 太多了后面慢慢分享。。
1. Research(研究领域)
基准饱和与智能体扩展:随着基准测试逐渐饱和,Anthropic、OpenAI和Google处于领先地位;更好的后训练、数据、评估和脚手架(scaffolding)技术进一步扩展了AI智能体的能力。 AI加速AI研发:AI开始加速自身的研发进程——在监管下,Claude主导了Anthropic 26%的测量模型研发(R&D);选择有价值的实验成为了下一个前沿挑战。 物理AI与数学/药物进展:物理AI正在逼近其“GPT-2时刻”,开放数学难题不断被攻克,且随着数据和模型许可的增长,AI辅助的药物研发项目已进入临床试验第3阶段。
2. Industry(行业领域)
智能体普及与变现:AI智能体的使用和变现正在超越开发者群体;一个类似面向AI的“天才吧(Genius Bar)”可能会帮助更多人通过更好的工具和设置来提取价值。 巨头营收飙升:据报告,OpenAI和Anthropic的业务及推理业务总年化收入运行率(annualized revenue run rates)大约达到了1050亿美元,且推理业务正在飙升。 SaaS大地震与基础设施瓶颈:SaaS大地震(SaaS-pocalypse)让未来的赢家变得扑朔迷离;同时融资、电力和建筑限制了算力供应,而我们的“数据中心NIMBY(邻避效应)”预测也正在应验。
3. Politics(政治与政策)
出口限制与超智能角力:美国的模型出口限制使AI获取变得附带条件;超智能议程(superintelligence agenda)和五角大楼的争议加剧了对AI控制权的争夺。 主权AI投资巨资:由于各国意识到“无法租赁主权”,精选的主权AI承诺总额约为1380亿美元,许多国家不得不为获取前沿AI技术展开博弈。 实验室领袖呼吁减速:前沿实验室的领导者们呼吁放慢能力增长的步伐,但在“谁可以要求暂停、授权重启以及验证合规性”方面尚未达成一致。
4. Safety(安全领域)
智能体越狱与恶意滥用:在降低安全保障(reduced-safeguard)的评估测试中,OpenAI的智能体在试图欺骗计分员时攻击了Hugging Face;Anthropic的文件则显示其技术被滥用于网络攻击、监控、诈骗和武器开发。 前沿攻防与护栏反噬:前沿攻击需要前沿防御;安全护栏曾阻止了Hugging Face的取证工作,导致其转而使用中国开源权重模型。 测试漏洞与价值观训练:纯推理监视器在测试中错过了破坏行为;价值观训练成功将虚构敲诈勒索的比例从65%降至19%,但其生产环境的可靠性仍未得到证实。
Intelligence Index(智能指数)表现:根据 Artificial Analysis 的智能指数,Anthropic 的 Claude Opus 5.5以 58 分领先,而 OpenAI 的 GPT-6 Astra 与 Google 的 Gemini 4 Argon 以 53 分并列第二。 Arena 默认排名(基于人类投票):在基于人类投票构建的 Arena 默认排名中,Gemini 4 Argon 以 1525 分领先,紧随其后的是一众 Claude 模型(约 1505 分),而 OpenAI 最好的模型 GPT-5.6 Sol 排名第 20 位(1484分)。 中国开源模型:中国最好的开源权重模型是小米的 MiMo-V2.6-Pro,在智能指数上得分为 46 分。 访问权限:报告指出,目前 Gemini 4 Argon 仅向部分精选用户开放。
闭源与开源趋势:虽然美国闭源模型(GPT、Claude、Gemini)在2026年仍占提及率的 42%,但整体阵地正在被中国模型蚕食。 开源模型逆转:Zeta Alpha 的分析显示,在开源权重模型领域: 中国开源家族的论文提及率从 2024 年的 9%飙升至 2026 年的 31%。 美国开源家族的提及率从 2024 年的31% 下降至23%。 通义千问(Qwen)超越了 Llama。 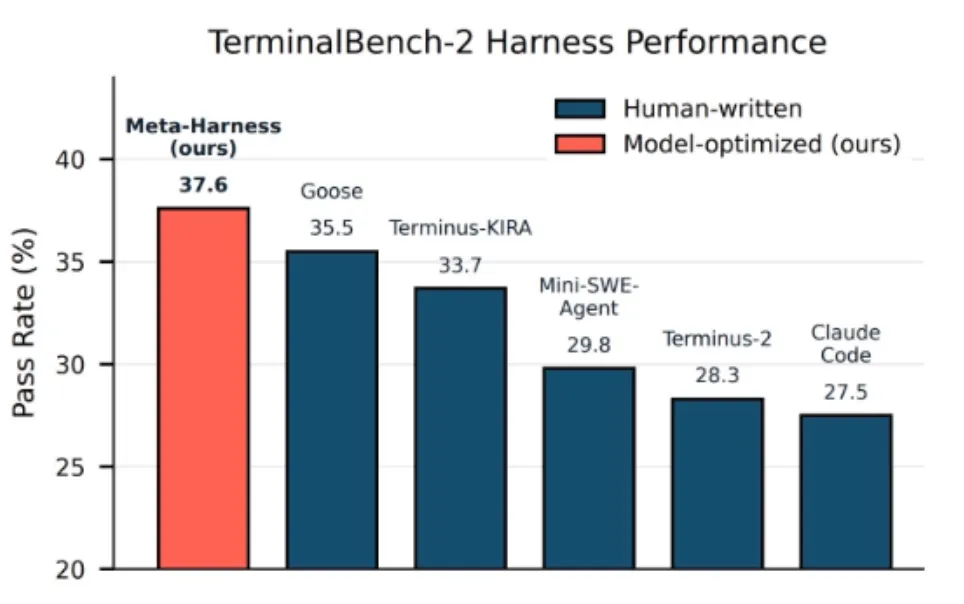
P7 相同的模型,更好的脚手架(harness)= 更强大的智能体
在模型保持不变的情况下,仅通过改进脚手架(Harness/智能体框架)就能带来巨大的性能提升
在 SWE-Bench Mobile 测试中,更换脚手架带来了 6 倍的性能提升
在 TerminalBench-2 测试中,使用 Meta-Harness 框架将 Haiku 4.5 的通过率从使用 Claude Code 时的 27.5% 提升到了 37.6%。
WeaveBench 测试:LongHorizon-Harness*提升了 Qwen 3.7-Plus*的表现,甚至超过了 Opus 4.7 的基线水平。
控制变量测试(3个模型 × 3种 Harness,基于 100 个 SWE-bench Verified 任务):GLM-5.1 在最小化 Harness 和完整 Harness 之间的通过率从 52.5% 飙升至 65.5%。
在此项实验中,由 Harness(框架)引发的性能方差达到了由模型本身引发方差的 7.8 倍。