ARTICLE · 1160675
文档解析模型 MinerU 又升级了!专门处理跨页段落、表格、标题和图像!
文档解析模型 MinerU 又升级了!专门处理跨页段落、表格、标题和图像!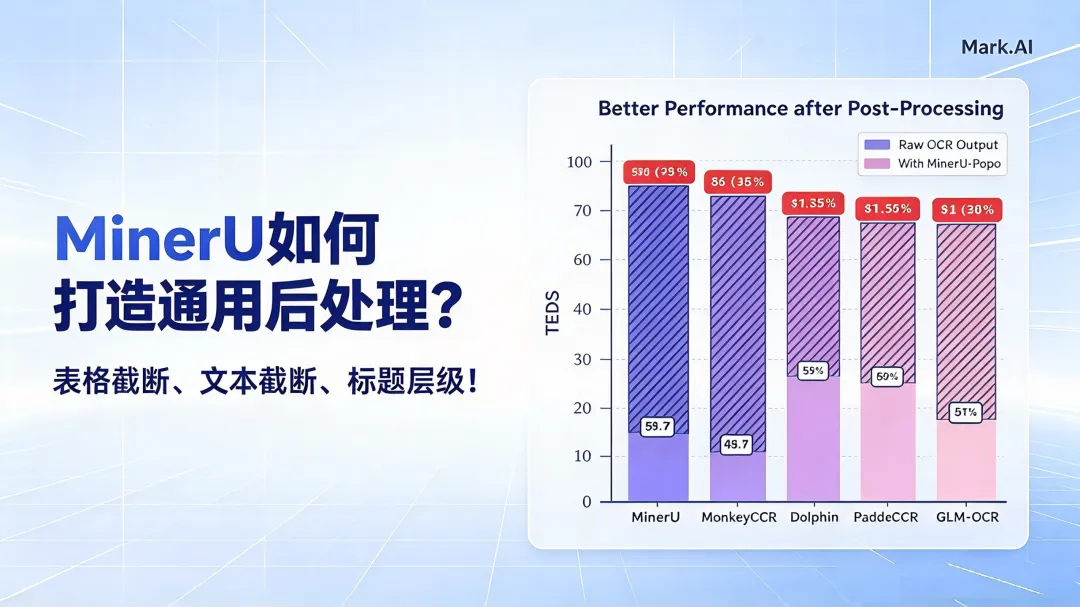
// 近期文档解析热门文章 
目前一线的OCR模型,单页解析已经足够强了!
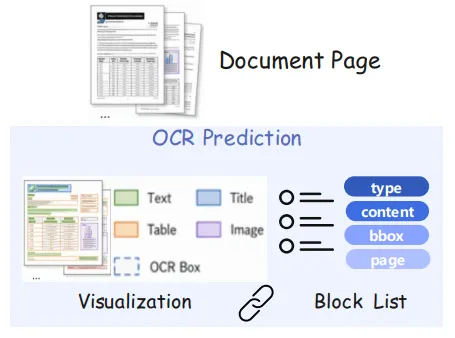
元素类型、位置框、阅读顺序、文本内容,一页一页给你抠得清清楚楚。
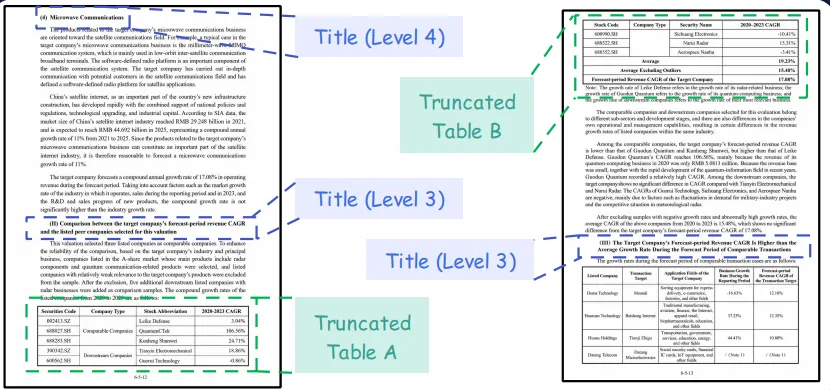
但是一份PDF里,表格会横跨两页,模型把上半部分解析成表格A,下半部分解析成表格B。
标题和段落也是一样,跨页的标题和段落,模型往往给出独立的解析结果。
这种逐页OCR破坏了跨页连续性,而 RAG 等下游应用需要连贯的文档级信息。
一个自然的解决方案是,复用现有OCR输出,通过后处理重建文档级逻辑结构。
上海交通大学、上海人工智能实验室等机构联合提出了MinerU-Popo,一个专门做OCR后处理的轻量级通用框架。
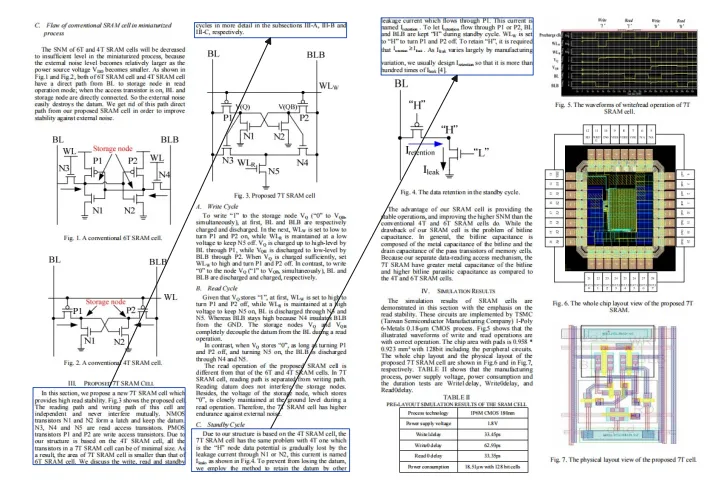
总参数4B,干四件事,表格截断分析、文本截断分析、标题层级分析、图文关联分析。
# PaperMinerU-Popo: Universal Post-Processing Model for Document Parsing# Arxivhttps://arxiv.org/pdf/2605.24973# Codehttps://github.com/opendatalab/MinerU-Popo
一、一个OCR后处理这么难吗?
MinerU、PaddleOCR、GLM-OCR、Dolphin、MonkeyOCR,这些VLM做的OCR模型,输出内容足够细致。
其可以从单个页面提取元素类型、边界框、阅读顺序和文本内容,每个块关联内容和坐标。
但仅仅采用轻量级规则进行归一化后处理,扩展性差。使用通用VLM进行后处理,对于海量文档来说成本高昂。
那理想的OCR后处理框架,既要扩展性强、通用性好,又要轻量级、可部署。就要解决以下挑战!
跨页连续性问题,分页破坏了文档的逻辑流,导致相关元素出现在不同页面。
冗余文档解析,文档解析输出是全面的,包含所有元素块的详细信息,如何过滤无用信息?
长文档可扩展性,处理几百页的文档,单次输入会超出轻量级模型的上下文限制。
二、MinerU 如何打造通用后处理?
既然一个文档级解析,需要跨多个页面联合分析标题、段落、表格和图像。
MinerU-Popo 就把后处理拆成四个子任务,每个子任务只接收它需要的那部分OCR信息,其余全部过滤掉。
前三个比较直白,跨页表格合并、跨页段落拼接、图文归属判断。真正有意思的是第四个,标题层级重建。
大多数OCR模型只认两级标题,好一点的认三级。MinerU-Popo预测的是开放式整数级别,文档嵌套多深,它就认多深。
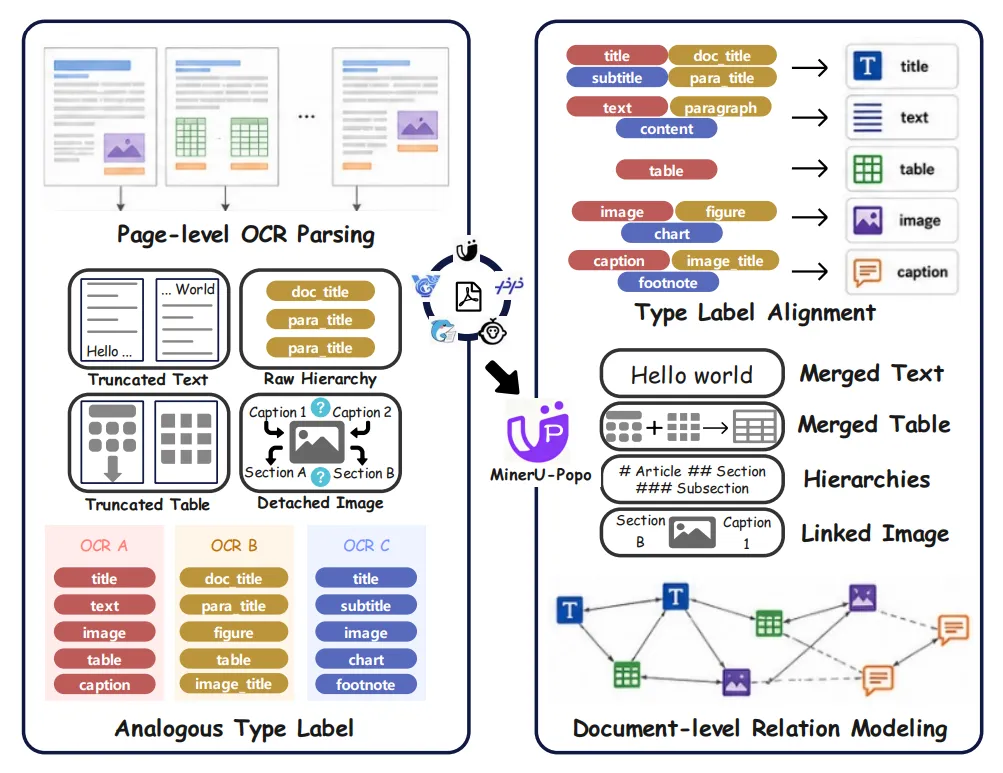
把四个任务加起来,就是把页面级的碎片,重组成文档级的树。
这对下游RAG来说是刚需,你检索到的不再是一段文本,而是一个有上下文、有层级、有摘要的节点。
论文里面也做了对应的试验,在RAG和端到端QA任务上,每次查询延迟最多降低70%!
什么意思呢?比如检索一次要等1秒,现在0.3秒!整个系统体验更流畅。
之前文章有介绍过MinerU2.5,可以自己翻阅查看下,MinerU系列的确是一个可用的模型。
把四个任务加起来,就是把页面级的碎片,重组成文档级的树。
这对下游RAG来说是刚需,你检索到的不再是一段文本,而是一个有上下文、有层级、有摘要的节点。
论文里面也做了对应的试验,在RAG和端到端QA任务上,每次查询延迟最多降低70%!
什么意思呢?比如检索一次要等1秒,现在0.3秒!整个系统体验更流畅。
之前文章有介绍过MinerU2.5,可以自己翻阅查看下,MinerU系列的确是一个可用的模型。
把四个任务加起来,就是把页面级的碎片,重组成文档级的树。
这对下游RAG来说是刚需,你检索到的不再是一段文本,而是一个有上下文、有层级、有摘要的节点。
论文里面也做了对应的试验,在RAG和端到端QA任务上,每次查询延迟最多降低70%!
什么意思呢?比如检索一次要等1秒,现在0.3秒!整个系统体验更流畅。
之前文章有介绍过MinerU2.5,可以自己翻阅查看下,MinerU系列的确是一个可用的模型。
最后,小伙伴们可留言回复或者公众号后台回复‘加群’进入大模型交流群、视觉应用落地交流群!
记得点击下方卡片,关注并星标码科智能!