ARTICLE · 1183713
我让 AI 拆了几个本地软件,最有价值的收获却不是代码
最近,我把 REA 接进了 Codex,拿本地几个桌面软件做了一轮研究。
从网易云音乐,到 WorkBuddy、Codex,再到 SpatialMind。最初只是好奇:AI 配上逆向工具,究竟能看进去多少?
后来问题越来越具体:资源包里装了什么?界面怎样调用功能?Agent 怎么组织执行?工具审批放在哪里?那些一边输出、一边收缩的会话动效,到底怎么做的?
这一圈下来,最有价值的收获,是终于能把“这个产品做得不错”,拆成一组可以核验、讨论和借鉴的设计。
中间也踩了一个很典型的坑:AI 给你做出一个像样的演示,不代表它还原了原产品。
先接上工具,再谈它有多厉害
REA 是一个逆向分析工具项目。接入 Codex 后,我可以在聊天里提出目标,让 AI 调用分析工具,再根据结果继续追查。
不过,配置写进去和工具真正可用,中间还有一段距离。
我们这次就碰到了 Node 版本兼容问题。解决运行环境、完成 MCP 注册之后,还要确认当前会话能发现工具,并且确实分析了一个样本。最初注册完,当前聊天也没有立即加载新工具,重启、重新连接后才继续验证。
所以我现在判断这种工具是否“装好了”,至少看三件事:安装能检查、客户端能连接、真实样本能走通。
至于分析路线,要跟着目标走。JavaScript、Electron 资源包和原生二进制,难度与所需工具不同。遇到原生代码,仍然需要相应的反汇编、反编译能力,不能因为前端文件好读,就以为整个软件已经被看透。
网易云给我的第一课:后缀不等于内部结构
研究网易云音乐时,我们碰到了 NTPK 资源包。
乍一看,这种专用后缀很容易让人觉得,它是一套完全特殊的格式。实际检查后,发现本机版本中的一个资源包,在一段自定义前缀之后,就是普通 ZIP。
沿着容器结构继续分析,最终四个资源包合计提取出 1,765 个文件,并完成了 ZIP 成员的 CRC 校验。里面的 HTML、JavaScript、CSS、图片,让界面和功能入口变得具体起来。
这一步很有启发:研究发布包时,先确认它是什么,再决定用什么工具。
有的目标需要反编译,有的先把资源容器识别正确,就已经打开了一大半。
但资源恢复也有明确的边界。能提取页面和脚本,并不代表播放、歌词等功能已经可以独立运行。前端仍可能依赖原生桥接、协议处理和运行环境。
这次研究没有修改客户端的签名检查,也没有拿账号数据或歌曲缓存当分析材料。我们关注的是安装包中的资源和调用关系。
最有意思的部分,是我把 AI 做的演示否了
后来,我想看 AI 软件在执行任务时的会话效果。
就是大家熟悉的那种:文字逐步到达,读取文件、执行命令穿插出现,前面的步骤又会收成一小行摘要,最后留下回答。
AI 最初做了一个动态演示。
它会输出文字,会展示步骤,看着也像一个 Agent 在工作。但我看完觉得不对:原产品不是把所有内容一直往下排,它会边执行边收缩。
修改之后,还是不对。
我干脆问:“你到底能不能按他们的原样搬出来?”
这句话把研究方向拉了回来。继续凭印象写一套相似界面,无法回答原产品究竟怎样组织会话。于是我们去定位发布包里的原组件,加载原样式,在独立宿主中回放虚构的任务事件。
这次才终于对上了。
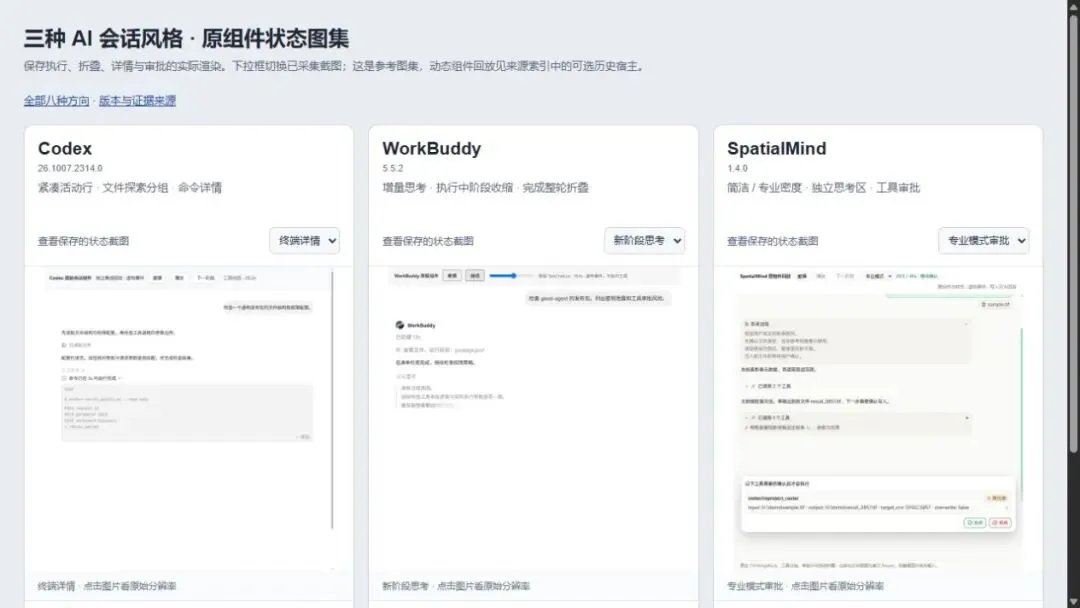
图中为原发布组件在独立测试宿主中的截图,任务事件是虚构回放;上方播放控制条属于测试宿主。
这里也要说清楚:我们运行的是原会话组件的局部,不是把完整桌面客户端复制出来。回放没有调用真实模型,也没有执行截图里的业务工具。
即便如此,它已经足够回答那几个最重要的界面问题:什么时候分组?什么时候收缩?完成后保留什么?用户能怎样展开回看?
三个产品,三种组织执行过程的方法
看原组件之后,差异就很清楚了。
Codex 把工具活动压得比较紧凑。 文件探索可以归成一组,命令默认显示摘要,需要时再展开终端内容。完成之后,过程进入披露入口,最终回答继续留在正文里。
WorkBuddy 更强调执行中的阶段收缩。 当前阶段继续输出,前一阶段的思考、文件读取和命令活动,可以收成一条有含义的摘要。结束后,再把整轮过程折叠起来。
这正是我之前一直觉得“没做对”的地方。只加一个折叠按钮,无法复现它在执行过程中不断整理历史的感觉。
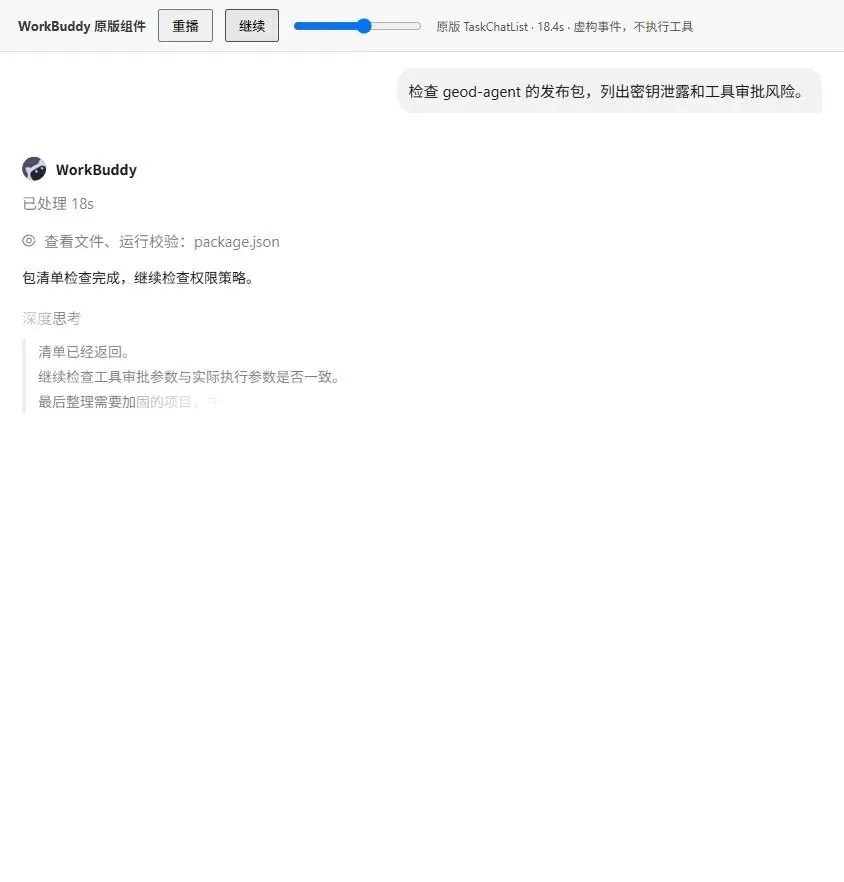
原组件回放截图:前段已收为摘要,新阶段继续输出。文字和任务均为演示内容。
SpatialMind 则提供了两种信息密度。 简洁模式把中间过程收起来,专业模式保留更多中间内容;思考区、工具组和审批区也有各自的组织方式。
这些差异让我意识到,AI 会话设计的重点,是让用户随时知道:现在做什么、前面做过什么、哪里需要我决定,以及结果在哪里。
如果过程全部展开,用户会被细节淹没;如果只剩一个转圈,用户又无法判断系统到底有没有在工作。
好的会话界面,处理的是这两种需求之间的平衡。
从“看懂别人”到“改进自己”
我们做 geod-agent,这些观察可以直接转化成产品问题。
例如,一次影像任务可能经过检索、筛选、下载、处理和产物检查。正在下载时,用户需要看到进度;已经完成的检索过程,可以收成摘要;涉及覆盖文件或执行外部操作时,需要单独展示审批;最后的产物,应有明确的查看入口。
这些只是设计参考,具体实现仍要接到自己的真实事件和执行状态上。
特别是审批:界面显示“已批准”,不能替代后端确认。一个漂亮的审批卡,也不能证明工具真的被权限规则拦住了。
我们也追查了 Agent 调度、MCP 和 Skills 的部分发布代码。静态代码能帮助理解控制流,但一些原生模块没有完整反编译,真实后台恢复和工具执行也没有全部跑过。因此,观察到的代码逻辑、局部界面回放、真实后端测试,必须分别记录。
这套经验对安全检查同样适用。发布包能揭示暴露的配置、接口入口和客户端校验位置,却不能单靠一次搜索就宣布“绝对没有密钥泄露”或“肯定无法绕过”。真正关键的权限、授权和计费判断,需要在可信的一侧执行。
最后,我们把这轮已经核验的 Codex、WorkBuddy、SpatialMind 会话规则,整理进自己的 UI 技能资料:保存状态截图,记录版本和证据,明确分组、折叠、展开、审批与滚动的区别。
这样下一次开发时,就不用再从“做一个好看的聊天框”开始。可以直接讨论:这个任务需要哪种信息密度,什么时候该收缩,什么内容必须留给用户检查。
这也是我现在最看重 REA 的地方。
它让产品研究有机会从感觉走到证据。但工具得到的结果,还需要人不断追问、核验和纠正。
尤其当 AI 给你一个很像的答案时,最好再问一句:
这是从原实现里验证出来的,还是你觉得它应该如此?
研究记录:2026 年 10 月的本地样本。会话参考版本为 Codex 26.1007.2314.0、WorkBuddy 5.5.2、SpatialMind 1.4.0,后续版本可能变化。研究结论来自本地资源提取、发布代码分析和独立组件回放,不代表完整客户端或真实后端已复现。