ARTICLE · 1189466
MinerU免费本地提取图片PDF内容
MinerU免费本地提取图片PDF内容
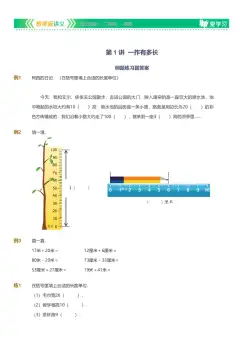
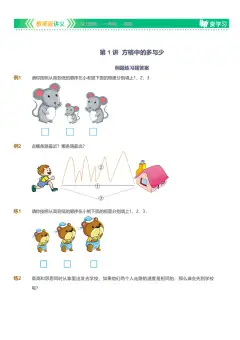
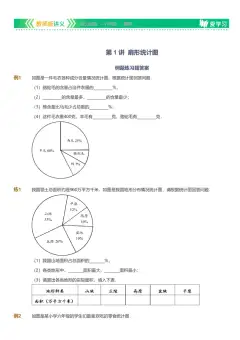
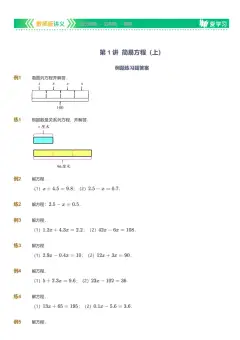
1. 把PDF交给AI后回答总有偏差,问题有时出在内容提取:扫描页没有文本层,表格行列被打散,双栏顺序和公式符号也可能转换错误。MinerU 先做文档解析,减少把混乱材料继续交给模型的问题。
2. 它能处理PDF、扫描图片及多种办公文档,识别标题、段落、表格、公式与图片,再导出Markdown等结构化结果。分页文档可保留位置标记,方便找到原文核对;这些能力不等于识别永远正确。
3. 可以让支持本机操作和技能的AI助手协助安装,也可以自己按文档部署。默认本地处理;若走网页版或配置远程解析,文件会上传,敏感材料不要随意交给外部服务。
4. 一般本地使用不需另付软件许可费,但要承担硬件与维护成本。许可证有附加条件:使用方及关联方合并月活超过一亿,或月总收入超过两千万美元,需另行商业许可;对外提供服务还有标识要求。
5. 先用一份不敏感文件试,重点核对数字、合并表头、手写与公式,再逐批扩大。只偶尔看一两页文档,可先用现有工具。项目:github.com/opendatalab/MinerU。
项目页面显示英文可用浏览器翻译;若页面或下载无法访问,请检查自己的网络条件。
#GitHub挖宝# #开源工具#
北京,3小时前,