ARTICLE · 1204329
AgentScope Java 源码解析系列第 2 篇 Workspace|一棵会自己整理自己的文件树(Agent 记忆 / 上下文压缩)
AgentScope Java 源码解析系列第 2 篇 Workspace|一棵会自己整理自己的文件树
Agent 的长期状态不进数据库,进一棵文件树;读写全外包给一个可插拔接口,记忆靠「流水账 + LLM 定期合并」自己长大。
先看我本机跑出来的一行真实输出。我给 Agent 出了个坏主意:往工作区外面写文件,路径里塞 ../../,一路摸到我用户目录底下去——
这是 AbstractFilesystem.validatePath 抛出来的(v2.0.4 源码,L185)。挡住它的这层代码,就是今天要拆的 Workspace 模块的门口。这个模块管的事比「拦路径」大得多:AgentScope Java 里 Agent 的长期记忆、技能、知识、会话记录,全部长在一棵普通文件树上,而且这棵树会自己整理自己。
第 1 篇讲 HarnessAgent 时埋了个钩子:「全家桶不是新引擎,是一摞中间件和一棵会进化的工作区」。中间件那半已经拆完了,这篇拆另一半。
📁 系列导航
本文是 AgentScope Java 源码解析系列 第 2 篇(Workspace 模块)。
已发篇目(按依赖顺序,附一句话结论):
第 1 篇 HarnessAgent:HarnessAgent 不是新引擎,是包在 ReActAgent 外面的一摞中间件(build() 装配 14 步)加一棵会进化的工作区;子 Agent 只当叶子、Skill 自学习默认全拒绝、Plan Mode 只读白名单
第 2 篇 Workspace(本文):Agent 的长期状态不进数据库,进一棵文件树;读先问可插拔的 filesystem 层、写全走这一层,记忆靠「流水账 + LLM 定期合并」自己长大
下一篇:候选是 Skill 自学习闭环(_drafts → 审批 → 转正)或 sandbox 执行后端(Docker/K8s/E2B),看这篇留言想看哪个。关注追更,系列更完后会整理总目录。
WorkspaceManager全程几乎不直接碰磁盘:读先问 filesystem 层、写全走 filesystem 层,本地盘只是兜底——这一层外包,换来 Local / Overlay / Remote / Sandbox 四种存储形态不改一行业务代码切换「长期记忆」是两层普通文件: memory/YYYY-MM-DD.md流水账(append-only,每次上下文压缩都追加一段)+MEMORY.md精编版,由MemoryConsolidator定期让 LLM 合并去重,进度水位线记在memory/.consolidation_state隔离靠三道闸,不靠路径约定: LocalFsMode三档(SANDBOXED / ROOTED / UNRESTRICTED)、PathPolicy宿主机目录白名单、NamespaceFactory给用户/会话加路径前缀OverlayFilesystem是写时复制:改共享技能只写进上层,delete根本删不到共享层——「个人定制不污染公共资产」是强制的,不是靠自觉源码里最诚实的一段注释在 WorkspaceManager的pathLocks字段上:这个锁只管本进程,跨副本是 last-writer-wins,真正的乐观并发在AgentStateStore#saveIfVersionv2.0.4(10-08 发布)新加的 sharedLocalWorkspace是个单租户逃生舱,javadoc 直接写明「多租户不安全」
AgentScope Java 把「状态放哪」整个外包给一个可插拔的 filesystem 接口,再把 Agent 的记忆、技能、知识全变成 Agent 自己能用文件工具读写的普通文件,最后让 LLM 自己当「整理员」。这套「存储全外包、状态文件化、整理交给模型」的三段式,不挑语言,搬到任何 Agent 框架都成立。
适合谁读:在写或准备写 Java Agent、关心「Agent 的记忆和状态到底放哪」的后端工程师。预计阅读:主线 16 分钟(3 张按需查阅的字段表另需 4 分钟)。
一棵目录树,凭什么当「记忆」
先把问题摆清楚。2.0 的 ReActAgent 是彻底无状态的:一次调用里的临时状态全靠 Reactor Context 传递,同一个实例可以安全地并发服务多个 (userId, sessionId) 组合。这是好事——但状态总得有地方待。会话历史、长期记忆、技能定义、子 Agent 声明,这些跨请求活着的东西放哪?
传统答案是个数据库,外加一张 schema。AgentScope Java 的答案是一棵目录树。而且它的姿态很松:WorkspaceManager.validate()(L202-226)在构建时只做检查、只打 warning——目录不存在、AGENTS.md 缺失,都不拦着你跑。工作区不是必须初始化的基础设施,是一棵「没有也能活、有了会活得越来越好」的树。树长这样:
(依据:WorkspaceManager 类注释 L85-97、WorkspaceConstants。默认根目录 .agentscope/workspace。)
这棵树不是被动存储。官方 WorkspaceSetupExample 的注释写明了运行时语义:AGENTS.md 每一轮推理都注入 system prompt;KNOWLEDGE.md 全文注入,knowledge/ 下其他文件只列路径、按需读取;往 subagents/ 里丢一个 .md 文件,这个子 Agent 就能被 agent_spawn 调起来。工作区就是活的提示词材料。
这棵树的每个位置都有明确分工,字段表如下(核心,必读——这张表就是本模块的「数据结构」,调试时先回来查它;后面三张表按需查阅即可,不影响理解主线):
(依据:WorkspaceConstants 各常量、WorkspaceManager 类注释 L85-97、MemoryConsolidator.STATE_FILE、PlanModeManager.DEFAULT_PLAN_DIR。)
为什么选文件树而不是数据库?我在源码里能指认的理由有三个。第一,Agent 自己的文件工具(read/write/edit/grep/glob)就是记忆的读写接口,不需要第二套 API——你给 Claude Code 用过就知道这套交互有多顺。第二,文件树人能直接看、直接改、直接 git 管,调试时 tree 一下全明白。第三,后面的沙箱、远程存储、多副本,都可以用「文件系统语义」这一层抽象统一掉。当然代价也真实:没有事务,没有查询,并发要自己想办法——这些坑下面一个个看源码怎么填。
读写两条路:两层读、一层写
WorkspaceManager(agentscope-harness/.../workspace/WorkspaceManager.java,v2.0.4 共 1,026 行)是这棵树的看门人。它对自己的定位写在类注释第一行:stateless accessor——自己不存任何状态,只做转发和兜底。
读走两层(readWithOverride,L818-824):先问 filesystem 层(filesystem.read(rc, path, 0, 0)),有内容就用它的;没有再读本地磁盘兜底。「filesystem 层」就是构造时传入的 AbstractFilesystem 实现,可以是本地盘、可以是键值存储、可以是沙箱代理。写只走一层(writeUtf8WorkspaceRelative,L711-729):全部 filesystem.uploadFiles(...) 上去,只有没配 filesystem 时才退回本地盘。列目录是两边并集(listKnowledgeFiles,L296-334):filesystem 层 glob 一遍、本地 Files.walk 一遍,按相对路径去重。三条路画成一张图(每条箭头都能在源码指认):
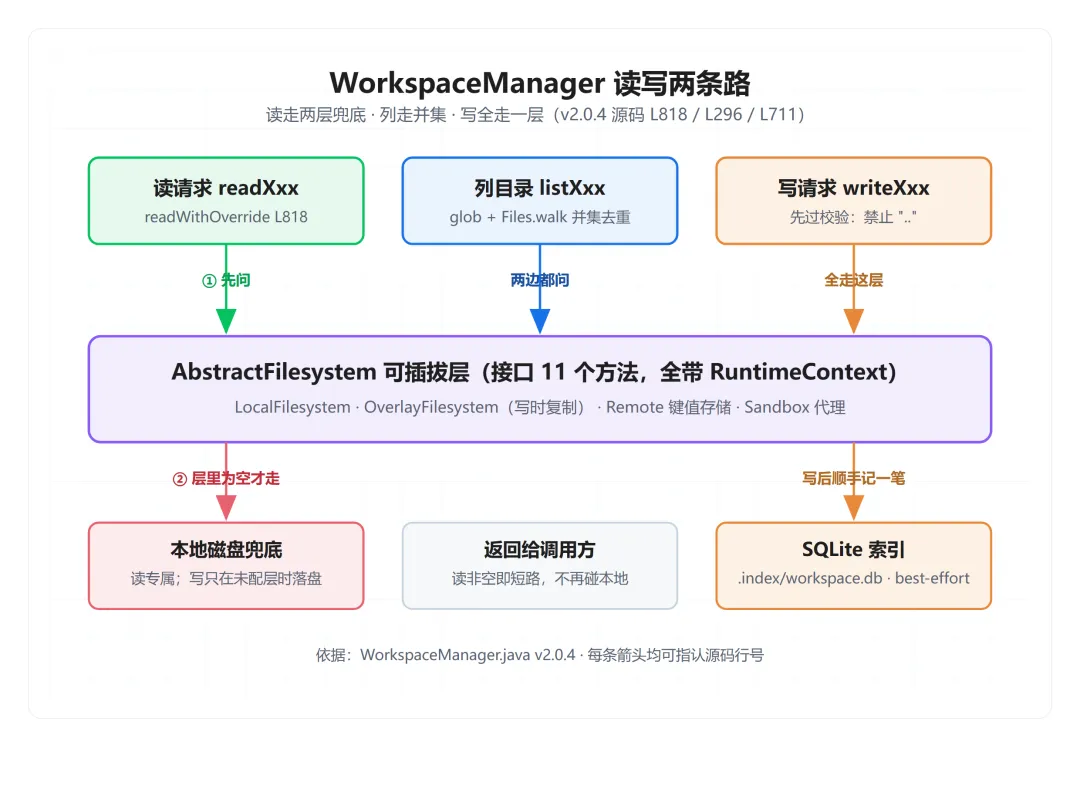
为什么读要两层、写要一层?这是个部署形态问题:单机跑的时候,历史遗留文件可能直接躺在本地盘上,而 filesystem 层(比如键值存储)里还没有这些文件——读必须兜底,不然升级即失忆。而新写的东西一律进 filesystem 层,保证多副本都能看到。读写不对称,是迁移期的现实妥协,不是洁癖。
顺带把 filesystem 层这个接口的 11 个操作列全(按需查阅,写自定义存储时回来对着实现):
每个操作的第一个参数都是 RuntimeContext——隔离作用域的钥匙就在这,实现方拿它做命名空间前缀,调用方不感知。
写本地盘有个细节值得看一眼(writeLocalFile,L882-913):先写同目录临时文件,再 ATOMIC_MOVE 换过去,不支持原子 rename 的文件系统就退回普通 move。并发读者永远看不到写了一半的 JSON。另外每次写完都会 index.upsert 一下——这个 index 马上讲。
记忆怎么「自己长大」
两层记忆模型,全在 agentscope-harness/.../memory/ 包里,两层都是文件:
第一层,流水账。MemoryFlushManager 负责往 memory/YYYY-MM-DD.md 里追加(L123 拼路径),append-only,每次上下文压缩(compaction)都把被压掉的内容写成一段存进去。它的提示词写得很直白(L81):"You are writing to TODAY'S daily memory ledger"——今天的事记今天的账,不回头改。
第二层,精编版。MemoryConsolidator 定期把「上次整理水位线之后改过的流水账 + 当前 MEMORY.md」喂给 LLM,让它合并、去重、修剪,然后整个覆盖写回 MEMORY.md。水位线是个隐藏状态文件 memory/.consolidation_state(STATE_FILE 常量),记着上次成功整理的时间点——早于它的流水账直接跳过,省 token,也防止旧内容反复重写精编版。
技能走的是同构的另一条路:Agent 干完活觉得这经验值得沉淀,就往 skills/_drafts/ 写草稿(writeDraftSkillFile,L764-784),审批通过后 moveSkill 把目录从 _drafts/ 挪到 skills/ 转正(L791-810)。第 1 篇说过,这条路默认全拒绝(RejectAllGate),人不动手它永远只是草稿。
所以「会进化的工作区」不是修辞:流水账每天在长,精编版定期被重写,技能区有草稿转正的通道——整棵树确实在生长和自我修剪,而且修剪员是 LLM 自己。
隔离的三道闸
Agent 要读写文件,安全边界就是问题。AgentScope Java 没把隔离押在「路径写对」这种约定上,而是三道闸叠着:
第一道,LocalFsMode 三档(41 行的枚举,一眼看完;按需查阅):
第二道,PathPolicy(126 行,不可变白名单):PathPolicy.of(project, workspace, additionalRoots) 建出来,isAllowed 做归一化后 startsWith 判断。PathPolicy.empty() 拒绝一切绝对路径——只留相对路径访问。
第三道,路径校验兜底:AbstractFilesystem.validatePath(L178-188)把路径按 / 切开,任何一段等于 .. 直接抛 IllegalArgumentException。所有经过 WorkspaceManager 的写操作前置都要过 requireSafeRelativePath。我在测试里故意试了一把穿越攻击,见下面的实测段。
多租户的隔离靠 NamespaceFactory:resolveRuntimeDataPath(L239-248)把 (userId, sessionId) 映射成路径前缀,每个用户/会话的数据各待各的子树里。沙箱侧还有 SandboxIsolationKey,四档作用域:SESSION、USER、AGENT、GLOBAL(userId 缺席时 USER 自动降级到 SESSION,GLOBAL 统一用 __global__ 占位)。
这一层的设计取向很清楚:默认收紧,逐级放宽。想要自由可以,但每一档都得显式选。
Overlay:个人定制不碰公共资产
OverlayFilesystem(302 行)解决一个具体矛盾:skills/、subagents/ 这类内容想全员共享一份,但每个用户又想有自己的微调。做法是经典的两层覆盖:
读:先上层后下层 写:永远写上层(写时复制) 删:只删上层,共享层文件删不掉 列目录:两边并集,路径冲突时上层优先
「删不到共享层」是这份语义表里最容易被误读的一条:个人定制不管怎么折腾,公共资产动不了——这是接口语义强制的,不靠使用方自觉。下面实测段有验证代码和输出。
SQLite 索引:为什么是 best-effort
远程存储(键值型)有个尴尬:ls/glob/exists 这类操作要全库扫 key。WorkspaceIndex(372 行)的解法是在本地放一个 SQLite 索引,位置 .index/workspace.db,只跟踪两个前缀:agents/ 和 memory/。表结构就一张(按需查阅):
这个类的所有方法注释里都有一句 (non-fatal):upsert 失败、删除失败、重建失败,全部只打 debug 日志,不向调用方抛。类注释把一致性模型说得明明白白:远程写入是权威,索引可以滞后,索引坏了不影响正确性只影响速度。文件内容永远不进索引,grep 还是老老实实从远端拉内容。
这种「能加速就加速、加不了就裸跑」的降级姿态,比把索引做成强一致组件省了太多麻烦。open() 失败直接返回 null,调用方拿到 null 就走远端扫描。
顺带一个 Windows 细节:WorkspaceManager.close() 的注释专门解释了为什么必须关索引——JDBC 驱动会握着 .index/workspace.db 的句柄,Windows 不允许删还开着句柄的文件,测试里用 @TempDir 就会被锁目录。我在本机实测时果然撞上了这个行为,一棵小树跑完 .index 里的 db 文件好好地躺在那。
分布式的诚实边界
单进程内,WorkspaceManager 用 pathLocks(ConcurrentHashMap,L120)给每个文件路径配一把锁,读-改-写的循环(比如 appendUtf8WorkspaceRelative 的读旧文-拼接-写回)在进程内是原子的。
但这个字段的注释是我读过最诚实的自我披露(L110-119):这锁只管本进程。跨副本时这些读写是 last-writer-wins,WorkspaceManager 不做服务端 CAS。真正的乐观并发在 BaseStore#putIfVersion 和 AgentStateStore#saveIfVersion 上,不在这把锁上。
把「我保证什么、我不保证什么」写进字段注释而不是文档,这种源码自带边界说明的习惯值得抄。
另一个跨环境细节:子 Agent 任务记录(agents/{id}/tasks/*.json)的维护线程跑在 Agent 调用之外,那时沙箱代理里没有活沙箱、任何操作都抛异常。taskRecordsRouteToLiveSandbox(L451-457)检测到这种情况就把任务记录 IO 路由回宿主机工作区——心跳和孤儿任务清扫不至于跟着沙箱一起死。配套的 listAllTaskRecords(L546-598)用「文件 mtime 超过窗口就跳过」的规则缩小扫描量:全部任务都到终态的文件永远不会再改,老文件不可能藏着孤儿任务。
v2.0.4 新增:sharedLocalWorkspace,一个承认现实的逃生舱
v2.0.4(10-08 发布)给 LocalFilesystemSpec 和 RemoteFilesystemSpec 都加了 sharedLocalWorkspace 开关。默认 false,保持按用户/会话加前缀的隔离行为;打开后,非路由路径直接落在共享根上,没有命名空间前缀。
为什么需要它?单机单租户嵌入场景:宿主应用用普通 java.nio 往 uploads/ 写了个文件,期望 Agent 用 read_file 能读到;Agent 写的文件,宿主应用也希望在「自己以为的位置」找到。两套代码对「文件在哪」的默认认知对不上,这个开关就是来对齐的。
javadoc 里那句警告值得原样引用:「Not safe for multi-tenant workspaces」——共享模式关掉的是工作区根上的按用户隔离,同一个工作区目录的多个用户会互相读到、覆盖掉对方的文件,只给单租户宿主应用用。把逃生舱的适用边界写在门口,这个习惯和 pathLocks 注释一脉相承。
同版本相关的还有 AgentRun / RunControl(每次运行的执行控制)和请求级工具配置隔离,这两个我本篇没展开,属于运行时话题,放在讲执行链的那篇更合适。
扩展指南
✅ 应该改(推荐路径)
实现自己的 AbstractFilesystem。11 个方法(ls/read/write/edit/grep/glob/uploadFiles/downloadFiles/delete/move/exists)全带 RuntimeContext,接个自建存储一天能搞定。Builder 上有现成入口 abstractFilesystem(store)(L1827),或者用 filesystemRoute(prefix, fs)(L1862)把它挂到某个路径前缀下——比如把 memory-stores/notes/ 挂到专门的笔记库,主文件系统不受影响。
✅ 应该改(推荐路径)
换记忆整理的行为。MemoryConsolidator.DEFAULT_CONSOLIDATION_PROMPT 是 public 的,官方就是让你在项目里追加自己的整理规则(比如「技术决策单独成节」)。
⚠️ 不应该改(有更优替代)
绕过 WorkspaceManager 直接写工作区文件。PlanModeManager 类注释专门强调了这条纪律:计划文件只通过 WorkspaceManager 写,从不直接用 java.nio.file.Files——这样它才能落到任何配置的后端上。你自己写组件时同理,绕过这层等于把「存储可插拔」废了。
⚠️ 不应该改(有更优替代)
动 INDEXED_PREFIXES 想让索引多管点事。索引是 best-effort 的,把业务正确性押上去,总有一天索引和远端不一致时你会 debug 到怀疑人生。
🚫 千万不要改(动了会破坏不变量)
validatePath 对 .. 的拒绝逻辑。它是所有路径安全的地基,放宽等于把「Agent 可以写宿主机任意文件」的口子撕开。需要访问工作区外的文件,走 PathPolicy 显式加白名单,别动这道闸。
🚫 千万不要改(动了会破坏不变量)
不要在多租户配置里开 sharedLocalWorkspace。javadoc 原话「Not safe for multi-tenant」,这条红线的后果是用户间数据互踩。
调试断点与阅读顺序
断点 1:WorkspaceManager.readWithOverride(L818)。看一个读请求先打到哪里、兜底有没有触发——理解两层读最快的方式是亲眼看一次分叉。
断点 2:MemoryConsolidator 的整理调用点(配合 memory/.consolidation_state 的内容)。观察 LLM 拿到哪些流水账、产出什么样的 MEMORY.md。
断点 3:OverlayFilesystem.write。打断点后看写请求是不是只落到 upper,然后去磁盘确认下层文件没动。
阅读顺序建议:WorkspaceConstants(49 行,先记住地图)→ WorkspaceManager 类注释和 readWithOverride/writeLocalFile → LocalFsMode + PathPolicy → OverlayFilesystem → WorkspaceIndex → 有余力再看 MemoryFlushManager/MemoryConsolidator。WorkspacePathNormalizer 和 PlanModeManager 可以最后看,都是小而清晰的收尾。
实测:JUnit 里把两个行为跑给人看
读源码之外,我在 v2.0.4 tag 的 tarball 里写了个动手测试(WorkspaceHandsOnTest,两个用例),JDK 21.0.9 + Maven 3.9.16,Windows 上跑的。构建过程本身先给了我一个教训:本机 java -version 是 1.8.0_202,切到 D:\6-env\jdk-21.0.9 后 Maven 连续卡死——jstack 一看,卡在 SocksSocketImpl.connect;再查,Windows 系统代理指向 127.0.0.1:7897,这个端口只讲 HTTP 不讲 SOCKS,Maven 的 JVM 挑了系统代理却按 SOCKS 去握手,永远握不上。MAVEN_OPTS=-Djava.net.useSystemProxies=false 绕开才通。如果你本机也挂着本地代理客户端跑 Java 构建,这个坑大概率会遇上。跑测试还踩了两个小坑:仓库 POM 里写死了一个内网 nexus(10.0.202.35,现在不可达),每个构件都先撞内网再超时回退,最后用临时 settings 把所有请求镜像到阿里云才跑顺;提交测试前还得过 spotless 格式检查(mvn spotless:apply 一把梭)。
第一个用例走工作区生命周期(写、追加、读回、索引生成、穿越攻击、关句柄),原始输出如下——SLF4J(W) 那三行警告是真实毛边:测试环境没绑日志实现,validate() 的 warning 就被 NOP 实现吞了,也从侧面说明这个类对日志零依赖:
两个用例都不需要 API key——纯文件操作,这正是「记忆即文件」的好处之一:核心机制可以离线验证。几处值得对着上文核对:写完 memory 文件后 .index/workspace.db 自动出现、索引立刻可见(best-effort 索引);穿越攻击被 validatePath 一行拦死(开头那行输出就是这里打的);目录树里只有 .index 和 memory——树是从零长出来的。
第二个用例验证 Overlay 写时复制(两层都是真实 LocalFilesystem,下层放了共享技能文件):
注意最后三行的组合:对共享层文件 delete 返回的是成功,但紧接着读,文件又「复活」了——因为删的只是上层那份副本,下层原件从头到尾没动过。「删不掉共享资产」不是报错拒绝,而是删了等于没删,这个语义比抛异常更微妙,也更容易让人误判,用的时候要心里有数。
这套设计最值得抄的三件事
存储全外包给一个接口。WorkspaceManager 一千行,自己不存一个字节,「在哪存」整个是 AbstractFilesystem 的多态。结果是 Local、Overlay、Remote、Sandbox 四种形态共存,业务代码一行不改。做基础设施的同学应该都有体感:能把「换存储」做成加一行配置的,都是把状态和行为剥得足够干净的。
降级设计做得坦荡。SQLite 索引坏了我裸跑、锁只保进程内、沙箱死了任务记录回宿主机——每个组件的失效路径都是设计的一部分,而且全写在注释里。对比那种「出了问题才知道边界在哪」的系统,这种把不保证的事先说清楚的源码,维护成本完全是两个量级。
让 LLM 干体力活,但不给它破坏权。整理 MEMORY.md 的是模型,转正技能的闸门是人(RejectAllGate),写共享层的是写时复制——模型可以整理世界,但不能改写公共资产、不能越过审批。这个分寸感是整套设计里我觉得最值得揣摩的。
不过有一个疑虑我得说出来:MemoryConsolidator 让 LLM 重写 MEMORY.md,源码里的水位线只防「重复整理」,没看到对整理内容正确性的防线——模型哪天合并时幻觉一条错结论进精编版,这棵树没有任何机制能发现,而 MEMORY.md 是每轮注入 system prompt 的。生产上开这个功能之前,这个风险要想清楚。我不同意「LLM 整理天然危险所以不该用」的说法——流水账人类的替代方案是不整理,更糟——但「幻觉永久化」这个问题,目前是使用方自己扛。
读完后你应该能回答的
为什么一棵文件树能当 Agent 的长期状态?因为它同时是存储、是提示词材料、是 Agent 自己的工具能操作的对象。为什么读写不对称?迁移期兼容,读必须兜底本地盘。隔离靠什么?三道闸加命名空间,默认收紧。要改自己的存储怎么办?实现 AbstractFilesystem,别绕过 WorkspaceManager。
带走一句话就够了:把状态交给文件树,把存储交给接口,把整理交给模型,把闸门留给人。
1. 低门槛:你自己的 Agent 项目(或者用 Claude Code / Codex 这类工具时),记忆和上下文现在存在哪?数据库、文件、还是干脆不存每次重来?
2. 进阶:让 LLM 定期重写长期记忆文件,你敢在生产上开吗?如果开,你会加什么防线?
追更:系列持续更新,关注后不错过下一篇(Skill 自学习闭环 或 sandbox 执行后端,看留言)。
裂变:转发到 Java 后端 / Agent 开发的技术群,帮同样在选型的朋友省一次源码考古。