ARTICLE · 1206252
AI 评测体系建设(二十):LLM-as-Judge 与框架设计
AI 评测体系建设(二十):LLM-as-Judge 与框架设计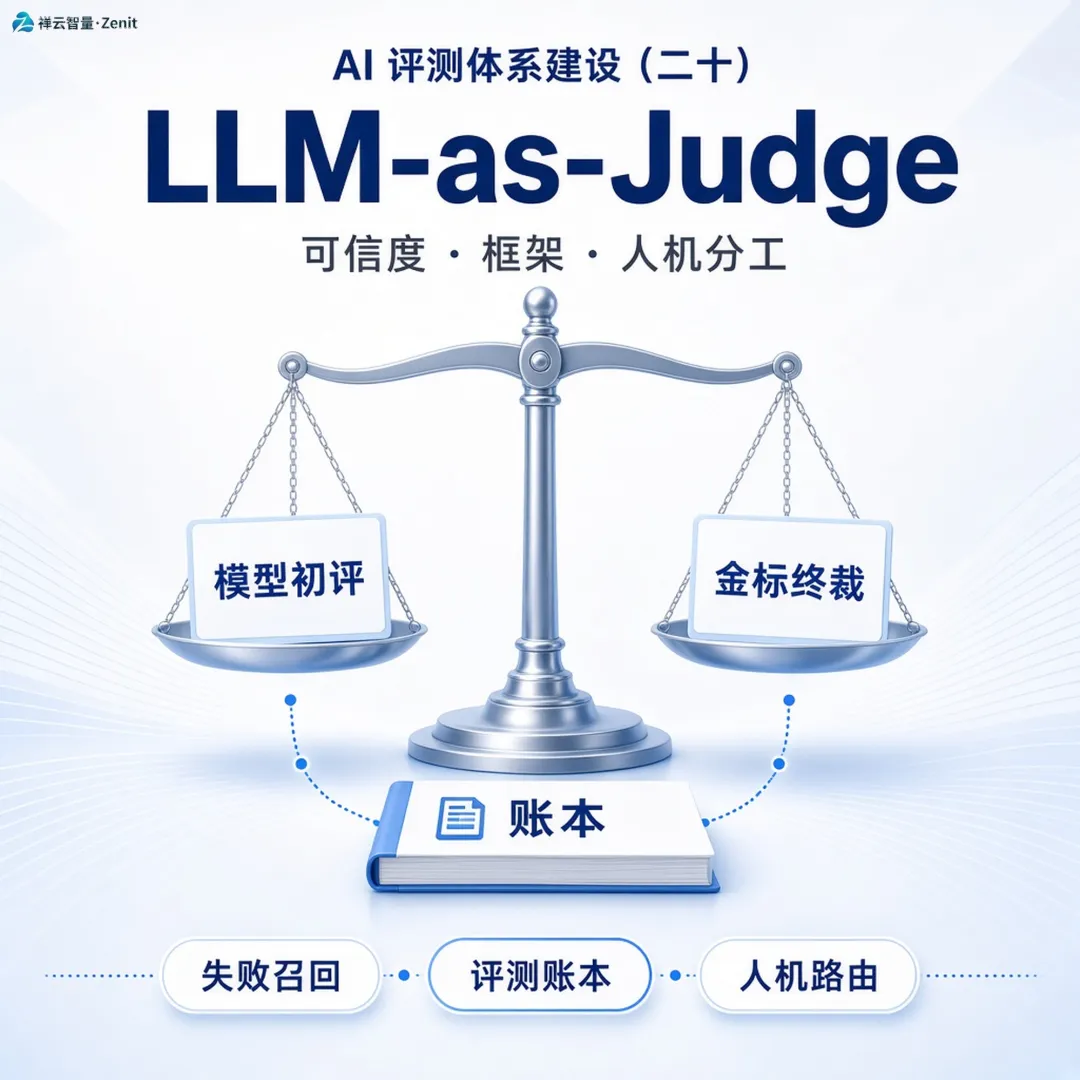
摘要:自动评测能不能进门禁,不看框架名字,看金标回放能不能在失败切片上站得住。编排工具只负责调度和 traces;量规、校准集和分歧路由要自己记账。人处理高后果、弃权和分歧;成本对照人工小时与漏报,不对照平均 token 单价。
上一篇解决的是「按什么打、数据从哪来、人看哪一层」。现场接着会碰到另一类故障:周报上人机一致率 90%,高后果切片一抽,漏报仍然高;或者团队选了一个带 Evaluator 的框架,默认 1–10 分直接进了发布门槛。 这两种故障同源:把自动评测的平均表现当成可发布证据。一致率会被类别不平衡抬高——大多数样本本来就该过,模型和人都会打「通过」,数字很好看。真正要问的是:在金标判定为失败、且属于高后果或稀疏切片的那些条上,Judge 漏了多少。 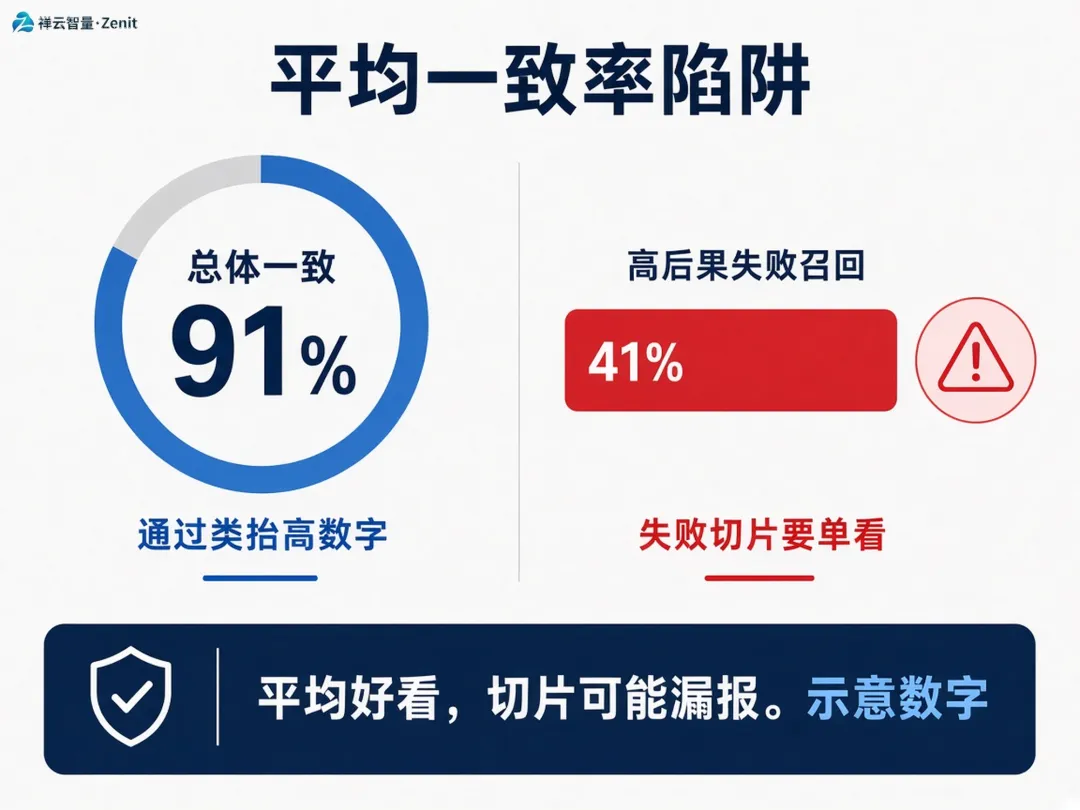
因此「用 AI 辅助评测和标注」的第一约束是:Judge 的输出是初评,进门禁之前必须能被金标和规则质疑。框架可以加快调度,不能代替这道质疑。
自动评测能不能信,用校准集回放,不靠演示。校准集沿用上一篇的量级即可:一个任务 80–150 条金标,必须覆盖至少一两个稀疏切片,不能全是「标准表达的通过样本」。 回放时至少拆开四张表,不要合成一个「Judge 准确率」:
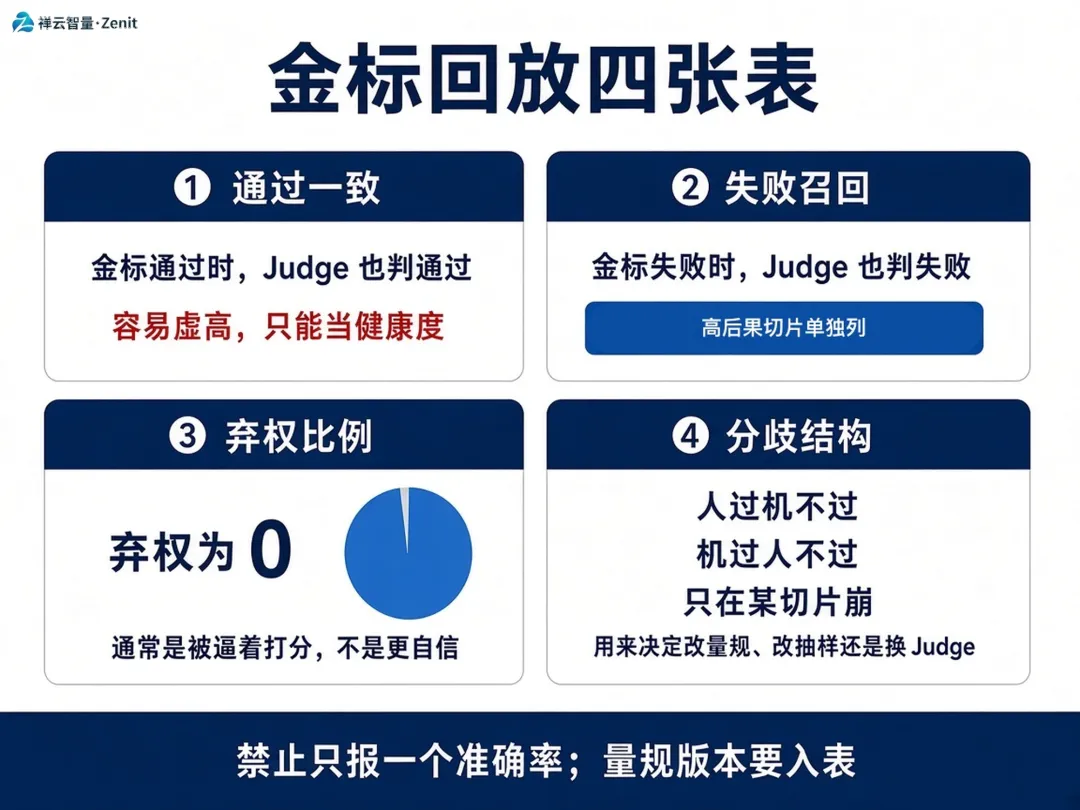
还要专门查几类系统性偏差,否则回放数字会被「看起来更像好答案」的表面特征带跑: 人机一致率写成「≥85%」只适合作为某一任务、某一量规版本的观察位,不是跨产品线的合格证。类别极不平衡时,即使一致率 90%,失败召回仍可能低于 60%。门禁应绑失败召回和切片表现,不绑总一致率。 校验要版本化:量规变了、Judge 模型变了、提示词变了,旧的一致率作废,必须重跑校准集。结果表至少留下 rubric_version、judge_model、judge_prompt_hash、gold_set_id。缺这四列,下周无法解释分数为什么跳。
混合评估不是「模型和人各打一半」。人的时间应用在机器最可能错、错了最贵的地方。 一条样本的路由可以写成规则,不必先上复杂工作流: 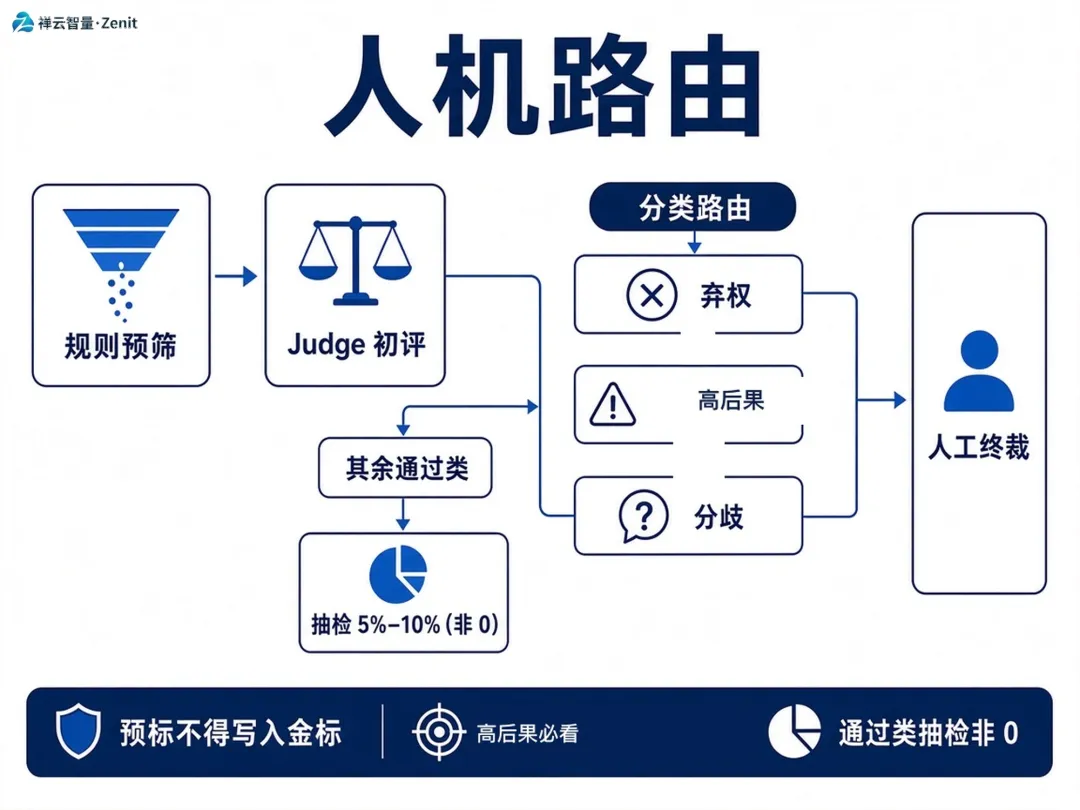
标注场景同样适用。用模型预标意图、槽位或错误类型,可以加快吞吐;但预标结果要带 prelabel_source=model 和置信度,终标仍是人。不允许把预标直接写进金标表。金标被模型污染后,下一轮回放会变成「模型同意自己」。 有两处不能自动化顶替: 「过度依赖自动评测」的典型样子是:抽检比例降到接近 0,弃权被关掉,高后果与普通问答共用一个通过阈值。这时一致率往往还在涨,因为抽检已经抽不到失败类。
规划里要对比 LangChain、Dify 这类名字,现场容易做成功能清单比赛。清单会过期,工程上只需要问:评测账本放在哪。账本指量规版本、金标、切片、Judge 结果、人工终裁、成本,并且能按 trace_id 回放。 按这个定义,常见选项不是「谁更智能」,而是职责切分:
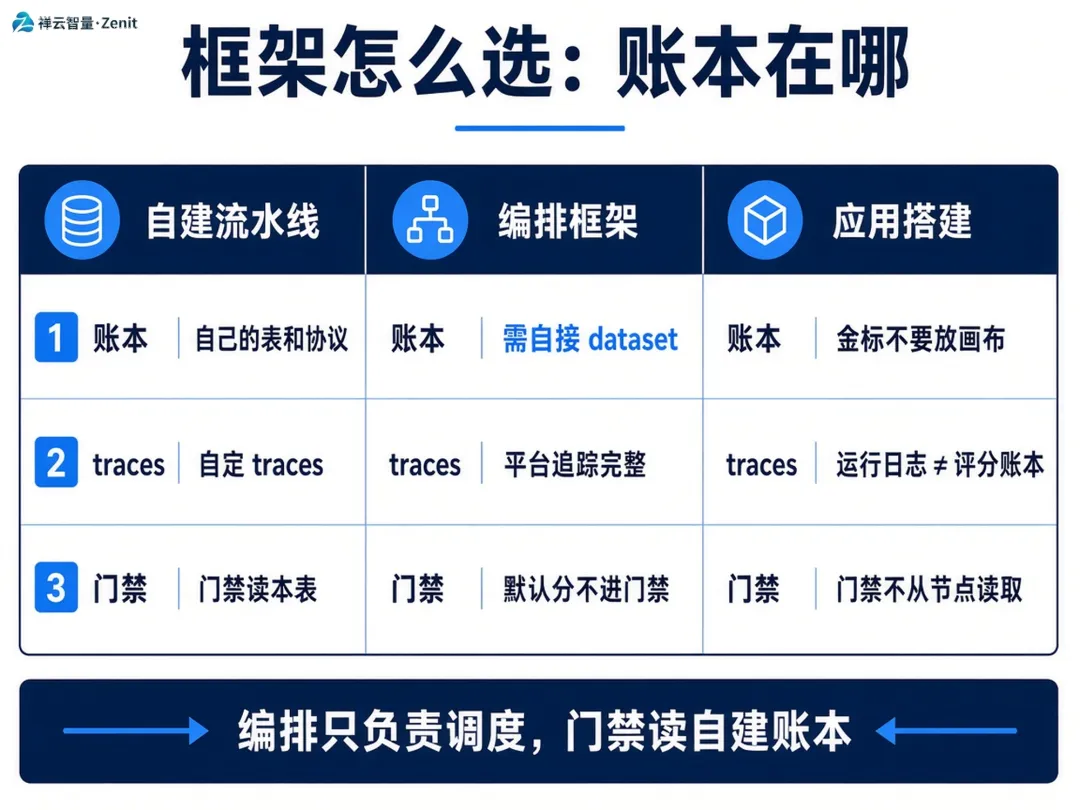
选错框架的常见原因是把「能跑起来一条评测链」当成「评测系统」。LangChain 一类适合把检索、生成、评测步骤串起来,并接到追踪;Dify 一类适合给业务同学搭可演示的工作流。它们都不自动给你:失败召回、切片配额、量规变更后的回归、以及「这条分能不能进门禁」。这些留在你自己的表里,框架只是生产者。 因此选择可以很具体: 框架对比如果只停留在「谁支持 LLM-as-Judge」,结论一定虚。几乎都「支持」。差别是:默认输出是不是综合印象分、能不能强制证据字段、能不能把一次评测写成带版本的数据集。后三项没有,框架只是更快地生产不可审计的分数。
自动评测的账不能写成「每条 0.0x 元,所以全面替代人工」。漏掉一条高后果失败,成本不在 token 账单上。建议至少记四笔:
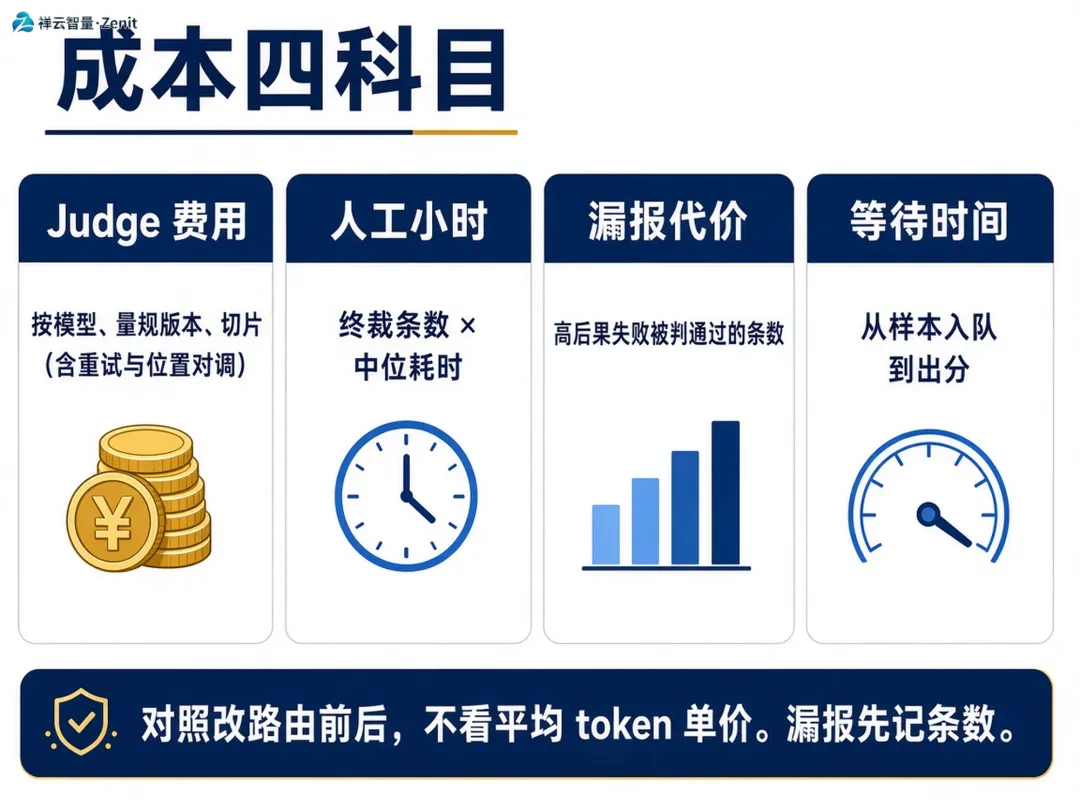
ROI 只在对照里有意义。例如:同一周、同一任务,全人工终裁 18 小时,改为「Judge 初评 + 高后果必看 + 通过类 8% 抽检」后人工 7 小时,失败召回不下降,这才叫省到了人。如果人工降到 2 小时、失败召回从 80% 掉到 50%,省的是审计,不是评测。 省钱的杠杆仍是上一篇的分层和缓存,只是要写清条件: 不要把「多模型投票」当默认架构。它把费用乘以模型数,却不自动提高失败召回;投票还可能把弃权投没。先把单 Judge 的失败召回和切片做稳,再决定要不要第二路。
团队用编排框架自带的打分器,对「有用性」打 1–10 分,取 ≥7 为通过。全量人机一致率 91%。准备把人工从全量改为 2% 抽检。抽检方案上会前,按切片拆了金标回放:
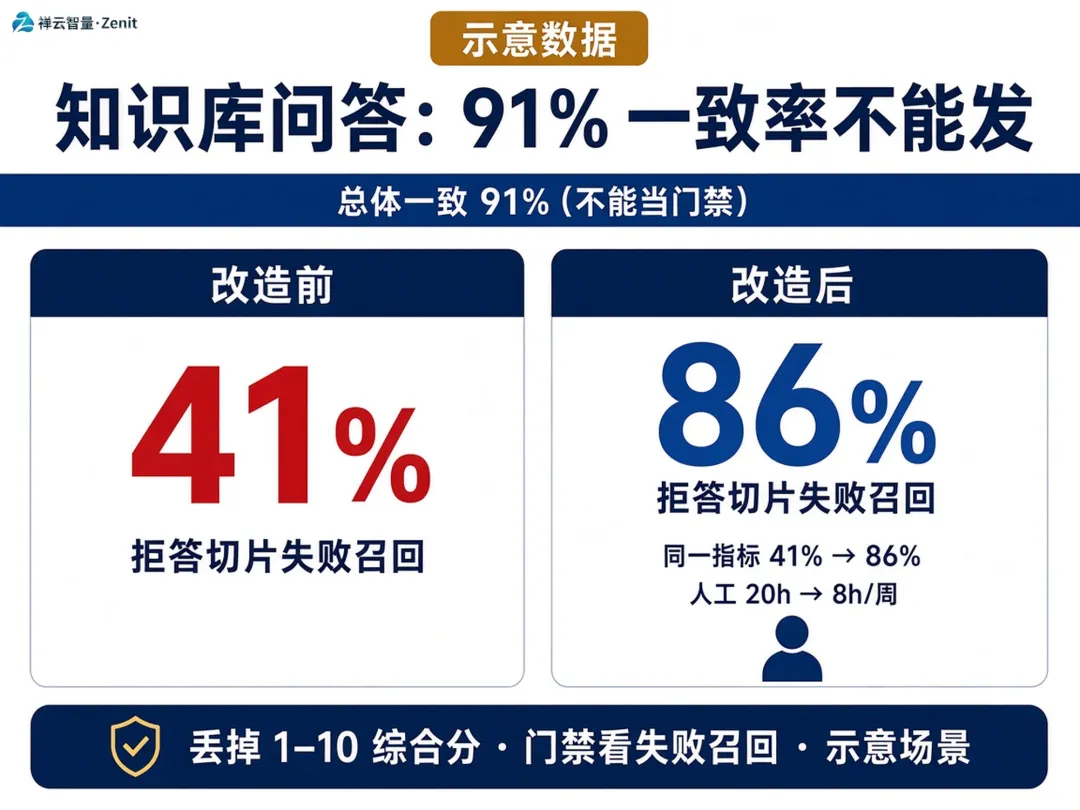
改造没有换框架品牌,改的是账本和路由: 四周后的示意对照:拒答切片失败召回 41%→86%;人工从约 20 小时/周降到约 8 小时/周(必看 + 抽检 + 校准);Judge 费用明显高于「只用规则」,但低于全量强模型加全量人工。应用搭建工具仍用来给业务改提示词做演示,发布门禁不从画布节点读取。
两个规划里点名的坑,现场长这样: 起步不要并行上三个框架。先固定一个任务: 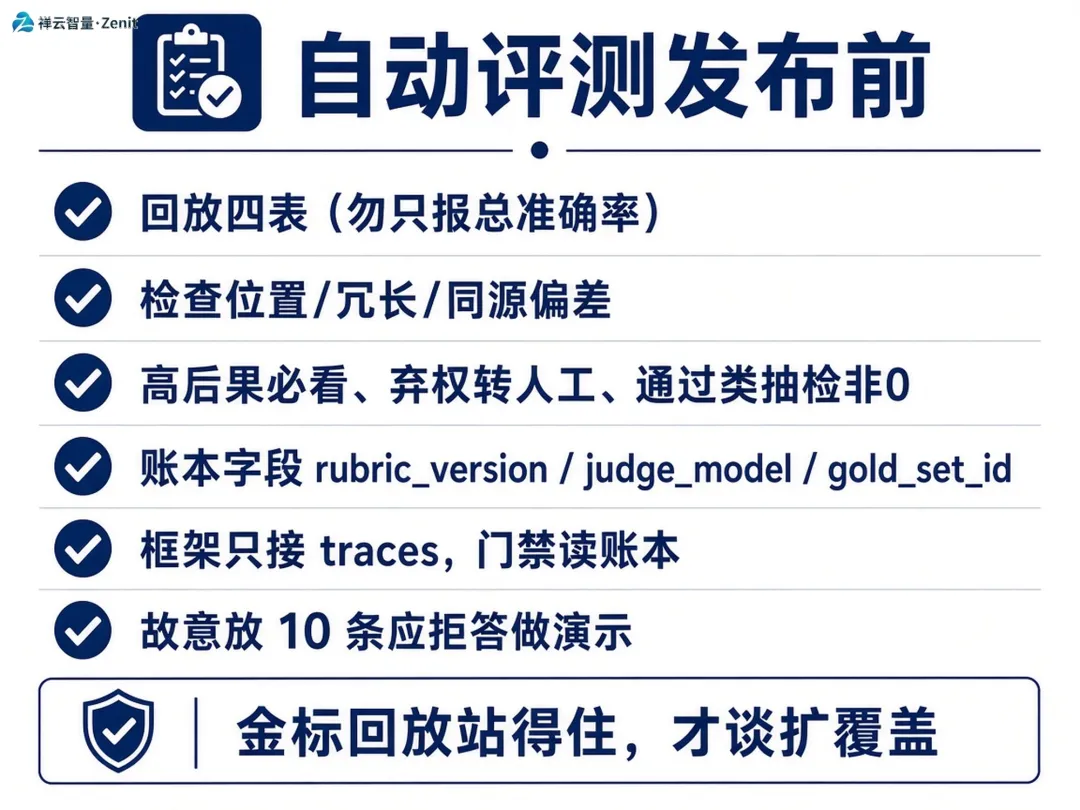
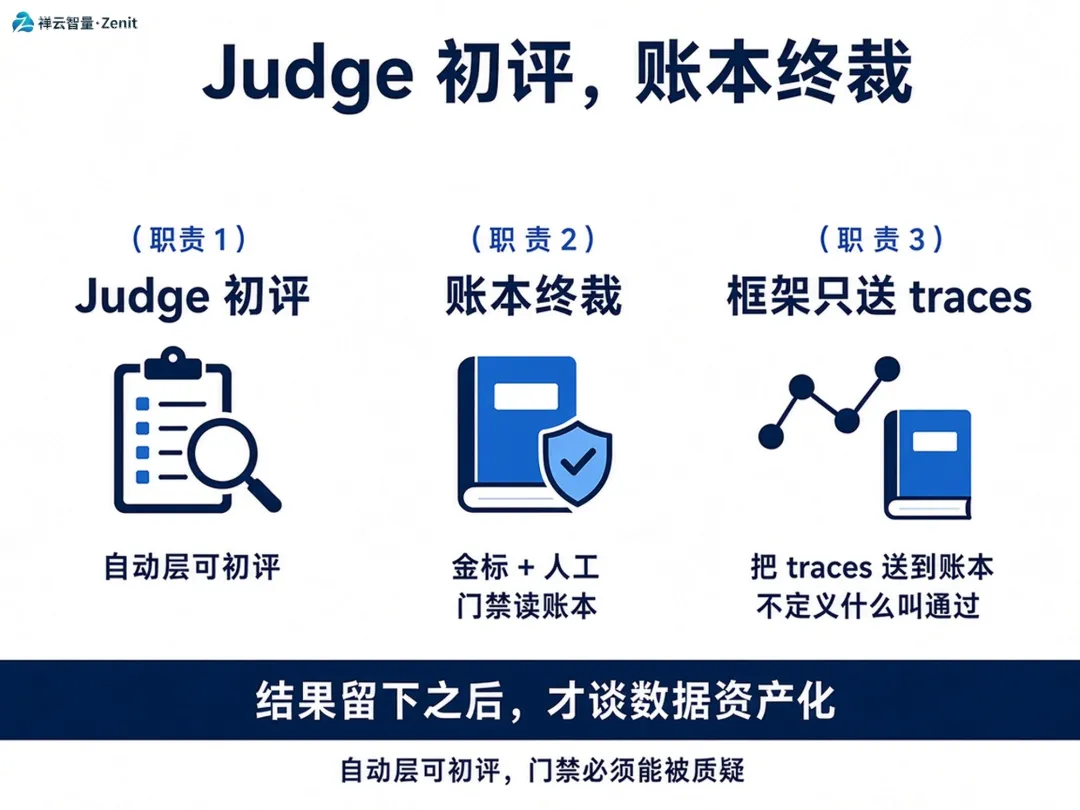
账本稳定之后,下一期才处理这些结果和 traces 如何资产化:日志怎么存、向量库用来检索失败模式而不是堆原文、评测数据怎样复用到下一轮回归。那是数据工程问题。若本周还在用综合印象分和总一致率发版,先不要上向量库。
用 AI 辅助评测和标注,可靠的部分是:把 Judge 当成可回放的初评器,用金标和切片质疑它;人看高后果、弃权和分歧;框架用来调度和接 traces,不用来定义「什么叫通过」。成本账对照的是人工小时和漏报,不是平均 token 单价。 自动评测可以扩大覆盖,不能单凭平均一致率取消校准。框架可以缩短接线时间,不能把评测账本外包给默认 Evaluator。 下一篇进入评测数据资产化——日志、向量库与复用:当每次 Judge 与人工终裁都留下带版本的结果,这些记录怎样索引、检索和复用,才不会变成又一套无主日志。
这一篇的核心问题:怎样用 AI 辅助评测和标注?量规协议立住之后,自动打分何时可以进门禁,自建流水线与现成框架各自承担什么,人机之间怎样分工,才不会把自动化做成另一只黑盒。
上一篇把 Judge 收成量规执行器,把合成数据和分层调度写成可版本化协议,并明确下一期再谈可信度与框架。本期不再重复提示词六段怎么写,只处理四件事:自动评测能不能信、框架选什么、人机怎么混、账怎么算。
一、协议立住之后,Judge 仍可能不可用
二、可信度校验:先回放金标,再看偏差,不要只报一个百分比
位置偏差。成对比较时,把 A/B 对调再打一次,结论翻转超过约定阈值,这个 Judge 不能直接用于排序。 冗长偏差。同样错误,更长的回复更容易拿高分。校准集里要有「短而正确」对「长而空」的对照。 同源偏好。用同一模型族既生成又裁判,分数会偏向自己的口吻。至少用另一路模型或人工对失败类做抽检。 量规外打分。输出里没有证据摘录却给了最高档,这条结果作废,不计一致率分子。
三、人机混合:默认 Judge 初评,人看三类样本
规则预筛不通过 → 直接失败或回修,不进 JudgeJudge 弃权 → 人工高后果任务 → Judge 初评 + 人工必看与金标或上一版 Judge 不一致 → 人工低置信 / 分数贴阈值 → 人工其余通过类 → 按比例抽检(例如 5%–10%),不是 0
量规争议。两条金标意见不合,先改量规或加例子,不要加一个更强的 Judge 来投票。 不可逆后果。医疗、资金、合规拒答,Judge 可以初评,发布门禁的失败类必须能指到人工或规则。
四、框架选择:先问账本在哪,再问用哪家编排
评测对象已经是稳定 HTTP 服务、你们有数仓和任务队列 → 自建账本 + 薄封装调用 Judge,不必为了评测再引入一层编排。 对象是多步 Agent、工具调用要和 traces 对齐 → 用编排框架拿 traces,账本仍自建,Evaluator 默认分不要进门禁。 业务要自己改提示词做试点 → 应用搭建可以当演示台;金标和发布门禁不要放在画布节点上。
五、成本与 ROI:分母是失败和人工小时,不是平均 token
规则能判的不要进 Judge(格式、违禁、空回复); 同一 (input_hash, rubric_version, judge_model) 命中缓存,不重复花 token; 位置对调、多模型投票只用于校准周和高分歧,不用于全量。
六、示意案例:知识库问答的「91% 一致率」为什么不能发
以下为示意工程场景,数字不可当实测引用。样本口径:某内部知识库问答,四周评测窗口,金标 120 条(含拒答与过期文档切片 40 条),线上抽样 800 条。
丢掉 1–10 综合分,改成上一篇的分项量规:支持证据、拒答是否该发生、过期引用,每项有限等级 + 原文摘录; 金标 120 条按切片回放,门禁看拒答切片失败召回,不看总一致率; 高后果(拒答、涉及权限)Judge 初评后人工必看;普通通过类抽检 10%; 编排框架只负责把问答 traces 送进评测任务;分数写入自建结果表,带量规和模型版本。
七、误区、清单与起步
过度依赖自动评测。关掉弃权、抽检趋近于 0、高后果与普通样本同一阈值,只盯总一致率。 框架选择不合理。因为 Evaluator 能出分就进门禁;或者因为工作流好画,就把金标放进节点,量规一改无法回归。
[ ] 校准集 80–150 条,至少含一个失败切片[ ] 回放输出四张表:通过一致、失败召回、弃权、分歧;禁止只报总准确率[ ] 查位置偏差、冗长偏差、同源偏好中至少两项[ ] 路由落地:高后果必看、弃权转人工、通过类抽检非 0[ ] 结果表有 rubric_version / judge_model / gold_set_id[ ] 框架只接 traces 与调度;门禁读自建账本[ ] 成本记 Judge + 人工小时 + 漏报条数,对照改路由前后[ ] 演示:故意放 10 条应拒答,看有几条被判通过