ARTICLE · 1222141
一个新实验还没做,AI 就学会用一句话来指挥细胞
AI for Science · arxiv论文解读
arXiv:2610.02247 · 2026年9月30日 · 佛蒙特大学 / 塔夫茨大学 Allen Discovery Center
核心发现
作者把实验室里早就录好的 149 段刺激录像当成一个固定数据库,没有补做一只新的胚胎。他们让一个视觉语言模型当裁判,看录像像不像那句话描述的样子,再把裁判打的分当奖励。最后训出来的小网络只有 2.7 万个参数:输入一句话,输出电刺激该打几秒。在既没见过的新句子、也没见过的录像上,命中率 80%,随机基线是 66.7%。
一个新实验没做。
也没有碰一只新的青蛙胚胎。
就靠一个录完放着的旧录像库,AI 把"让它慢一点""让它停下来"这类没人说过的话,翻译成了电刺激该打多少秒。
换成它完全没见过的新说法,命中 80%。瞎猜是 66.7%。
一、我们跟细胞说话,一直用的是旋钮
跟软件说话,可以说"给我一个排序函数"。跟分子生成模型说话,可以说"亲水性再高一点"。这些话,机器都能接住。
跟细胞说话不行。真正的接口是一排旋钮:电压多少伏,刺激几秒,什么时候打,从哪一侧打。
旋钮只能靠试。每试一次,就是一次湿实验。想教会模型"这句话对应哪组参数",就得给每一句话配一次实验,这个成本没人扛得住。
麻烦还有第二层。细胞不是砖头。Michael Levin 这一条线上的研究,核心结论是细胞膜电位参与了组织"决定自己长成什么形状"这件事。
也就是说,活的东西本来就有自己的意图。想让它按你的意图动,得在它的电学语言里插话。
这篇论文挑的实验对象,是把这件事推到最干净的一个模型:xenobot。
二、非洲爪蟾细胞拼的机器,只有"电多久"能调
xenobot 是非洲爪蟾胚胎细胞拼出来的多细胞构造,几百微米,没有神经系统。这个团队 2021 年就让它自己游动了。
选它有一个很实用的好处:干预手段被压缩成一个数。给一团电场,唯一调的参数是持续时间 d。
一句话进来,出去的就是一个秒数。
数据是老账。149 段录像,每段是单独一个构造,受一次刺激,前后各录一段轨迹。构造不重复使用,所以这 149 段算真正的生物学重复,不是同一只反复测。
从视频里抠轨迹比听起来难。刺激会在培养皿里冒气泡,还有反光和杂质,朴素的亮度追踪会把气泡当成机器人。
作者用 SAM 分三套策略逐帧定位:重新检测、光流引导、网格提示,再拿培养皿几何和构造外观交叉排除假阳性。三套都失败的帧直接标记为缺失,不当成"没动"。
清洗完剩下 101 段可用:26 段加速,75 段减速。另外 48 段被判不可靠,直接扔掉,没有硬塞进分类。
指令写了 33 句。于是有了一张 101 × 33 的打分表,一共 3333 个"录像 × 句子"组合。整篇论文的训练,都在这张表上做。
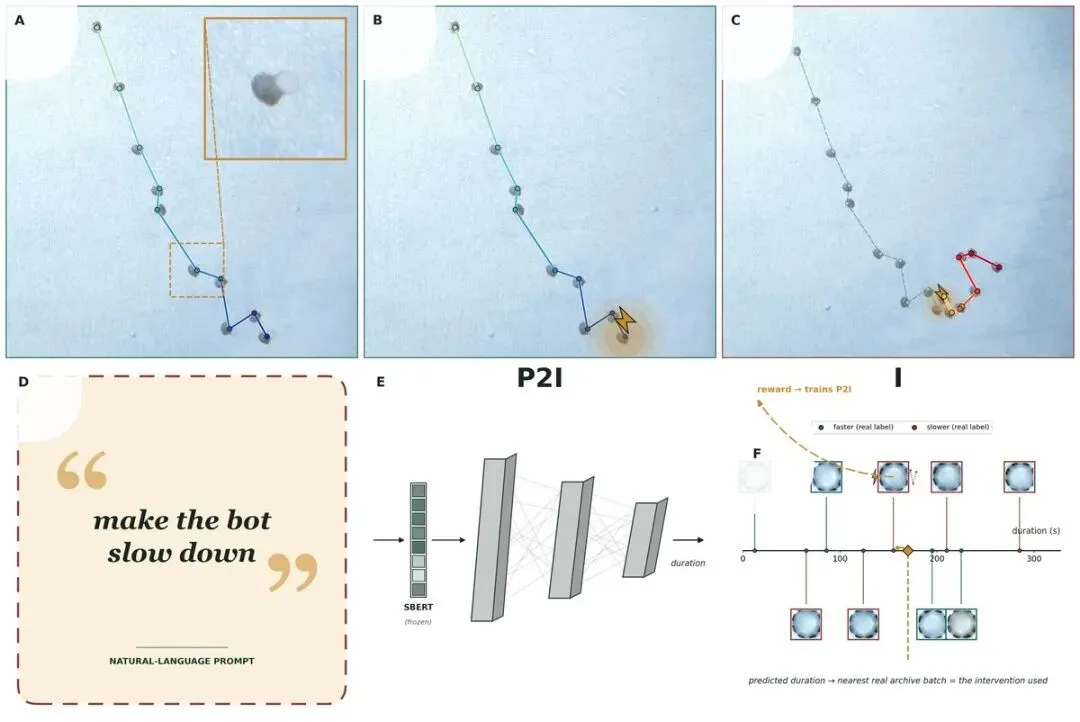
图1|(a)-(c) 同一个 xenobot 在刺激前、刺激瞬间、刺激后的真实轨迹,虚线处是通电那一刻;(d) 一句自然语言指令;(e) 一个冻结的句向量接两层小网络,输出一个时长;(f) 这个时长去库里找最近的真实录像,裁判看录像像不像这句话,分数回传训练。整条链路里,只有一个变量在动,就是时长。
三、裁判自己错了怎么办
这里有一个绕不开的窟窿。没有人手工标注过"这句话该配几秒",训练哪来的对错?
作者的办法是让大模型当裁判。给它一句指令和一段轨迹图,让它打一个 0 到 1 的分。注意,它看不到时长,只能从轨迹里自己猜快慢。
这一步最容易被质疑:裁判错得离谱,整个训练就是错的。
作者没有绕。他们拿裁判的分,去对独立追踪出来的真实行为标签:相关系数 0.843,正负号一致率 97%。三处不一致的录像,速度变化都在 ±0.02 像素/秒以内,本身就是模糊地带。
还有一个我很喜欢的对照。作者试过把预先算好的速度曲线图喂给裁判,让它对着图打分。相关系数掉到 0.49,两类的区间也只有 0.49 到 0.66。
把答案抽掉,逼它从原始轨迹里推,它反而更准。这个结果反过来解释了为什么"看图说话"的模型经常不可靠。
打分表拿到手,怎么变成训练信号,有两条路走。一条是把预测的时长吸到最近的真实录像上,直接读那一段的分。这个 argmin 不可导,只能用强化学习或者进化策略。
另一条路更省事:对每句指令,把 101 个点拟合成一条 logistic 曲线,取曲线中点当目标时长,剩下的就是普通的均方误差,直接反向传播。
两条路作者都跑了,还加了第三种做交叉验证。同一张表,三种优化器,最后谁高谁低,见下一节。
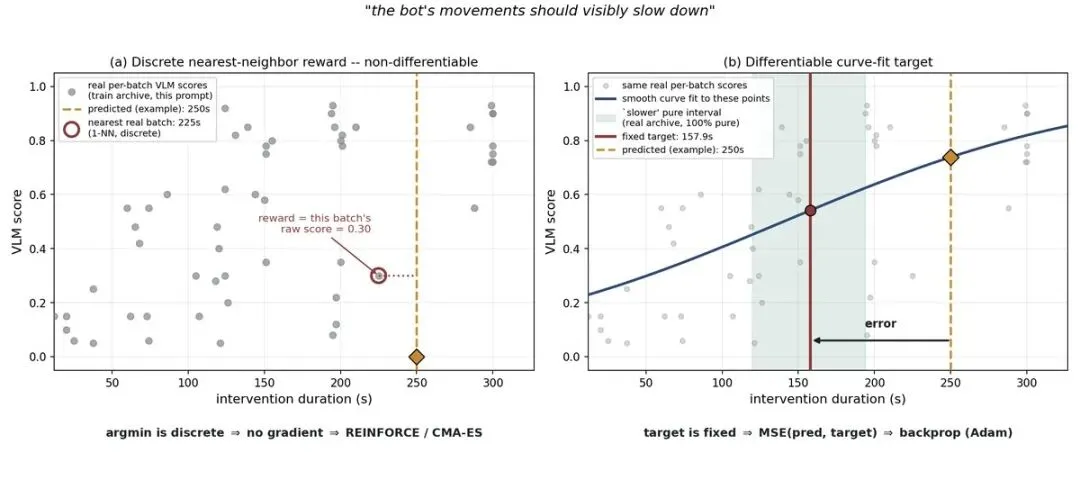
图2|同一句指令的两种用法。(a) 离散路线:预测时长吸到最近的真实录像,读它的原始分数,所以要走强化学习;(b) 可微路线:把同样这些真实点拟合成一条曲线,压成一个固定目标,用均方误差反传。两种办法的输入数据完全相同,差别只在怎么把离散的点变成梯度。
四、80% 是怎么算出来的,59.1% 又是怎么掉的
评测分四个格子,交叉两条轴:句子见没见过,录像见没见过。
最狠的格子是两条轴都换:用训练里的句子去考没见过的录像,再拿没见过的说法去考没见过的录像。
按最简单的多数类猜,基线是 66.7%,因为减速样本占七成多。
| 80.0% | ||||
表|30 个随机种子的平均。前一行是本文的参考模型,后两行是同一张打分表上的另外两种优化器。
梯度法全格领先两个无梯度方法十几个点。原因不难想:打分曲线能被拟合,能反传,就不用靠撒点碰运气。
这一条本身就有意思。前面同一批人的工作里,这个奖励一直被当成不可微的,只能上进化策略。今天改成可微,成绩就上来了。
还有个压力测试。拿训练好的模型,不重训,喂 120 条新写的同义说法,8 倍量地考。准确率 85%,和原来的 80% 差不多。
我认为全文最值钱的是下面这组对照。
作者把奖励换成一个纯数字目标:不用裁判,直接在训练集里挑速度变化最大的那段录像,把它的时长定死。加速的话全用同一个秒数,减速的话全用另一个。
训练集准确率 88.9%,几乎一样。最狠的格子掉到 59.1%,比瞎猜还低。
原因很具体。那个被挑中的加速时长,正好落在没见过的录像里"减速样本密集"的区间,于是所有没见过的加速指令都被判成了减速。
训练曲线一样漂亮,泛化差 21 个点。只看训练集的准确率,你根本发现不了这件事。
分类粒度上作者也很坦白。想要三分类(加速、轻微减速、停下),平衡准确率只有 0.477,基本等于没学会;合并成两类才 0.713。
不是模型不行。真正"轻微减速"的样本只有 14 条,数据撑不起第三类。
所以只测两类时,"停下"这类指令很稳,97.8% 落在真实的完全停止上;说"慢一点"有 33.3% 会被预测成完全停止,冲过头了。
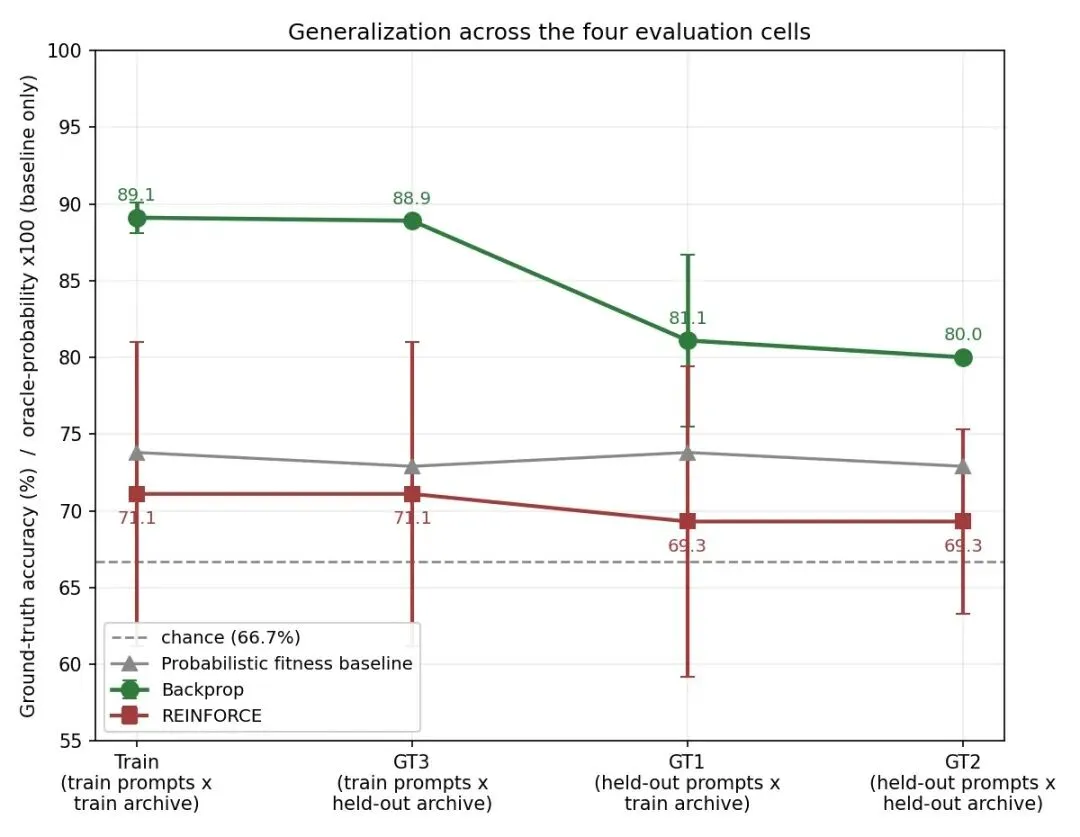
图3|四个格子横着看是换录像,竖着看是换句子。反向传播在每一格都留着对随机基线的最大余量,全换那一格仍有 13.3 个百分点。旁边几根浅色柱是几张陪跑的基线:随机、常数、未训练网络、只用最近邻训练的网络。
五、写在最后
边界得先说清楚,作者自己写在讨论里:只有一个可调的干预参数,可用数据 101 条,行为类别是提前定好的,而且全文没有一个新做的物理实验。
最关键的一条:预测出来的那个秒数,还没真的打在一只新的 xenobot 上。它有没有照做,这篇没测。
所以严格讲,这是检索,不是生成。模型只会指着仓库里最像的那段录像说"大概是这样"。仓库里没有的组合,它给不出来。
我更看重它对假设的验证方式。80% 这个数字没那么重要,重要的是它证明了"让大模型当裁判,可以代替新实验"这件事,在一个真实活体系统上站得住脚。
这个假设一旦成立,价值在数据那边。实验室里压着大量录过、没细算过的录像,它们本来只是存档,现在可以变成训练集。这个池子比外人想的大得多。
但别把它当成"AI 指挥细胞"的成品。80% 说的是"这句话最像哪段录像",不是"这么做真能让它慢下来"。前者是检索准确率,后者才叫控制。这一格没填,标题里那个"指挥"就只兑现了一半。
顺手给做湿实验的同学一条建议。录像归档时,把刺激参数写进文件名或元数据,别只存视频。这篇能做出来,靠的就是那个仓库里每段录像都带着自己的 d。
还有一条值得记。论文里专门写了 AI 使用声明:裁判用的是 Claude,写作过程也用 AI 润色过,文字由作者复核。这种声明以后会越来越多,早一点习惯比晚一点好。
觉得有用?转发给做类器官、做活体机器人实验的朋友。
— END —
组织工程研究前沿聚焦 AI for Science