ARTICLE · 1225257
80% 的 RAG 问题出在文档解析|AI-FDE 转型之路 · AI 工程 05-解析工程
一、喂进去的垃圾,模型再强也吐不出来
本文适合正在做企业知识库、制度/合同/手册类 RAG 的实施、售前和运维;不讨论模型选型和微调。文中的参数和阈值是起点,不是承诺,必须按项目抽样校准。
二、四个杀手
打个比方。你让一个厨师做菜,食材由你提供。他不认识这批菜,你也没洗没切,整棵带泥扔进锅里,然后评价“这个厨师水平不行”。这不合理,但客户现场天天在上演这个版本。
文档进到知识库之前,会死在这四类手上:
第一类:扫描件。影像 PDF,每一页其实是一张图,必须经过识别才能出字。识别这一步最擅长把“第 3.2 条”认成“第 3.2 杀”,把“500 万”认成“500 方”,把编号“ZX07”认成“ZX0T”。错得极其具体,而且安静——你不去核对原文,根本发现不了。
怎么发现:在 PDF 里试着选中一段文字,选不中就是图;再抽 3 页看编号、金额、日期是否可读。
怎么治:这几页单独走 OCR;识别后用条款编号、金额、日期做正则抽查,错得多的页标出来人工核。
验收看什么:抽 10 个关键字段,编号/金额/日期可读且与原文一致,错误率降到可接受范围。
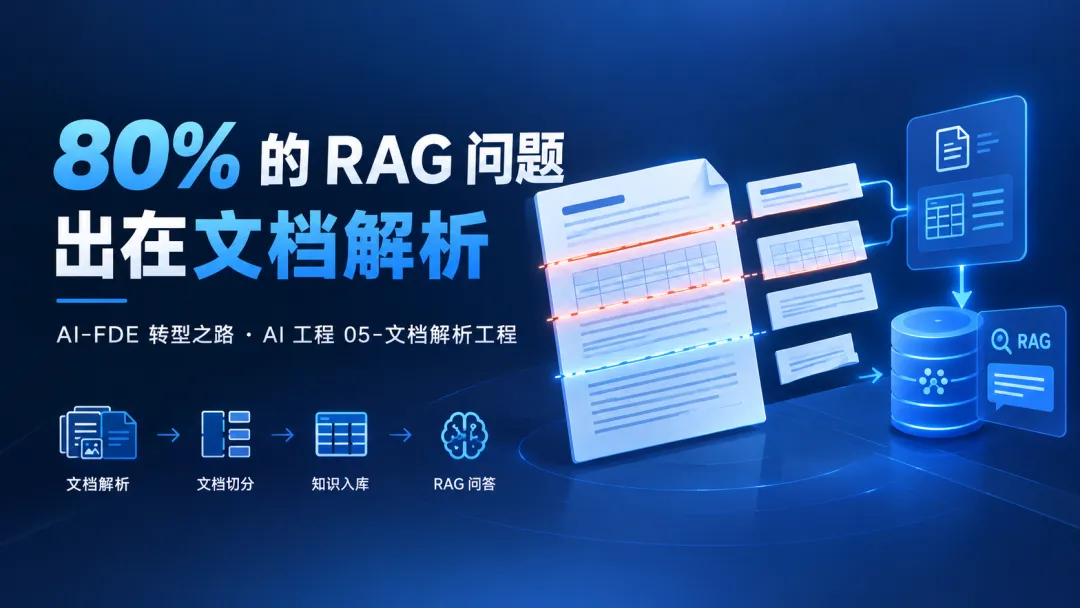
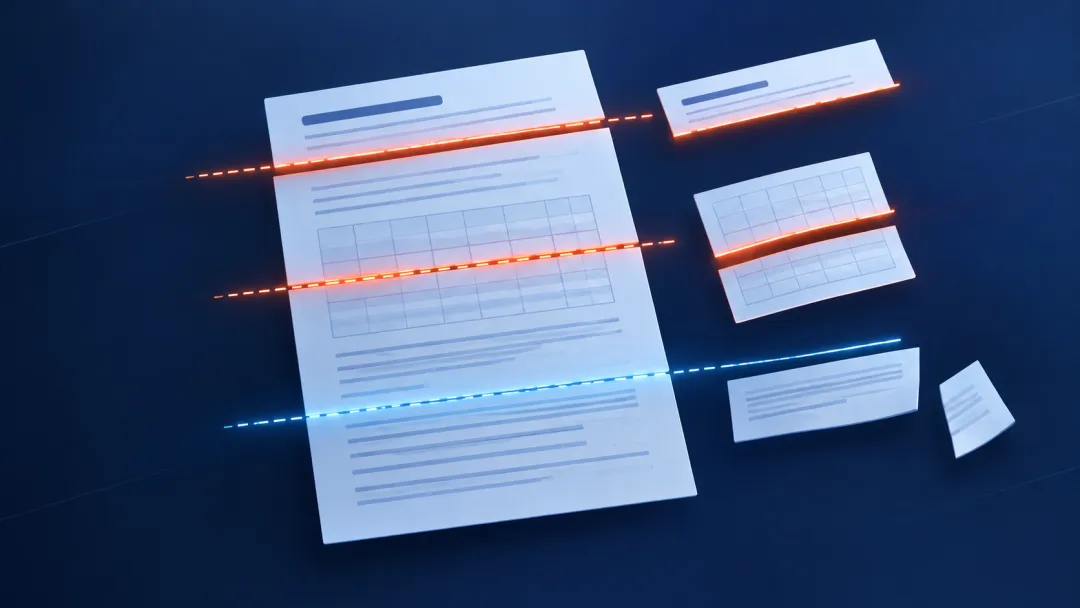
第二类:表格。表格是最容易“物理性破损”的东西。一个三十行的表,切分的时候被中间一刀切开,上半在 A 片段、下半在 B 片段,表头只在 A 里。于是每当检索到 B,模型看到的就是一串没有列名的数字。它答不对,不是它笨,是它看不见表头。
怎么发现:找一个跨页长表,看表头是否跟着每一段走。
怎么治:解析时保留表格结构,转成表格标记,别把表格拍平成一行行文字;跨页表给每一段都回填表头。
验收看什么:抽一个跨页表,每一段片段里都能看到列名,不出现“只有数字没有表头”的片段。
第三类:多栏排版。双栏的文档,很多解析按物理行读,于是左栏一句右栏一句交替出现,读起来像两个人在隔空对话。制度和合同里多栏排版不少见。
怎么发现:找一段双栏内容,看句子是否连贯,是否出现“上句讲授信、下句讲食堂”的串行。
怎么治:换带版面坐标的解析,按阅读顺序先左栏后右栏重排;改完抽三段读一遍顺不顺。
验收看什么:抽三段双栏内容,读起来是连续的一段话,不是左右栏交替的“隔空对话”。
第四类:标题层级。这个最隐蔽。一段话属于“第三章 / 第二节 / 第 3.2 条 / 注意事项”,这个层级关系在原始文档里靠字号和缩进表达,解析完可能全变成一行平文本。层级一丢,模型就不知道这段话的适用边界在哪——而制度的适用边界几乎是全部。
怎么发现:看片段里能不能带上“第几章第几条”,还是全是裸文本、看不出归属。
怎么治:切分时把标题路径一并记下来,拼成前缀塞进片段,或者用元数据保留父标题。
验收看什么:抽任意三个片段,每个开头都能看见“它属于第几章第几条”。
这四类怎么治,第四节那张表的右边一列逐条给了办法。但在治之前,得先说一件更要紧的事——切分。
三、切分怎么切:先选对档,再调参数
切法 | 怎么切 | 适合什么 | 代价 |
固定长度 | 按字数或 Token 数切,带重叠 | 本身没结构的文档(会议纪要、邮件、聊天记录) | 容易切在半句话、半个表格上 |
按结构 | 按标题 / 条款 / 段落边界切 | 制度、合同、手册——有编号有层级的 | 得先能识别出结构,纯扫描件做不了 |
按语义 | 意思相近的相邻段落归并成一块 | 材料本身没有硬结构,且内容杂 | 要多跑一次模型,有成本、有耗时 |
参数 | 建议基线 | 为什么 |
片段大小 | 300–800 字(或 500–1000 Token) | 太小丢上下文,太大检索就散了 |
重叠 | 片段长度的 10%–20% | 让边界处的句子不至于被切断 |
硬上限 | 超过 1500 字强制再切 | 再大就超出"一个意思"的范围了 |
四、一张体检表:一半用来查,一半用来治
检查项 | 怎么查 | 不合格的样子 | 怎么治 |
是不是扫描件 | 试着在 PDF 里选中一段文字,选不中就是图 | 通篇能选,但中间夹着几页图片页 | 这几页单独走识别;识别完用条款编号、金额、日期做正则抽查,认错率高的页标出来人工核 |
编号有没有认错 | 抽十条条款编号,跟纸质/影像原文逐字对 | 字母 O 与数字 0 混、1 与 l 混 | 别指望通用识别全对。只对关键字段做定向校验:编号、金额、日期这三类,错了会出事 |
表格还完整吗 | 找一个跨页长表,看表头是否跟着每一段走 | 只有第一页有列名 | 解析时保留表格结构(转成表格标记),别把表格拍平成一行行文字;跨页表给每一段都回填表头 |
多栏有没有串 | 找一段双栏内容,看句子是否连贯 | 上句讲授信下句讲食堂 | 换带版面坐标的解析,按阅读顺序(先左栏后右栏)重排;改完抽三段读一遍顺不顺 |
标题层级在吗 | 看片段里能不能带上"第几章第几条" | 全是裸文本,看不出归属 | 切分时把标题路径一并记下来,拼成前缀塞进片段(就是上一节第一招) |
页眉页脚清了吗 | 搜一个常见页眉词看命中多少 | 每页都有公司抬头和页码混进来 | 按位置去重(每页同一位置的重复内容剔除),不要按关键词删——关键词会误伤正文 |
切分位置合理吗 | 抽十个片段看开头是不是半句话 | 从句子中间起头的片段占多数 | 别调字数了,换"按结构"切(上一节第二档) |
五、Dify/工具落地映射
工具不是重点,重点是每个动作在工具里有没有对应验收点。用 Dify 如此,用别的工具也一样。下面这张表是实施时“问什么、配哪里”的映射,不写成教程:
再强调一遍顺序:先把解析入口弄干净,再建知识库选父子模式和结构锚点,再确认元数据保留,最后才动 TopK 和阈值。改完必须复检。
六、什么算会了
七、动手任务(按顺序做,别跳步)
从知识库里抽二十份文档,过一遍体检表,按“合格 / 勉强能用 / 必须重做”分三堆。最后一堆超过两成(示例阈值,仅用于演示口径),先别做后面的优化,回头重解析。
产出:体检表 + 三堆清单。
回答一句“我现在用的是哪一档切法”。如果文档有编号、而你用的是固定长度切,改成按结构切一版,拿同样十个问题对一遍——先改档,再调参。
产出:一句话说明 + 改档前后 10 问对照表。
随手抽三个片段,看开头有没有“第几章第几条”。没有就把标题路径拼上去,这是本篇里最便宜的一处改动。
产出:3 个片段截图或文本,改后带“第几章第几条”。
改完再跑一遍体检表。不改完不复检,等于没改。
产出:复检体检表,标出下降项。
没有复检记录的改造,不算完成;没有负责人的体检表,不算落地。
八、坑
《AI-FDE 转型之路》:写给不写代码的 IT 实施 / 售前 / 运维,把已有的交付能力「AI 化」。全系列 55 篇,六大模块 53 项技能。
想先看看自己缺什么:AI-FDE 技能自评地图,53 项打分,出一张雷达图。AI-FDE 转型之路 · 开篇