ARTICLE · 1232121
让AI按器官名称分割CT:VoxTell怎么安装、怎么用,三维ROI怎么导出?
打开一份腹部CT,输入 right kidney,让模型返回右肾的三维掩膜,再叠回原图检查。
这就是VoxTell提供的交互方式:用文字说明目标,把影像和提示一起交给分割模型。 对做影像科研的人来说,值得尝试的是能否拿到一份可继续修改、测量和分析的ROI。
这个项目已有公开代码、模型权重和napari图形界面。官方仓库将其列为CVPR 2026工作;预印本最初公开于2025年11月,软件包在2026年9月更新到0.1.2。下面按当前公开入口,讲清楚怎样从自己的影像开始。[1–3]
输入一句话,模型还需要看到什么?
VoxTell同时接收三维影像和文字提示,输出对应目标的体积掩膜。文字可以是器官名称,也可以是更具体的描述;模型仍要结合影像判断目标在哪里。
初次尝试,可以从 liver、spleen、right kidney 这样明确的英文目标开始。侧别写清楚,一次先验证一个目标,再扩展到多个结构。本文没有验证中文提示的表现。
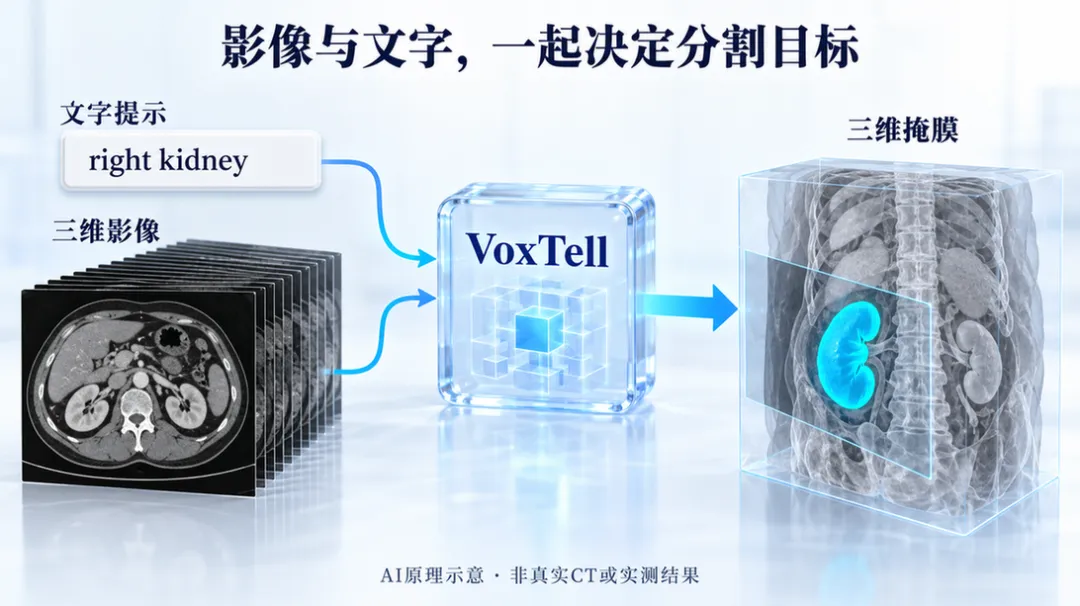
图1|影像与文字共同输入模型的AI原理示意。图中断层影像和掩膜为概念画面,不是真实CT或本文分割结果。
论文探索了更复杂的病灶与报告描述,也讨论了完全陌生解剖区域上的困难。能输入开放文本,不等于任何描述都能得到可靠分割。 上手时先验证一个熟悉、容易复查的器官,更容易判断输入、方向和模型调用是否正常。[3]
自己的CT能不能跑,先看这几个条件
准备一份覆盖目标器官的三维NIfTI影像,例如 case001.nii.gz。如果手里是DICOM,先完成正确的序列选择与格式转换,保留方向和体素间距;JPEG截图不能代替这份体数据。
官方软件要求Python 3.10及以上,需要与运行环境匹配的PyTorch。当前依赖明确排除了PyTorch 2.9.x。模型默认使用CUDA,命令行也提供CPU选项,但有CPU选项并不能据此判断处理一套CT需要多久。[1]
首次使用会下载权重。当前默认模型为 voxtell_v1.1,其中主要分割检查点约1.77 GB;这只是一个权重文件的体积,不能当作全部磁盘或显存需求。常见提示可以使用预计算文本嵌入,未覆盖的提示可能触发文本编码模型的加载。[1,4]
有可用的GPU工作站,可以让界面留在自己的电脑上,把推理交给工作站。 napari插件提供远程模式,但需要先部署可连接的VoxTell服务;远程提交会把影像传到所配置的后端。[2]
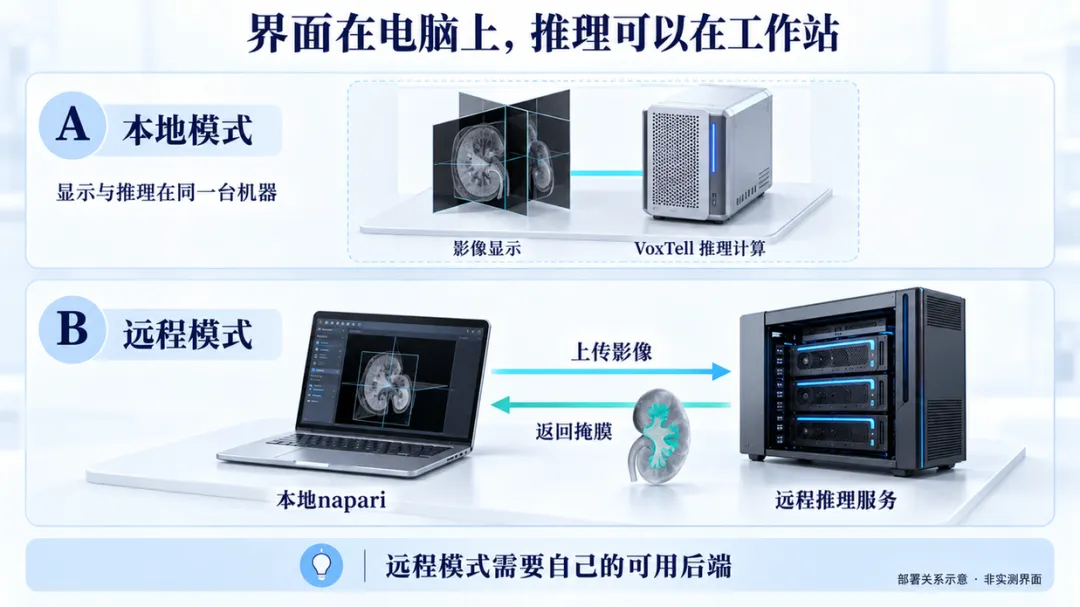
图2|本地与远程部署关系示意,画面由AI辅助生成。远程模式是可选路径,图中电脑界面与影像均非实测截图。
想先看见结果,可以从napari界面开始
在准备好PyTorch的独立Python环境中,安装插件并启动界面:
bashpip install napari-voxtell napari -w napari-voxtell打开NIfTI时,选择插件提供的 VoxTell reader。它采用与模型训练一致的读取与重定向方式,并保存恢复原始方向所需的信息。普通读取器打开后“看起来正常”,仍不足以说明输入模型的方向正确。[2]
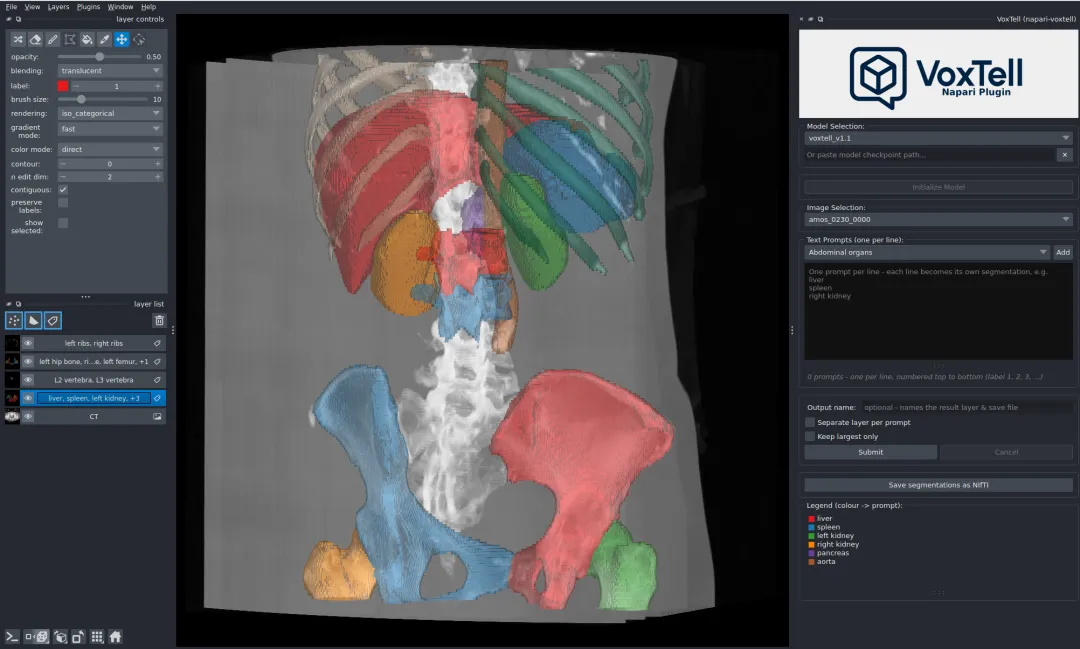
图3|开发者公开的真实napari插件界面,展示腹部结构与文字提示区域。来源:MIC-DKFZ/napari-voxtell。它是作者演示,不是本文本机运行结果;界面以实际安装版本为准。
进入VoxTell面板,选择模型并点击 Initialize。随后在 Image Selection 中选择目标影像层,在提示区域输入 right kidney,点击 Submit。
先只输入这一行。结果出现后,回到原图逐层看:选中的是不是右肾,有没有连到其他组织,上下端是否完整。左右方向要结合影像方向信息判断,不能直接把屏幕左侧叫作患者左侧。
要同时尝试多个器官时,每行写一个提示。插件支持将结果分成独立Labels图层,也能显示合并标签及颜色图例。把目标名称、颜色和图层对应起来,再检查每个结构。[2]
想接进自己的流程,也有命令行入口
VoxTell核心软件包提供 voxtell-predict。下面这条命令以一份NIfTI和一个提示为输入,把结果放进独立目录:
bashvoxtell-predict -i case001.nii.gz -o roi_output -p "right kidney" --no-overwrite按0.1.2发行包的默认命名规则,对应文件应为:
textroi_output/case001_right_kidney.nii.gz这里的文件名是说明输入与输出关系的例子。本文对官方发行包中的参数解析和文件命名函数做了离线核对,没有运行这份CT的模型推理。
同一套提示要应用于多份影像时,-i 可以接一个NIfTI文件夹;-p 可以给出多个带引号的提示。每例需要不同提示时,官方还提供 --jobs。先跑通一例并检查保存结果,再扩大范围。[1,5]
得到彩色结果以后,怎样把ROI真正带走?
命令行默认按提示分别保存二值掩膜;napari插件的 Save segmentations as NIfTI 则会把选定影像对应的VoxTell图层合并为标签图,恢复到原图方向,并保存JSON图例。两条路径的输出组织不同,需要看清自己用了哪一种。[2,5]
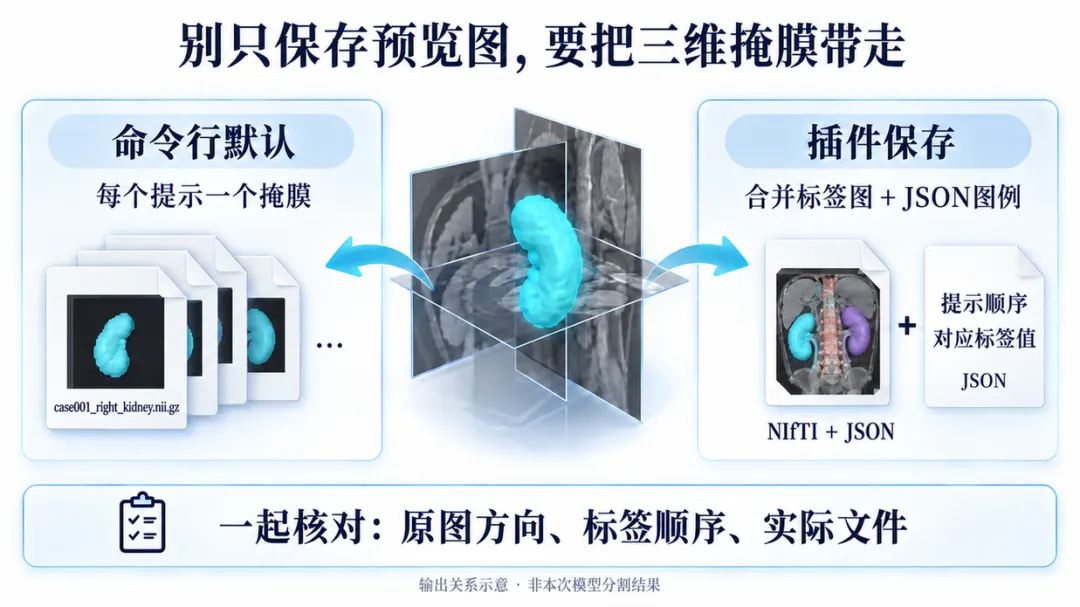
图4|两种保存路径的AI概念图解。文件名用于说明格式,图中影像不是本文模型结果;标签与提示的对应关系以实际输出图例为准。
保存后,把原始CT与输出掩膜一起重新打开,核对尺寸、方向、空间位置和标签含义。多提示合并时,后面的提示可能覆盖重叠区域,提示顺序也应保留。
后续要测体积、提取影像组学特征或用作训练标注,先把分割质量检查与必要的人工修正做完。文字提示改变了选择目标的方式,ROI是否符合课题定义,仍要回到影像和研究目标判断。
VoxTell值得尝试的地方,就在于把目标选择变得直接:先描述自己要的结构,再拿着三维掩膜回到原图验证。 从一个明确器官开始,把载入、分割、保存和复查走通,这份结果才接得上后面的科研工作。
项目入口与核查范围
[1] VoxTell官方项目与使用说明。[2] napari图形界面、读取与保存说明。[3] VoxTell预印本及方法说明。[4] 默认模型文件与许可。[5] 0.1.2官方发行包。
2026年10月22日核查官方文档、模型文件元数据与0.1.2发行包源码。软件代码为Apache-2.0许可,默认模型权重为CC BY-NC-SA 4.0,两者使用条件不同。当前仓库main可能包含未发布变更,操作项以安装版本为准。本文未安装完整推理环境、下载大模型或完成分割实测;未报告新的模型效果数据。
读片摸鱼指南|关注AI与影像科研中能实际用起来的新工具。