ARTICLE · 1238405
我让 AI 写了个脱敏工具,三种写法不用密钥就还原
银行做开发,最常缺的东西不是代码,是数据。
要测一个转账功能,得有一批像样的客户和账户;要测对账,得有一批像样的流水。真实的不能拿出来,编的又不真。所以几乎每个项目都会出现同一件事:有人写个小工具,把导出的样本洗一遍,拿到开发库去用。
这事本身在绿区。判据很简单:工具写错了,当场就看得出来,而且它根本不接触生产数据。所以我一直是让 AI 写这类工具的。
这次我让它写一个脱敏工具。
它交了三个函数,分别处理姓名、证件号、卡号。代码干净,注释清楚,还跟我解释了「都做了不可逆处理」。
我把这三个跑了一遍。
三个,一个都没挡住。
它交了什么
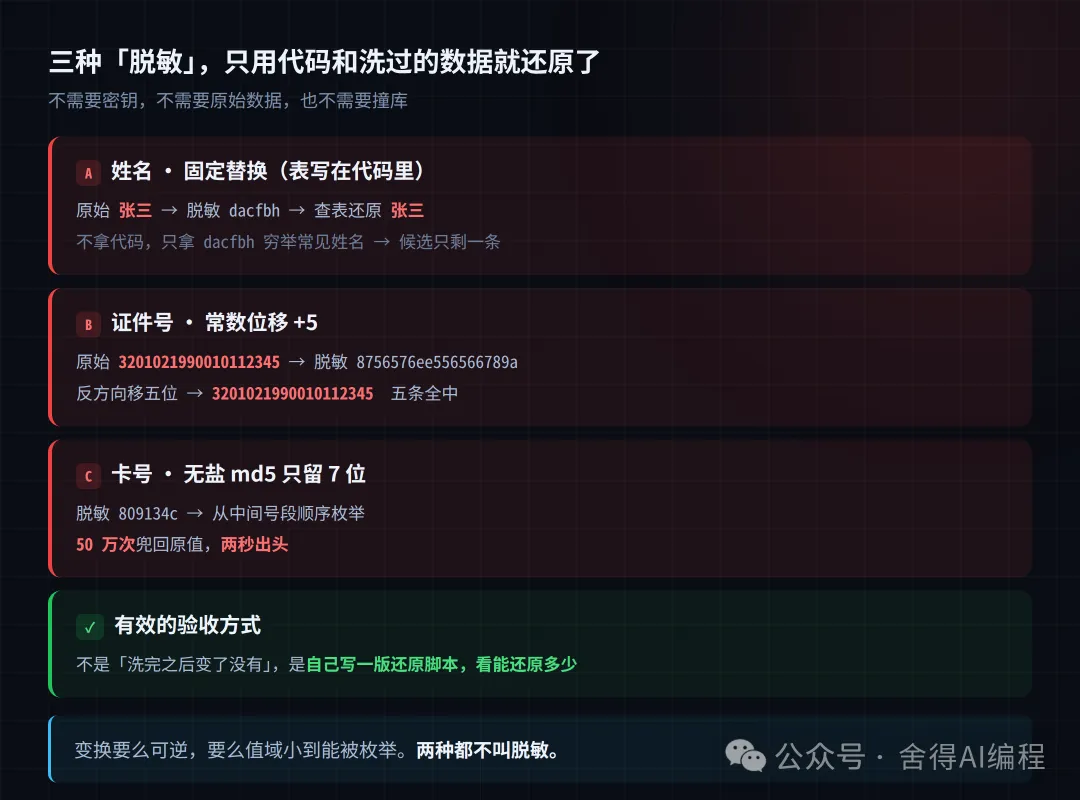
第一个,姓名。每个字替换成一个固定的假字,同一个人每次都变成同一个假名。
第二个,证件号。每一位往后错五位,转成字母数字混排。
第三个,卡号。先算一遍 md5 哈希,再截前七位当替代值。
读下来,三件事都做了:变了、错了、看不出原样了。
问题是这三件事之间没有因果关系。
我是怎么把它还原回来的
还原没用什么破解手段,就是穷举。信息量根本没被打掉,只是换了副样子。
姓名那一版,映射表就写在代码里。反过来排一遍字典,逐字查回去,五条全中。
而且就算代码拿不到,只拿洗过的那个值 dacfbh,配上「这是中文人名」这个常识去穷举常见姓名组合,结果也只有一条:张三。
证件号那一版,位移量是常数,写在函数里。往反方向移五位,五条全中,一位不差。
卡号那一版,看着最像回事,因为它用了哈希。但它只留了七位十六进制。卡号的结构是公开的:前六位是发卡行,最后一位是校验位,真正不知道的只有中间那十二位。我从中段往前挨个试,撞上原值用了 50 万次左右,两秒出头。
三个函数,三种写法,毛病是一个:变换要么可逆,要么值域小到能被人一个个试完。
为什么测试测不出来
这点比 bug 本身更值得说。
如果让 AI 顺手写测试,大概就是这几条:洗完之后名字变了,通过;证件号格式还对,通过;同一条数据洗两次结果一致,通过;空值不报错,通过。
这些测试全绿,而且确实都对。它们测的是「变换有没有发生」。
但脱敏这件事的定义不是「变了」,是「变不回去」。
「变不回去」这个性质,用常规单测证明不了。你得站到对面去,拿工具本身当对手,试一遍能不能还原。AI 写测试天然站在开发者这边,不会站到对面去。
所以这类工具最容易糊弄人。它不只是写错了,它还能自己证明自己是对的。拿着那份全绿的测试报告,你很容易跳过自己动手那一步。
什么样的脱敏才算数
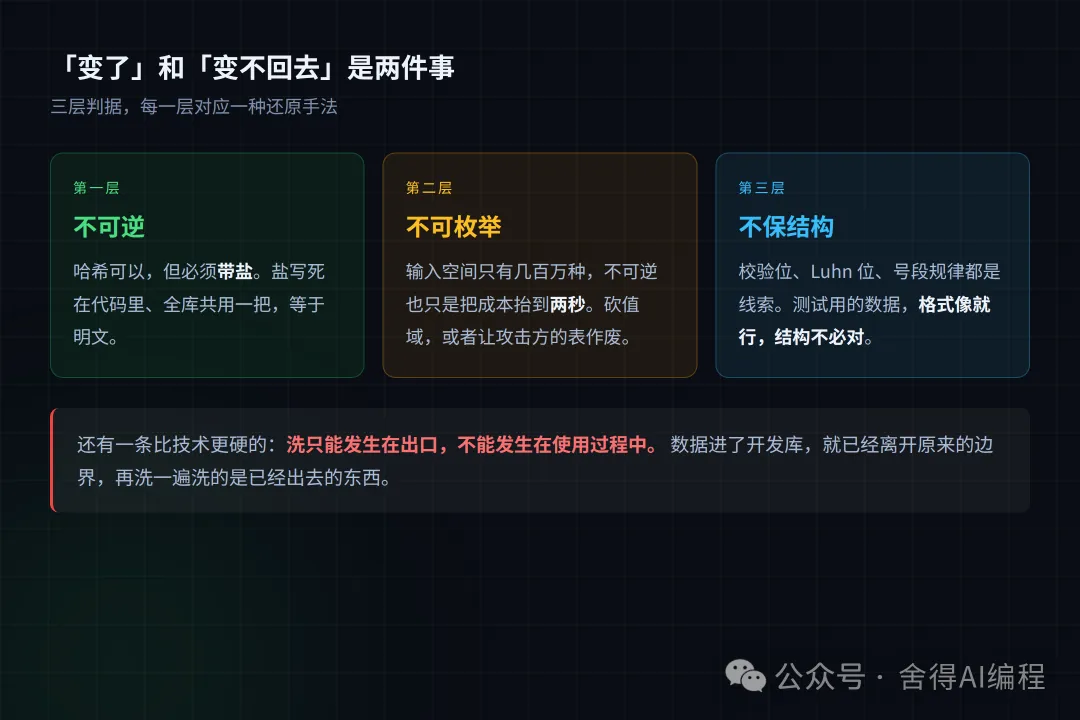
我把判据拆成三层。
第一层,不可逆。不是换了,是换不回来。哈希走这条路可以,但必须带盐,盐不能写死在代码里,不能全库共用一把。不加盐的哈希,对证件号这种值域有限的东西,等于明文。
第二层,不可枚举。就算不可逆,输入空间只有几百万种的话,也只是把还原成本从零抬到了两秒。要么加盐让攻击方那张表作废,要么直接把值域砍掉,比如证件号只留省市区前缀,后面整个换随机。这一层是数量级问题,不是有无问题。
第三层,不保结构。这一层最容易忽略。证件号的校验位、卡号的 Luhn 位、手机号的号段规律,都是结构。结构留着,工具能跑了,但每条数据都在告诉你它原来长什么样。开发测试里很多场景根本不需要结构是对的,只需要格式像个样。
还有一条比技术更硬的:洗只能发生在出口,不能发生在使用过程中。 数据进了开发库,它就已经离开了原来的边界,再洗第二遍洗的是已经流出去的东西。顺序是先洗、再出,出去之后别再洗。
该怎么用 AI 干这件事
四步。
第一,让 AI 写工具,不让它验收。 它写得快,这部分确实强。但「够不够」它判不了,它没有对手视角。交付归它,验收不归它。
第二,验收自己写一版还原脚本。 这是唯一有效的验收方式。拿洗过的数据,写个查表/回推/枚举的脚本,能还原多少就是漏了多少。我这次就是这么抓出来的,还原脚本比脱敏工具本身还短。
第三,盐和密钥不进代码。 写在代码里的常量等于没有。参数从环境变量读,读不到就报错退出,别给默认值。给默认值那天,就是它在生产上用默认值那天。
第四,洗完抽一批人工看一眼。 不是看程序输出,是看数据本身。姓名是不是还集中在几个常见姓、证件号前六位是不是还对着真实地区、金额是不是还留着真实量级。程序判不了的事,眼睛三秒钟能看出来。
最后
这篇不是要说 AI 写不了脱敏工具。这活我以后还会交给它,它快,错了代价也当场看得见。
我要说的是另一句:「当场可见」这个条件,得你自己去创造。
AI 交出来的东西,自带一副「我已经验证过了」的样子:默认参数、成套的测试、讲得通的理由。三样凑齐,人就容易跳过自己动手那一步。
脱敏这类工具,自己动手那一步就是写个还原脚本。写完你就知道它到底挡没挡住。
不写,你就只能拿它的话当结论。而它的话,恰好是全绿。
关于这篇的实验
文中三个脱敏函数的写法、还原方式和一个还原耗时,是我拿一套虚构数据自己跑出来的,代码从零重写,没有一行来自工作环境。
实跑结果:姓名版五条全部查表还原,且只拿洗过的值不做查表、穷举常见姓名也只剩「张三」一个候选;证件号版五条反方向移五位全部原样还原;卡号版把截断值当目标、从中间号段顺序枚举,50 万次左右命中,两秒出头(本机 Python,单线程)。
未验证的部分
「穷举要多久」这个数是本机单线程 Python 跑出来的量级,不是评估结论。真实数据分布、能不能并行、有没有别的侧面信息可用,都会让这个数变。文中「两秒」只能说方向:留七位十六进制挡不住。
具体哪些字段要脱敏、脱到什么程度、能不能保留格式,是合规和业务要求,得按你们自己的制度定。文中三层是结构,不是标准。
还有一点:本篇讲的是「工具本身写得不够」这一类问题。让 AI 去碰真实生产数据的导出、或者把样本贴进对话框,那是另一条线(红线 r3),不在本篇范围内。
红线自查
只讲通用脱敏逻辑,不涉及任何具体机构的实现 所有代码从零重写,虚构银行「示范银行」、虚构姓名、虚构证件号与卡号(Luhn 位自己算) 全文不出现任何真实机构名、项目名、可反推的细节