ARTICLE · 1239755
Kafka源码深度剖析:RecordAccumulator 封装消息流程
分区决定了消息去哪个 Partition,接下来消息进入 RecordAccumulator——Producer 内部最复杂的组件。它按分区维护双端队列,把一条条消息攒成 16KB 的批次,等 Sender 来拉。这篇拆 RecordAccumulator 的内部结构、append() 流程和 ByteBuffer 布局。
为什么需要 RecordAccumulator
前面几篇讲了 send() 怎么序列化、怎么选分区。但选完分区后,消息不是直接发出去的——那样每条消息一次网络请求,吞吐会惨不忍睹。
Kafka Producer 的核心优化就是攒批:同一分区的消息先在内存里攒成一个批次(默认 16KB),攒满了(或 linger.ms 到了)再一次性发给 Broker。RecordAccumulator 就是做这件事的。
它解决两个问题:
攒批:多条消息合并成一个网络请求,减少 IO 次数
路由:按分区组织,Sender 拉取时知道哪些分区有 ready 批次
01 数据结构:每个分区一个双端队列
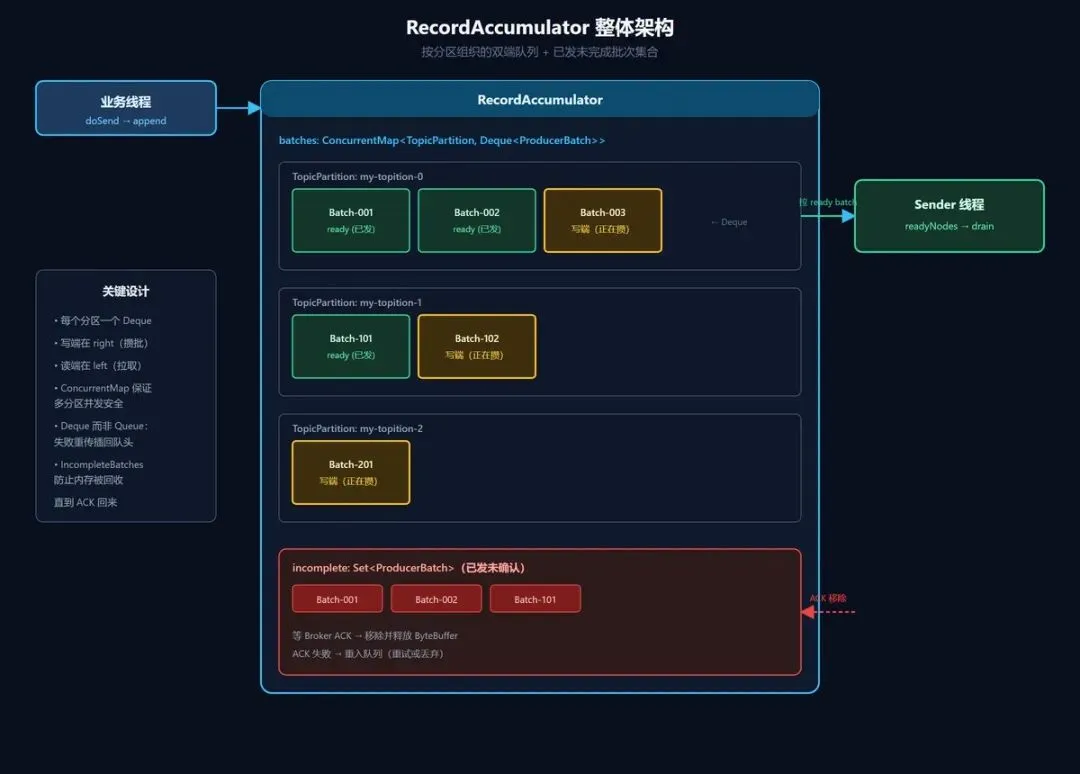
RecordAccumulator 内部核心是一个 ConcurrentMap<TopicPartition, Deque<ProducerBatch>>。每个分区对应一个 Deque,Deque 里是这个分区的所有批次。
为什么是 Deque 而不是普通 Queue?因为读写两端不同:
写端(right):业务线程把新批次加到队尾,正在攒批
读端(left):Sender 线程从队头拉 ready 批次发出去
失败重传:ACK 失败的批次插回队头,保证尽快重试
ConcurrentMap 保证不同分区的 Deque 之间并发安全——两个分区的业务线程同时 append,不用互相等。
除了 batches 这个 Map,还有一个 incomplete: Set<ProducerBatch>。所有已经发出去但还没收到 ACK 的批次都在这个集合里。为什么要这个 Set?因为如果没有强引用,这些批次可能被 GC 回收——但网络上还飘着它们的字节,ACK 回来时找不到对应对象就炸了。
02 append() 流程:找尾批次,写不进去就新建
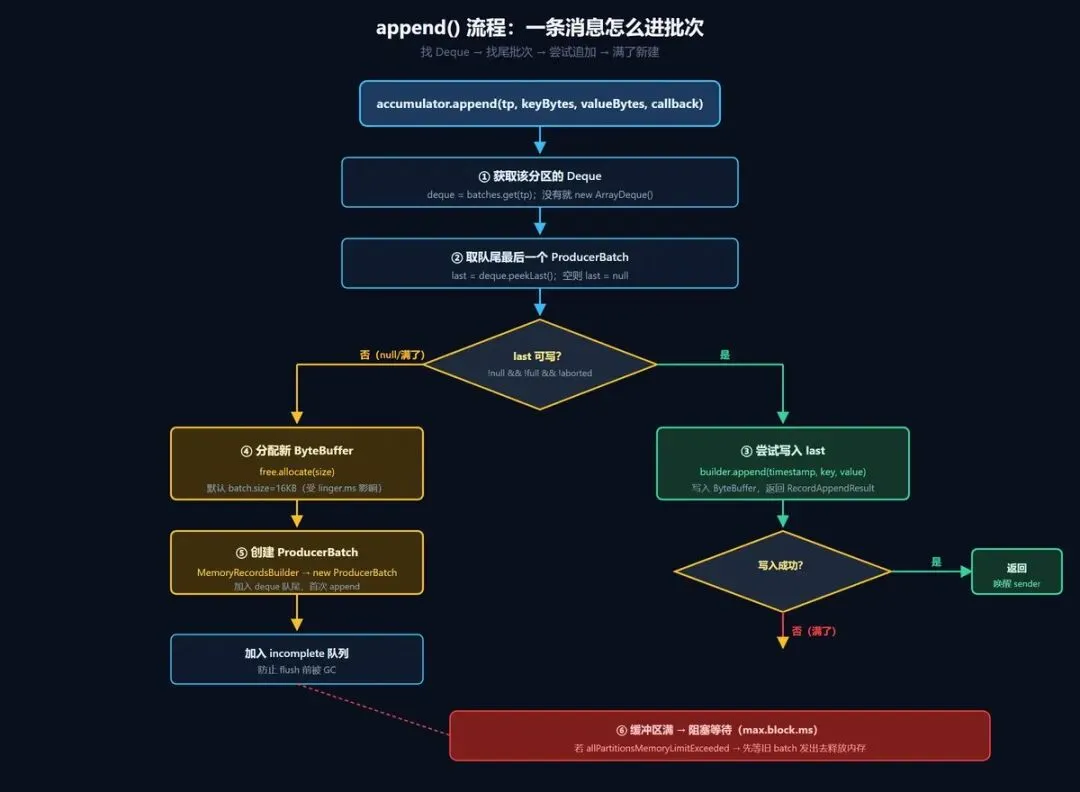
业务线程调 accumulator.append() 时,流程是一条决策链:
第一步:拿到该分区的 Deque。没有就新建一个。
第二步:看队尾最后一个批次。没满、没 abort,就尝试往里写。
第三步:MemoryRecordsBuilder 把 key、value、timestamp 写入 ByteBuffer。
第四步:写不进去(满了),从 BufferPool 拿一块 16KB ByteBuffer,新建 ProducerBatch。
第五步:BufferPool 没内存了,阻塞等待 max.block.ms(默认 60 秒),等不到就抛异常。
这里有个容易踩的坑:linger.ms=0 不代表消息立刻发出去。它只是说"攒满 batch.size 就发,不用等时间"。如果消息量很小,一个批次永远攒不满 16KB,就会一直等。线上低流量场景调大 linger.ms(比如 5ms)比调小 batch.size 更有效——让小批次攒得快一点,而不是把每个批次拆得更小。
03 ByteBuffer 布局:一条消息在内存里长什么样
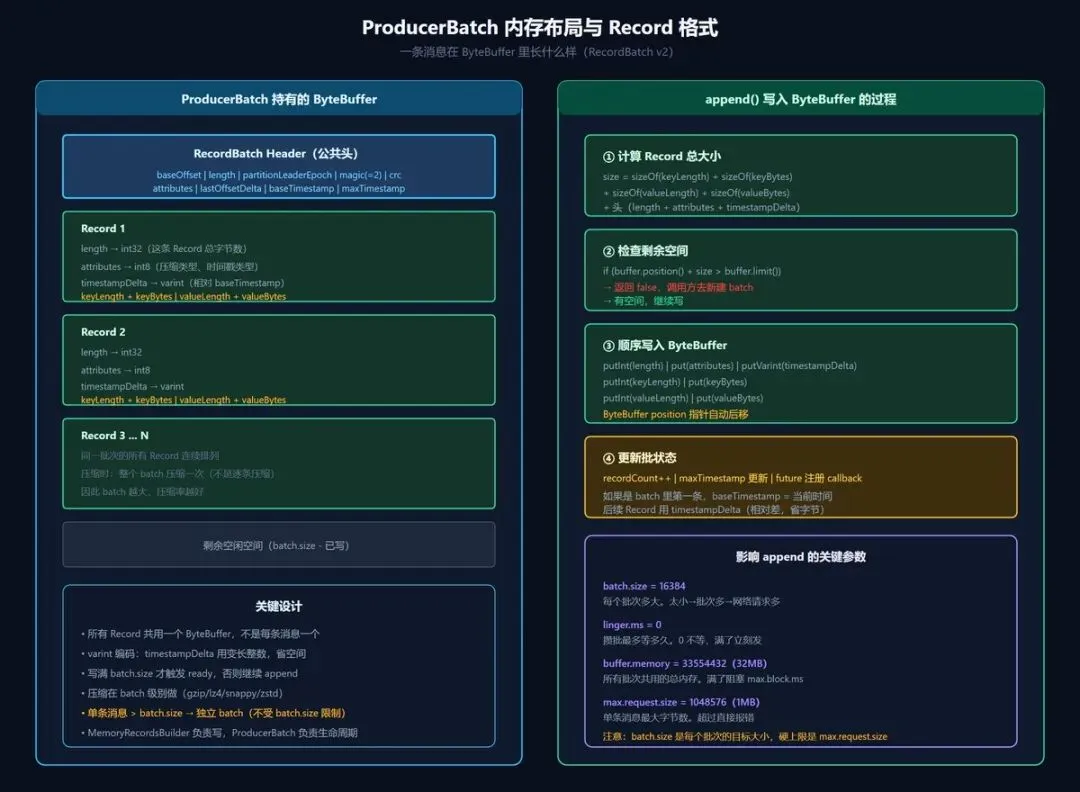
一个 ProducerBatch 底层就是一块 ByteBuffer。写入格式是 RecordBatch v2:
[Batch Header(公共头)] baseOffset | length | magic(=2) | crc attributes | lastOffsetDelta | baseTimestamp | maxTimestamp[Record 1] length | attributes | timestampDelta | keyLength | key | valueLength | value[Record 2] ...[Record N] ...[剩余空闲空间]
几个关键设计:
为什么用 timestampDelta? 同一批次的消息时间戳相差很小,存差值(varint 变长整数)比存 8 字节绝对时间省得多。baseTimestamp 存在 Batch Header 里只存一次。
为什么在 batch 级别压缩? 同一个 batch 里的消息通常相似(同一个用户、同一个事件类型),batch 级别压缩率远高于逐条压缩。gzip 能压到原来的 1/5,zstd 更好。
单条消息超过 batch.size 怎么办? 直接分配一块单独的 ByteBuffer,大小就是这条消息的大小(受 max.request.size 限制,默认 1MB)。它自己成一个 batch。
04 内存管理:BufferPool 和背压
RecordAccumulator 不是无限内存。总大小由 buffer.memory 控制(默认 32MB)。所有批次共用这 32MB。BufferPool 管理这些内存:分配 ByteBuffer、回收 ACK 后的 ByteBuffer。
当 32MB 用完了,新的 append 请求就阻塞——这就是背压。线上最常见的内存问题:
消息太大:单条 10MB 超过 buffer.memory,直接 OOM。调 max.request.size 和 buffer.memory。
发送太慢:Broker 响应慢,批次都在 incomplete 集合里不释放,32MB 用完,业务线程阻塞 60 秒后抛异常。这是 Broker 侧问题。
分区太多:32MB 被切成 500 个批次,每个批次只有 64KB——利用率低。
经验值:buffer.memory 至少是 batch.size × 活跃分区数 × 2。比如 50 个分区,每个 16KB,32MB 够用;如果 500 个分区,就要调到 160MB。
写在最后
RecordAccumulator 看起来就是个 Map,但它是 Producer 性能的核心:攒批减少网络请求,Deque 支持失败重传,BufferPool 控制内存上限。理解了 append() 流程,就理解了为什么调 batch.size、linger.ms、buffer.memory 能影响吞吐——它们分别控制"批次多大"、"等多久"、"总共多少内存"。