ARTICLE · 1244558
V4L2 源码深度解析(十一):从 vmalloc 到 DMA——设备怎样访问缓冲区?
前面的采集流程已经闭合:应用申请缓冲区、建立映射、QBUF,驱动接收对象并产生图像;完成以后,应用通过 DQBUF 取回结果,最后停流、释放。一直没有改变的,是那组用来存放像素的内存。
不过,前面主要沿 VIMC 的软件处理路径阅读。它取得 CPU 能访问的指针,调用 memcpy() 写入一帧。换成真实采集设备后,图像往往由硬件直接写入内存。这时,驱动究竟应该把哪个地址交给硬件?原来的 vmalloc 内存能不能继续使用?所谓“连续缓冲区”,连续的是哪一种地址?
本篇从这些问题出发,依次读 videobuf2-vmalloc.c、videobuf2-dma-contig.c 和 videobuf2-dma-sg.c。先解释设备访问内存的条件,再分析后端怎样建立地址、怎样与 VB2 交接、最后怎样撤销这些关系。普通 CAPTURE、MMAP 是主线;USERPTR 和 DMA-BUF 只在影响后端行为时交代边界,完整导入流程留到后续专题。
1. CPU 能访问的指针,为什么不能直接交给设备
1.1 先看已经跑通的 VIMC
vimc_capture_process_frame() 中,真正写像素的是下面两行:
    vbuf = vb2_plane_vaddr(&vimc_buf->vb2.vb2_buf, 0);

memcpy(vbuf, frame, vcapture->format.sizeimage);
第一行取得 buffer 的第 0 个平面在内核中的 CPU 虚拟地址;第二行由 CPU 执行复制。沿用 640 × 480 RGB24、无额外行填充的例子,这次复制的逻辑容量为 921600 字节。
CPU 执行 memcpy() 时,使用自己的地址转换规则。它并不是把 vbuf 这个数值直接放到内存总线上。启用 MMU 的系统会通过页表,把这个虚拟区间对应到底层内存页。
采集硬件不执行这条 memcpy(),也不自动使用 CPU 的这套页表。驱动需要给它一个对该设备有效的访问地址,或者一组描述这些地址的硬件任务。把 vbuf 强制转换成整数,并不会完成这件事。
1.2 硬件 DMA 替代的是像素搬运,不是缓冲区管理
真实设备可以在 buf_queue() 中记录缓冲区,在启动或运行过程中把地址写入硬件寄存器或描述符。设备完成写入后,驱动确认访问已经结束,填写结果,再调用 vb2_buffer_done()。
VB2 仍然负责池、状态、排队、完成和等待;内存后端负责提供适当的存储和访问表示。选择一个名字含 DMA 的后端,不会自动替驱动配置寄存器、建立描述符、处理完成中断。 有的硬件内置总线主设备能力,有的需要另一颗 DMA 控制器;是否使用 DMAEngine,要看设备驱动的实现,不由 mem_ops 的名字决定。
这里讨论“DMA 减少复制”,也需要分清目标:设备直接写入最终的采集缓冲区,可以减少一次 CPU 搬运;但 DMA 仍在传输数据。其他处理节点可能还会转换格式、复制图像,DMA 映射实现也可能使用反弹缓冲区,不能仅凭后端名称宣称整条链路零复制。
实现对照:vimc_capture_process_frame();DMA 地址规则见文末接口 A。
2. 一份存储,为什么会有几种地址
2.1 应用地址、内核地址和设备地址
应用的 mmap 返回值属于本进程的虚拟地址空间。内核的 vaddr 属于内核 CPU 地址空间。它们可以映射同一组页,却使用不同的数值。
设备使用的地址由 DMA API 按具体 struct device 建立。驱动通常用 dma_addr_t 保存它。设备经过 IOMMU 时,这个地址可先转换为物理地址;没有 IOMMU 的系统,也可能存在总线地址转换或可寻址范围限制。只有特定平台上数值碰巧一致,不能据此省掉 DMA API。
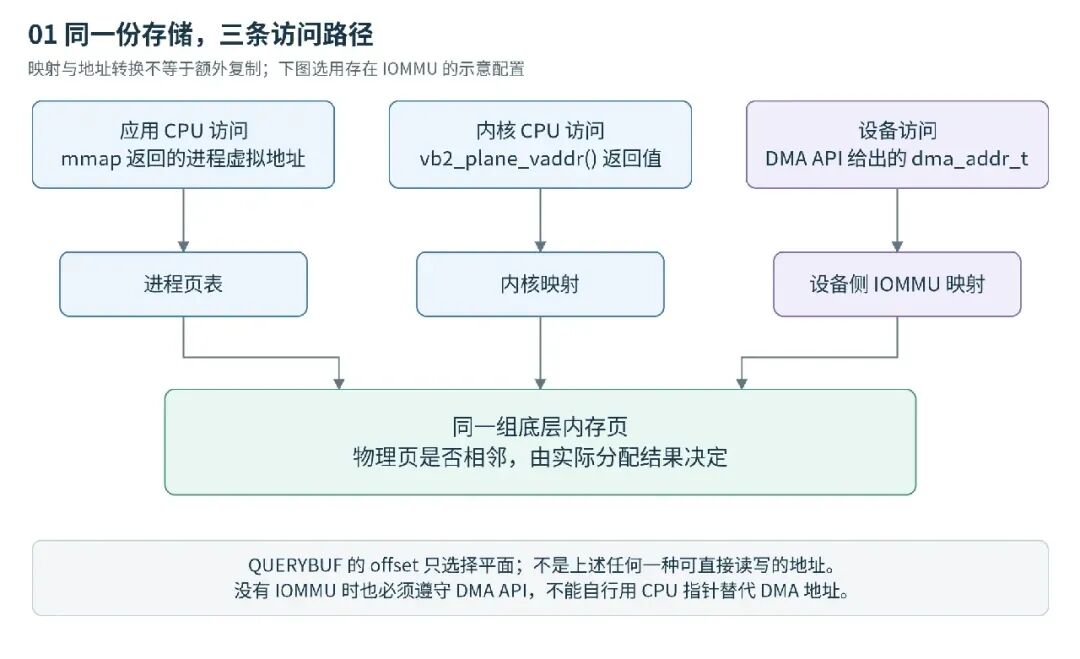
图 1:箭头表示地址转换或关联,不表示又复制了一帧。设备侧 IOMMU 是可能存在的配置,不是所有设备的必经硬件。
QUERYBUF 返回的 m.offset 还属于第四类数值:它用来选择某个缓冲区平面,是 mmap 接口的标识。它既不是 mmap 返回地址,也不是物理地址或 DMA 地址。
2.2 “连续”必须带上地址空间
假设一段存储由四个页组成,CPU 可以把它们映射为一个连续虚拟区间。底层四个物理页却可能分布在不同位置。若设备具有合适的 IOMMU 映射,这些页又可能在设备侧形成一段连续的 DMA 地址。
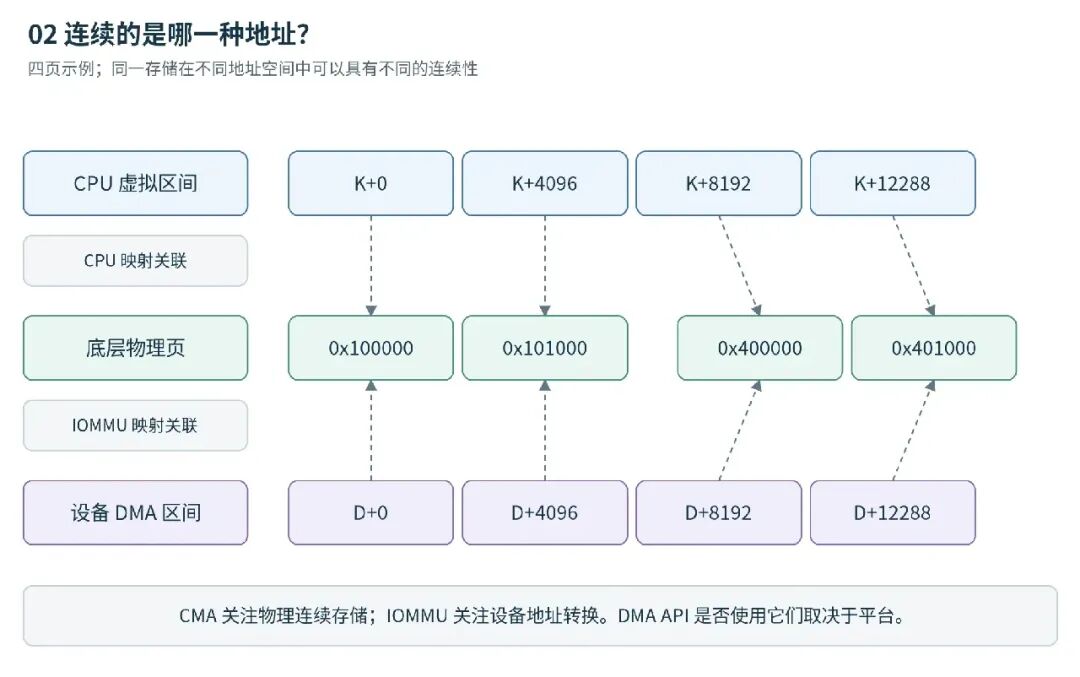
图 2:示意中物理页有间隔,CPU 和设备各自建立连续视图。图中的 IOVA 只是设备虚拟地址示例,不代表每次 DMA 映射都会合并成一个区间。
因此,阅读“contiguous”时要问:连续的是 CPU 虚拟地址、物理页,还是设备看到的 DMA 地址?
CMA 是一种帮助取得物理连续内存的机制;IOMMU 是设备地址转换机制;dma_alloc_*() 是驱动使用的 DMA API。三者不处在同一层。某个 DMA 分配可以在特定平台借助 CMA,也可以借助 IOMMU 组织存储,不能把它们画成三个互斥的内存后端。
2.3 硬件到底能消费什么布局
一种设备只接受“基地址+长度”,会在这个地址空间中顺序访问。它需要整个范围对设备连续;只给它一个不连续 SG 表的首地址,会让它跨越第一段之后访问错误的位置。
另一种设备可以消费多段描述符,每项包含地址和长度,逐段进行访问。它不一定要求整个帧在设备侧连续,但有自己的描述符数量、段长度、边界和对齐限制。
SG 表描述存储,硬件描述符描述设备任务,两者不是同一个数据结构。 即使硬件支持多段访问,驱动仍要把 DMA 映射结果翻译成该硬件接受的格式。IOMMU 也只能在平台和设备支持的条件下改善地址布局,不能替设备增加它原本没有的功能。
3. 地址对了,为什么还会读到旧图像
3.1 缓存保存的内容不一定已经写回内存
CPU 可能把数据保留在缓存中,设备则通过自己的访问路径读写存储。在缺少相应硬件一致性保证的系统上,两端可能暂时看到不同的内容。
对 OUTPUT,CPU 刚准备的像素可能仍在缓存,设备读取到的还是旧内容。对 CAPTURE,设备已经写入新图像,CPU 却可能继续命中旧缓存;更糟的是,CPU 留下的脏缓存行在稍后写回,可能覆盖设备的新结果。
解决办法不是“任何时候都手工 flush 一遍”。需要先确定分配和映射的约定、访问方向,再在 CPU 与设备交接的位置使用相匹配的 API。
3.2 一致性分配与流式映射
一致性 DMA 分配提供约定的 CPU/设备可见性,驱动通常不需要为每轮交接手工做同类缓存维护。它不等于“所有系统都关闭 CPU 缓存”,更不等于访问无需同步:硬件是否完成、描述符字段先后是否可见、CPU 与设备能否同时改同一块区域,仍需按设备协议处理。缓存一致性不能替代必要的内存屏障。
流式 DMA 映射则要求明确访问方向和交接。映射可为一次传输建立,也可以保持多轮使用,并在合适位置调用 dma_sync_*()。streaming DMA 的“streaming”不等于 V4L2 的 STREAMON。 前者描述 DMA 内存访问约定,后者控制视频队列运行。
VB2 没有规定所有后端一律采用同一种 DMA 分配方式。下面会看到:dma-contig 有两条分配分支,dma-sg 则自己分配页并建立流式 DMA 映射。此前常见的“VB2 默认全部使用流式 DMA”不足以描述这里的实现。
3.3 映射、同步和完成分别做什么
映射建立设备能够访问的地址关系。缓存同步处理交接时的数据可见性。完成通知说明本轮实际访问已经结束。三者要配合,任何一项都不能替代另外两项。
例如 dma_sync_sgtable_for_cpu() 不是“等待 DMA 跑完”的函数;必须先由设备协议确认写入已经完成。反过来,即使已经收到完成中断,也不能跳过当前内存模式要求的缓存交接。
接口对照:DMA 的一致性、方向与复用规则见 A、B;后端自己的调用位置以下文源码为准。
4. VB2 怎样把一块平面交给内存后端
4.1 内存方式和后端是两个选择
V4L2_MEMORY_MMAP 表示由当前队列准备存储,再允许应用映射。它不等于“必须使用 vmalloc”。VIMC 就在同一类队列中选择不同的 mem_ops:
    q->io_modes = VB2_MMAP | VB2_DMABUF;
if (vimc_allocator == VIMC_ALLOCATOR_VMALLOC)
        q->io_modes |= VB2_USERPTR;
    q->drv_priv = vcapture;
    q->buf_struct_size = sizeof(struct vimc_capture_buffer);
    q->ops = &vimc_capture_qops;
    q->mem_ops = vimc_allocator == VIMC_ALLOCATOR_DMA_CONTIG
           ? &vb2_dma_contig_memops : &vb2_vmalloc_memops;
    q->timestamp_flags = V4L2_BUF_FLAG_TIMESTAMP_MONOTONIC;
    q->min_buffers_needed = 2;
    q->lock = &vcapture->lock;
    q->dev = v4l2_dev->dev;
代码里的两张表分别是 vb2_vmalloc_memops 和 vb2_dma_contig_memops。当前 VIMC 没有把 dma-sg 作为第三个 allocator 选项;后文读 dma-sg 是分析另一个通用后端,不是描述一个不存在的 VIMC 配置。
更换 mem_ops 也不会把 VIMC 的 memcpy() 变成 DMA。只要填帧函数仍按原样运行,像素依然由 CPU 复制。将真实硬件驱动从一个后端换到另一个后端,还必须同步调整地址取得方式和设备任务组织。
4.2 mem_priv 是每个平面的后端对象
MMAP 分配路径逐平面调用 mem_ops->alloc()。下面是 __vb2_buf_mem_alloc() 中的连续节选:
/* Memops alloc requires size to be page aligned. */
unsignedlong size = PAGE_ALIGN(vb->planes[plane].length);

/* Did it wrap around? */
if (size < vb->planes[plane].length)
gotofree;

        mem_priv = call_ptr_memop(alloc,
                      vb,
                      q->alloc_devs[plane] ? : q->dev,
                      size);
if (IS_ERR_OR_NULL(mem_priv)) {
if (mem_priv)
                ret = PTR_ERR(mem_priv);
gotofree;
        }

/* Associate allocator private data with this plane */
        vb->planes[plane].mem_priv = mem_priv;
size 已按页对齐,dev 优先使用该平面的 alloc_devs[plane],否则使用 q->dev。返回值保存到 mem_priv。这个返回值是后端私有对象,不一定是像素地址。
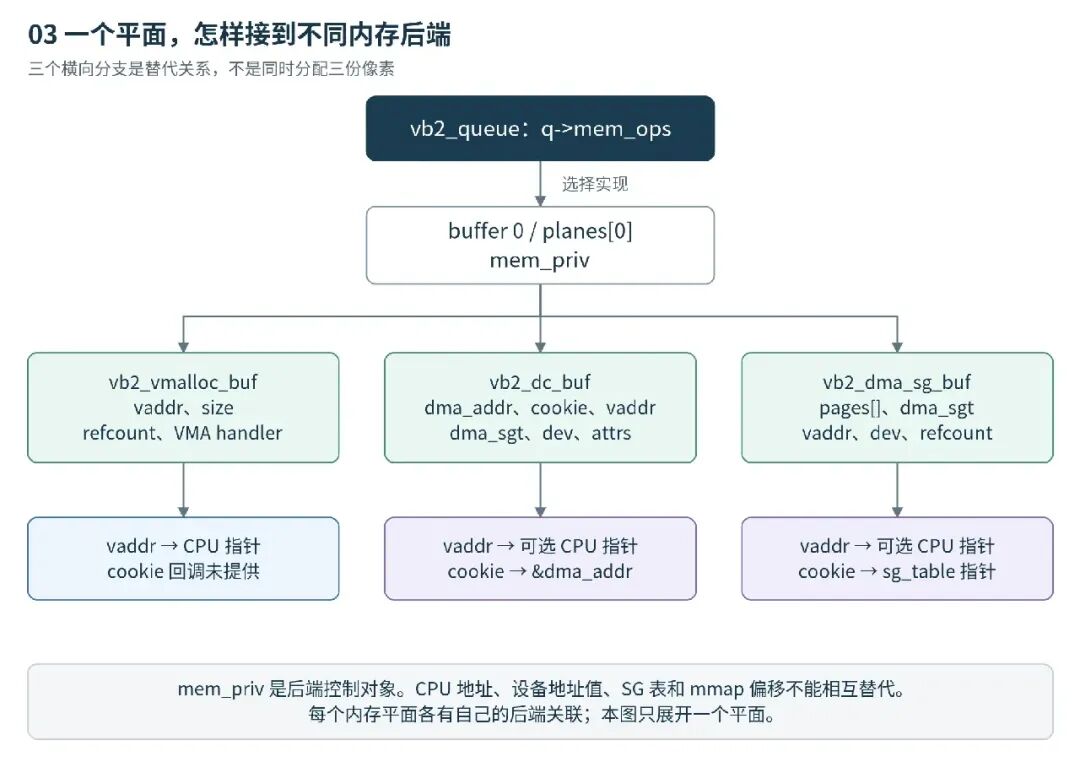
图 3:每条横向分支表示选定的一个后端,不是同一平面同时分配三份存储。图中只列本篇需要的成员。
vmalloc 对象保存 vaddr;dma-contig 对象还保存 dma_addr、DMA 属性及分配分支;dma-sg 对象保存页数组和映射后的 SG 表。VB2 核心不需要理解这些结构的全部字段,它把同一 mem_priv 交回对应的 mmap/prepare/finish/put 等回调。
4.3 vaddr 和 cookie 是两条不同的查询接口
void *vb2_plane_vaddr(struct vb2_buffer *vb, unsignedint plane_no)
{
if (plane_no >= vb->num_planes || !vb->planes[plane_no].mem_priv)
returnNULL;

return call_ptr_memop(vaddr, vb, vb->planes[plane_no].mem_priv);

}
void *vb2_plane_cookie(struct vb2_buffer *vb, unsignedint plane_no)
{
if (plane_no >= vb->num_planes || !vb->planes[plane_no].mem_priv)
returnNULL;

return call_ptr_memop(cookie, vb, vb->planes[plane_no].mem_priv);
}
第一个接口询问后端“CPU 能不能访问这个平面”。第二个接口询问“后端约定的设备访问信息是什么”。void * 只是让不同后端共用接口,不表示返回值可以任意强转。
dma-contig 的 cookie 是 dma_addr_t 成员的地址;dma-sg 的 cookie 是 struct sg_table *;vmalloc 的操作表没有提供这个 cookie 回调。QUERYBUF 的 mmap 偏移与这里的 cookie 也不是同一对象。
4.4 dev 与 DMA 方向必须属于真实访问者
DMA 映射与具体设备相关。DMA mask、IOMMU 域、总线限制与一致性信息都从对应设备及平台配置获得。不能拿设备 A 的 DMA 地址去喂设备 B,也不能随意把一个“看起来有关联”的父设备当作 DMA master;应使用该设备驱动和总线约定的 DMA 设备对象。
队列初始化设置的方向为:
if (q->bidirectional)
        q->dma_dir = DMA_BIDIRECTIONAL;
else
        q->dma_dir = q->is_output ? DMA_TO_DEVICE : DMA_FROM_DEVICE;
普通 CAPTURE 对应设备写内存,即 DMA_FROM_DEVICE;OUTPUT 对应设备读内存,即 DMA_TO_DEVICE。方向从设备与内存之间的传输理解,不是按 open(O_RDONLY) 或应用调用 read/write 来猜。只有确有双向访问需求并满足约定时,才使用双向模式;它不是省去分析的万能设置。
实现对照:vimc_capture_add()、__vb2_buf_mem_alloc()、vb2_plane_vaddr()、vb2_plane_cookie()、vb2_core_queue_init();接口 D、E、F。
5. vmalloc 后端:先把 CPU 访问这条线走到底
5.1 分配得到的仍是一个控制对象
staticvoid *vb2_vmalloc_alloc(struct vb2_buffer *vb, struct device *dev,
unsignedlong size)
{
structvb2_vmalloc_buf *buf;

    buf = kzalloc(sizeof(*buf), GFP_KERNEL | vb->vb2_queue->gfp_flags);
if (!buf)
return ERR_PTR(-ENOMEM);

    buf->size = size;
    buf->vaddr = vmalloc_user(buf->size);
if (!buf->vaddr) {
        pr_debug("vmalloc of size %ld failed\n", buf->size);
        kfree(buf);
return ERR_PTR(-ENOMEM);
    }

    buf->dma_dir = vb->vb2_queue->dma_dir;
    buf->handler.refcount = &buf->refcount;
    buf->handler.put = vb2_vmalloc_put;
    buf->handler.arg = buf;

    refcount_set(&buf->refcount, 1);
return buf;
}
函数先分配 struct vb2_vmalloc_buf,随后调用 vmalloc_user() 建立可映射的存储。成功返回 buf,不是 buf->vaddr。后者只有通过 vb2_vmalloc_vaddr() 才作为 CPU 指针提供出去。
vmalloc_user() 建立连续的内核虚拟区间,底层物理页不必相邻。它提供适于映射到应用的清零存储,但清零不是采集完成标志。沿用 921600 字节和 4096 字节页的例子,一个平面逻辑上覆盖 225 页;这些页的物理位置不由这个页数决定。
q->dma_dir 在这里被记录,并不表示分配函数已经为某颗设备建立了 DMA 映射。该函数没有调用 dma_map_*()。
5.2 mmap 仍映射同一份存储
vb2_vmalloc_mmap() 调用 remap_vmalloc_range(),将这组页接到应用的 VMA,然后设置 vb2_common_vm_ops 并执行其 open 回调,增加后端引用。对 CPU 来说,应用与内核各有一条虚拟访问路径,底层存储可以相同。
vb2_vmalloc_memops 没有直接提供 prepare、finish 和 cookie 回调。因此,在普通 vmalloc MMAP 路径上,核心调用内存准备接口,不会凭空生成 DMA 地址或额外缓存同步代码。
5.3 不能把两种相反的说法写死
“vmalloc 指针可直接做 DMA”不成立:不能将一个普通 vmalloc 区间直接作为单段 dma_map_single() 的输入,也不能对它做 virt_to_phys() 后交给设备。
“vmalloc 背后的页永远不能用于 DMA”同样不成立:正确取得页、组织 SG 并为目标设备建立映射后,这些底层页可能用于 DMA;当前 vmalloc 后端还带有配置条件下的 DMA-BUF 导出实现,可以在另一设备的 attachment 上建立 DMA 映射。那是另一条受约束的关联路径,不是普通 vaddr 自动变成设备地址。
所以,准确的结论是:普通 vmalloc MMAP 主要提供 CPU 访问,不能直接给当前驱动返回通用 DMA cookie;底层存储是否能被其他设备使用,需要额外的合法映射和同步协议。
实现对照:vb2_vmalloc_alloc/vaddr/mmap()、vb2_vmalloc_memops;接口 A。
6. dma-contig:先看分配分支,而不是先猜物理布局
6.1 一个后端同时保存两种访问表示
struct vb2_dc_buf 中,vaddr 表示可选的 CPU 映射,dma_addr 表示设备可用的 DMA 基地址,cookie 保存 DMA 分配 API 返回的句柄,dma_sgt 用于非一致性分配或外部内存关联。size、attrs、dma_dir、dev 是后续映射和释放必须配对的参数。
注意,这里又出现了一个名为 cookie 的成员。它是 dma_alloc_attrs() 返回值的保存位置,不是mem_ops->cookie() 的返回类型,也不是 mmap 的 offset。阅读时应看赋值和使用者,不凭相同单词把三者合并。
6.2 分配入口先保存属性,再选择路径
vb2_dc_alloc() 的主体节选如下:
    buf->attrs = vb->vb2_queue->dma_attrs;
    buf->dma_dir = vb->vb2_queue->dma_dir;
    buf->vb = vb;
    buf->non_coherent_mem = vb->vb2_queue->non_coherent_mem;

    buf->size = size;
/* Prevent the device from being released while the buffer is used */
    buf->dev = get_device(dev);

if (buf->non_coherent_mem)
        ret = vb2_dc_alloc_non_coherent(buf);
else
        ret = vb2_dc_alloc_coherent(buf);

if (ret) {
        dev_err(dev, "dma alloc of size %lu failed\n", size);
        kfree(buf);
return ERR_PTR(-ENOMEM);
    }

    buf->handler.refcount = &buf->refcount;
    buf->handler.put = vb2_dc_put;
    buf->handler.arg = buf;

    refcount_set(&buf->refcount, 1);
真正的分支条件是 q->non_coherent_mem。它为假时进入 vb2_dc_alloc_coherent();为真时进入 vb2_dc_alloc_non_coherent()。两个分支都会为目标设备提供 DMA 可用表示,但 CPU 映射和缓存交接方式不同。
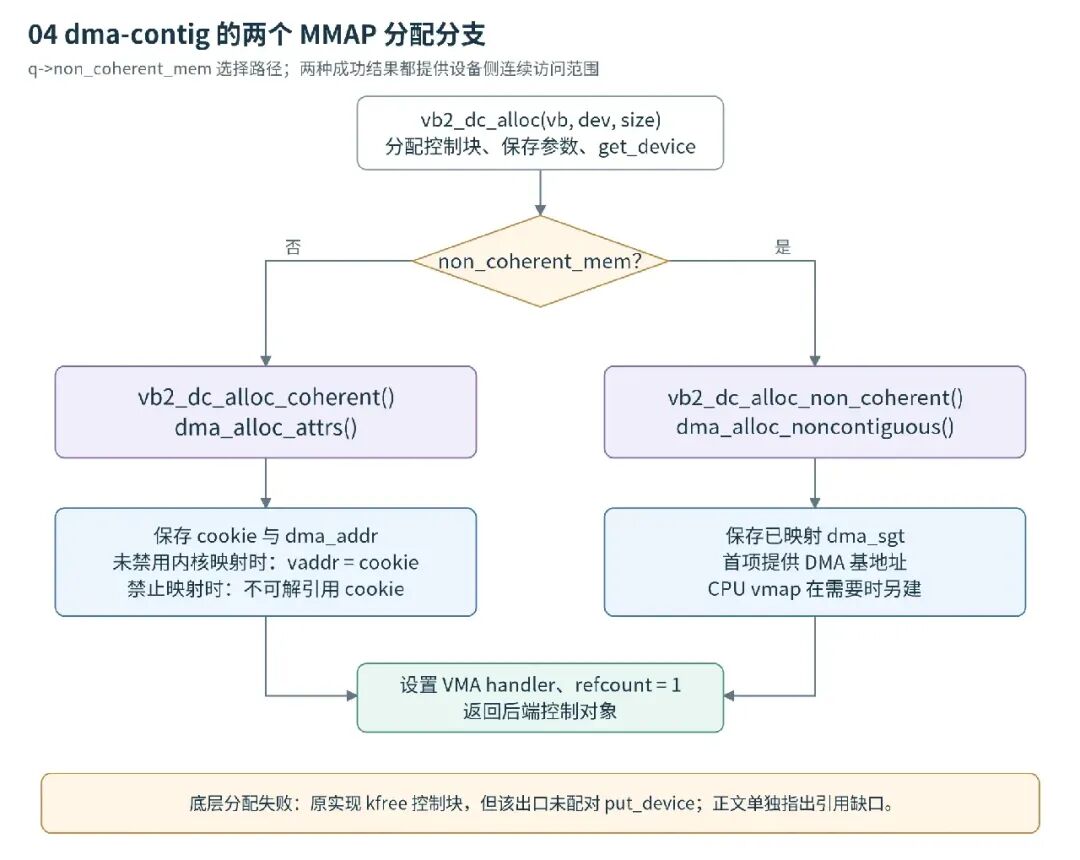
图 4:设备引用、控制块和 DMA 存储是不同资源。失败处理不能照抄成功释放的顺序;源码中的一个引用配对问题在本节末单独说明。
6.3 通常的一致性分配分支
staticintvb2_dc_alloc_coherent(struct vb2_dc_buf *buf)
{
structvb2_queue *q = buf->vb->vb2_queue;

    buf->cookie = dma_alloc_attrs(buf->dev,
                      buf->size,
                      &buf->dma_addr,
                      GFP_KERNEL | q->gfp_flags,
                      buf->attrs);
if (!buf->cookie)
return -ENOMEM;

if (q->dma_attrs & DMA_ATTR_NO_KERNEL_MAPPING)
return0;

    buf->vaddr = buf->cookie;
return0;
}
在默认属性下,dma_alloc_attrs() 建立 DMA 一致性存储,返回分配句柄并写回 dma_addr。这一步已经包含设备所需的 DMA 访问安排,驱动不应拿返回的 CPU 地址再执行一次 dma_map_single()。
没有 DMA_ATTR_NO_KERNEL_MAPPING 时,后端把 cookie 同时保存为 vaddr,允许 CPU 访问。设置该属性时,后端不把它当作可解引用的 CPU 指针;即使某个平台内部忽略该属性并返回了看起来像地址的数值,驱动也应遵守 API 的不解引用契约。
这条路径提供 DMA 连续范围,不意味着源码在这里直接调用了 CMA,更不保证所有平台底层物理页都必须连续。对额外 DMA 属性的支持仍要看相应 API 与平台;不能任意拼接属性位后假定所有分支都会按同一含义处理。
6.4 这份失败分支有一处需要单独审视
上面的实际节选先执行 get_device(dev),底层分配失败后却只 kfree(buf),未在该出口配对 put_device()。成功对象的 vb2_dc_put() 会归还设备引用,但失败时对象没有交给后续持有者,因此不能期待那个成功释放回调替它补上。
这是对本函数失败路径的静态检查结论:该出口存在设备引用配对缺口。它不等于“每次都泄漏一帧像素”,也不能据此判断某台设备已经发生了故障。阅读和移植时应核对目标树是否已修复,不把这段失败处理当作推荐模板。若在此处修正,应在控制块释放前归还已经取得的设备引用;本文保留原实现,不把修正代码冒充原文。
实现对照:vb2_dc_alloc()、vb2_dc_alloc_coherent()、vb2_dc_put();DMA 属性见接口 C。
7. 非一致性 dma-contig:物理可分散,设备仍看一个区间
7.1 这个分支怎样被选择
接口层先通过 validate_memory_flags() 检查 REQBUFS 的附加标志:只有队列允许缓存提示,并且本次是 MMAP,才保留 V4L2_MEMORY_FLAG_NON_COHERENT。核心在设置本次内存模式以后,按这个经过检查的请求决定 q->non_coherent_mem。
这个位是框架的分配策略状态,不是 CPU 是否具有一致性互连的硬件探测结果。它也不会让所有后端采用相同实现:dma-sg 自己按页分配并映射,不会因为这个位为零就自动变成 dma-contig 的一致性路径。
当前 VIMC 的初始化没有开启 allow_cache_hints。因此,不能在这份 VIMC 的标准 MMAP 请求中只填一个 NON_COHERENT 标志,就宣称已经实测了下面的分支。下面是在分析后端支持的路径,而不是给 VIMC 虚构默认行为。
7.2 dma_alloc_noncontiguous() 已经分配并映射
staticintvb2_dc_alloc_non_coherent(struct vb2_dc_buf *buf)
{
structvb2_queue *q = buf->vb->vb2_queue;

    buf->dma_sgt = dma_alloc_noncontiguous(buf->dev,
                           buf->size,
                           buf->dma_dir,
                           GFP_KERNEL | q->gfp_flags,
                           buf->attrs);
if (!buf->dma_sgt)
return -ENOMEM;

    buf->dma_addr = sg_dma_address(buf->dma_sgt->sgl);

/*
     * For non-coherent buffers the kernel mapping is created on demand
     * in vb2_dc_vaddr().
     */
return0;
}
函数得到一张 sg_table,再从它的首项取得 DMA 地址。为什么这里可以只取第一项?原因来自所使用 API 的契约:dma_alloc_noncontiguous() 成功时返回已经 DMA 映射的存储,保证设备侧一个 DMA 段,但 CPU 侧可以由多个段组成。
因此,这里的“noncontiguous”不能被直接翻译成“设备地址一定不连续”。名字描述的是允许非连续的底层存储组织;成功结果仍满足这条 API 的单段 DMA 条件。
这不是对一般 dma_map_sgtable() 的保证。后者可能返回多个映射段,不能在所有 SG 后端里照搬“取第一项就够”。同样,该分配 API 的属性支持范围有明确限制;传入的 q->dma_attrs 必须适合这个分支,不能直接照搬另一分支的所有属性。
7.3 CPU 映射按需建立,失败也必须处理
分配函数没有立即给 vaddr 赋值。第一次通过 vb2_plane_vaddr() 请求 CPU 地址时,vb2_dc_vaddr() 才可能调用 dma_vmap_noncontiguous()。
这样设备已经能够使用存储,并不要求内核预先为整帧保留一段连续 CPU 映射。应用 mmap 则通过 dma_mmap_noncontiguous() 建立自己的访问关系;它也不是复用 vaddr 指针。
按需 vmap 可能失败,并且可能需要可睡眠上下文。驱动不能把一次可能首次建立映射的 vb2_plane_vaddr() 随意放到硬中断或持自旋锁的区域。若后续 CPU 必须访问,应在适当的准备阶段取得地址并处理失败,随后严格遵守存储交接。
7.4 外部存储的连续性不是按一个段数判断
USERPTR 和 DMA-BUF 导入会拿到映射后的 SG 表。dma-contig 还用下面的函数计算从第一段开始的 DMA 连续跨度:
staticunsignedlongvb2_dc_get_contiguous_size(struct sg_table *sgt)
{
structscatterlist *s;
dma_addr_t expected = sg_dma_address(sgt->sgl);
unsignedint i;
unsignedlong size = 0;

    for_each_sgtable_dma_sg(sgt, s, i) {
if (sg_dma_address(s) != expected)
break;
        expected += sg_dma_len(s);
        size += sg_dma_len(s);
    }
return size;
}
它比较 sg_dma_address() 与前一段结尾;只要相邻 DMA 段首尾接上,就继续累计。因此,有多个 SG 条目,不一定表示设备地址有洞。 另一方面,所有段的长度加起来足够,也不代表从第一个基地址顺序访问就安全。
例如映射段依次是 (0x80000000, 8192)、(0x80002000, 4096),连续跨度为 12288 字节。如果第二段起点改成 0x80004000,中间有洞,连续跨度就只有 8192。需要 12288 字节的平面不能据此被当成单基地址区域。
vb2_dma_contig_set_max_seg_size() 可以调整传给 DMA 层的最大段参数,使合法的合并不受过小配置阻碍;它不会填平真实的地址洞,也不会让硬件获得更大的寻址能力。只能按设备及平台实际支持范围配置。
实现对照:validate_memory_flags()、set_queue_coherency()、vb2_dc_alloc_non_coherent()、vb2_dc_vaddr()、vb2_dc_get_contiguous_size();接口 B、E。
8. dma-sg:先组织内存页,再建立设备映射
8.1 页、原始 SG 段和映射后的 DMA 段
dma-sg 的私有对象 vb2_dma_sg_buf 保存 pages[]、num_pages、内嵌的 sg_table、当前使用的 dma_sgt、可选 vaddr 和 DMA 方向。MMAP 分配时,dma_sgt 指向自己的 sg_table;导入 DMA-BUF 时,它可以改指向外部映射得到的表。
这几个数量不能混淆:内存页数描述取得多少页;orig_nents 描述原始 SG 条目数;nents 描述 DMA 映射后的段数。相邻页可以先合并成一个原始 SG 条目,DMA 映射又可能进一步合并,也可能因设备限制保留多个段。
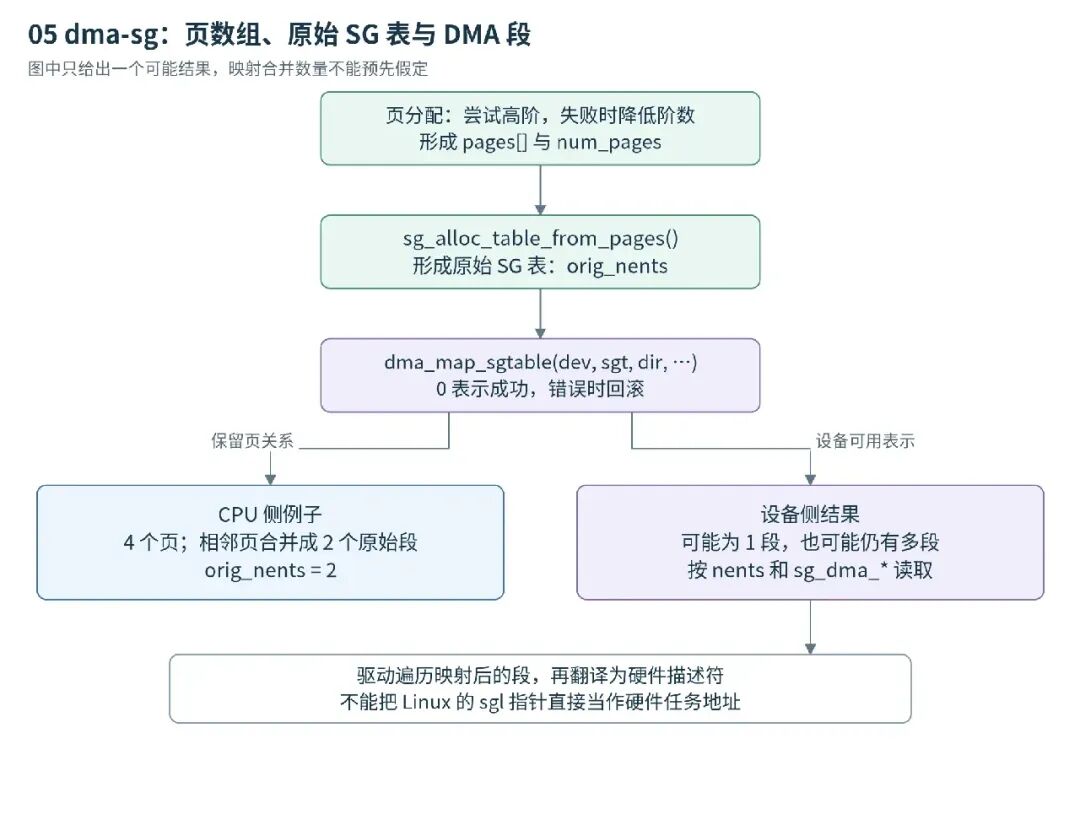
图 5:四页、两个原始条目和一至多个 DMA 段是示意布局。是否合并以及合并到几段,必须看本次映射结果。
8.2 页分配并不是固定一页一次
vb2_dma_sg_alloc_compacted() 根据剩余大小尝试合适的高阶页分配,失败后降低 order;成功后拆成可逐页管理的记录,写入 pages[]。这样可能得到较大的物理连续片段,减少 SG 条目,但不会承诺整帧物理连续。
这也不等于“主动搬动其他页进行内存整理”。函数是在尝试不同阶数的分配;底层分配器是否发生其他操作,要看其实现和 GFP 条件。
如果降到 order 0 仍失败,它释放已经取得的页并报错。成功取得全部页之后,外层才调用 sg_alloc_table_from_pages() 建立原始表。
8.3 dma_map_sgtable() 改变的是设备可访问表示
以下是 vb2_dma_sg_alloc() 中的连续节选:
    ret = sg_alloc_table_from_pages(buf->dma_sgt, buf->pages,
            buf->num_pages, 0, size, GFP_KERNEL);
if (ret)
goto fail_table_alloc;

/* Prevent the device from being released while the buffer is used */
    buf->dev = get_device(dev);

    sgt = &buf->sg_table;
/*
     * No need to sync to the device, this will happen later when the
     * prepare() memop is called.
     */
if (dma_map_sgtable(buf->dev, sgt, buf->dma_dir,
                DMA_ATTR_SKIP_CPU_SYNC))
goto fail_map;
这一层先持有 dev,再对 SG 表做 DMA 映射。成功以后,驱动读取的是 sg_dma_address() 和 sg_dma_len(),而不是把 sg_page() 得到的物理布局直接交给硬件。
dma_map_sgtable() 成功返回 0,失败返回错误;它和返回有效段数量的 dma_map_sg() 不是同一种返回约定。使用 table 接口时,映射结果数量保存在表中。读取设备段用 for_each_sgtable_dma_sg(),撤销和同步仍交给匹配的 table API;不要把两套接口的计数规则混用。
这里使用 DMA_ATTR_SKIP_CPU_SYNC,表示这次建映射不重复执行那一步 CPU 交接。代码注释已给出后续责任:真正交给设备前,prepare() 会处理同步。它不是永久关闭缓存一致性处理的许可。
8.4 dma-sg 没有承诺一致性分配
本函数直接用页分配器取得内存,并明确不按上层 DMA allocation attributes 提供一致性分配保证。队列选择 dma-sg,不等于可任意启用 DMA_ATTR_NO_KERNEL_MAPPING、WRITE_COMBINE 等属性并期待相同效果;必须读这个后端实际上消费了哪些参数。
同样,dma-sg 需要硬件及驱动能够处理本次映射结果。硬件不支持多段且映射确实返回多个不连续 DMA 段时,不能只把首段地址当作整帧基地址。成功分配内存和设备能够执行传输,是两个条件。
8.5 CPU 与应用映射分别建立
需要 CPU 地址时,vb2_dma_sg_vaddr() 对普通 MMAP 存储按需使用 vm_map_ram() 把页数组接成连续内核虚拟区间。应用 mmap 则通过 vm_map_pages() 建立 VMA 映射。两者都不会把 SG 表本身映射成图像。
这些 CPU 访问路径也需要正确的上下文与缓存交接。即使存在长期有效的 vaddr,设备当前正在写入时,也不能由另一个 CPU 路径随意读取成品图像。
实现对照:vb2_dma_sg_alloc_compacted/alloc/vaddr/mmap();段迭代与计数见接口 G、H。
9. 驱动怎样把后端结果交给硬件
9.1 dma-contig 提供的是一个 DMA 地址值
后端的 cookie 实现是:
staticvoid *vb2_dc_cookie(struct vb2_buffer *vb, void *buf_priv)
{
structvb2_dc_buf *buf = buf_priv;

return &buf->dma_addr;
}
可以看到它返回 &buf->dma_addr,也就是保存 DMA 地址的成员地址。配套的 vb2_dma_contig_plane_dma_addr() 会取出这个值。驱动取得的最终类型是 dma_addr_t,而不是 cookie 指针本身。
在确认使用 dma-contig、平面已成功建立的前提下,典型接口片段是:
/* 示意:放在设备驱动已有的合法缓冲区路径中。 */
dma_addr_t addr = vb2_dma_contig_plane_dma_addr(vb, plane);
unsignedlong capacity = vb2_plane_size(vb, plane);

/* 下一步由设备驱动校验本次任务长度、对齐和地址位宽。
 * 之后才按该硬件协议写寄存器或构造描述符。
 * 不在这里再次 dma_map_single(),也不由这里释放后端地址。
 */
不能为了“兼容 32 位寄存器”直接把地址截断成 u32。先在设备初始化阶段设置并检查真实支持的 DMA mask,再按硬件地址字段编码。DMA 地址数值为零也不天然表示失败;失败判断应遵循取得地址的 API 和前置分配结果。
9.2 dma-sg 提供的是一张已经映射的表
staticvoid *vb2_dma_sg_cookie(struct vb2_buffer *vb, void *buf_priv)
{
structvb2_dma_sg_buf *buf = buf_priv;

return buf->dma_sgt;
}
配套的 vb2_dma_sg_plane_desc() 返回这个表。驱动按设备侧条目读取地址和长度:
/* 示意:已确认后端为 dma-sg,平面有效且已建立 DMA 映射。 */
structsg_table *sgt = vb2_dma_sg_plane_desc(vb, plane);
structscatterlist *sg;
unsignedint i;

for_each_sgtable_dma_sg(sgt, sg, i) {
dma_addr_t addr = sg_dma_address(sg);
unsignedint length = sg_dma_len(sg);

/* 将 addr、length 按设备格式翻译成描述符。
     * 如有单描述符长度/边界限制,需要进一步合法拆分。
     * 这些值不是 CPU 指针,不应交给 memcpy()。
     */
}
这段只是接口示意,不是可以直接加载的设备驱动。真正实现还要检查描述符容量、每段边界、尾段有效长度、图像 stride、启动条件和错误回滚。sgt->sgl 指向 Linux 的管理结构,也不能未经翻译就写进设备的“硬件描述符首地址”寄存器。
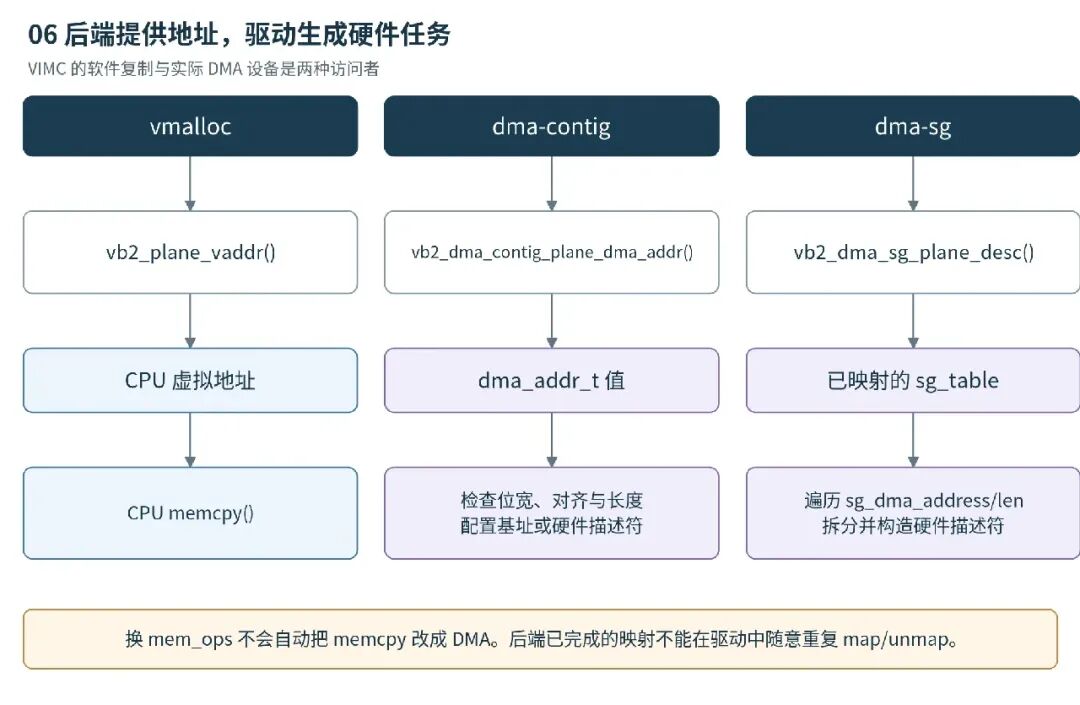
图 6:内存后端止于合法访问表示,实际任务仍由采集驱动构造。CPU 地址、DMA 地址值和 SG 表指针在图中分开传递。
9.3 不要把地址取得当成再次映射
调用 vb2_plane_cookie() 或对应的 typed helper,通常是在取得已经存在的访问表示,不是每次 QBUF 再做一次全新 DMA map。dma-sg 的 MMAP 映射在分配阶段建立;dma-contig 的两个 MMAP 分配 API 也已经建立相应设备访问安排。
驱动拿到后端提供的 DMA 地址后,不应另外 unmap 同一对象,也不应在中断里绕过 VB2 直接释放存储。否则,后端记录的映射和引用仍然存在,下一轮使用或最终 put 就会失配。
10. 一轮采集中的缓存交接,究竟发生在哪里
10.1 buf_prepare 和内存 prepare 不是同一个回调
在未 prepared 的普通 MMAP 提交中,__prepare_mmap() 先整理内部描述,再调用驱动的 ops->buf_prepare()。驱动检查容量、布局等要求;成功后,__buf_prepare() 才调用 __vb2_buf_mem_prepare(),逐平面进入内存后端的 prepare()。
这意味着需要由 CPU 整理的本轮内容,应当在交给设备的内存 prepare 之前完成。不能因为 buf_queue() 也在驱动里,就把任意 CPU 改写拖到那个阶段。显式 PREPARE_BUF 提前执行这些准备,后面的 QBUF 可能复用结果。
10.2 正常完成先收尾内存,再发布结果
驱动先确认本轮设备访问结束,再调用 vb2_buffer_done(DONE/ERROR)。该函数在把对象发布到 done_list 之前执行内存 finish()。之后应用 DQBUF,框架再调用驱动的 ops->buf_finish() 等收尾。
因此,通常的顺序是:
CPU/应用使用存储
    → 驱动 buf_prepare:检查与设备相关准备
    → 内存 prepare:按后端规则交给设备
    → buf_queue:驱动接收,可等待或开始实际处理
    → 硬件本轮访问结束
    → 驱动调用 buffer_done
    → 内存 finish:按后端规则交回 CPU
    → 发布完成对象并唤醒
    → DQBUF 中的驱动 buf_finish
    → 应用取回结果,处理完再次提交
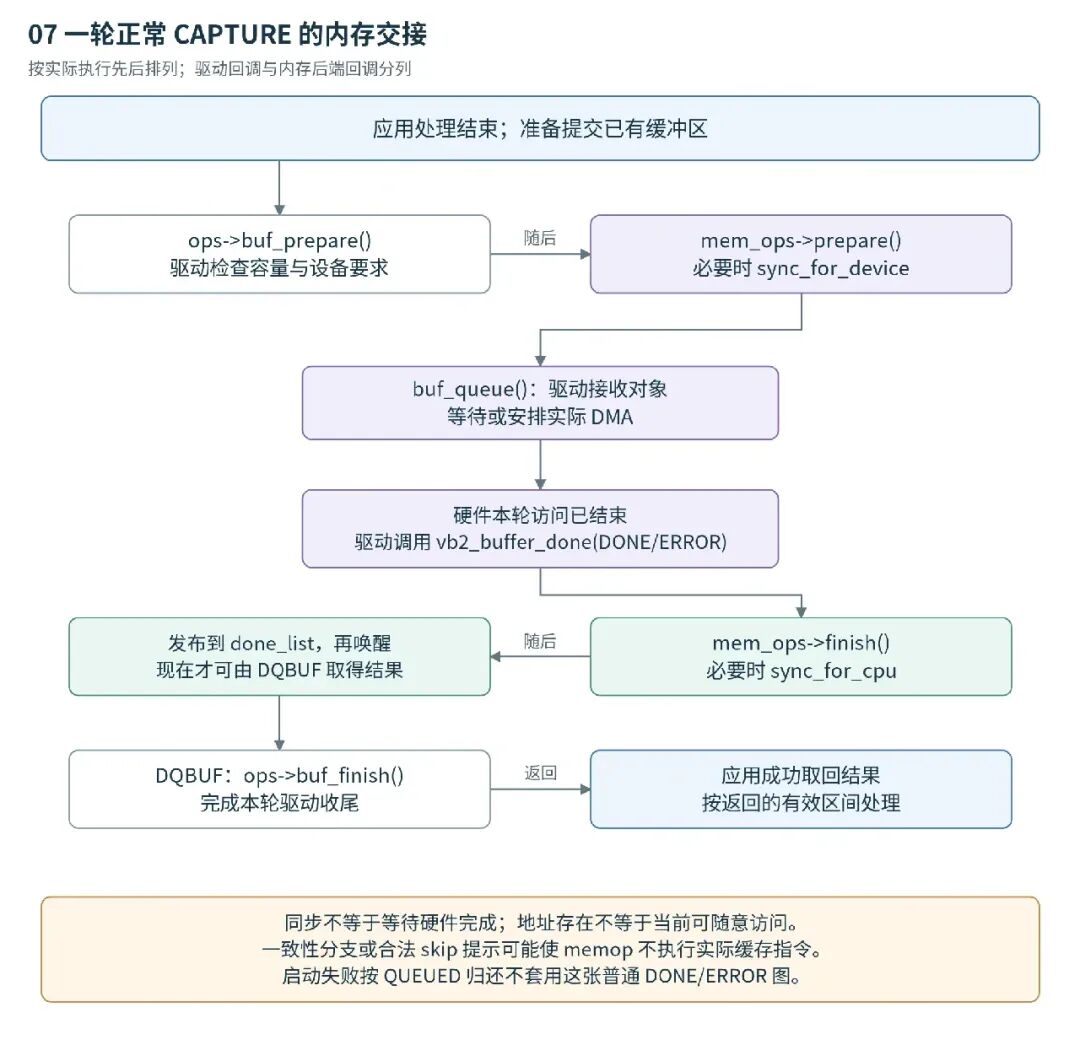
图 7:只画普通成功 CAPTURE 路径。准备、设备完成、内存同步和应用取回是不同的时刻;图中 memop 可能因后端或合法提示而不执行实际缓存指令。
启动失败按 QUEUED 归还时,不走普通完成分支的内存 finish;prepared 与 synced 的回收要由相应取消流程处理。这条分支不能强行套进正常 DONE 时序。
10.3 synced 配对的是调用,不是检测缓存硬件
staticvoid __vb2_buf_mem_prepare(struct vb2_buffer *vb)
{
unsignedint plane;

if (vb->synced)
return;

    vb->synced = 1;
for (plane = 0; plane < vb->num_planes; ++plane)
        call_void_memop(vb, prepare, vb->planes[plane].mem_priv);
}
staticvoid __vb2_buf_mem_finish(struct vb2_buffer *vb)
{
unsignedint plane;

if (!vb->synced)
return;

    vb->synced = 0;
for (plane = 0; plane < vb->num_planes; ++plane)
        call_void_memop(vb, finish, vb->planes[plane].mem_priv);
}
核心用 synced 避免同一轮重复 prepare 或 finish。即使某后端没有对应回调,这个位也会变化。不能把 synced == 1 翻译成“所有 CPU 和所有设备现在看到完全相同的字节”,更不能把它当作跨设备同步完成标志。
10.4 dma-sg:同步一张持续存在的 DMA 映射
staticvoidvb2_dma_sg_prepare(void *buf_priv)
{
structvb2_dma_sg_buf *buf = buf_priv;
structsg_table *sgt = buf->dma_sgt;

if (buf->vb->skip_cache_sync_on_prepare)
return;

    dma_sync_sgtable_for_device(buf->dev, sgt, buf->dma_dir);
}
staticvoidvb2_dma_sg_finish(void *buf_priv)
{
structvb2_dma_sg_buf *buf = buf_priv;
structsg_table *sgt = buf->dma_sgt;

if (buf->vb->skip_cache_sync_on_finish)
return;

    dma_sync_sgtable_for_cpu(buf->dev, sgt, buf->dma_dir);
}
函数先检查相应跳过标志,否则调用 dma_sync_sgtable_for_device/cpu()。DMA 映射可以跨多轮 QBUF/DQBUF 保持,交接时进行必要同步。流式 DMA 不要求每帧重新分配,也不要求每帧一定 unmap 再 map。
CAPTURE 的映射方向是 FROM_DEVICE,并不意味着提交前的 prepare 永远可以删除。设备写入前仍可能需要处理 CPU 侧缓存状态;具体指令由 DMA API 和平台决定。不要将架构无关代码改写成某个平台经验中的固定 clean/invalidate 顺序。
10.5 dma-contig:先看一致性,再看 CPU 映射
staticvoidvb2_dc_prepare(void *buf_priv)
{
structvb2_dc_buf *buf = buf_priv;
structsg_table *sgt = buf->dma_sgt;

/* This takes care of DMABUF and user-enforced cache sync hint */
if (buf->vb->skip_cache_sync_on_prepare)
return;

if (!buf->non_coherent_mem)
return;

/* Non-coherent MMAP only */
if (buf->vaddr)
        flush_kernel_vmap_range(buf->vaddr, buf->size);

/* For both USERPTR and non-coherent MMAP */
    dma_sync_sgtable_for_device(buf->dev, sgt, buf->dma_dir);
}
staticvoidvb2_dc_finish(void *buf_priv)
{
structvb2_dc_buf *buf = buf_priv;
structsg_table *sgt = buf->dma_sgt;

/* This takes care of DMABUF and user-enforced cache sync hint */
if (buf->vb->skip_cache_sync_on_finish)
return;

if (!buf->non_coherent_mem)
return;

/* Non-coherent MMAP only */
if (buf->vaddr)
        invalidate_kernel_vmap_range(buf->vaddr, buf->size);

/* For both USERPTR and non-coherent MMAP */
    dma_sync_sgtable_for_cpu(buf->dev, sgt, buf->dma_dir);
}
一致性分支在这里返回,不重复执行非一致性维护;非一致性分支在存在内核 vmap 时处理对应虚拟映射范围,再调用 DMA table 同步。正文按代码保留这两段的先后顺序,不把它改写成所有平台都通用的一条手工刷缓存模板。
这些调用处理可见性,不负责确认 DMA 已经停止,也不负责锁住其他访问者。设备停止、描述符顺序、共享存储的使用权仍须由对应协议保证。
实现对照:__buf_prepare()、__prepare_mmap()、vb2_buffer_done()、vb2_core_dqbuf() 及两个 DMA 后端的 prepare/finish。
11. 缓存提示不能当作无条件加速开关
11.1 哪些路径会跳过后端同步
初始化缓冲区时,这份核心实现为 DMA-BUF 导入设置两个 skip 标志,把相应缓存责任留给共享缓冲区协议;对 DMA_TO_DEVICE,也设置 finish 跳过提示,因为该方向约定设备只读。
应用提出的 V4L2_BUF_FLAG_NO_CACHE_CLEAN 和 V4L2_BUF_FLAG_NO_CACHE_INVALIDATE 则需要队列允许缓存提示且处于相应 MMAP 场景。接口层不能识别或不允许的请求会被清理。普通应用不应为了追求速度盲目打开它们。
V4L2_MEMORY_FLAG_NON_COHERENT 控制允许的分配策略,两个 NO_CACHE 标志控制某些交接操作,q->dma_attrs 又属于驱动交给 DMA 分配层的属性。它们不是三个同义字段。
11.2 DMA-BUF 的跳过不表示“已经自动同步一切”
当前 VB2 核心的 skip 策略,只说明这一层不重复做那些后端操作。谁等待生产设备结束、谁开始 CPU 访问、谁等待消费设备完成,仍要沿 DMA-BUF 导出者、导入者和使用方的同步约定核对。
长期保留 attachment 和 DMA 映射,不等于允许设备永久并发访问。CPU 映射的开始/结束同步,与等待设备完成也不是同一件事。后续 DMA-BUF 专题会单独追踪,本篇不把“共享同一个 fd”作为无竞争的证明。
11.3 VIMC 不能替代非一致性硬件测试
VIMC 当前填帧路径由 CPU 执行复制,没有真实 DMA 在另一条访问路径上写入。即使它能够切到 dma-contig,也不能用一次软件采集成功证明目标 SoC 的非一致性缓存、IOMMU 域或硬件停流处理正确。
尤其不能把这段软件填帧函数机械挂接到任意非一致性 DMA 后端,然后认为已有 prepare/finish 时序天然适合 CPU 生产者。分析同步前必须先确认实际是谁读写,不能只看队列标为 CAPTURE。
实现对照:init_buffer_cache_hints()、set_buffer_cache_hints()、validate_memory_flags();共享存储协议见接口 I。
12. mmap 和 put:访问关系与存储寿命怎样结束
12.1 三个后端使用各自的映射入口
vmalloc 通过 remap_vmalloc_range() 映射已有 vmalloc 存储;dma-contig 根据一致性分支调用 dma_mmap_attrs() 或 dma_mmap_noncontiguous();dma-sg 通过 vm_map_pages() 映射页数组。
DMA 后端的应用映射应使用与其分配相匹配的接口,以保留相应内存属性和平台规则。不能拿着一个 DMA 地址,把它当作 CPU 物理地址自行 remap_pfn_range(),也不能强行再建一条缓存属性不兼容的 CPU 别名。
这些后端随后都使用公共 VMA handler 管理引用。显式执行 vm_ops->open() 是增加本次映射的后端持有关系,不是重新执行视频节点的 open,更不是再次取得设备采集权。
12.2 最后一次引用归还,才执行真正的后端释放
以下是 vmalloc 的完整 put:
staticvoidvb2_vmalloc_put(void *buf_priv)
{
structvb2_vmalloc_buf *buf = buf_priv;

if (refcount_dec_and_test(&buf->refcount)) {
        vfree(buf->vaddr);
        kfree(buf);
    }
}
dma-contig 和 dma-sg 同样先判断引用。普通 MMAP 情况下,三者的最终资源配对可以概括为:
vfree() | |
dma_free_attrs()。 | |
dma_free_noncontiguous()。 | |
dma_unmap_sgtable() | |
put_device()。 |
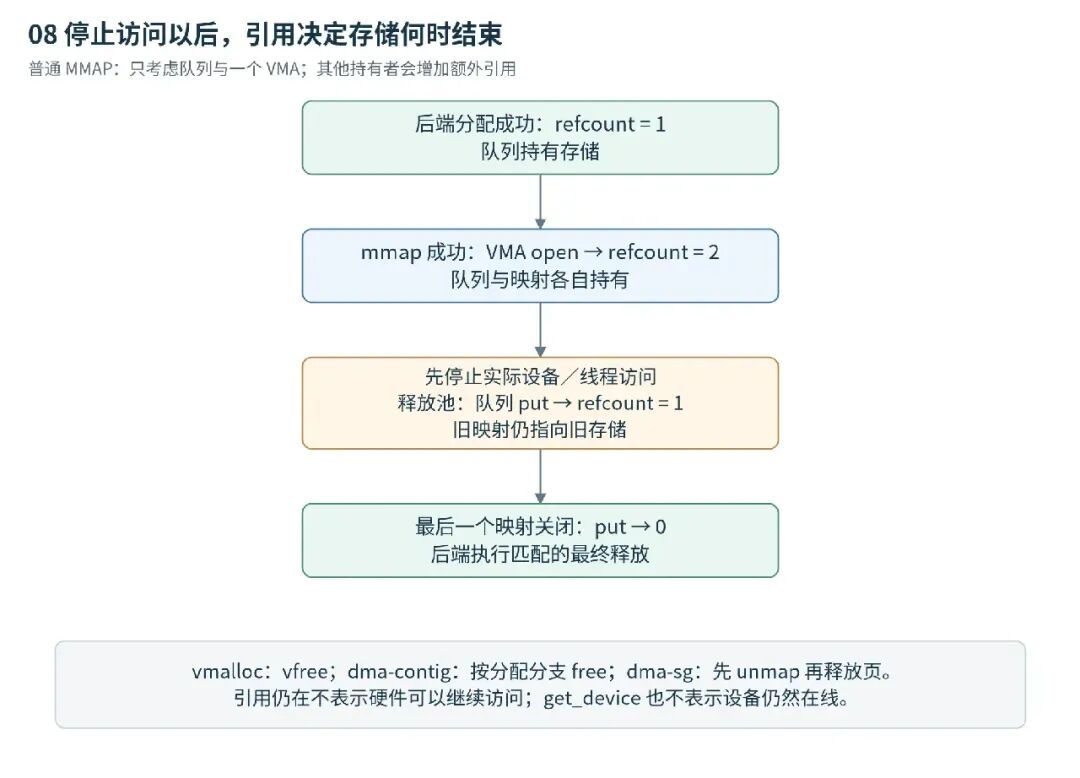
图 8:假定只存在队列与一个映射两份引用,并且已经停止实际访问。支持孤立缓冲区的释放解除队列关系,不把旧映射自动改绑到新池。
所以,释放队列对象不保证像素内存当场消失。映射、导出对象或其他合法持有关系还在时,后端存储可能继续存在;设备却必须在宣布归还本轮缓冲区之前结束访问。引用计数能防止过早释放,不能替代停 DMA。
12.3 设备对象仍在,不代表硬件还在线
后端 get_device() 保证的是设备模型对象不会因这份引用而过早销毁,不等于断开以后设备仍可进行总线访问。热拔插、IOMMU 上下文退出、异步任务停止和内存释放要遵守设备驱动的整体退出次序。
本节表格针对各后端自己的 MMAP 分配。USERPTR、DMA-BUF 导入有各自的 put/unmap/detach 配对,不能把 MMAP 的最终释放函数直接调用到另一类后端对象上。
13. 分配失败时,从最后取得的资源倒着检查
13.1 dma-sg 的回滚是分层的
vb2_dma_sg_alloc() 最后的失败出口是:
fail_map:
    put_device(buf->dev);
    sg_free_table(buf->dma_sgt);
fail_table_alloc:
    num_pages = buf->num_pages;
while (num_pages--)
        __free_page(buf->pages[num_pages]);
fail_pages_alloc:
    kvfree(buf->pages);
fail_pages_array_alloc:
    kfree(buf);
return ERR_PTR(-ENOMEM);
页数组分配失败,只需释放控制块;页获取失败,由其内部回收已经取得的页,外层释放页数组;SG 表已建立而 DMA map 失败,则先归还设备引用、释放 SG 表,再释放页与其他对象。
注意,DMA map 失败时没有一份成功映射可供正常 unmap,不能不分阶段执行同一套清理。已经成功返回给 VB2 的对象,则由引用归零时的 put 结束;这与分配自身失败的回滚不是同一入口。
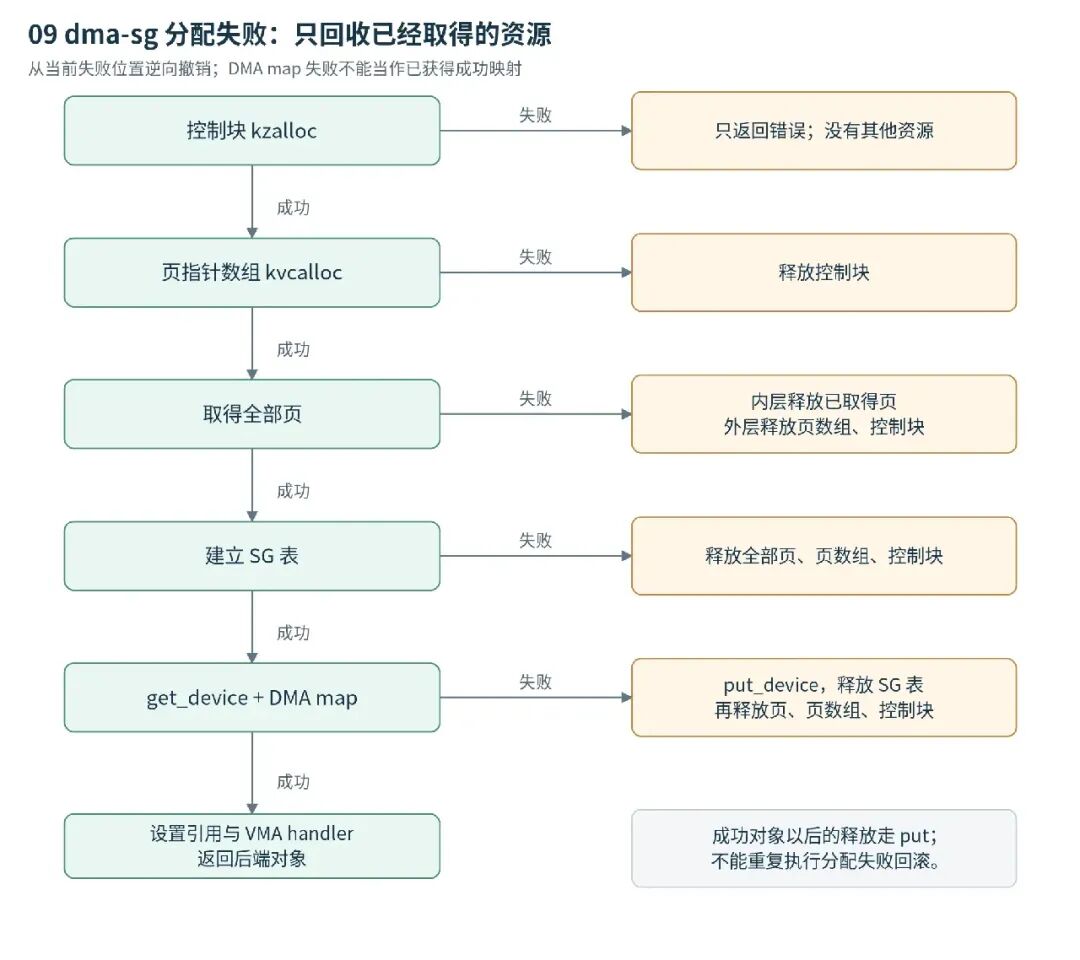
图 9:每一步失败只回收已经成功取得的资源。页分配内部回滚与外层回滚分开,避免重复释放。dma-contig 的设备引用缺口不能从本图类推为已修复。
13.2 上层 errno 不一定保留底层全部原因
后端可能把多类分配失败统一返回为 -ENOMEM。更上层的 REQBUFS 还会根据成功缓冲区数量决定接受较小池还是整体失败。最终只看到 ENOMEM,不能直接断定是物理 RAM 不够。
应先区分:控制对象失败、页取得失败、SG 表失败、DMA 地址空间或设备映射失败、CPU vmap 失败、应用 mmap 失败。IOMMU 空间、DMA mask、分配属性、连续跨度与实际存储容量分别属于不同检查点。
同样,CPU 映射失败不必然意味着 DMA 存储不存在。某些分支已经具备设备地址,只是在请求额外 CPU 视图时失败;释放时仍必须撤销之前成功建立的资源。
14. 将这些结论落到驱动选择和排障中
14.1 后端选择先服从访问者和硬件约束
如果主要由 CPU 生成或消费图像,并且不需要当前设备的 DMA cookie,vmalloc 是清晰的分析起点。硬件只接受单基地址连续范围时,应选择能满足设备 DMA 连续性的机制,并确认实际分配或导入结果。硬件及驱动能处理 SG 任务时,dma-sg 可以提供映射段,但仍要检查数量和边界。
这些判断不是性能排名。物理碎片、IOMMU 支持、CPU 映射成本、缓存属性、硬件段限制和共享需求共同影响结果。不能简单宣称 dma-sg 一定更快、dma-contig 一定来自 CMA,或一致性存储一定更适合大图像。
14.2 地址配置应当早于队列投入使用
设备初始化阶段需要设置并检查实际支持的 DMA mask。示意如下,bits 必须来自真实硬件能力,不应直接照抄 32 或 64:
/* 示意:dma_dev 为实际 DMA master 对应的设备。 */
ret = dma_set_mask_and_coherent(dma_dev, DMA_BIT_MASK(bits));
if (ret)
return ret;

q->dev = dma_dev;
/* 再按设备访问方式选择 mem_ops,准备其余队列字段。 */
有些设备的一致性描述符和数据缓冲区地址能力不同,需要分别设置 coherent 与 streaming mask。设置成功也不能替代描述符字段宽度、边界和长度校验。
14.3 实际排障时先记录什么
建议在允许睡眠的准备阶段、而不是高频中断里,短时间记录平面容量、所选后端、DMA 方向、分配策略以及取得的地址或映射段。DMA 地址使用内核 %pad 格式并传入 dma_addr_t 对象地址;不要用 %p 或截断后的十六进制数代替。
vb2_plane_cookie() | |
驱动日志中的地址和内存布局可能涉及运行时信息,应限定在测试环境中,不作为长期对外接口。调试 DMA API 的分配/映射配对时,可以在合适测试内核上启用对应调试配置;这能发现部分 API 误用,但不能证明像素时序和硬件逻辑都正确。
14.4 三个可手工验证的问题
问题一:两个 DMA 段长度分别为 8192 和 4096,总长够 12288,是否就能交给只接受一个基地址的设备?
还要检查第二段是否紧接第一段,并确认硬件其他限制。总长度足够不能证明中间没有 DMA 地址洞。
问题二:dma-sg 的 orig_nents=6、nents=3,应建立六个还是三个设备段?
遍历映射后的三个 DMA 段,再按硬件规则转换和必要拆分;不能把原始页段当成最终 DMA 描述。匹配的 unmap/sync table API 自行使用正确的表信息。
问题三:dma-contig 分配成功,但 vb2_plane_vaddr() 返回 NULL,是不是可以重新 dma_map_single() 补救?
不可以。设备访问表示可能已经存在,只是没有 CPU 映射或 vmap 失败。需要判断是否禁止内核映射、是否处于可建映射的上下文,以及 CPU 访问是否真正必要;不能重复映射来“修复”另一类地址。
15. 回到一块图像缓冲区
现在可以把设备访问过程读成一条完整路径:
驱动选定真实 DMA 设备、能力和后端
    → VB2 为每个平面建立后端对象
    → 后端分配存储并建立必要的设备访问表示
    → 需要时分别建立内核 CPU 映射和应用映射
    → 提交时按内存契约完成交接
    → 驱动取得 DMA 地址或 SG 表,生成硬件任务
    → 设备完成实际访问
    → 后端按契约交回 CPU,VB2 发布结果
    → 应用处理后再次提交
    → 停止实际访问,解除引用,最后撤销映射与存储
最重要的不是记住哪一种后端“更高级”,而是能沿着一个平面说明:存储由谁建立,当前地址给谁用,设备为什么能够访问,什么时候允许 CPU 读取,最后由谁释放。
vmalloc、dma-contig 和 dma-sg 用不同方式回答这些问题。VB2 提供统一的交接位置,不抹平它们的地址类型、映射规则和缓存条件。下一篇讨论 USERPTR 时,将改变存储来源,但这些问题仍然成立。
实现与接口对照
本篇直接分析的实现
drivers/media/common/videobuf2/videobuf2-core.c:平面分配、地址查询、内存 prepare/finish、方向及缓存提示初始化。drivers/media/common/videobuf2/videobuf2-v4l2.c:内存属性验证与应用缓存提示。drivers/media/common/videobuf2/videobuf2-vmalloc.c:CPU 存储、应用映射、引用及共享接口边界。drivers/media/common/videobuf2/videobuf2-dma-contig.c:两条 MMAP 分配路径、DMA 连续跨度、地址取得、同步和释放。drivers/media/common/videobuf2/videobuf2-dma-sg.c:页分配、SG 构建、DMA 映射、CPU 视图、同步及失败回收。drivers/media/common/videobuf2/videobuf2-memops.c:公共 VMA 引用管理。drivers/media/test-drivers/vimc/vimc-capture.c:后端选择、队列配置与 CPU 填帧。