ARTICLE · 1245745
Kafka源码深度剖析:RecordAccumulator 封装消息流程详解
上一篇讲了 RecordAccumulator 的整体结构和 append() 决策链。这篇往下钻:MemoryRecordsBuilder 一条 Record 怎么写进 ByteBuffer、ProducerBatch 的状态怎么流转、Sender.drain() 怎么把 ready 批次按 Broker 分组发出去。
上一篇讲了什么
上一篇讲了 RecordAccumulator 的"骨架":每分区一个 Deque、BufferPool 管内存、IncompleteBatches 管在途批次。但有几个问题没回答:
一条 Record 写进 ByteBuffer 的具体过程是什么?
一个 ProducerBatch 从创建到释放,经历哪些状态?
Sender 怎么知道哪些批次 ready、怎么按 Broker 拼请求?
这篇把这三个问题讲透。
01 MemoryRecordsBuilder:一条 Record 怎么写进 ByteBuffer
append() 最终调用的是 MemoryRecordsBuilder.append()。这个方法干了五件事:
第一步:算大小。 这条 Record 占多少字节?长度头 + attributes + timestampDelta + key + value。算出来后看 ByteBuffer 剩余空间够不够。
第二步:预留长度位。 ByteBuffer 只能顺序写,不能回头改。所以先 putInt(0) 占位——这个位置将来存这条 Record 的总字节数。
第三步:写字段。 按顺序写 attributes、timestampDelta(varint 变长编码省空间)、keyLength + key、valueLength + value。
第四步:回填长度。 所有字段写完后,position 移回长度位,putInt(实际字节数) 覆盖掉占位的 0。
第五步:返回 RecordAppendResult。 告诉调用方:这次 append 是否成功、这个 batch 是否写满了、对应的 Future 是什么。
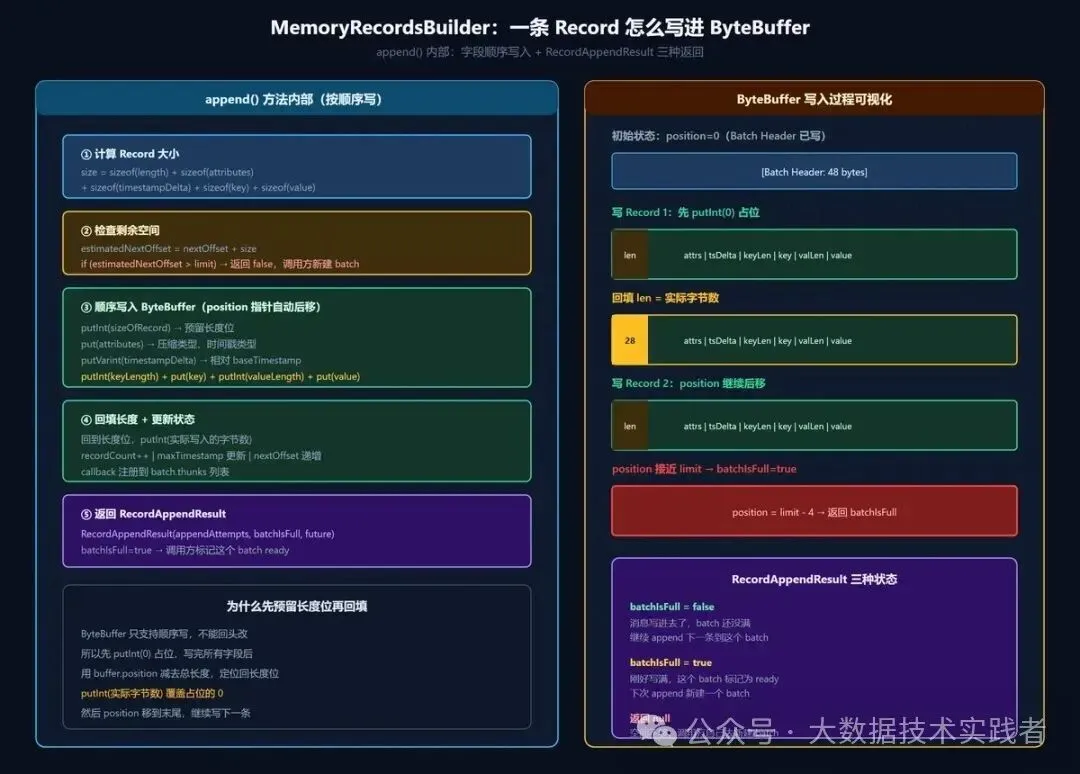
这里有个容易忽略的设计:为什么先 putInt(0) 占位再回填? 因为 ByteBuffer 是顺序指针,不能随机访问。如果一开始不知道 Record 多长(key/value 长度是变的),就得先写、写完才知道多长。所以先留个坑,写完再填上。
RecordAppendResult 有三种返回,对应三种后续动作:
batchIsFull = false:写进去了,batch 还没满,继续 append 下一条
batchIsFull = true:刚好写满,这个 batch 标记为 ready,下次 append 新建
返回 null:空间不够,调用方自己去 BufferPool 拿新块新建 batch
02 ProducerBatch 状态机:从创建到释放
一个 ProducerBatch 不是"创建了就一直活着",它有完整的生命周期:
NEW → WRITING: 刚从 BufferPool 分配 ByteBuffer,第一条消息 append 进来。此时在 Deque 队尾,业务线程继续往里写。
WRITING → READY: 两种情况触发:batch 写满,或者 linger.ms 超时到了。此时 batch 不再接收新消息,等 Sender 来拉。
READY → IN-FLIGHT: Sender.drain() 把它从 Deque 队头取出,加入 IncompleteBatches,网络请求发出去。
IN-FLIGHT → COMPLETED: ACK 成功。触发用户回调,ByteBuffer 释放回 BufferPool。
IN-FLIGHT → RETRY: ACK 失败或超时,且 retries 没耗尽。重新塞回 Deque 队头。
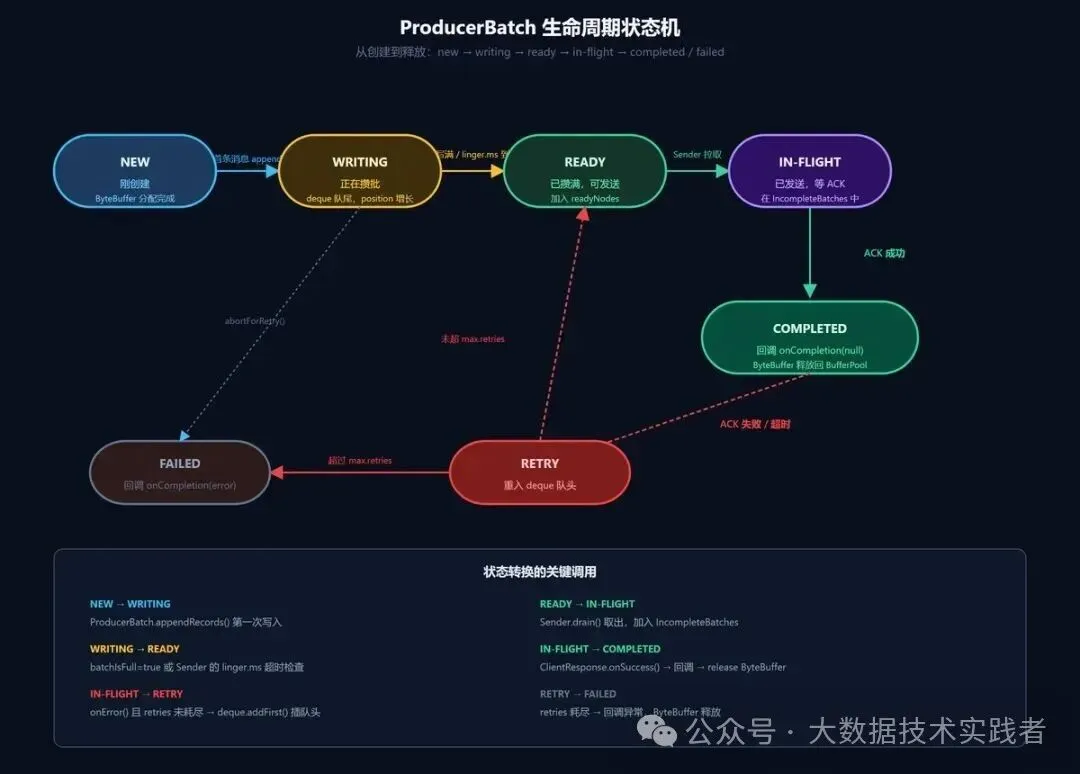
为什么重传要插队头?因为这个 batch 已经 ready,应该尽快重发。如果插队尾,后面攒的新 batch(还在 WRITING 状态)会排在它前面——新 batch 还没满,要等很久才发,重传延迟就被拉长了。Deque 的 addFirst() 是 O(1),这就是为什么用 Deque 而不是普通 Queue。
03 Sender.drain():怎么把 ready 批次按 Broker 分组
Sender 线程的主循环每轮做一件事:accumulator.drain(cluster, maxSize, deadline)。
这个方法遍历所有分区的 Deque,做三件事:
第一,只拉 ready 的。 WRITING 状态的 batch 不动,留在 Deque 队尾继续攒。只把 READY 状态的从队头 poll 出来。
第二,按 Leader 分组。 drain() 把拉出来的 batch 按 Leader 节点 ID 分组——Node-1 的所有分区的 ready batch 放一组,Node-2 的放一组。
第三,限制单请求大小。 每组里的 batch 字节数加起来不能超过 max.request.size(默认 1MB)。超了就拆成多个请求。
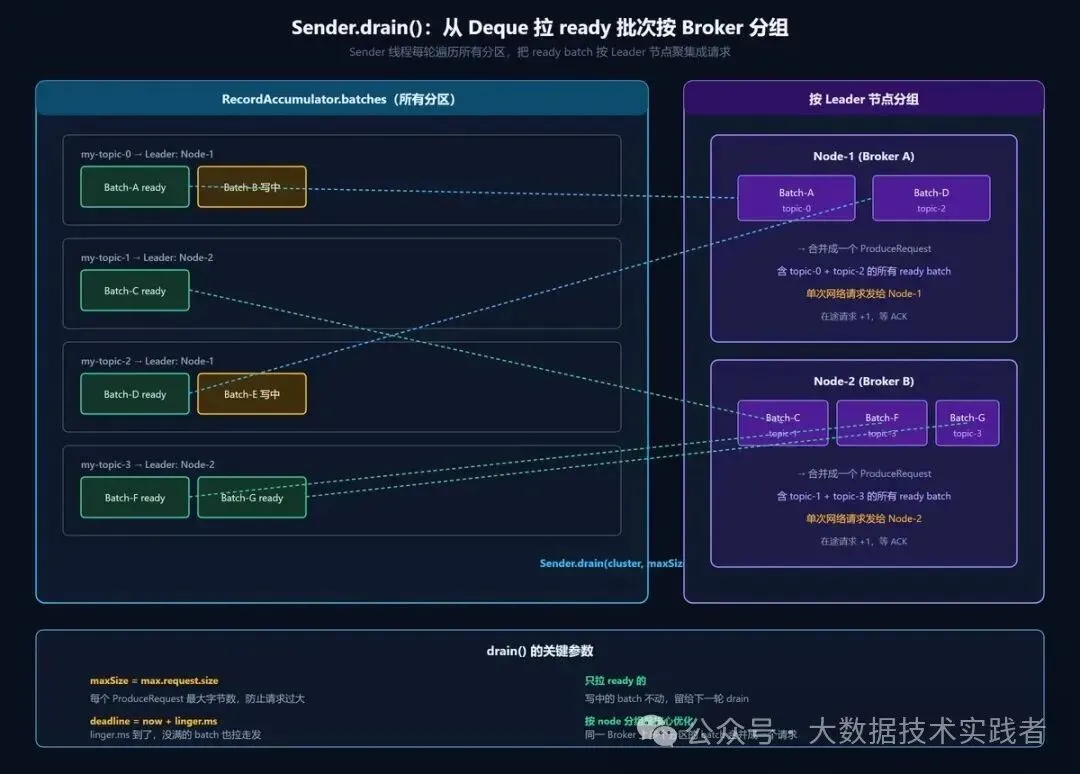
分组的意义:同一个 Broker 上,不管是 topic-0 还是 topic-2 的分区,Leader 都在 Node-1。把它们的 ready batch 合并成一个 ProduceRequest,一次网络请求发过去。如果不分组,100 个分区就是 100 次 RTT——分组后可能只要 3 次(假设 3 个 Broker)。
linger.ms 在这一步起作用:deadline = now + linger.ms。时间到了,哪怕 batch 没写满,drain() 也会把它拉走。这就是为什么设了 linger.ms=5,小流量场景不会一直等下去。
写在最后
RecordAccumulator 的"封装"不是简单的"存起来"——MemoryRecordsBuilder 处理字节写入,ProducerBatch 管理状态流转,drain() 负责按 Broker 聚合发送。三者配合,才把"一条条消息"变成"一个个批量网络请求"。
理解了这三层,就理解了为什么调 batch.size(控制 WRITING 阶段攒多大)、linger.ms(控制 READY 触发时机)、max.request.size(控制单请求多大)能影响吞吐——它们分别作用于状态机的不同节点。
下一篇讲 Sender 线程的网络层:InFlightRequests 怎么限流、Selector 怎么管理 NIO 连接、请求怎么发出去又怎么收回来。