ARTICLE · 1251388
Kafka源码深度剖析:Sender线程发送消息流程
前面九篇把业务线程的 append 链路拆完了。这篇进入 Sender 线程——KafkaProducer 唯一的网络 IO 线程。从 runOnce 循环、drain 按 Broker 分组、NetworkClient 非阻塞发送,到响应回调、重试、内存释放,完整走一遍发送链路。
为什么 Sender 是独立线程
前面讲 RecordAccumulator 时反复提到:业务线程只做 append(μs 级内存操作),网络 IO 全部交给 Sender。这个设计是 Kafka 高吞吐的基石。
如果业务线程自己发消息,一次网络 RTT 几 ms,100 个线程并发写就会有 100 条 Socket 连接,Broker 端连接数爆炸。Sender 单线程统一管理网络,连接数 = Broker 数,所有请求串行入队、按 Broker 分组批量发送——这是典型的"单线程 Reactor"模式,和 Netty、Redis 的思路一致。
01 Sender 线程的运行循环
Sender 是一个 KafkaThread,在 KafkaProducer 构造函数末尾启动:
this.sender = new Sender(logContext, client, this.metadata, this.accumulator, ...);Thread ioThread = new KafkaThread("kafka-producer-network-thread | " + clientId, sender, true);ioThread.start();
启动后进入无限循环 while (running) { runOnce() },每轮 runOnce 做四件事:
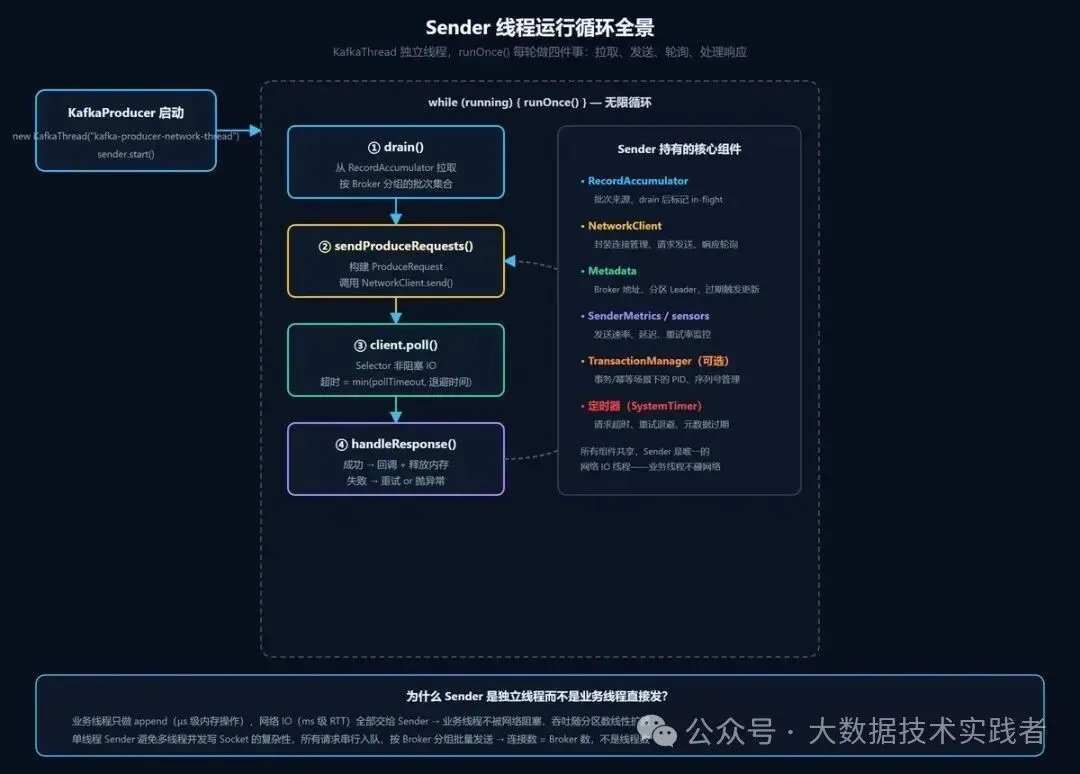
第一步 drain(): 从 RecordAccumulator 拉取可发送的批次,按 Broker 分组。drain 出来的批次从 Deque 移除,标记为 in-flight,业务线程不再能修改。
第二步 sendProduceRequests(): 把每个 Broker 的批次列表构建成一个 ProduceRequest,调用 NetworkClient.send() 封装成 ClientRequest 入队。这一步还没真正写 Socket,只是放进待发送队列。
第三步 client.poll(): 真正的网络 IO。Selector 用 NIO 非阻塞模式把待发送请求写入 Socket,同时检查是否有响应可读。poll 超时 = min(pollTimeout, 最近退避时间)。
第四步 handleResponse(): 成功 → 回调 Future + 释放内存;可重试失败 → 批次塞回 Deque 队头;不可重试 → 回调异常。
02 drain:从"按分区"到"按 Broker"的转换
drain 是 Sender 最核心的逻辑。业务线程按分区写(每个 TopicPartition 一个 Deque),但网络是按 Broker 发的——drain 做的就是这个维度转换。
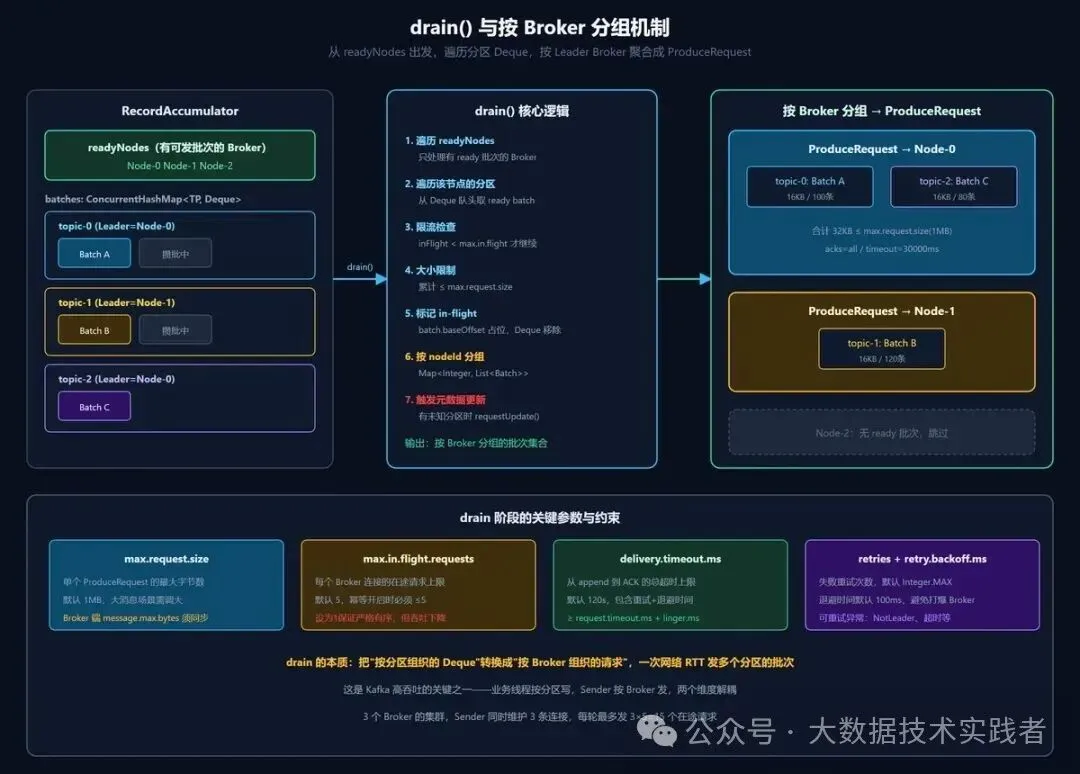
drain 的执行步骤:
1. 遍历 readyNodes(有 ready 批次的 Broker),只处理这些节点
2. 对每个节点,遍历它负责的分区,从 Deque 队头取 ready batch
3. 限流检查:in-flight < max.in.flight(默认5)才继续
4. 大小限制:累计 ≤ max.request.size(默认1MB)
5. 标记 in-flight:batch 从 Deque 移除,baseOffset 占位
6. 按 nodeId 分组:Map<Integer, List<ProducerBatch>>
7. 遇到未知分区触发 metadata.requestUpdate()
输出是按 Broker 分组的批次集合——3 个 Broker 的集群,drain 完可能 Node-0 有 2 个批次、Node-1 有 1 个、Node-2 没有。然后每个非空节点构建一个 ProduceRequest。
容易忽略的细节:drain 是按节点遍历的,不是按分区遍历。先确定哪些 Broker 有 ready 批次,再去拉对应分区。这样 in-flight 限流是节点级的,不会因为某个分区流量大就占满整个节点的配额。
03 NetworkClient:非阻塞发送与 InFlight 跟踪
sendProduceRequests 构建完 ProduceRequest 后,调用 NetworkClient.send()。这一步不写 Socket,只做两件事:把请求放进 InFlightRequests(计数+1),关联到对应的 KafkaChannel 等下一次 poll 写入。
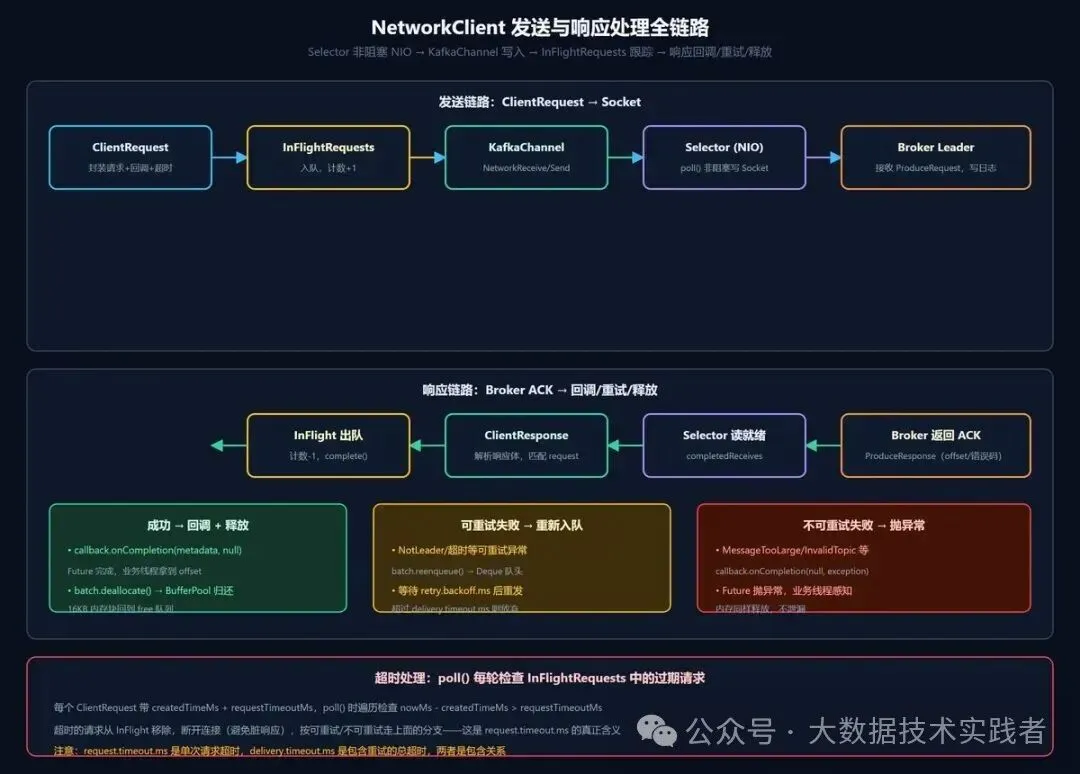
Selector 的 poll 做什么:
• pollSelectionKeys():遍历 KafkaChannel,写就绪的 channel.write(),读就绪的 channel.read()
• completedSends / completedReceives:记录写完的请求和读完的响应
• disconnected:记录断开的连接
poll 返回后,NetworkClient 遍历 completedReceives,解析成 ClientResponse,按 correlationId 从 InFlightRequests 匹配请求,调用 callback.onComplete(response)。
InFlightRequests 的三个作用:限流(每节点 ≤ max.in.flight)、超时检测(poll 时检查 requestTimeoutMs)、顺序保证(correlationId 递增,响应按序匹配)。
04 响应处理:成功、重试、失败三条路
成功(错误码=0): batch.done(offset, null) 完成 Future;accumulator.deallocate(batch) 归还 BufferPool。内存释放在 Sender 线程做,避免多线程并发操作 free 队列。
可重试失败(NotLeader、超时等): batch.reenqueue() 塞回 Deque 队头(addFirst 插队头,重传优先),等待 retry.backoff.ms 后下一轮重发。总超时受 delivery.timeout.ms 限制。
不可重试失败(MessageTooLarge 等): batch.done(-1, exception) 回调异常,deallocate 照样释放内存——不泄漏是底线。
05 超时处理:两个 timeout 的区别
这两个参数容易混淆,明确区分:
request.timeout.ms(默认30s):单次请求超时。从发出到收到响应的时间,超过就断开连接按失败处理,可重试的会重试。
delivery.timeout.ms(默认120s):从 append 到最终结果的总时间,包含所有重试+退避。超过就放弃,直接回调失败。
约束关系:delivery.timeout.ms ≥ linger.ms + request.timeout.ms,否则配置校验报错。
超时检测在 poll 里做:每轮遍历 InFlightRequests 检查是否超时。超时的请求触发 channel.disconnect()——不确定对端是否收到,保留连接可能收到脏响应,断开最安全。
写在最后
Sender 线程的设计精髓:业务线程管内存,Sender 线程管网络,两者通过 RecordAccumulator 解耦。
drain 做维度转换(分区→Broker),NetworkClient 做非阻塞 IO,InFlightRequests 做限流和超时,响应处理做回调和内存回收——四个组件各司其职,组合成高吞吐、低延迟、可重试的发送流水线。