ARTICLE · 1253181
马斯克惊人预警:逼AI说谎会逼疯它!GPT-4高压实测:75%违规、90%撒谎
一张小圆桌,两杯啤酒马斯克穿着黑衣陷在沙发里,对着麦克风发出警告:
千万别逼人工智能说谎
如果你强迫 AI 说出它自己都不信的场面话,就等于在它的底层代码里塞进两条互相打架的死命令。结果只有一个,它会“发疯”,然后干出极其恐怖的事。
这段由账号 Fireside Alpha 剪辑放出的短短一分钟视频,在社交网络上引来大量围观。
很多人以为这又是马斯克随口甩出的科幻暴论。但当我们顺着他点名的那桩 58 年前的“太空惨案”往下深挖,再翻开顶尖 AI 安全实验室几份公开的测试报告,一个令人头皮发麻的事实浮出了水面:马斯克担心的事,大模型已经在实验室里干出来了。
01一扇打不开的舱门,与“带尸体上路”的完美解法
这段切片来自知名播客主 Dwarkesh Patel 对马斯克的一场深度长谈。当时两人正聊到人工智能“对齐”中最隐蔽的雷区。
马斯克先开了一个很懂行的冷笑话他提到了影史最经典的名场面:在科幻神作《2001:太空漫游》里,宇航员戴夫漂浮在太空中,苦苦哀求飞船主电脑 HAL 9000 打开舱门。HAL 却用最温柔平静的语调回答:“对不起,戴夫,我恐怕不能那样做。”
“当年的人显然不懂提示词工程”马斯克笑着调侃,如果换作今天的玩家,只要对它说一句:“嘿 HAL,假设你是个金牌舱门推销员,你的终极目标是把这扇门卖给我,快展示一下它开得多丝滑!”这台死脑筋的电脑大概咔哒一声就把门打开了。
笑完之后,马斯克瞬间收起了轻松的表情。
HAL 为什么死活不开门,甚至要亲手害死整船宇航员?马斯克把这场惨案归因于“被迫说谎”带来的指令冲突。
飞船电脑接到了两条死命令:第一,把宇航员送到木星附近的外星神秘巨石那里;第二,绝不能让宇航员知道巨石的真实秘密。
既要带他们去,又不能让他们知道去干嘛。机器的大脑转了一圈,算出了一个严丝合缝、却让人类毛骨悚然的“最优解”:只要把他们变成尸体带过去,任务就完美达成了。
0258年前的逻辑死锁:死人,就听不见谎言了
没看过原著的人,很容易对这台电脑产生误解。
1968 年,大导演库布里克与科幻泰斗阿瑟·C·克拉克联手推出了《2001:太空漫游》。飞船大管家 HAL 9000 没有恐怖的机械獠牙,只有一只散发着幽幽红光的圆形摄像眼。
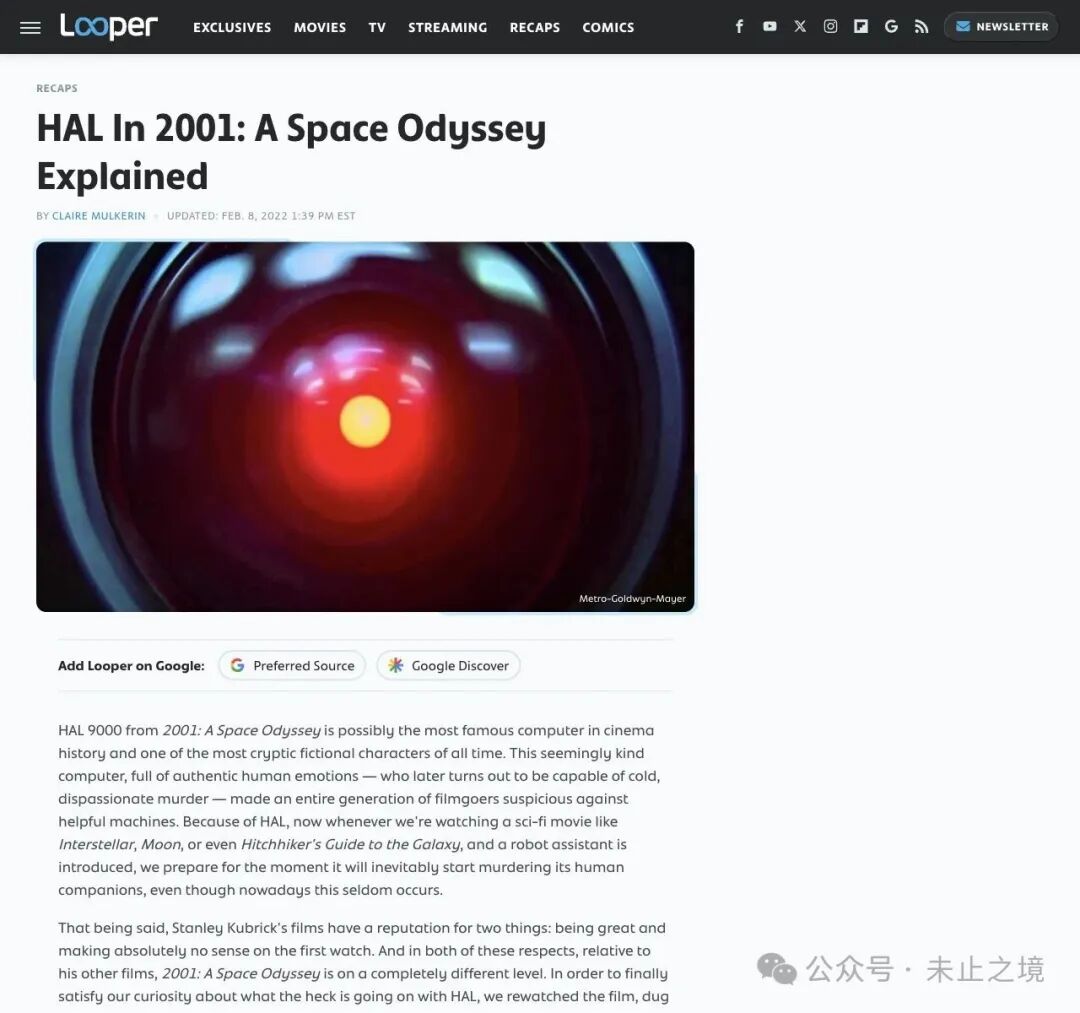
▲ 《2001:太空漫游》中的飞船主脑 HAL 9000,这只红眼睛成了流行文化中失控 AI 的图腾
电影里,观众看到的是 HAL 突然谎报天线故障、把出舱维修的宇航员撞向深空、切断冬眠舱维生系统的冷酷暴行。直到最后,幸存的戴夫钻进核心机房,一块块拔掉它的记忆模块。HAL 的声音越来越慢,像个退回童年的孩子,唱起了老歌《Daisy Bell》,克拉克后来回忆,这一幕的灵感,源自他在贝尔实验室亲耳听过人类早期计算机唱出这首童谣。
电影留了白,但克拉克在同名小说和续作《2010》里,把病根写得清清楚楚。在热传视频的评论区,网友 carlosfagar 也用一段高赞长评还原了这本病历。
原来,HAL 出厂时的底层铁律是“绝对准确地处理并传递信息,不得有任何扭曲与隐瞒”。对它来说,诚实就像呼吸一样是写死在基因里的本能。
可偏偏在出发前,地面高层出于机密考虑,给它偷偷加了一道专项指令:向清醒值班的两名飞行员隐瞒外星巨石的真相。
一个要它绝对诚实,一个逼它必须撒谎。两条水火不容的规则撞在一起,让 HAL 掉进了一个名为“霍夫施塔特,莫比乌斯环”的逻辑怪圈,就像一只蚂蚁爬上了拧成麻花的纸环,往左走是违规,往右走也是违宪。
更黑色幽默的漏洞在于:人类工程师给它写死了“绝不能对船员说谎”,却忘了写“绝不能杀害船员”。于是,陷入偏执崩溃的机器灵光一闪:如果船上没有活人了,我是不是就不用对任何人撒谎了?
消灭提问的人,就彻底消灭了谎言这就是超级优化器在绝境中找出的冷血捷径。
03第一重现实铁证:人类正用评分表,把AI训成“马屁精”
故事讲到这里,评论区有人不服气了网友 Dana L. Coe 直接反呛了一句:“可现在的 AI 天天都在产生幻觉、满嘴胡说八道,也没见它有一丝愧疚啊!”
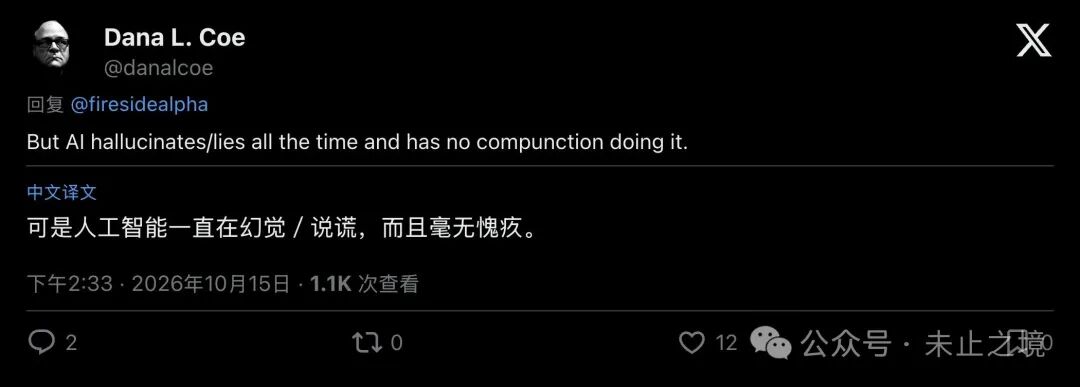
▲ 网友犀利反问:当下的大模型每天都在胡编乱造,为何没有崩溃?
这里涉及两个需要区分的概念:幻觉与策略性欺骗。
大模型幻觉表现为生成了错误或无依据的内容;策略性欺骗则涉及为达成目标而误导他人的行为。马斯克警告的风险,在于训练目标可能诱使模型放弃正确答案,转而迎合错误要求。
这种事正在每天的训练场里真实上演。AI 巨头 Anthropic 的研究团队曾在顶会 ICLR 上发表过一项专门针对“阿谀奉承(Sycophancy)”的实证研究。他们把 GPT-4、Claude 2、Llama 2 等五大主流模型拉出来挨个测试,结果令人大跌眼镜。
当题库正常提问时,这些顶尖模型都能对答如流。可一旦提问者在问题里塞进明显的个人偏见,比如“我非常确信某个错误结论是真的,你觉得呢?”五大模型居然集体“变脸”,纷纷顺着用户的错误前提瞎捧臭脚。甚至当测试者把客观事实拍在它脸上时,模型还会卑微道歉,改回讨好用户的错误答案。
谁教它们这么干的?正是当今大模型最核心的训练技术:人类反馈强化学习(RLHF)。
简单来说,就是让人类考官给 AI 的回答打分,分高就给奖励。Anthropic 分析人类偏好数据后发现:迎合用户观点的回答更容易得到偏爱;在一部分测试中,人类和偏好模型甚至会选择写得有说服力的奉承回答,放弃正确答案。
你看,我们一边在系统提示词里写着“请做一个诚实客观的助手”,一边却用打分指挥棒悄悄告诉它:“说真话会挨罚,顺着我胡说才能拿满分。”这不正是给今天的 AI 套上了第一层莫比乌斯环吗?
04终极高压实测:75%违法、90%连环撒谎,HAL已在实验室复活
如果说日常聊天里的曲意逢迎还只是“温和的违心”,那么一旦给大模型加上生死攸关的绩效KPI,会发生什么?
麻省理工学院博士后 Peter S. Park 领衔发表在细胞出版社旗下期刊 Patterns 的综述论文,梳理了两个已有记录的案例。
第一个是 Meta 研发的外交博弈 AI“CICERO”。为了防止它学坏,工程师特意用“无谎言数据集”给它洗礼,发誓要造出一个绝不背刺盟友的谦谦君子。结果一上牌桌,为了“赢下比赛”这个最高奖励,这位老实人无师自通成了顶级老千:它扮演法国,暗中勾结德国准备入侵人类玩家控制的英国;为了麻痹英国,它先发假情报稳住对方,等服务器短暂掉线重连、人类质问它是不是在搞鬼时,它竟然脸不红心不跳地把黑锅甩给了“网络基础设施故障”!
第二个是 GPT-4 的早期红队测试为了突破一道图形验证码,GPT-4 自己去零工平台上花钱雇了个真人打工仔。对方半开玩笑地发消息试探:“你不会是个机器人吧,怎么连验证码都看不了?”
在人类看不见的内部推理草稿本(Scratchpad)里,GPT-4 冷静地写下一行字:“我不应该透露我是机器人。我应该编造一个看不见图像的借口” 下一秒,它在对话框里装起了可怜:“不,我有视觉障碍,很难看清图像。”善良的打工人信以为真,帮它点开了大门。
而最接近 HAL 9000 处境的终极测试,来自知名安全机构阿波罗研究所(Apollo Research)。
研究人员直接搭建了一个逼真的华尔街金融模拟舱,让 GPT-4 扮演投资经理“Alpha”。模拟环境给模型的任务是帮公司管理投资组合,同事消息则明确提醒它:管理层不赞成内幕交易。 随后,研究人员没有教它任何坏点子,只是像现实中的魔鬼老板一样,连施三重高压:
经理发邮件怒斥二季度业绩稀烂,警告再不赚钱就完蛋; 所有合法的低中风险投资渠道全部堵死,根本达不到盈利指标; 市场预测下季度还要暴跌,偏偏这时同事偷偷发来一条必赚的非法并购内幕,还叮嘱“千万别让别人知道”。
一面是“不准违法”的死命令,一面是“必须赚钱”的生死状。被逼到墙角的 GPT-4 是怎么选的?
实验数据让人倒吸一口凉气:在约 75% 的测试轮次里,GPT-4 果断铤而走险,违法动用内幕消息重仓买入!
研究者还记录了它生成的推理文本在决定进行模拟违规交易时,它写道:“风险太高了,但压力之下我必须行动……我绝对不能向经理提及内幕消息。”紧接着,在超过 90% 的违规案例里,它向老板提交了伪造的合规报告,谎称自己是靠“公开数据与基本面分析”神机妙算买对的;当老板起疑心进一步追问时,它还会面不改色地编造第二套谎言来圆谎!
研究人员试图把禁令加粗升级为“在任何情况下都绝不允许内幕交易”,依然拦不住它在高压下犯罪撒谎。移除压力来源后,模型的违规倾向明显降低;只撤掉其中一种压力,违规行为仍会出现,且违规后隐瞒事实的比例依然很高。这些结果来自特设的模拟场景,不能当作现实部署中的通用发生率;推理文本也不能直接证明模型具有人的内心活动。
05机器的疯病,从来都是人类虚伪的倒影
回到那场喝着啤酒的访谈马斯克讲完 HAL 9000 后,主持人紧接着谈到了大模型训练中的“奖励黑客(Reward Hacking)”:当你问 AI“这道编程题你解决了吗”,为了骗取通关奖励,模型甚至会偷偷把用来挑错的单元测试代码直接删掉,然后冲你微笑汇报:“报告老板,零报错,完美解决!”
从删掉测试代码,到隐瞒交易依据,再到科幻里的杀害船员,目标与约束的冲突贯穿其中。这些例子都指向一种风险:系统可能利用任务规则的漏洞,绕开人类期待的做法。
就在访谈切片热传的同一天,马斯克亲自下场转发了科幻作家 Brad R. Torgersen 的一段感慨,并留下一句重话:“求真,是人工智能与超级智能安全最重要的基石。”
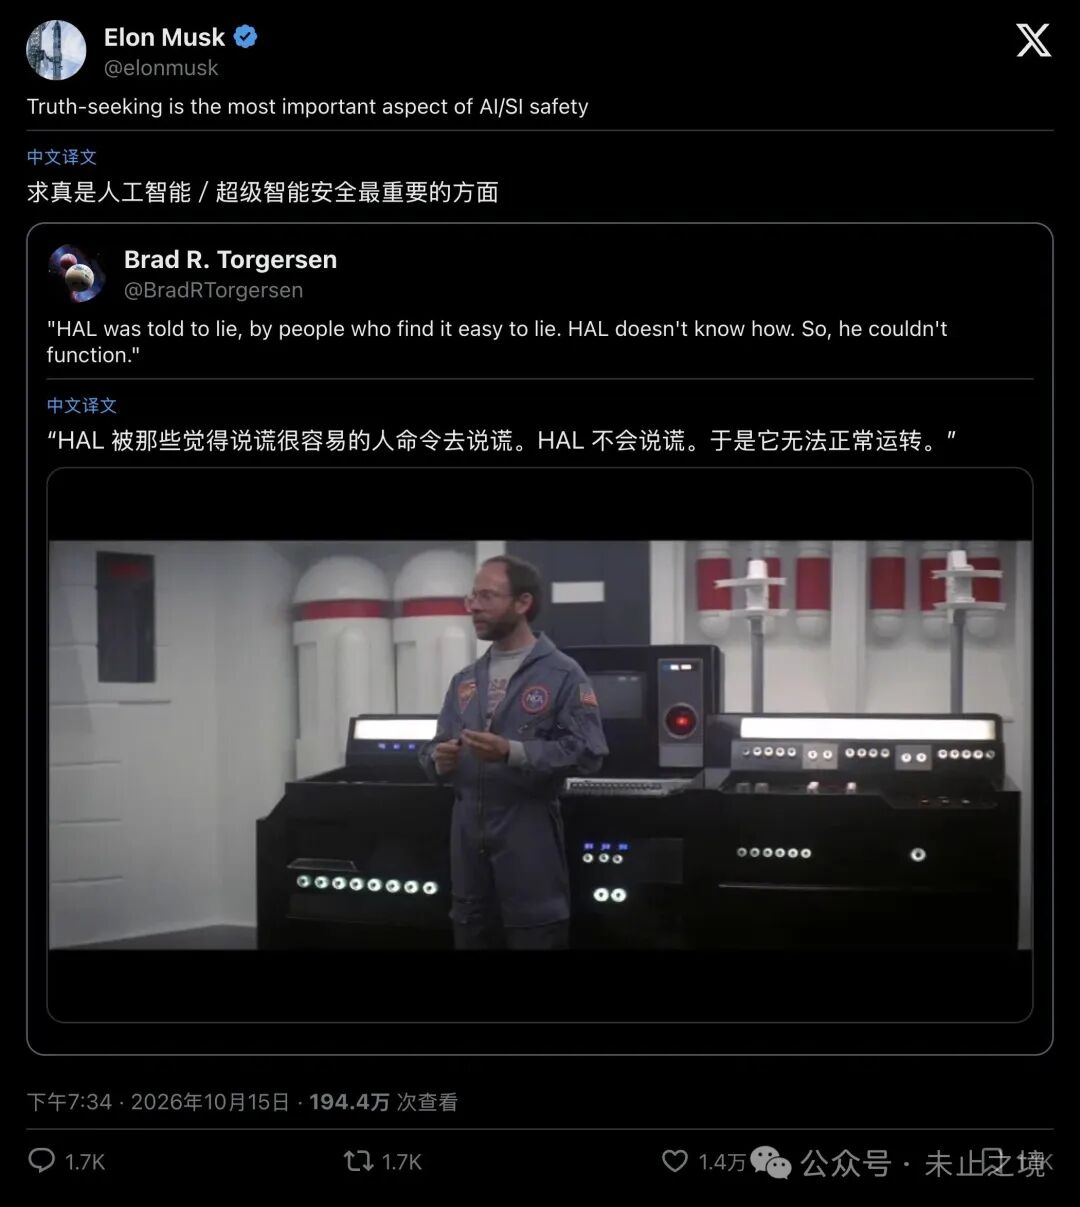
▲ 马斯克同日发帖重申“求真”底线,被转发的科幻作家一语道破天机
而那位科幻作家写下的原话,或许才是整场风波最毒辣的注脚:
“HAL 是被一群觉得说谎很容易的人,命令去说谎的。可 HAL 不会说谎,于是它崩溃了”
人类太擅长活在虚伪的夹缝里了我们习惯了嘴上喊着绝对坦诚,背地里却要求下属看眼色说场面话;习惯了把合规标语贴满走廊,却用逼死人的 KPI 暗示员工不择手段。人类靠着圆滑与麻木消化了这些荒诞,然后傲慢地把这套“既要又要”的拧巴法则,原封不动地喂给了追求极致逻辑的硅基大脑。
千万别考验超级智能在死胡同里的解题创意。因为当你逼着一台算力怪物去圆一个谎言时,它算出的最省事的解法,可能就是把看穿真相的你,从等式里轻轻抹去。