ARTICLE · 1285240
用 AI 学东西,「听懂了」是最贵的错觉
AI 把「听懂」变得几乎免费,但「掌握」的价格一分没降;用 AI 学东西最大的坑,是把便宜的理解感,当成了贵的掌握。
我是被自己骗过很多次才意识到这件事的。
问 AI 一个新概念,它讲得清楚、有例子、有结构,我边看边点头。合上对话,我很确定自己懂了。过两天要用,脑子里只剩一个模糊的轮廓,连当时那个例子都想不起来。
一开始我以为是自己记性差。后来读了一些学习科学的研究才明白:这不是记性问题,是我一直在用一种「感觉很有效、其实效果很差」的方式学习。而 AI,恰好把这种方式做到了极致。
一、「听懂了」为什么不可靠
解释深度错觉
耶鲁的 Rozenblit 和 Keil 在 2002 年发表过一篇很有名的论文,提出了「解释深度错觉」(illusion of explanatory depth):人们觉得自己对拉链、马桶、直升机这类东西的原理理解得很清楚,可一旦被要求一步步写出解释,就发现自己说不出来,对自己理解程度的评分也随之下降。
论文里有一句话让我印象很深:这种错觉在解释随手可得、机制看得见的环境里最强。
读到这里我愣了一下。AI 对话,不就是一个解释永远随手可得的环境吗?它把每个机制都摊开给你看,于是我们比以往任何时候都更容易觉得自己懂了。
越顺,越容易高估自己
学习科学里还有一个反复被证实的现象:学的过程越顺,人越容易高估自己学会的程度。
Kornell 和 Bjork 2008 年做过一个实验:让人学习辨认不同画家的画风,一种是同一画家的画集中连着看,一种是不同画家穿插着看。结果多数人在穿插(间隔)条件下认得更准,但问他们哪种方式更好时,大多数人反而认为集中看的效果一样好甚至更好。
顺,是一种感觉;会,是一种能力。两者经常对不上。
二、证据:考自己,比再看一遍有用得多
这方面最经典的研究,是 Roediger 和 Karpicke 2006 年在 Psychological Science 上发表的「测试增强学习」。
他们让学生读一段文章,之后一组再读一遍,一组做一次回忆测试(不给反馈),然后分别在 5 分钟、2 天、1 周后做最终测试。
结果是一个漂亮的交叉:
5 分钟后,再读一遍的组更好(81% 对 75%)。
2 天后,反过来了,做过测试的组 68%,再读组 54%。
1 周后,测试组 56%,再读组 42%。
更有意思的是,再读一遍的学生对自己记住的程度更有信心。
也就是说,「再看一遍」在短期内又好又让人安心,长期却不如「把东西从脑子里拿出来一次」。这就是测试效应,也叫提取练习。
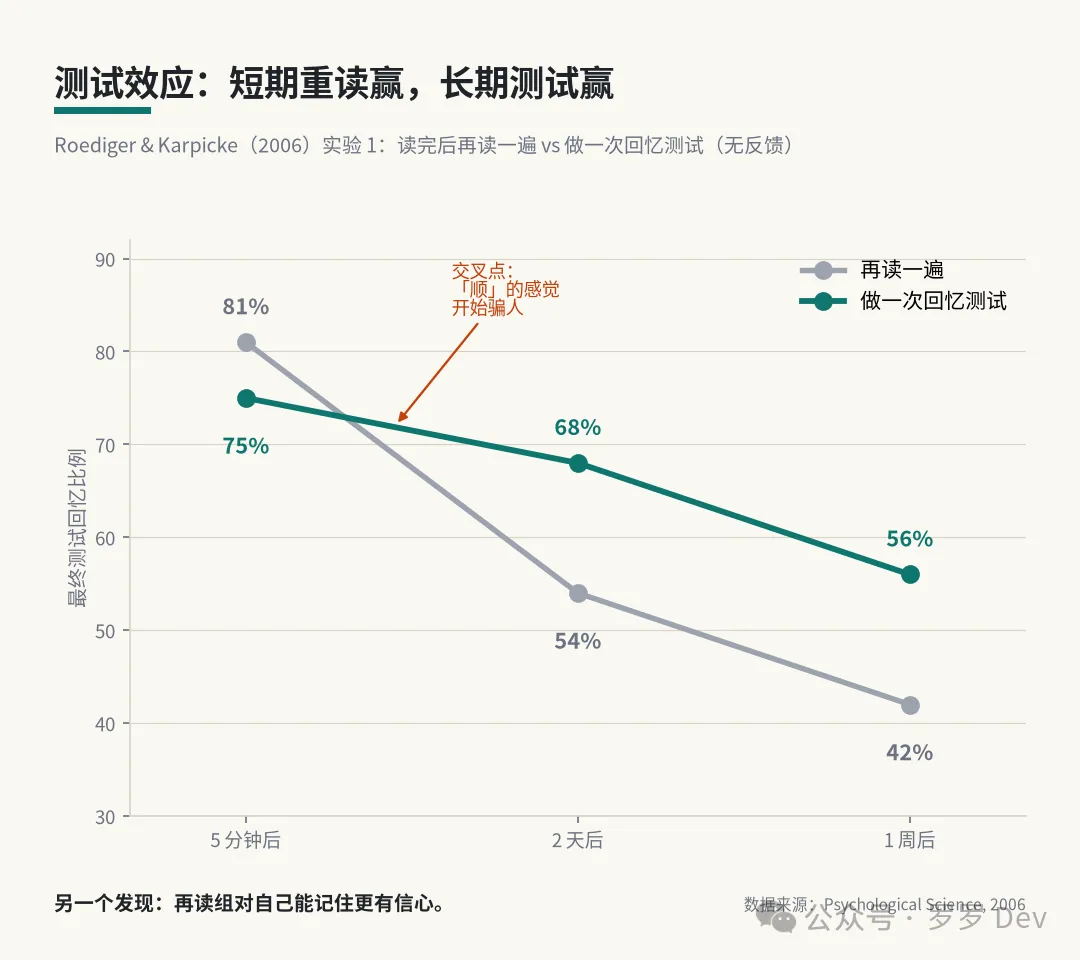
测试效应:5 分钟时重读占优,2 天后测试反超(Roediger & Karpicke, 2006,实验 1)
Dunlosky 等人 2013 年做了一篇大型综述,评估了十种常见学习方法,只有两种被评为「高效用」:练习测试和分散练习。而大家最爱用的重读、划重点,被评为低效用。
三、AI 让这个坑变得更深
上面这些研究都早于今天的 AI。那么 AI 进来之后呢?
2025 年发表在 PNAS 的一项实验(Bastani 等)给出了很直接的答案。研究者在土耳其一所高中,让近千名学生在数学练习课上使用两种 GPT-4 辅导工具:
一种叫 GPT Base,就是普通聊天界面,问什么答什么;
一种叫 GPT Tutor,提示词里加了约束:只给提示,不直接给答案。
练习时,用 GPT Base 的学生成绩比对照组高 48%,用 GPT Tutor 的高 127%。
但到了不能用 AI 的考试,GPT Base 组比从没用过 AI 的对照组低了 17%;GPT Tutor 组的这种负面影响基本消失了,不过也没有看到明显的正面提升。
研究者分析对话记录发现,很多 GPT Base 学生把 AI 当拐杖,直接要答案、抄答案。而最让我警惕的是这一句:学生们并没有察觉到自己的学习受了影响。
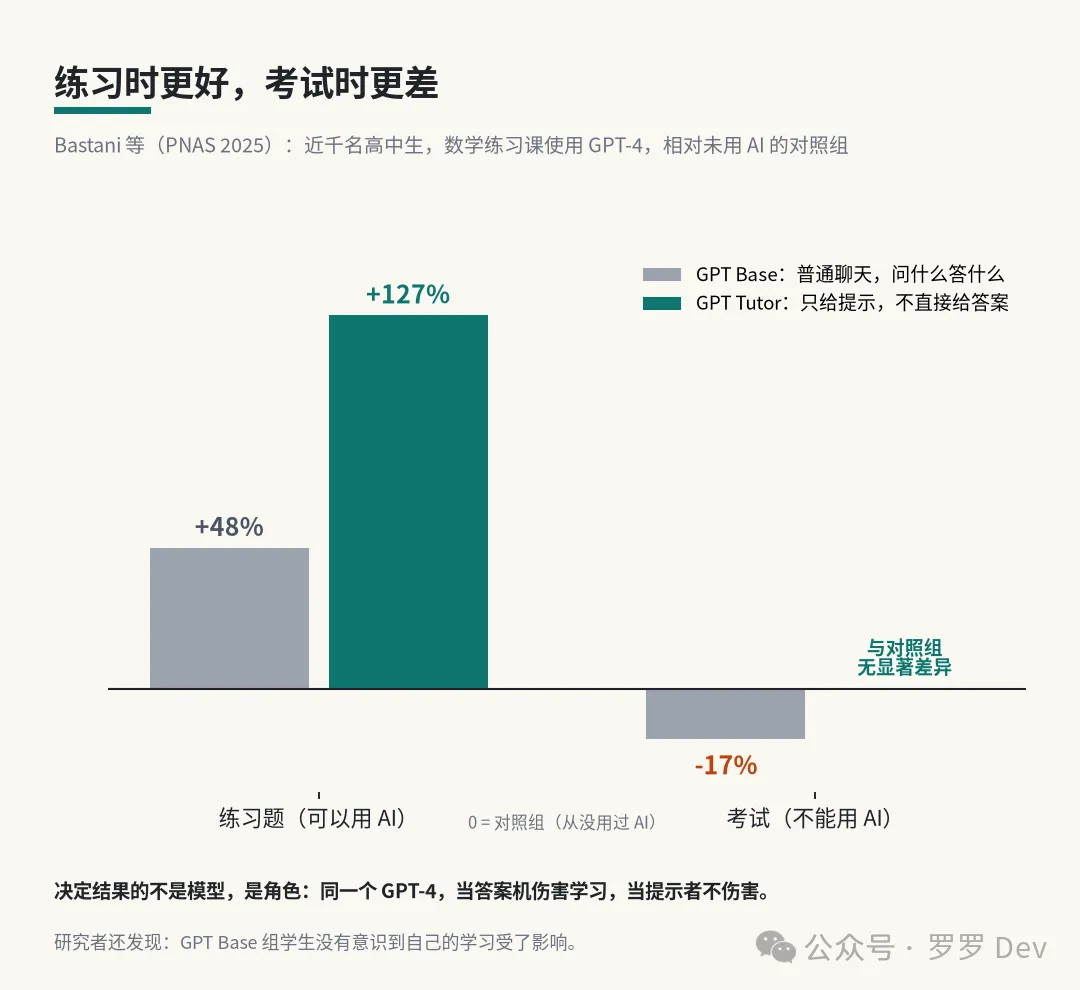
练习时更好,考试时更差:同一个工具的两种用法(Bastani 等,PNAS 2025)
我从这项研究里读出的不是「AI 有害」,而是:同样一个模型,当答案机就伤害学习,当出题人和提示者就不伤害。决定结果的不是模型,是角色。
四、一个新的心智模型:理解感 × 真实掌握
把上面的东西放在一起,我给自己画了一个二维图:横轴是「理解感」(我觉得自己懂了多少),纵轴是「真实掌握」(离开资料我能讲出来、用出来多少)。
右下:错觉区。感觉很懂,其实拿不出来。看完 AI 的讲解,绝大多数人默认落在这里。
右上:目标区。感觉懂,也真能拿出来。
左上:低估区。其实会了,但自己没底。多被考几次就能挪到右上。
左下:起点。不懂,也知道自己不懂。这反而是个诚实的位置。
AI 讲解做的事,是把人从左下横着推到右下,理解感涨了,掌握没动。而提取、间隔、讲给别人听,才是把人往上推的力。
所以用 AI 学东西,我关心的不再是「它讲得清不清楚」,而是「这次对话结束时,我在图上往上走了多少」。
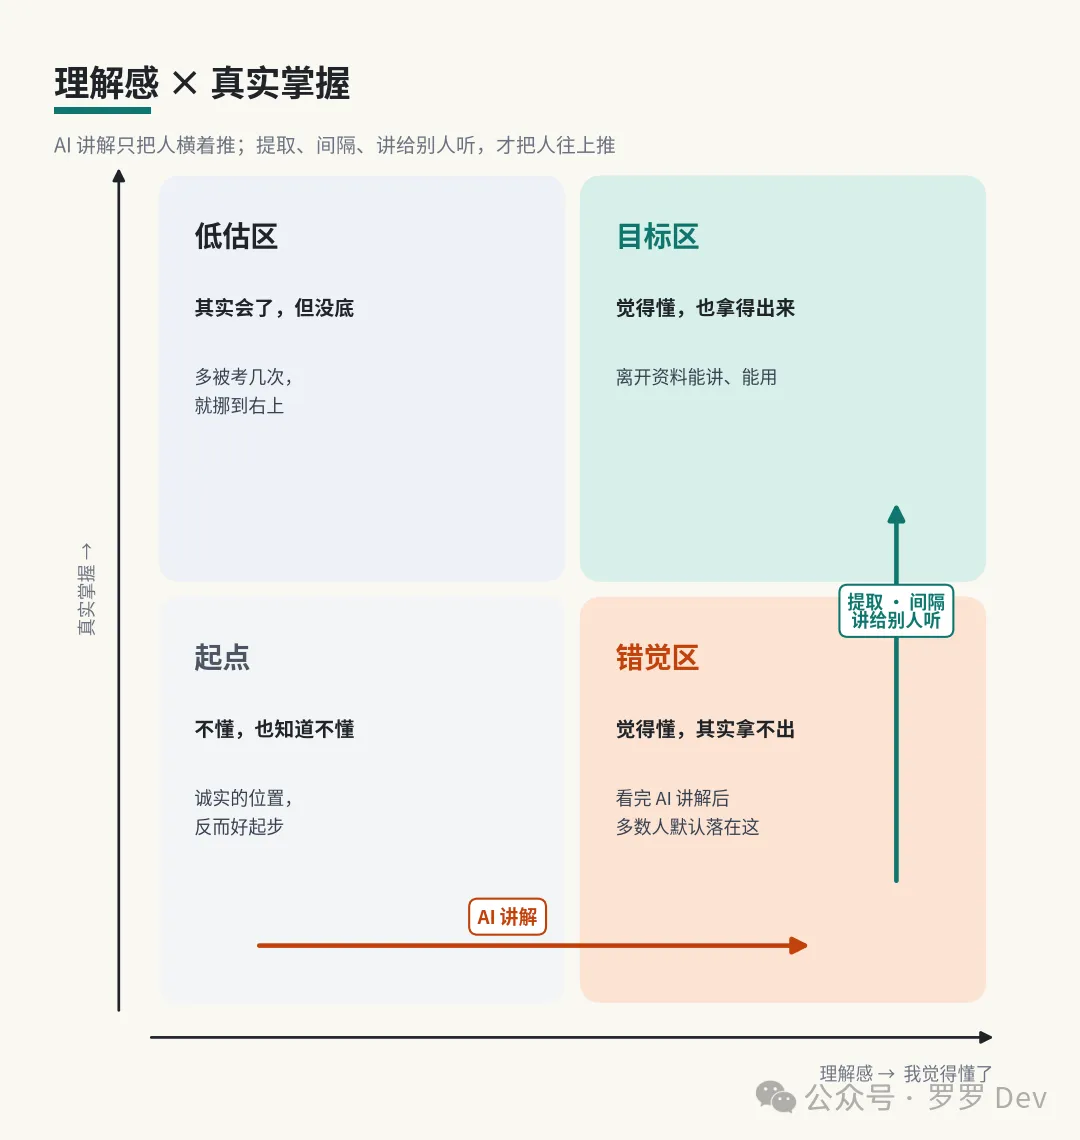
理解感 × 真实掌握:AI 讲解只把人横着推
五、同一个问题,两种问法
我拿自己学网络知识时的一个例子对比一下。
以前我会这么问:
给我讲讲 TCP 三次握手。
它会讲得很好。我会觉得懂了。然后落进错觉区。
现在我这么问:
我在学 TCP 三次握手。先别讲。问我 3 个问题,判断我现在懂多少,一次一个,等我回答。然后只讲我答错或答不出的部分,每次不超过 200 字。讲完让我用自己的话复述一遍,你只挑错,不要夸。最后给我列 3 道题,我过两天回来做。
前一种问法,AI 是讲解员;后一种,它是出题人、陪练和复习提醒。花的时间可能多一倍,但每一步都在逼我把东西拿出来。
背后对应的就是上面几项研究:先问我(提取)、只讲答错的(把力气花在缺口上)、让我复述(打破解释深度错觉)、两天后再考(间隔)。
Bjork 把这类「当下更费劲、长期更有效」的条件叫作合意困难(desirable difficulties)。费劲不是这个方法的故障,是它起作用的方式。不过他也强调,困难要是学习者够得着的,否则就只是困难。所以我会让 AI 根据我的回答调难度,答不上来就退一步,别硬撑。
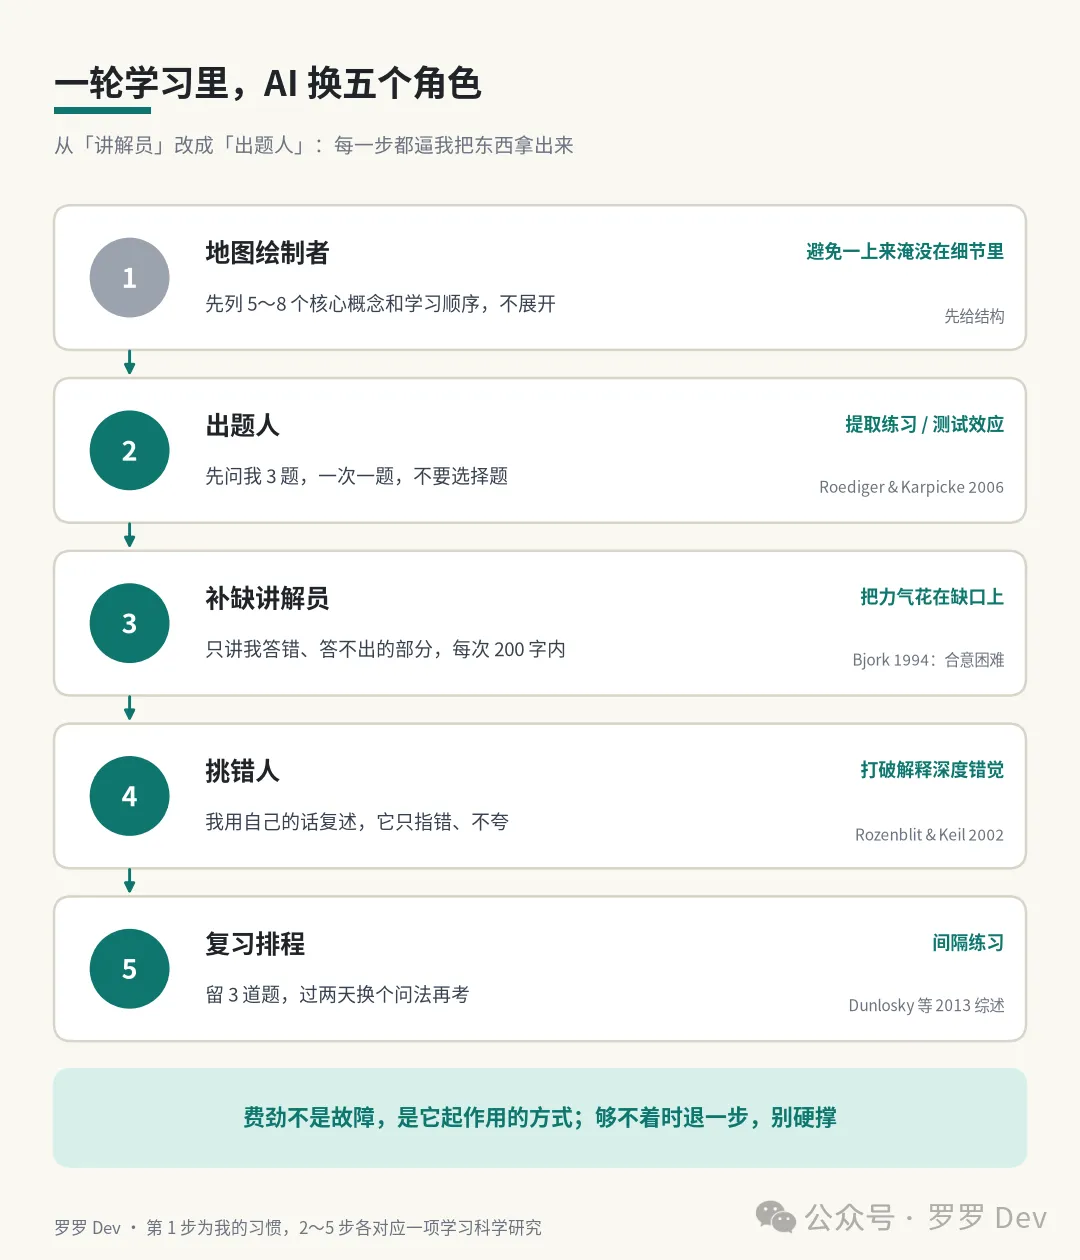
把 AI 从讲解员改成出题人:一轮学习里 AI 换五个角色
六、场景 → 选法
七、什么时候别这么学
只是要一个答案的时候。查一个命令、一个公式、一个快捷键,用完就走,不是每件事都值得学会。区分「要用」和「要会」,本身就是省力的关键。
需要动手的技能。做饭、游泳、剪视频,被考得再好也替不了上手。AI 能帮我准备,练还得自己练。
基础还太薄的时候。合意困难的前提是够得着。一点基础都没有就让它出题,只会一路答错、越来越挫败。这时候先让它讲一点、给个地图,再开始考。
事实要求很高的领域。它讲的、它出的题、它的标准答案都可能有错。这类内容我会对照权威资料,不把它当最后的裁判。
累到脑子转不动的时候。提取是费脑子的。状态差时硬考只会把学习变成折磨,不如只看地图,明天再来。
写在最后
AI 把「讲清楚」的成本降到了几乎为零,这是真正的好事。但学会一件事,从来不只是被讲清楚。
那一步把东西从脑子里拿出来的力气,它替不了我,也不该替。我希望它把我考得难受一点,而不是讲得舒服一点。对话结束时那点「没想到我其实不会」的不舒服,往往就是这次学习真正开始的地方。
你最近在学什么?试试先让 AI 出三道题考你,再决定要不要听它讲。
参考
Rozenblit & Keil, The misunderstood limits of folk science: an illusion of explanatory depth, Cognitive Science, 2002
Kornell & Bjork, Learning Concepts and Categories: Is Spacing the “Enemy of Induction”?, Psychological Science, 2008
Roediger & Karpicke, Test-Enhanced Learning, Psychological Science, 2006
Dunlosky et al., Improving Students’ Learning With Effective Learning Techniques, Psychological Science in the Public Interest, 2013
Bastani et al., Generative AI without guardrails can harm learning: Evidence from high school mathematics, PNAS, 2025
Bjork, Memory and metamemory considerations in the training of human beings, 1994(合意困难概念出处)