ARTICLE · 1286343
iDMA 源码全栈解析:三层契约、数据结构、Scatter-Gather 双路径与 Tensor Stride 展开
🎯 一句话主旨:Midend 用级联计数器把 tensor stride 说清楚,Backend 用合法化器和桶形移位器把 1D 搬合法;两者之间的接口窄到只剩三个数字
(src_addr, dst_addr, length)——接口即自由。
📚 目录
1. iDMA 是什么:源码给出的身份定义 2. 三层契约:不可违反的接口边界 3. 数据结构逐层拆解 4. ND Midend:级联计数器与无乘法器展开 5. Scatter-Gather 路径一:描述符链的任意离散 6. Scatter-Gather 路径二:Snitch + ND 的规律离散 7. 合法化器:协议合规的唯一守门人 8. 传输层:数据通路的真实代码形状 9. 在途计算:移动中变换,不额外访存 10. 参数、限制与集成事实 11. 总结:源码告诉我们的设计意图
1. iDMA 是什么:源码给出的身份定义
1.1 官方定位的直译
README 的第一句话定义了 iDMA 的身份:
"一个模块化、可参数化、高度灵活的数据移动加速器架构,目标覆盖从超低功耗边缘节点到高性能计算系统的广泛平台。"
它是 PULP 平台的集群级 DMA,用于 Snitch Cluster 和 PULP Cluster——这是它的原生场景。
1.2 它不是"更好的 1D DMA"
传统 DMA 的"固定功能"困境可以用一句话概括:
🎯 擅长连续,失语于离散。
当访存模式变成多维张量切片、Scatter-Gather、转置时,1D DMA 只能退化为:
• CPU 逐元素拷贝(最慢) • 海量单拍小传输(总线地址相位爆炸)
iDMA 的解法不是把 1D DMA 做得更快,而是把地址生成的复杂度从数据通路中解耦出去——用一个可选的、独立的 Midend 消化 stride,让 Backend 回到它最擅长的 1D 世界。
2. 三层契约:不可违反的接口边界
2.1 源码中的原始表述
README 用一句话定义了整个架构的拆分逻辑:
"iDMA 的核心思想是把 DMA 引擎拆成三个截然不同的部分:Frontend 发出传输请求;Midend 把前端请求变换为通用的 1D 传输,交给 Backend 处理;Backend 拿到一个 1D 传输
(src_addr, dst_addr, length)并在传输协议的管理接口上执行它。"
2.2 三个契约的硬边界
| 绝对不感知 | |||
|---|---|---|---|
| Frontend | idma_req_tidma_nd_req_t | ||
| Midend | 1D 请求流 | ||
| Backend | stride、维数、上一个请求的地址 |
⚠️ Backend 只认识三个数字:源地址、目的地址、长度。 它收到 个这样的三元组,就视为 个独立事务,绝不跨三元组合并——哪怕它们在物理地址上相邻。
2.3 为什么这是"硬契约"而不是"建议"
如果 Midend 把 stride 信息"泄漏"给 Backend,三层就退化为一个无法独立验证的巨石。源码的选择是:
🧩 Midend 承担全部"说清楚"的复杂度;Backend 承担全部"搬合法"的复杂度。
两者之间的接口窄到只剩 3 个数字,所以可以独立替换、独立形式化验证。
2.4 三层数据流
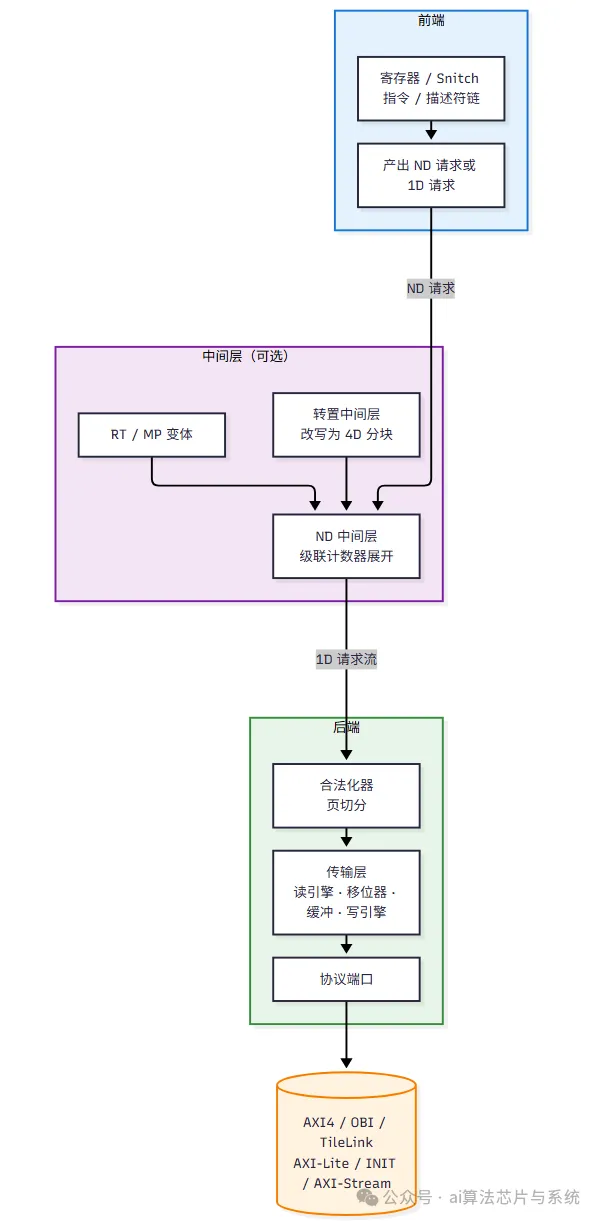
3. 数据结构逐层拆解
iDMA 的三层拆分不仅是逻辑分层,更直接体现在数据结构的归属上。每一层有自己能读写的结构体,有自己永远看不到的字段。
3.1 数据结构在各层的位置
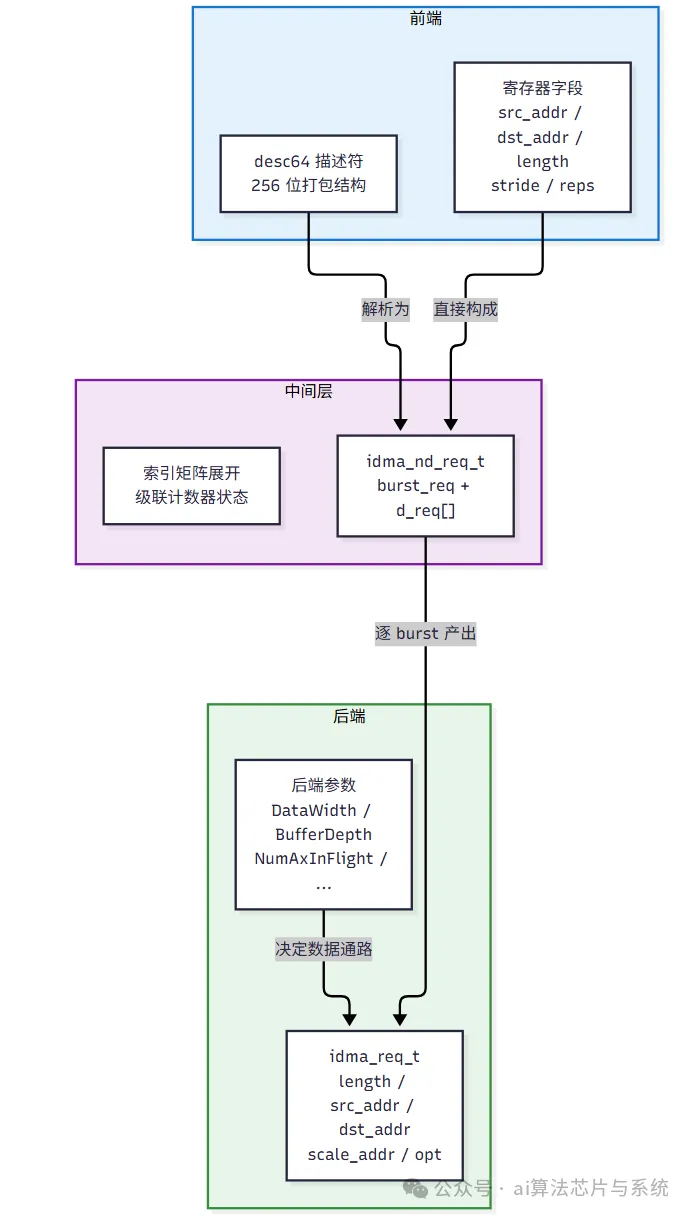
• 🔵 前端持有描述符或寄存器字段,产出 idma_nd_req_t或直接产出idma_req_t。• 🟣 中间层持有 idma_nd_req_t,内部维护索引矩阵的计数器状态,逐 burst 产出idma_req_t。• 🟢 后端只持有 idma_req_t和一组参数化配置;数据通路形状由参数决定,而不是由 stride 决定。
3.2 idma_req_t:后端唯一认识的 1D 结构体
idma_req_t 是三层之间的"通用货币"。源码中它的字段直接决定了后端能看到什么:
| 不感知 | |||
|---|---|---|---|
length | tf_len_t | ||
src_addr | addr_t | ||
dst_addr | addr_t | ||
scale_addr | addr_t | ||
opt | options_t | compute_options_t |
用带标签列的数组表达后端看到的"世界":
🎯 这个数组中没有任何 stride 行。后端收到 个这样的数组,就视为 个独立事务,绝不跨数组合并。
3.3 options_t 与 compute_options_t:请求上的控制平面
options_t 是 idma_req_t 中 opt 字段的类型,它本身是一个嵌套结构:
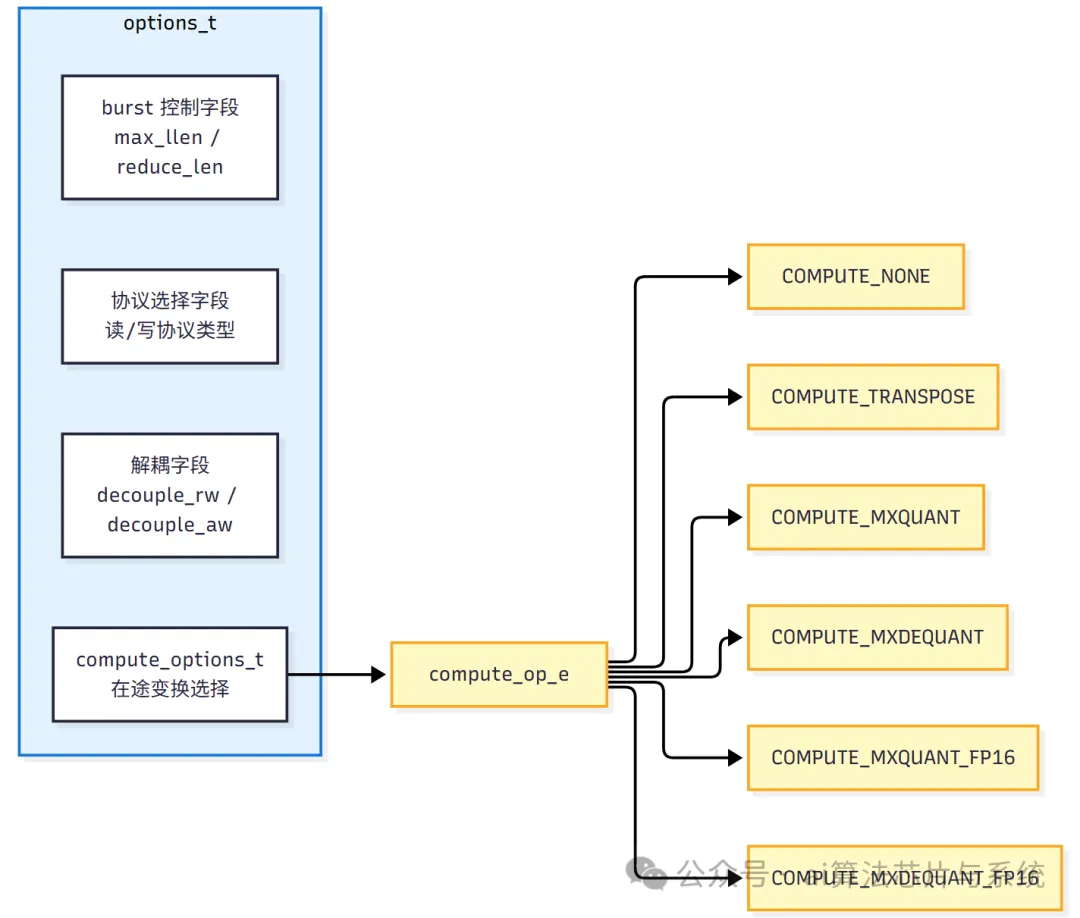
compute_op_e 的六个取值不是手写的 RTL 常量,而是从 idma_reg.rdl生成的:
"
compute_op_e编码了COMPUTE_NONE、COMPUTE_TRANSPOSE、COMPUTE_MXQUANT、COMPUTE_MXQUANT_FP16、COMPUTE_MXDEQUANT、COMPUTE_MXDEQUANT_FP16。该枚举从idma_reg.rdl生成,所以 RTL 和软件头文件共享同一份编码。"
🎯 这意味着
options_t的编码事实源是 RDL,而不是 SystemVerilog。软件驱动和硬件 RTL 通过同一份生成产物对齐,避免了枚举值漂移。
compute 的生效条件是一个逻辑与:
• 🧩 EnableCompute是后端参数,决定硬件是否例化计算引擎。• 🧩 ComputeOps是后端参数,决定允许哪些操作。• 🧩 opt.compute.op是请求字段,决定这次传输做什么。
3.4 idma_rsp_t 与 err_payload_t:完成与错误的结构化表达
idma_rsp_t 是后端返回给前端的完成信号,它包含两个成分:
| 完成状态 | ||
| 错误载荷 | err_payload_t |
后端的 ErrorCap 参数决定错误处理能力:
ErrorCap | |
|---|---|
NO_ERROR_HANDLING | |
ERROR_HANDLING |
用结构化数组表达错误载荷的定位能力:
🎯 这对于ND 展开后的长 burst 流尤其重要:中间层发出了 个 burst,如果第 个失败,
err_payload_t必须能回溯到具体是哪个 burst,而不是笼统报告"传输失败"。
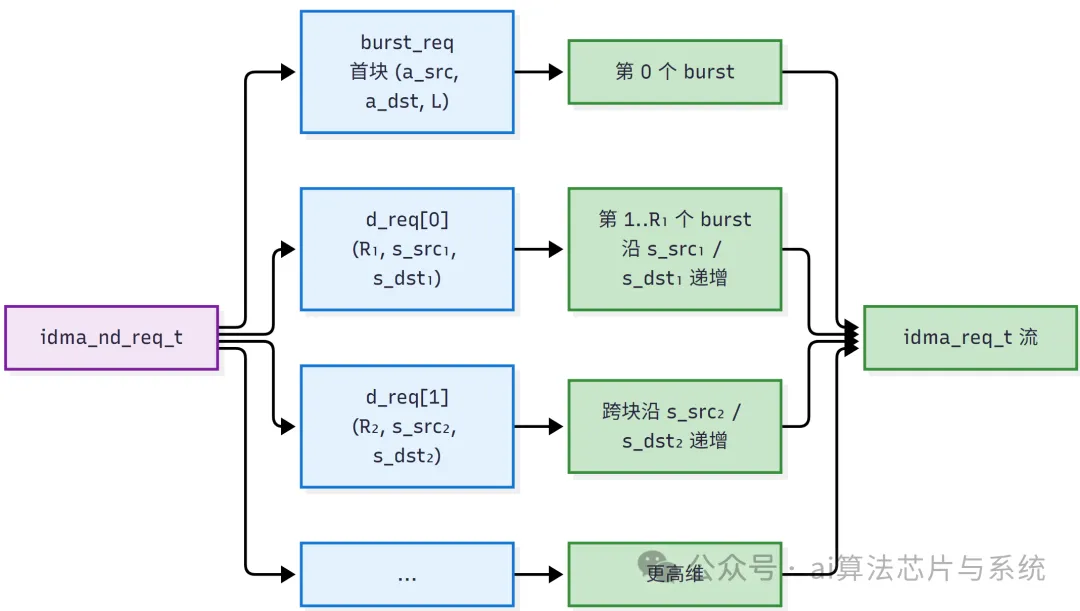
3.5 idma_nd_req_t:中间层的维度描述符数组
ND 中间层的输入 idma_nd_req_t 是把 1D 基块和每维描述符数组打包在一起的结构:
字段拆解:
burst_req | idma_req_t | 基础 1D 块 |
d_req[j] |
每个 d_req[j] 至少包含:
⚠️
d_req数组的长度是NumDim - 1,不是NumDim。原因:第一维(最内维)由burst_req.length隐含,不需要独立的 stride 字段。
ND 请求到 1D 请求流的映射:
3.6 desc64 描述符:256 位打包的链表节点
每个描述符是 256 位打包结构,字段的位域顺序和内存字节序相反:
"在 SystemVerilog packed struct 中,第一个字段(
flags)占据最高位,最后一个字段(dest_addr)占据最低位。在内存中(小端),dest_addr在最低字节地址。"
用带位域标签的打包数组表达概念布局:
⚠️ 实际
packed struct的字段顺序以源码idma_desc64_top.sv为准。关键是:flags在高位,dest_addr在低位,小端内存中dest_addr在最低地址。
flags 是一个 32 位位域,每一位有明确语义:
| 0 | irq | |
| 2:1 | src_burst | 00=FIXED,01=INCR,10=WRAP |
| 4:3 | dst_burst | |
| 5 | decouple_rw | 完全解耦读写 |
| 6 | decouple_aw | 安全解耦 |
| 7 | reduce_len | |
| 11:8 | src_cache | |
| 15:12 | dst_cache | |
| 23:16 | axi_id | |
| 31:24 |
典型 flags 值:
• 0x00000000:默认(INCR,无解耦,无中断)• 0x00000001:完成时中断• 0x00000061:decouple_aw+decouple_rw+ 中断
3.7 后端参数结构:决定数据通路形状的配置集
后端的数据结构不仅是 idma_req_t,还有一组决定数据通路形状的参数。这些参数不是运行时字段,而是例化时固定的配置:
DataWidth | ||
BufferDepth | ||
NumAxInFlight | ||
HardwareLegalizer | ||
CombinedShifter | ||
MaskInvalidData | ||
ErrorCap | NO_ERROR_HANDLING |
3.8 数据结构在各层的映射总览
| 能读 | 能写 | 永远看不到 | ||
|---|---|---|---|---|
| 前端 | desc64 | idma_nd_req_tidma_req_t | ||
| 中间层 | idma_nd_req_t | burst_reqd_req[] | idma_req_t | |
| 后端 | idma_req_t | lengthopt | stride、维数、描述符 |
结构体在流水线中的生命周期:
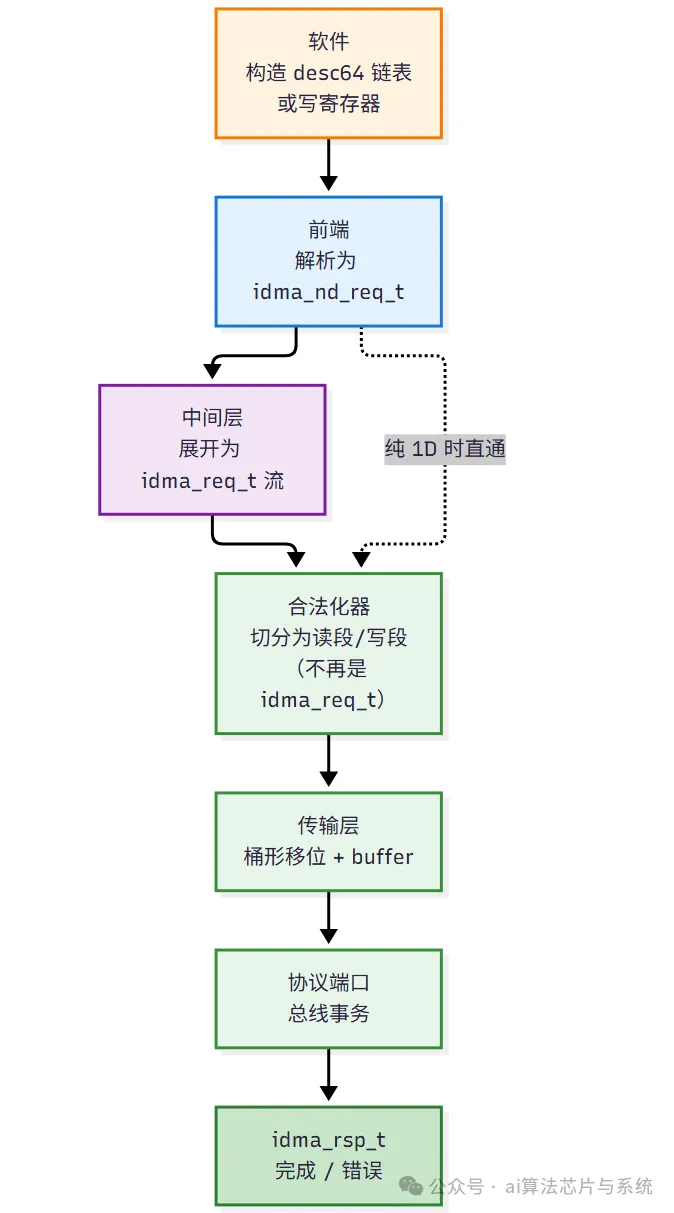
💡 数据结构设计遵循一条原则:每个结构体只携带该层需要的信息,并且尽可能窄。
idma_req_t只有 5 个字段,窄到后端可以独立形式化验证;idma_nd_req_t只增加维度描述符数组,不污染 1D 契约;desc64用 256 位承载链表节点,但通过reshaper的硬编码主动牺牲吞吐换合规。
4. ND Midend:级联计数器与无乘法器展开
4.1 源码中的实现描述
官方文档对 ND Midend 的描述精确到了微架构选择层面:
"每完成一个 1D burst,中间层检查当前维度是否还有剩余重复次数。若有,就把该维 stride 加到地址上,发出下一个 burst。当一个维度耗尽重复次数时,更高一维的计数器递增。内部用级联计数器(每维一个)和一个基于 popcount 的选择器实现,一次处理多层同时溢出。"
两个核心参数:
• NumDim:维数,必须 ——第一维由后端的 1D burst 隐含。• RepWidths:每维计数器位宽数组。例:NumDim=3, RepWidths='{32, 16, 8}表示第一维最多 次重复,第二维 ,第三维 。
4.2 级联计数器 + popcount:代码结构的文字还原
源码中 idma_nd_midend.sv 的关键信号是 stage_done 和 stage_zero。一个被广泛引用的代码注释写道:
"popcount 用于识别最高已完成 stage,然后加到当前地址寄存器上。"
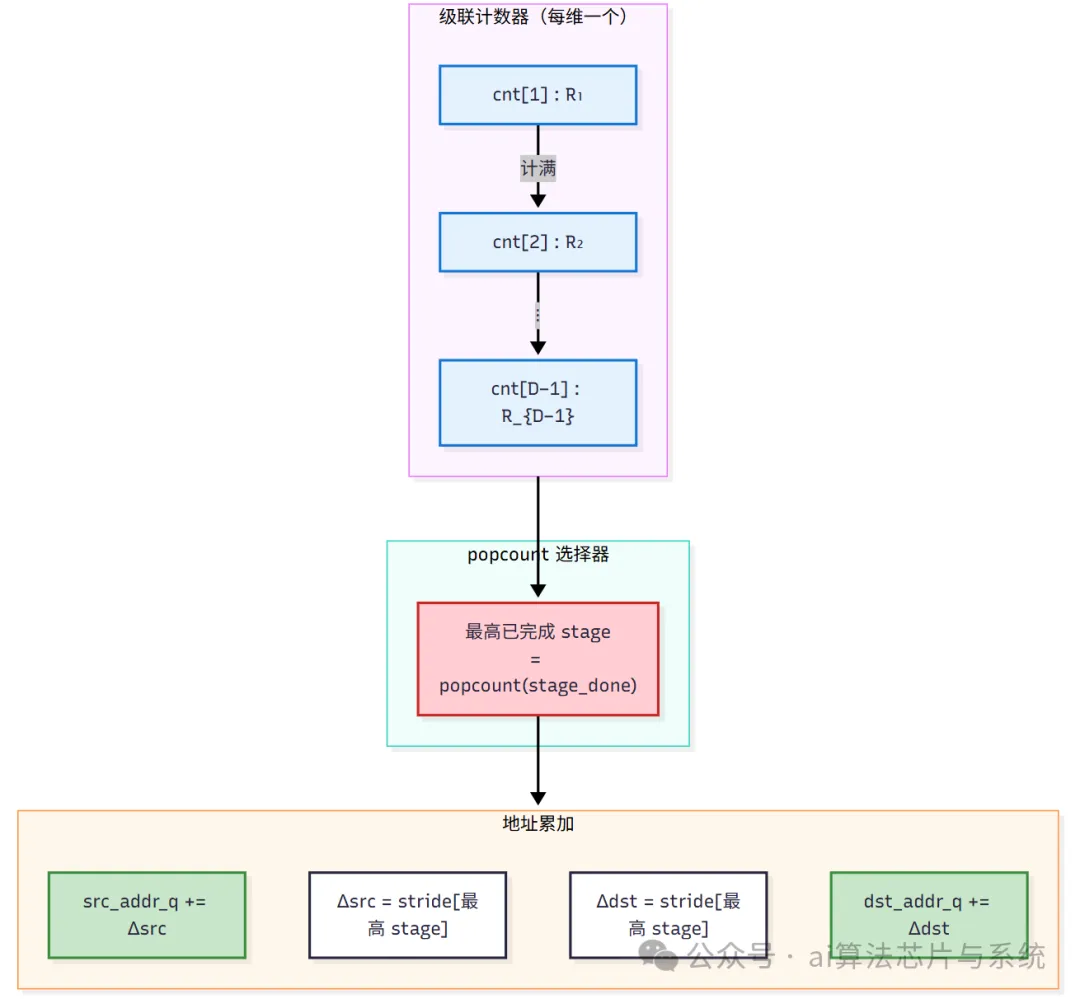
• 🔁 每握手一个 burst,最内维计数器 +1;如果未计满,不需要任何进位。 • ⚡ 计满时, stage_done[j] = 1;popcount 一次识别"哪几维同时溢出",避免链式进位的时序瓶颈。• 🧮 地址只加最高已完成 stage 的 stride;低维计数器清零——这就是 的硬件实现,不需要计算净增量。
4.3 数学本质:索引矩阵的逐行遍历
设 ,,。
第 个 burst 的维度索引:
burst 地址向量:
关键对应: 的第 行就是硬件在发第 个 burst 时的计数器状态向量。硬件不构造完整矩阵,而是逐行遍历。
4.4 官方 2D 数值示例
官方文档给出的 2D 传输:64 字节行,重复 4 次,源 pitch 128,目的 pitch 64。
• 🎯 每一列就是一个 1D 请求,共 4 个,顺序发出。 • 🎯 索引矩阵 ,硬件计数器从 0 计到 3。 • ⚠️ 后端将这 4 列视为 4 个独立事务,不合并——这是"小 stride 协议税"的直接来源。
5. Scatter-Gather 路径一:描述符链的任意离散
5.1 描述符前端的源码事实
描述符前端 idma_desc64_top 的本质是用链表表达任意离散性:
"描述符前端使用共享内存中的传输描述符链表。硬件通过 AXI 读端口自主获取描述符,使软件可以连续入队多个传输,而无需轮询每个传输的完成。"
5.2 一个关键的源码硬编码:debursting
描述符前端的 reshaper 模块负责把描述符的 flag 位映射为后端选项,但它硬编码了某些值:
"
src_max_llen和dst_max_llen总是被设为 0(完全 debursting:每个传输被拆成单拍总线事务,用吞吐换最大的协议合规性),lock、prot、qos、region也被清零。"
• 🚫 描述符路径优先保证协议合规,而不是吞吐。 • 🚫 即使源/目的地址是连续的,也被拆成单拍事务——没有 burst 合并。 • ✅ 这适合完全不规则的离散访问:网络包队列、随机稀疏张量、任意空洞地址。
5.3 链表遍历与投机预取
描述符是链表节点,next 指向下一个描述符的地址;0xFFFFFFFF_FFFFFFFF 标记链尾。
"
NSpeculation参数控制前端可以在后端消费之前预取多少个描述符。这隐藏了描述符取指延迟——当后端处理一个传输时,前端已经在读取后面NSpeculation个描述符。"
默认值 NSpeculation = 4。
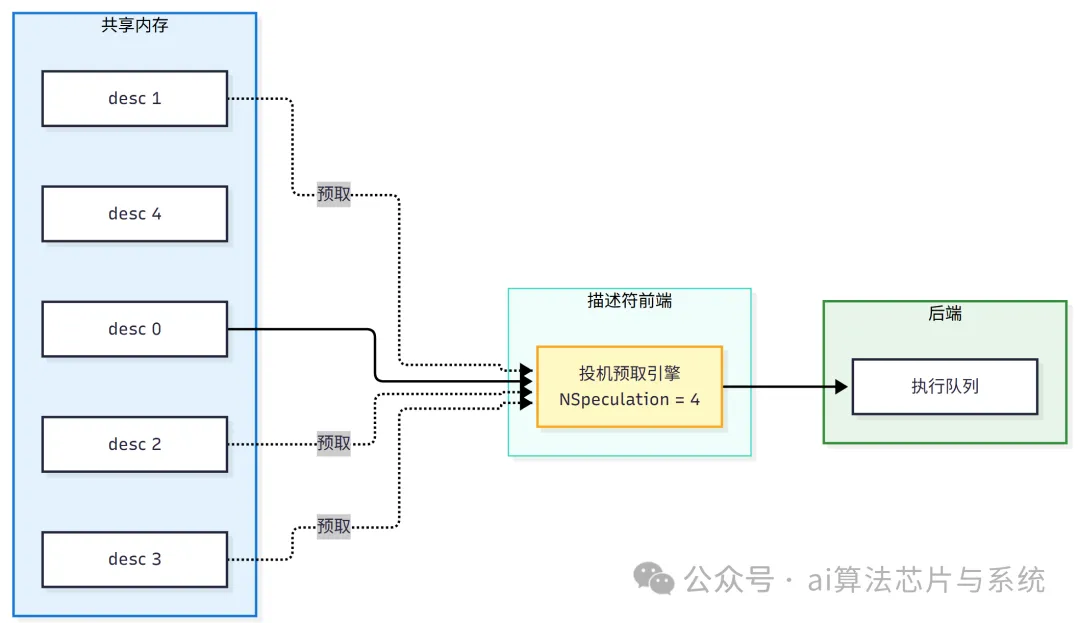
• 📌 预取深度 4 意味着描述符取指延迟被部分隐藏。 • 📌 NSpeculation = 0时禁用预取,每个描述符必须等上一个传输完成后才取。
6. Scatter-Gather 路径二:Snitch + ND 的规律离散
6.1 Snitch 前端的指令集
Snitch 前端通过 DMSRC / DMDST / DMCPY / DMSTR / DMREP 指令发起传输。其中 DMSTR 设置源/目的 stride,DMREP 设置重复次数,直接驱动 ND 中间层。
论文指出:"配置并启动一个 1D 传输只需 3 条指令,2D 传输最多 6 条指令。"
🎯 规律性 Scatter-Gather 的元数据开销是"几条指令",而不是一长串描述符。这正是 ND 中间层存在的理由。
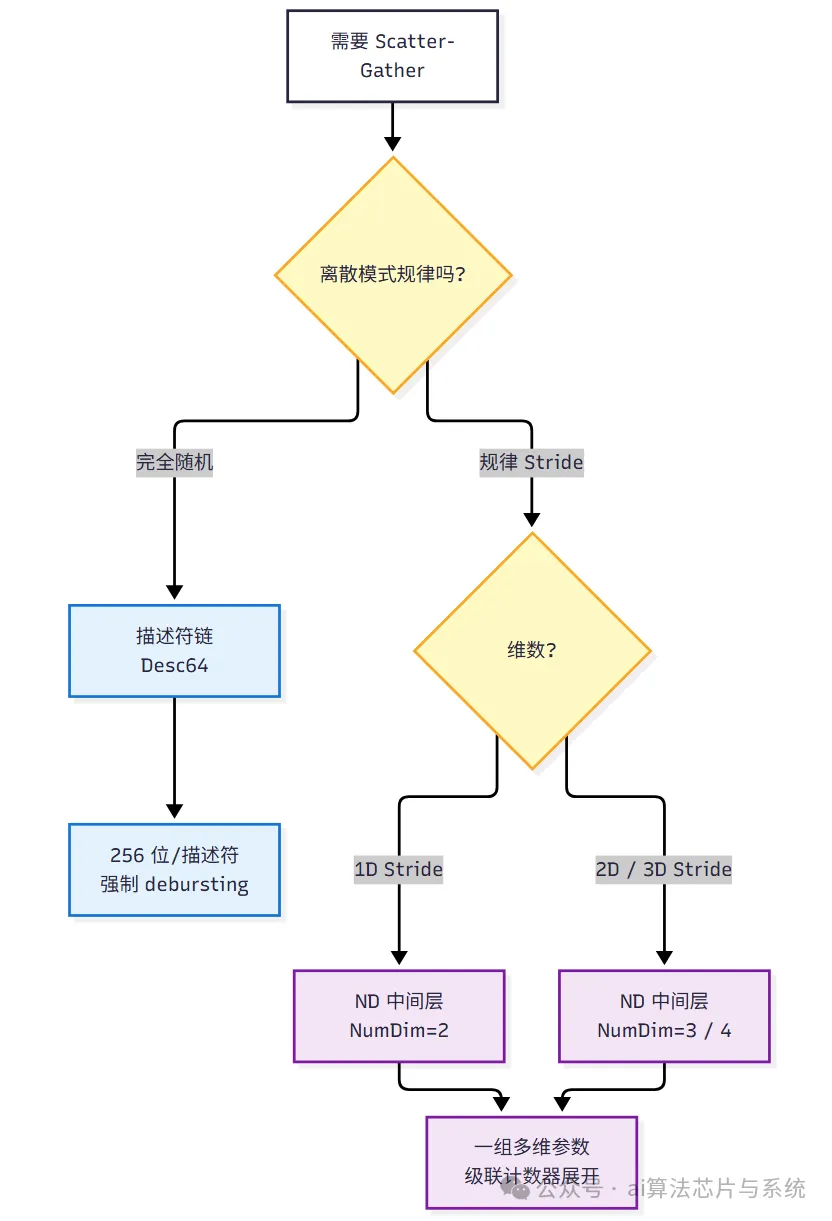
6.2 两条路径的决策对比
| 描述符链(Desc64) | Snitch + ND Midend | |
|---|---|---|
| 离散性类型 | 任意、不规则 | 规律、张量化 |
| 元数据开销 | 极低 | |
| burst 策略 | 强制 deburstingsrc_max_llen=0) | |
| 硬件加速点 | 级联计数器 + popcount | |
| 适用场景 | Im2Col、tile 抽取、通道重排 |
决策流程图:
7. 合法化器:协议合规的唯一守门人
7.1 源码职责的精确定义
"合法化器把请求切分为协议合法的总线 burst——即*不跨页边界、且不超过协议最大拍数的 burst,同时尊重对齐约束。"*
后端的三个执行阶段:
1. 合法化器:页切分 + 拍切分,产生 offset/tailer/shift控制信号。2. 传输层:读 → 桶形移位 → 缓冲 → 写。 3. 错误处理器(可选):监控总线响应。
7.2 页切分的数学规则
设请求起点 ,长度 ,页大小 (AXI 为 4096)。
第一段:
后续段:
用带水平分隔的列数组表达三段结构:
7.3 一个关键的架构边界
❗ 合法化器对每个 1D 请求独立切分,绝不跨请求合并。
设计意图: 后端只保证每个 1D 请求内部合法,不负责重组跨请求的访问模式。这是"小 stride 协议税"的架构根源,不是实现缺陷。
8. 传输层:数据通路的真实代码形状
8.1 四个组件的源码描述
后端文档对传输层的描述精确到数据流方向:
"传输层执行每个 burst:读通道从源取数,桶形移位器重新对齐字节车道,数据缓冲吸收时序差,写通道把数据存到目的。"
| 读通道 | ||
| 桶形移位器 | shift | |
| 数据缓冲 | BufferDepth 默认 2,推荐 3 | |
| 写通道 |
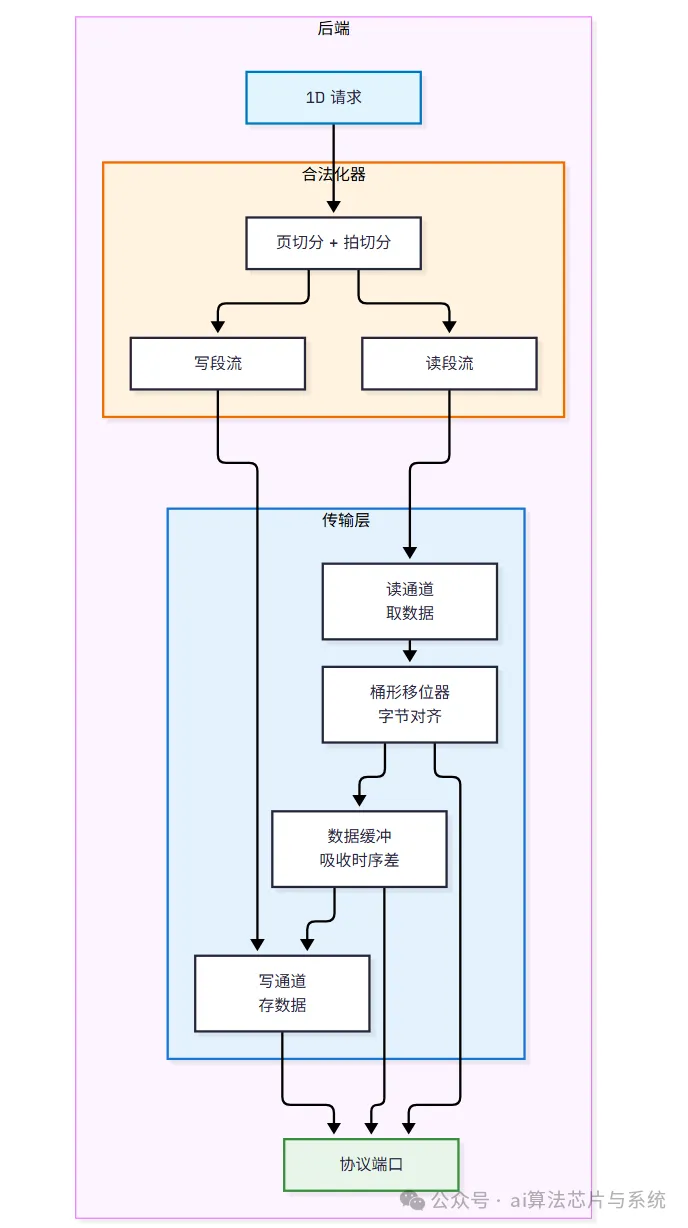
8.2 BufferDepth = 3 的源码理由
后端文档明确写道:
2 = 最小,3 = 推荐,因为深度 2 的缓冲在读写偏移不同的非对齐传输上会阻塞,需要额外的缓冲槽给对齐流水线。"
用流水线阶段表达:
• 🧩 深度 2:只能容纳"正在写入"和"正在对齐"的数据;写通道取数时会发生争用。 • 🧩 深度 3:多一个槽给对齐后的数据,写通道可以独立取数,不 stall。
🎯 这是源码级别的性能事实,不是经验法则。
9. 在途计算:移动中变换,不额外访存
9.1 源码位置的精确定义
"计算引擎位于*传输层的写侧,在读数据流缓冲和写桶形移位器之间,所以变换在从源流向目的地的节拍流上运行,没有到内存的往返。"*
9.2 两种操作与合法化器的联动
| 转置 | idma_otf_transpose | |
| MX 量化/反量化 | idma_otf_mxquantmxdequant |
"这些是改变尺寸的传输,在合法化器中合法化。"
🎯 计算改变读写长度,合法化器必须知道这一点——这是
compute使能时合法化器额外推导写长度的原因。
10. 参数、限制与集成事实
10.1 源码推荐的核心参数
| 源码推荐 | |||
|---|---|---|---|
DataWidth | |||
BufferDepth | 3 | "depth-2 在非对齐传输时 stall" | |
HardwareLegalizer | 1 | "除非你的软件预切 burst" | |
NSpeculation | 4 |
10.2 源码承认的性能限制
| 非对齐传输 | "任何小于总线宽度的传输都将不可避免地导致利用率的实质性下降" | 本质上限制 |
| 描述符 deburst | src_max_llen = dst_max_llen = 0 | |
| 小 stride |
10.3 固定延迟的源码事实
论文明确指出:"后端从接收 1D 传输到在协议端口发出读请求,有固定的两周期延迟。"
🎯 这是硬件流水线的固定开销,与传输大小无关。ND 中间层在此基础上额外增加一个周期延迟。
11. 总结:源码告诉我们的设计意图
源码确认的六个事实:
1. 🧩 三层解耦是硬契约,不是建议。 后端只认 (src_addr, dst_addr, length),stride 在中间层边界被完全消化。这是三层可以独立替换、独立验证的前提。2. 📦 数据结构是层间契约的物理载体。 idma_req_t只有 5 个字段,窄到后端可以独立形式化验证;idma_nd_req_t只增加维度描述符数组,不污染 1D 契约;desc64用 256 位承载链表节点。options_t的compute_op_e枚举从 RDL 生成,软件和 RTL 共享同一份编码。3. 🔀 Scatter-Gather 有两条源码路径。 描述符链( desc64)处理任意不规则离散,代价是 256 位/描述符 + 强制 debursting;Snitch + ND 中间层处理规律性 stride,元数据是几条指令,硬件用级联计数器 + popcount 无乘法器展开。4. ✂️ 合法化器是协议合规的唯一守门人,对每个 1D 请求独立切分,绝不跨请求合并。这是"小 stride 协议税"的直接来源,也是设计取舍而非缺陷。 5. 🚚 传输层数据通路是:读 → 桶形移位 → 缓冲 → 写。 BufferDepth=3是源码明确推荐值——深度 2 在非对齐读写偏移不同时会阻塞,因为对齐流水线需要额外一个缓冲槽。6. ⚠️ 非对齐/小传输的总线利用率损失是源码承认的内在限制,不是可以通过参数调优消除的。描述符前端的 src_max_llen=0是用吞吐换合规的显式设计选择。
💡 一句话记忆点:中间层用级联计数器把 stride 说清楚,后端用合法化器把 1D 搬合法;两条 Scatter-Gather 路径按"离散是否规律"分工,数据结构定义边界——接口即自由。