ARTICLE · 1310570
让 AI 生成的元数据可以被争辩、复盘,再进入目录
Agent 可以从设备台账、遥测、手册和维修记录中提议分类与关联,但“人点了批准”并不能说明人真正检查过什么。我认同的方向,是把候选标签变成带证据、可质询、可补正的主张,并留下完整审核轨迹。
我认同的判断AI 对元数据的贡献不应以“生成了多少标签”衡量,而应看每个决定能否回到证据、接受异议、在人工裁决后安全提交,并在未来被纠正或撤销。
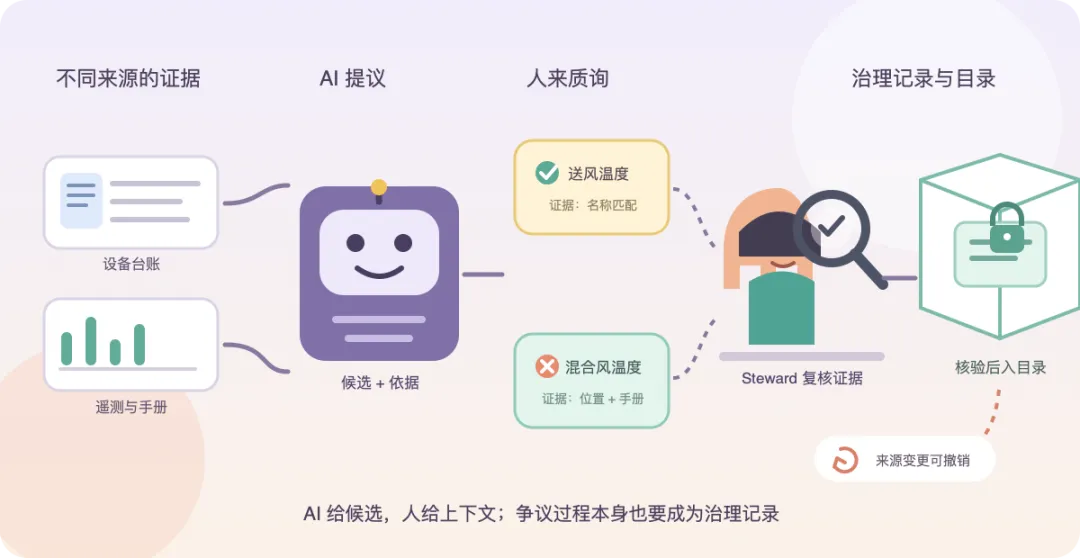
把“人类在环”落到细节:审核者不是点一下批准,而是对照不同证据、质询候选含义,并留下为什么这样决定的记录。
01 · 治理问题
资产标签错一次,可能被整条数据链复用很多次
工业组织的知识通常分散在两类地方:结构化记录里的点位名、设备型号、故障码和遥测;以及非结构化的手册、维护日志、沟通记录和检测报告。真正懂这些局部语义的人很少,Agent 因此很适合协助识别字段、找关联、提出分类。但如果模型把点位一次错标成“送风温度”,后续规则、报表和相似设备映射都可能继续沿用。
另一类问题是审批看起来完整,证据却不存在:治理系统只留下“某人批准了模型建议”,没有记录当时模型看过什么、审核者否决过哪些理由、引用的文档版本是否适用于这台设备。之后发生错误时,团队无法分清是模型推断、人工修订、批量导入还是过期先例造成的。
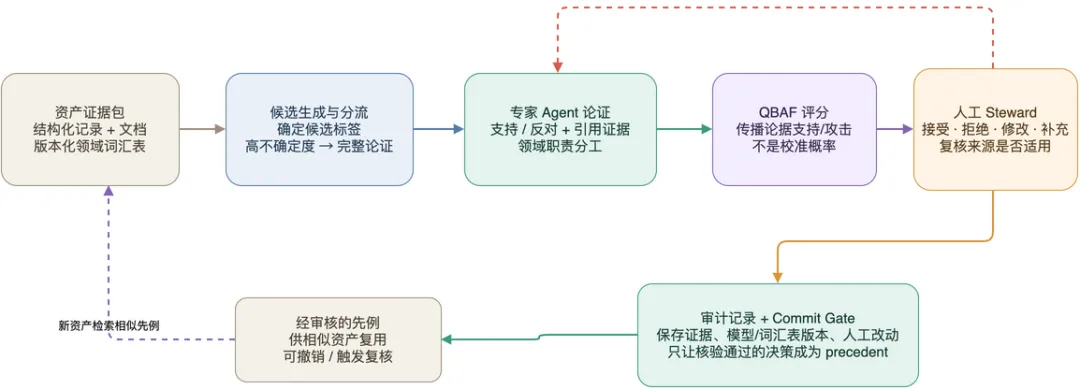
工作流示意。候选分流与提交门控是治理设计;参考实现并未完整覆盖这些环节。
02 · 机制
从“AI 给一个标签”改成“AI 给一组可质询的主张”
- 收集候选、证据、先例和版本化词汇
分析器读取结构化记录和相关文档,再找相似的已核验案例。词汇表要带定义、来源、适用设备/版本、所有者和版本号;同一个缩写在不同产品线上可能含义不同。 - 由不同职责的 Agent 提出支持与反对论据
例如一个 Agent 只看点位名称,一个查设备手册,一个检查文档修订范围。每条论据必须连到适用证据;“某候选缺证”本身不能算另一候选的支持理由。 - 让 Steward 逐条接受、拒绝、修改或补充
人可以直接质询证据是否适用于当前设备,也可以增加新的论据。系统重算分数,但决定在人工审查结束前不能提交到目录。 - 保留结果、证据和每次人工干预
治理记录保存输入快照、模型与词汇表版本、论据、审核事件、最终标签和授权人。只有经过验证的记录才能进入先例库;当文档或规则变化时,先例可以被撤销并触发复查。
评分不是概率,更不是事实真值
定量双极论证框架(QBAF)可以让支持与反对论据彼此传播:候选的支持链提高其强度,反方论据拉低强度。示例用 sigmoid 一类的更新规则和固定步数迭代,让论据之间形成相对稳定的分数。
候选强度 ← 候选基础分 + 支持论据的传播 − 反对论据的传播
最终分数用于比较候选,不是“这个标签有 82% 概率正确”。
更关键的是,示例中的基础分由 Agent 赋值,并非经过人工评级校准的概率。实际部署应使用版本化 rubric 判断引用来源是否适用,并通过独立标注检验评分者的一致性。审计记录能让决定重建,但可重建不等于正确。
03 · 案例
HVAC 点位和保修故障:把“缩写猜测”变成“证据冲突”
点位分类:DISCH-T 究竟测哪里?
合成站点包含 247 个点位,其中 18 个被认为有歧义。按照 triage 设计,229 个走较短的证据复核,18 个走完整多 Agent 论证;参考实现实际展示的是一个点位,并未实现完整 triage。
示例中,EQ-7700 空调箱的 DISCH-T 因设备位置和手册语境,最终更符合 Mixed Air Temperature。仅看字符串的匹配器提出一个反方意见;人工 Steward 否决后补充手册依据,系统保留否决原因和最后选择。
保修标签:传感器坏,还是风门连杆松?
第二个案例是完全合成的保修数据:工单说更换送风温度传感器后仍故障;遥测显示风门命令变化而实测位置不动;技师笔记提到连杆松脱;公告的适用序列号又排除了当前设备。
论据结构把这些冲突摆在 Steward 面前,示例最后选择 damper linkage failure。它说明结构可以怎么设计,不是一次真实生产系统的准确率实验。
点位示例还暴露一个重要建模问题:Brick Schema 中 Discharge_Air_Temperature_Sensor 被声明为 Supply_Air_Temperature_Sensor 的等价别名,但示例实现仍把两个标签作为独立候选计分。正式接入本体时,需要先归一化等价类、记录本体版本并校验生成的图结构,否则“论证很充分”也可能只是比较了重复选项。
04 · 证据边界
这是治理工作流设计,不是“AI 治理准确率提升 X%”的实证
247合成 HVAC 点位的示例站点规模
18被标作歧义点位;完整路径的重点案例
0整体标签准确率、审核耗时或生产工作量的对照实验
当前主要实现是 HVAC 点位分类参考方案,采用 CrewAI、GPT-4o、Voyage AI embeddings 和 MongoDB;保修案例则是示意性的合成数据。没有独立专家真值集上的准确率评估,也没有 Steward 审核时间、不同审阅者一致性或错误先例传播率的数据。
“先用高置信度分流,减少完整论证开销”的 72.7% 调用降低和 95% 成功率,来自另一项 100 个 Agent 任务的独立基准,不是这套数据治理流程的结果。即便是高置信度提议,也应由 Steward 审阅后再提交。
实现范围要分清。候选分流、append-only 审核历史和 promotion gate 是治理设计;参考实现未完整具备这些部分。第二个保修流程是合成示例。应把设计设想、已实现的 HVAC demo 和尚待验证的治理效果分开。
05 · 工程迁移
如果用在数据目录,先把四类证据写进“打标记录”
- 来源快照
记录字段、表、文档、数据样本及其版本/时间范围;区分机器抽取、人工提供和系统导入的证据。 - 语义适用范围
为缩写、业务术语和本体版本记录系统、型号、时间、地域等适用条件,避免把局部解释推广成全局语义。 - 完整争议轨迹
保留每个候选、支持/反对论据、证据链接、Reviewer 的否决理由、修改记录、模型与 prompt 版本。不要只保存最后一个 label。 - 提交与先例分离
候选生成不是资产变更。先进入待审核状态;只有核验通过的记录才写入正式目录或成为可检索先例,并允许来源更新后触发失效复查。
落地时我会先做一组标注任务,而不是先比较模型:抽取 50 个需要跨表、文档和规则判定的资产标签,标注来源适用性、候选冲突、人工修改原因、审核时长和最终一致性。随后再验证争辩式记录是否让错误更早被发现、是否减少重复审核、是否能可靠撤销过期先例。
我最认同的视角是:数据治理不是“让 AI 自动给资产贴标签”,而是让 AI 提供可审查的候选,让人的领域判断变成可回流、可复盘、可撤销的治理数据。落地时,应先验证审核质量和撤销机制,再扩大自动化范围。